ARTICLE · 999376
企业知识库到底该怎么建?从文档解析到 RAG 落地,这份 73 页白皮书梳理了核心路径(内含下载链接)
到了大模型时代,企业知识库也不再只是一个“存文档的地方”,大家更关心的是:这些知识能不能被准确找到,能不能被机器理解,最后能不能真正进入业务流程
真正开始规划时,通常会遇到几个很具体的问题:
人才流失引发经验断层,关键知识如何长效沉淀、有序传承? 审计与监管常态化,如何实现知识全链路留痕,筑牢合规屏障? 信息零散、重复工作挤占精力,怎样释放员工有效工作产能? 破除信息壁垒,盘活存量知识,为业务持续创新提供支撑?
合合信息发布的《企业知识库建设白皮书》,围绕企业知识库形态、RAG 架构、文档解析、技术选型和行业实践等话题,对企业知识库从 0 到 1 的建设问题做了一次集中梳理
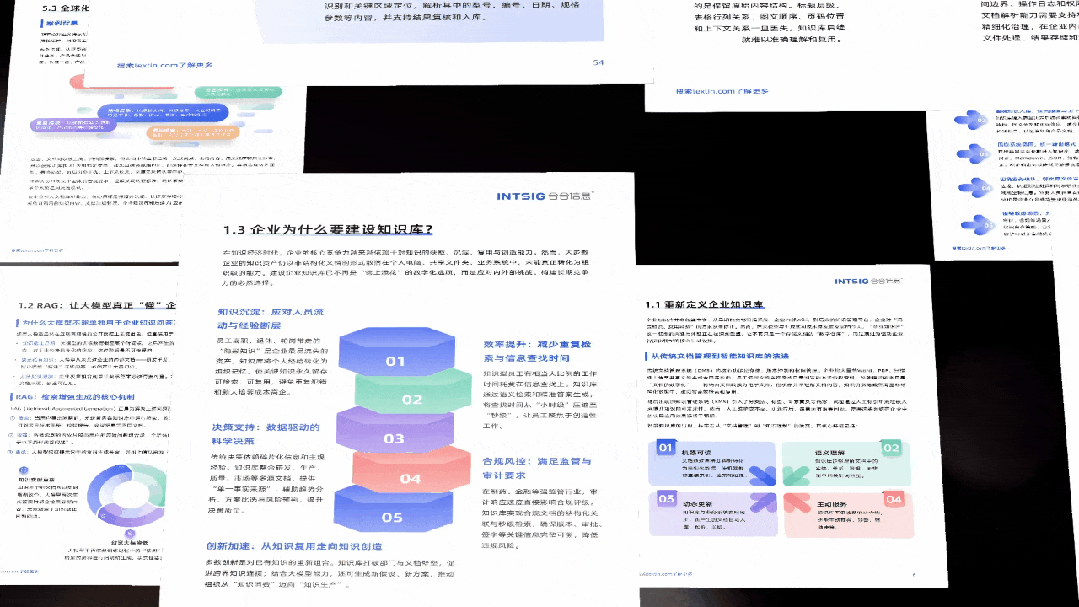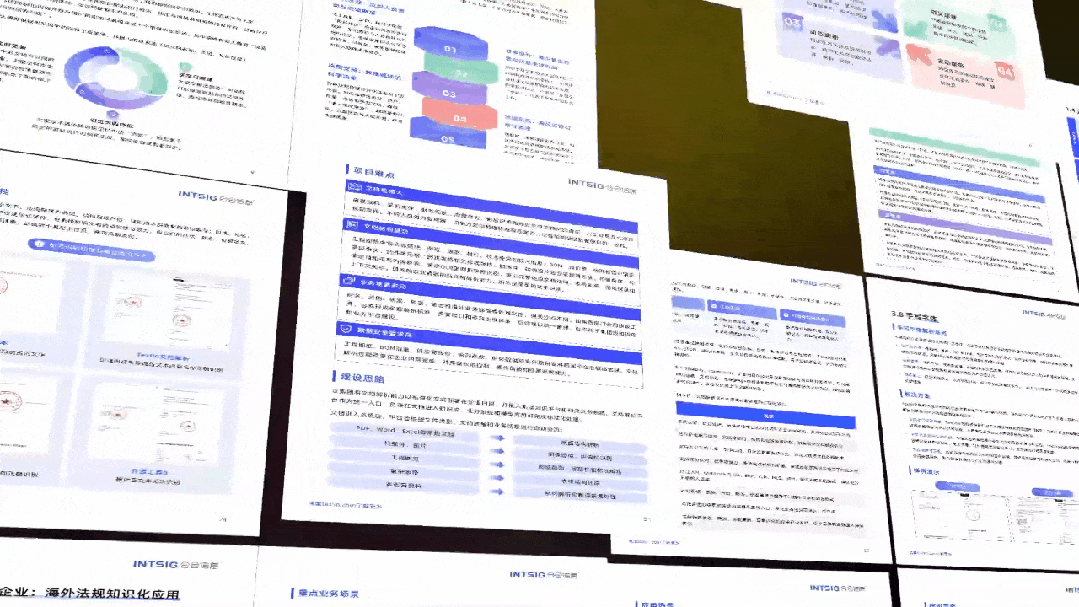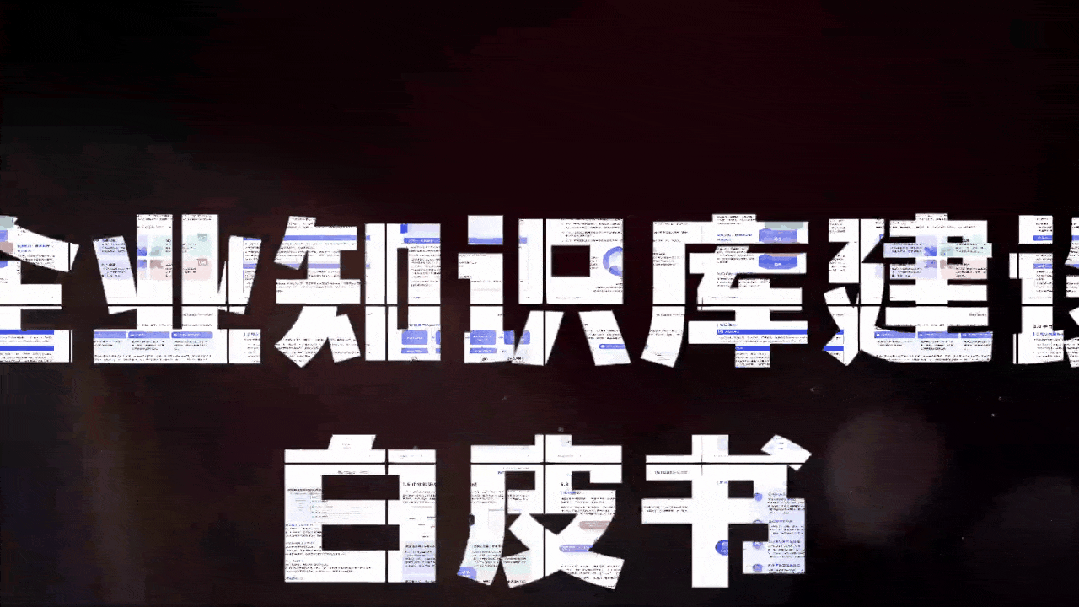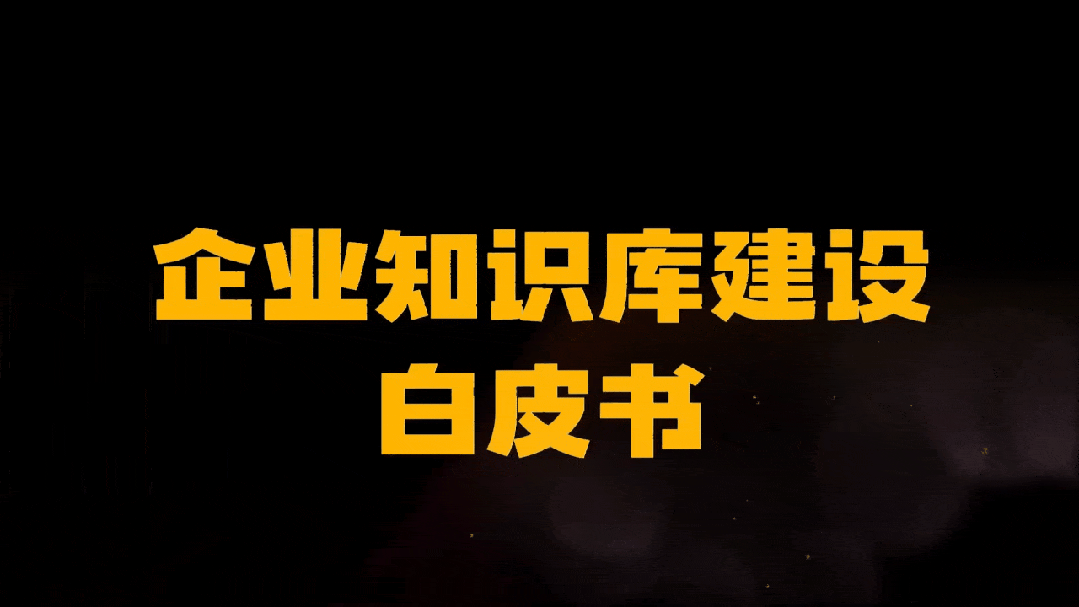
这是目前为止,我见到的最详细的企业知识库搭建文章
白皮书的获取方式在文末
接下来,我带你一起看看这份白皮书
这份白皮书主要讲什么?
如果你正在评估企业知识库,或者已经开始接触 RAG、文档解析和向量数据库,可以先通过这份材料搭一个基本框架。
RAG 可以先简单理解为:系统先从企业资料中找到和问题相关的内容,再让大模型根据这些内容组织回答。
企业知识库建设的完整流程
先看一张图,这是这份白皮书里企业知识库的搭建流程
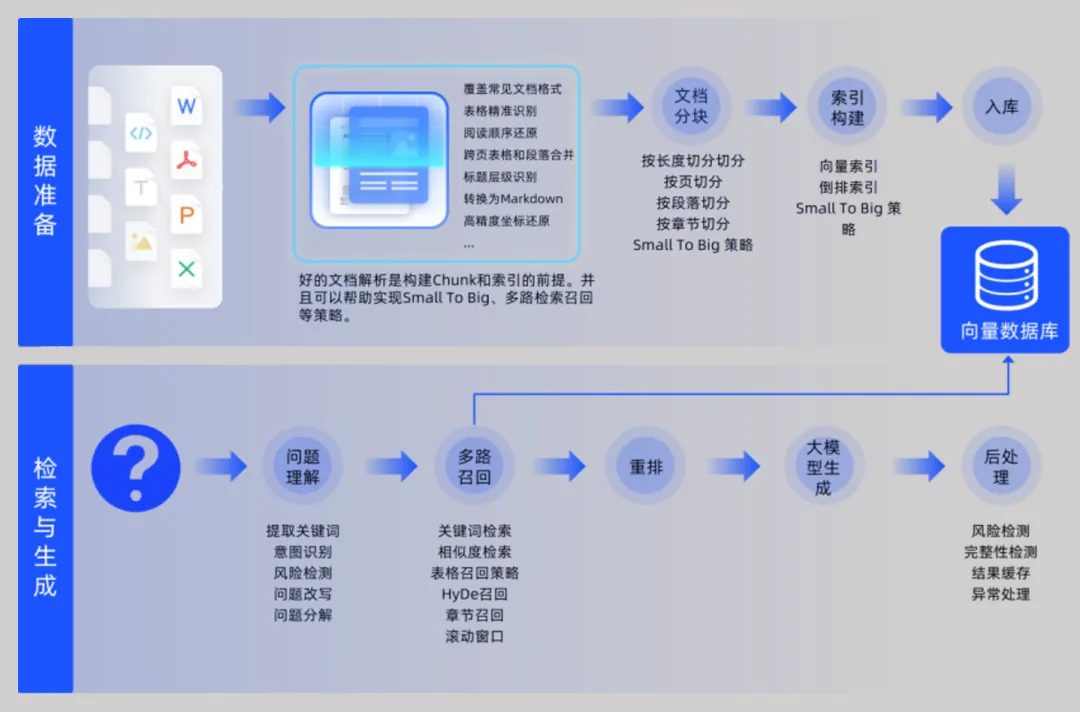
知识库建设不是把文档上传完就结束了,前面需要做文档解析、分块和索引构建,后面还有问题理解、检索召回、重排、大模型生成和结果处理。
也就是说,最终的回答效果不只取决于用了哪个大模型,前面的资料和检索链路同样重要
企业知识库建设的关键挑战
企业知识库的目标,是让机器能够“理解”并“利用”知识。但现实中的企业知识,绝大部分并不是以机器可读的形态存在。
行业报告、技术手册、研发记录、合规文档、合同协议等承载着核心知识资产的文件,大多以 PDF、扫描件、图片等非结构化格式存放在企业内部系统中。它们包含丰富的信息,却无法被检索系统直接索引,无法被大模型直接理解,更无法被业务系统直接调用。
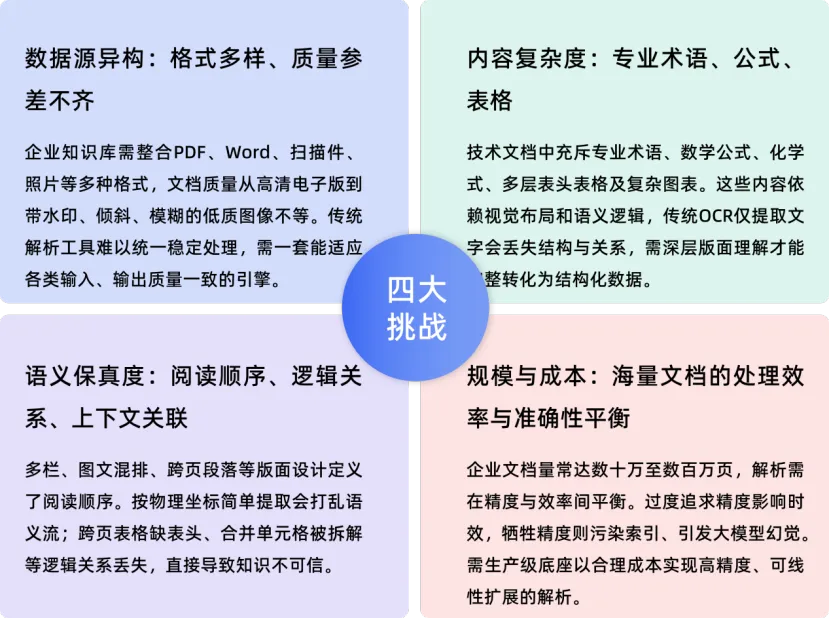
说得直白一点,文档还没有解析清楚,后面的检索和问答就很难稳定
很多问题在大模型开始生成答案之前,其实已经发生了
非结构化文档解析难点破解举例
对于这个问题,复杂表格是一个很典型的例子
合并单元格、无线表格、多层表头等内容,并不是把文字识别出来就算完成
如果行列关系和表头层级丢失,即使 OCR 识别出了所有字,后续系统仍然可能无法正确使用
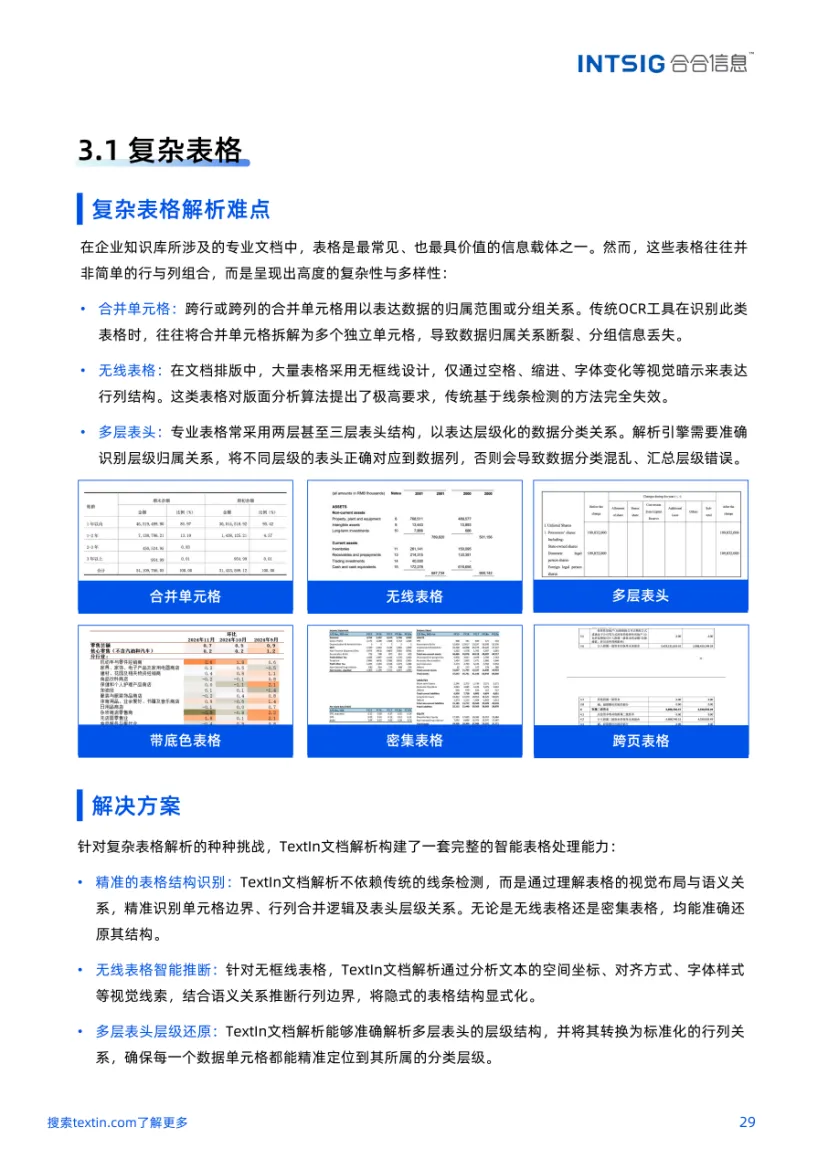
对此,这份白皮书有多种解决方案,精准的表格结构识别,无线表格智能推断,多层表头层级还原,等等,帮助你解决这些问题
白皮书中的五大行业案例
白皮书中还清晰的给出了五大行业的案例
头部券商:证券 AI 中台建设与创新运营 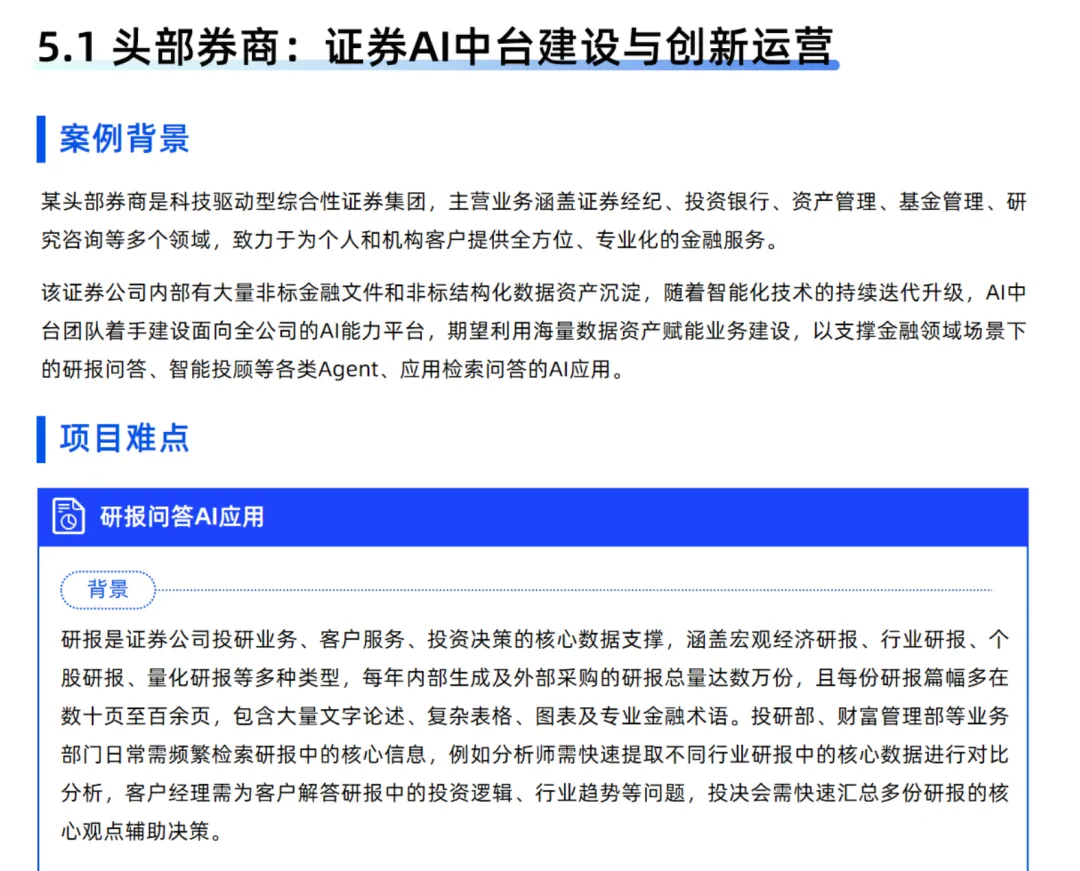
跨国工程机械集团:多场景企业级 AI 应用建设 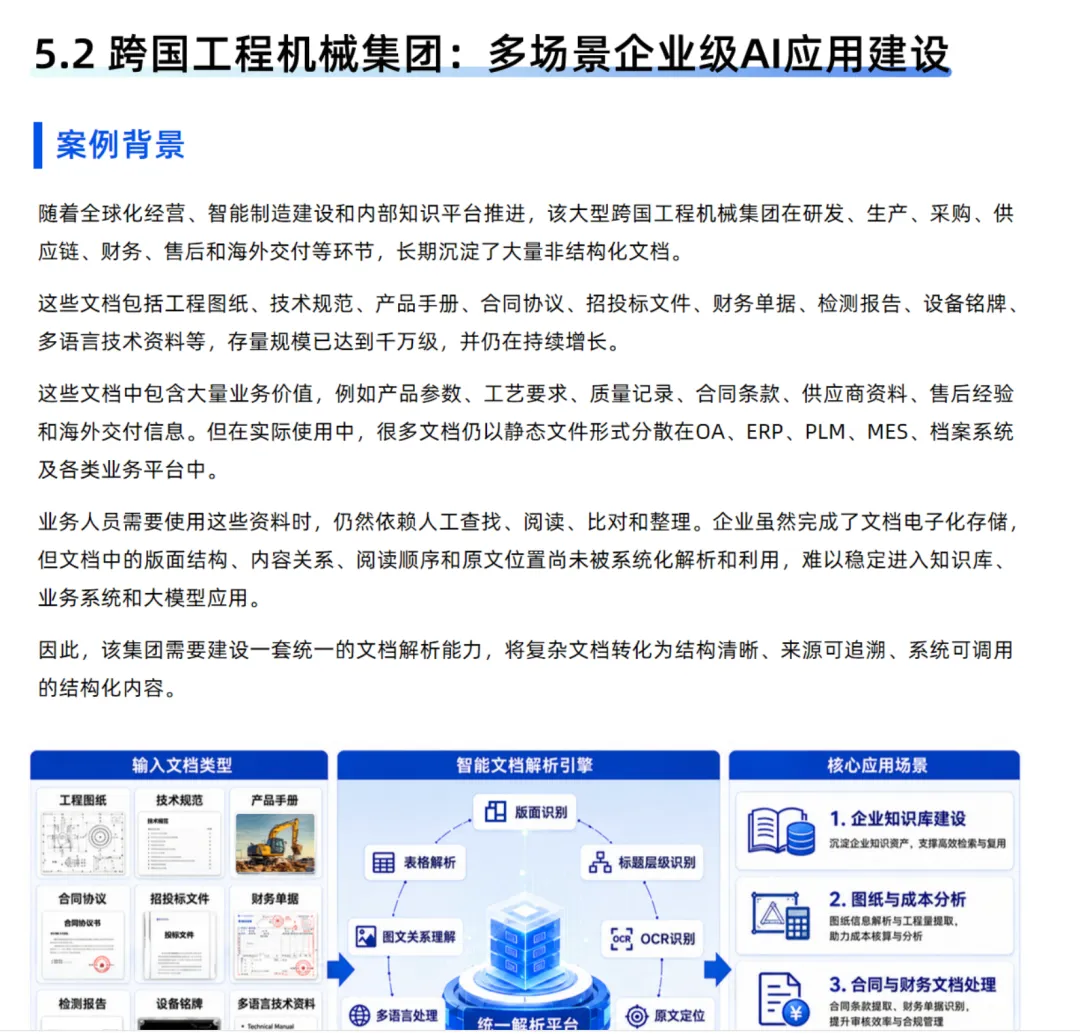
全球化智能物联企业:海外法规知识化应用 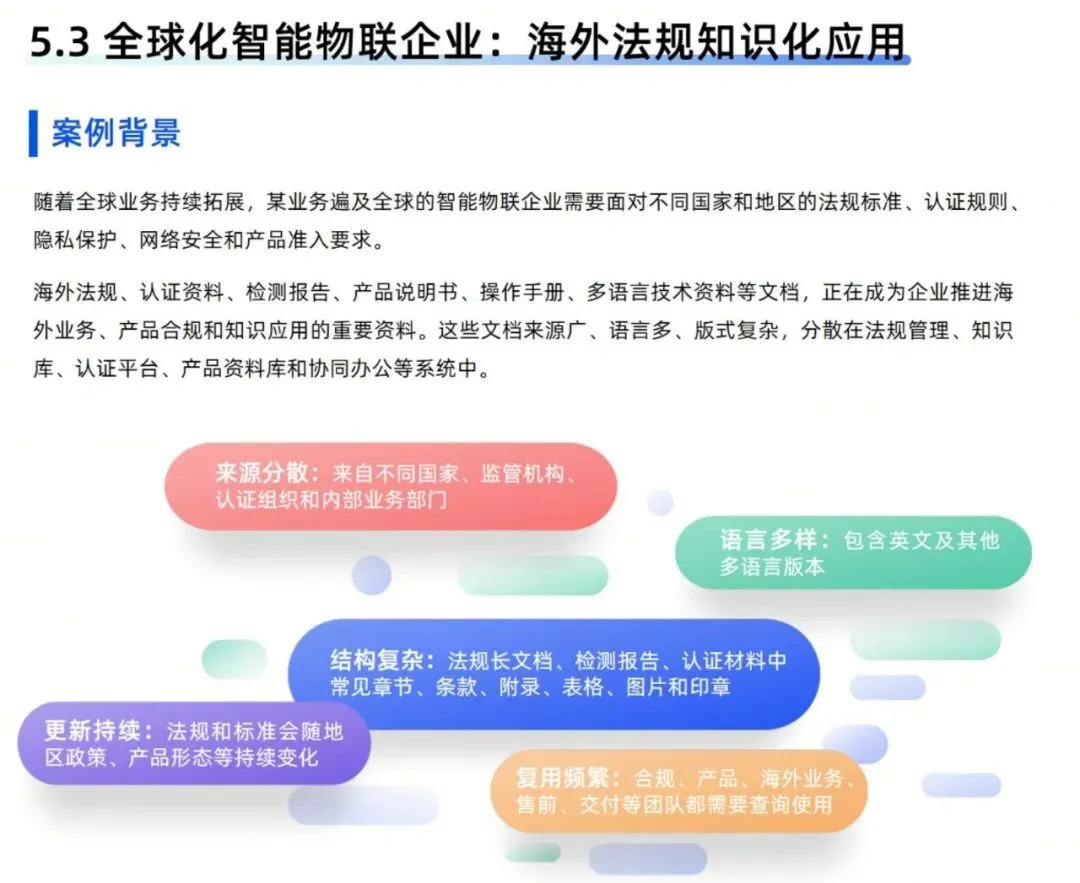
头部半导体企业:行业知识库建设与升级 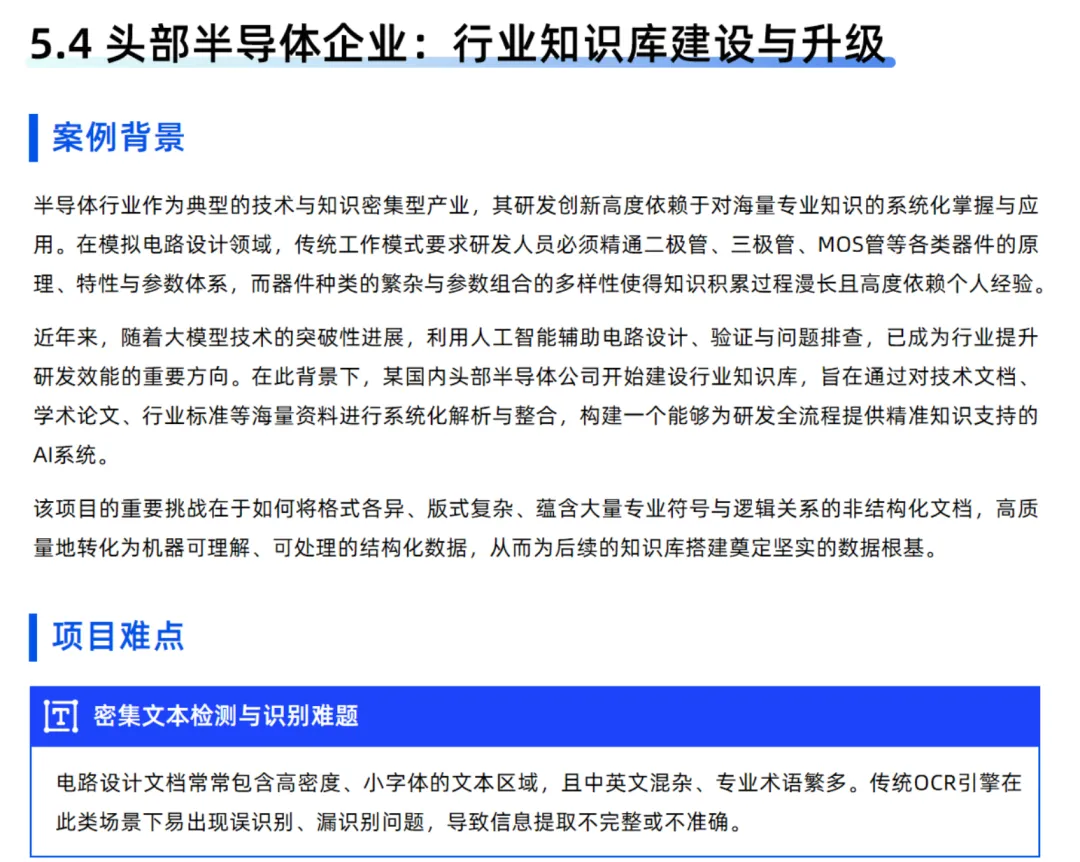
头部医药企业:构建五大知识库体系 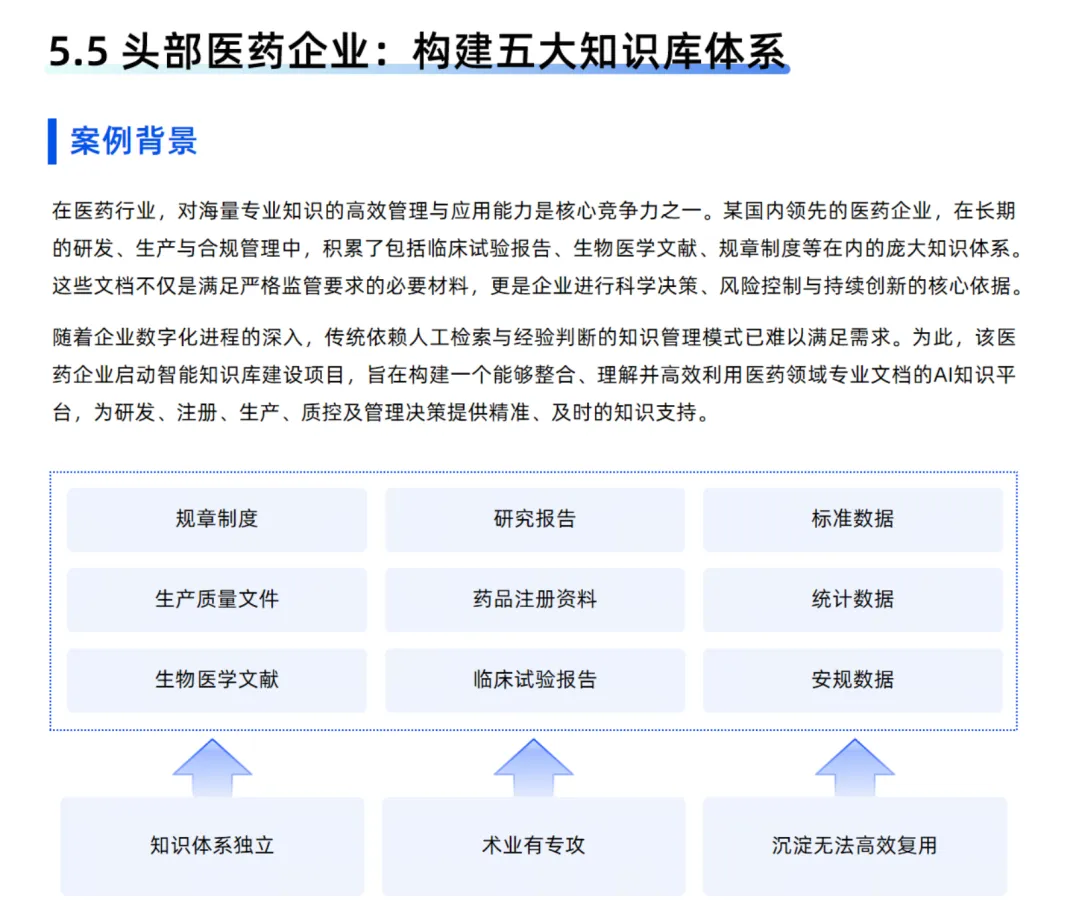
这五个案例覆盖证券、工程机械、智能物联、半导体和医药行业
对于正在做立项或技术选型的团队来说,案例部分可以用来对照:不同行业在解决什么问题,以及知识库最后进入了哪些业务场景
如何获取完整白皮书
这本白皮书不仅是一份技术洞察,更是企业知识库从0到1的建设指南,如果你是 CTO、技术负责人,或者正在参与企业数字化转型和知识库建设,这份白皮书都能能帮你获得体系化的方法、可落地的案例和避坑经验
扫描下方二维码并填写问卷,即可下载 73 页完整版白皮书。
推荐阅读: