ARTICLE · 999407
AI 工具越用越多,组织为什么没变强
上个月,业务方一个负责人给我发消息,就一句话。「你们那个 AI,我到底该从哪用?」
我盯着这句话看了半天,答不上来。
是真答不上来。这两年,各家厂商都在赶着出 AI 产品。通用办公这一层,国外有微软 Copilot、谷歌 Gemini,国内几家协同办公平台也都配齐了,飞书有豆包工作,腾讯有 WorkBuddy,钉钉推出了千问办公。编程这个垂直领域,先是 Cursor,接着 Claude Code、Codex 一个接一个。想自己搭 Agent 的,有 Dify 这样的低代码框架,WorkBuddy 也能建,公司 IT 还推了个通用 Agent 平台。每一个单拎出来都是 AI Tools,可它们之间是什么关系,谁也说不清,公司员工也很疑惑。真要用起来,哪件事该从哪进,连我自己都拿不准。
工具已经太多了。要把这一堆捋清楚,得先做一件事,分层。
◆ ◆ ◆
这两年我在企业里做过一些AI 落地项目,设计实施 HR 域的 Agent,也帮业务Vibe Coding过一堆工具。上面那个场景,我自己遇到过选择困难,我聊过的很多同行也遇到过。
有一份针对几百家公司的调研,我把两个数字记了很久。AI 工具的用量涨了六成多,团队真正交付的产出,只涨了一成左右。美国国家经济研究局还有一项调查,八成高管说,没看到这些投入带来可以测量的效果。
数据来源 · DX《AI Productivity Gains Are 10%, Not 10x》(2026) · NBER Working Paper 34836《Firm Data on AI》(2026)
工具用得越来越多,组织却没变强。这个落差,我不急着给答案。我想先做一件基础的事,把这些工具之间的关系梳理清楚。
▍工具根本不在一层
我最早也以为,乱是因为工具太多。后来发现,是我把框架想错了。
我把飞书、Dify、Trae、自研 Agent 摆在一张桌上比,越比越乱。问题就在这,它们压根不是一类东西。
飞书、钉钉、企业微信,是员工本来就在的地方。人在这里问问题,AI 从这里接话。这一类,管的是入口。
Dify、飞书 aily、扣子,是另一类。它们不直接面对员工,做的是把一句话识别出意图、配好提示词、决定该走哪条检索。这一类,管的是编排。
自研 Agent、内部系统接口,又不一样。真正的业务逻辑在这里,红线也在这里。这一类,管的是能力。
后面还有两层。知识库、向量库、业务数据库,管的是这个 AI 知道什么、不知道什么。再往下,大模型,管的是最后那一下推理。
入口、编排、能力、知识、模型,五层。它们是一条请求从上到下要路过的五站。
乱的人,是把五站的东西硬塞进一站看。
▍一条请求,穿过五层
下面这张图,是我把上面这套想清楚以后画出来的。
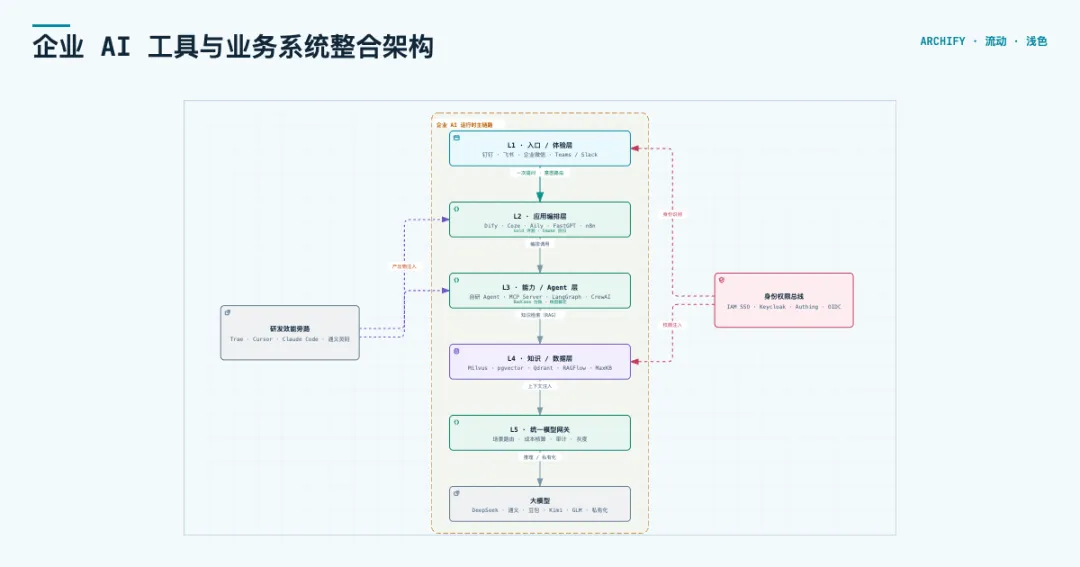
企业 AI 工具与业务系统整合架构 · 五层 × 两总线 × 一旁路
一次提问,从员工那里发起,到最后吐出一个答案,中间要穿过这五层。每一层只干自己的事,也只该干自己的事。
第一层是入口。它只做两件简单事,认出你是谁,把你的话转给下一层。业务逻辑不该放在这,识别身份、转发消息,到这就够了。所以入口层要稳,员工别为了用 AI 再装一个新软件,AI 就出现在员工本来就在的即时通讯里。他在钉钉里@一下,像问同事一样问它,这就对了。
第二层是编排。这里是 AI 应用的工厂,一个个对话流、一个个智能体,在这一层拼装出来。意图怎么路由,提示词怎么配,检索怎么做,改起来要快。业务方跑过来说,问年假的能不能先查一下他还有没有额度,我在编排层改几行配置,十分钟生效,不用动下面的代码。
第三层是能力,也是活儿最重的一层。业务逻辑在这里,系统集成在这里,该守的红线也在这里。
讲到这一层,我想插一句自己的判断。有些事,压根不该让模型干。薪酬核算、个税计算这类强规则的场景,数字错了就是事故,模型在这上面出幻觉的代价,谁都担不起。我把这类计算交给规则引擎,模型只负责把结果用人话讲一遍。分清哪一层该干什么,自然就分得清什么场景别硬上大模型。
第四层是知识。它决定这个 AI 知道什么,也就把答案的上限定死了。这里有个容易出大事的地方,知识能看见什么,得跟着人的权限走。否则一个普通员工问一句薪酬,看到的可能是别人的工资。
第五层是模型。我把模型和一个网关放在一起说,网关按场景把请求路由到合适的模型,成本算到部门头上,调用留审计。模型在下面,网关在门口。
五层讲完,你可能发现,每一层的东西,替换的代价不一样。模型天天在换,这个月这个顺手,下个月就出了更强的;编排平台一两年就可能换一个;入口却最好一辈子别动。分层的好处就在这,快的东西随便换,慢的东西不动。底下模型换了三轮,入口那边的员工毫无感觉,他还是在老地方问话。
▍四样东西,横跨所有层
分层解决的是"谁是谁"。分完以后,第二件事自己浮了出来。
还是看这张图。五层之外,有四样东西,横跨了所有层。
入口管你从哪问,身份管你能看什么。知识和模型是另外两样,一个决定能问出什么,一个决定答案从哪来。
一条请求从上走到下,每一层都要碰这四样。它们是全公司共用的资源,任何一家工具都带不走。
麻烦就出在这。如果这四样各自散在工具里,各管各的一本账,那五层搭得再漂亮也是塌的。我见过最直接的后果,一个团队 Dify 里一套模型的 key,Trae 里一套订阅,自研又一套,年底想按部门算一笔 AI 成本,根本算不出来。
所以分层之后要做的事,是把这四样收拢到一处管。我把这个动作叫收口。
收口这个词不太顺耳,意思其实简单,散在各处、却被所有人共用的东西,收到一起统一管。这里要划一条边界。收口不是再去买一个什么都装的大平台,全栈平台买回来,每一层还是人家自己那一套,只是换了个壳。收口收的是资源,身份、知识、模型调用这些共用的东西。至于每层用哪家工具,随便挑。工具可以多样,资源必须统一。
▍四把尺子
写到这,我把自己的判断收成四把尺子。搭完东西,或者回头看公司已经买回来的那一堆,拿这四把量一量。
一个入口。员工问 AI,是不是只从一个地方进,不用为了不同的事装不同软件。
一份权限。身份是不是跟着人走,换哪个工具,该看到什么、不该看到什么,都一个样。
一个知识底座。知识是不是只维护一处,到处都能用,看得见什么跟着权限走。
一本模型账。所有模型调用是不是进同一本账,场景、成本、审计在一张表里。
四把尺子,量的其实是同一件事。这四样公共资源,收口没收口。
▍一个工具,也能盖住好几层
看到这,你可能回过味来。拿这五层去看,飞书一个工具就占得差不多了。IM 是入口,aily 是编排,开放平台是能力,文档和知识库是知识,底下还接着火山方舟的模型。一条链路,它一家横着盖满。
这不跟分层打架。分层分的是职责,不是厂商。一个厂商把五层打包卖给你,五层不会变成一层,只是都姓了一个东家。
要留神的是打包带来的那点舒服。2026 年 8 月,字节发了"豆包工作",飞书账号一登,聊天记录、文档、会议纪要全继承过去,干完的活再沉淀回飞书,又省事又闭环。可这个闭环,收的是飞书自己的口。哪天你想换家模型,这份沉淀就带不走了。
这就绕回我前面那句话,工具可以多样,资源必须统一。你把五层在飞书里用得很顺没问题,但身份、知识、模型这三样,得攥在组织自己手里。
最后回到题目。工具越用越多,组织为什么没变强。
我的答案是这样。单个人的效率,早被这些工具提上来了,一个人十分钟干完过去一小时的事。可组织要的是另一件事,这省下来的力气得变成大家能复用、能接管、能算清账的能力。
这一步难在哪?把工具连起来,解决的是数据通不通。可组织要跑起来,还得解决事归谁管、账算谁的、权限跟不跟人。这些全是协调的事。单点效率提得再高,协调成本不降,组织这台机器就快不起来。那六成和一成的落差,就卡在这里。
这一步,靠的是先把工具分层,再把横跨各层的公共资源收口。光把工具连起来,攒不出这份能力。
工具可以多样,资源必须统一。
想明白这一句,那一工具箱的东西,就不再是乱麻了
信源说明
1. DX《AI productivity gains are 10%, not 10x》(Justin Reock,2026-03):400 家公司纵向研究(2024-11 至 2026-02),AI 工具用量 +65% vs PR 吞吐中位数 +7.76%(均值 13.1%,多数组织落在 5-15%)
2. NBER WP 34836《Firm Data on AI》(Yotzov, Barrero, Bloom, Davis 等,2026-02):美英德澳近 6000 名高管调查,89% 报告 AI 未对劳动生产率产生可测影响;摘要版:NBER Digest