CON T EN T S
目录
考点一 基本术语 ★
考点二 树的性质和存储 ★★★
考点三 二叉树 ★★★★★
考点四 二叉树的遍历 ★★★★★
考点五 线索二叉树 ★★
考点六 树、森林和二叉树的关系 ★★★★
考点七 哈夫曼树 ★★★★★
考点八 并查集考点框架
哈夫曼树的概念
哈夫曼树的构造
哈夫曼树的编码【哈夫曼树的概念】考点七: 哈夫曼树
编码:是将一个符号或一组符号通过某种规则转换成另一种符号或
符号组合的过程,是信息传递的基础。编码的作用是将信息从一个
形式转换为另一个形式,使其能够被传递、处理、存储与使用。考点七: 哈夫曼树
我们假设只发送A,B,C,D四个字母,那么直接发送A,B,C,D
是不可行的,为什么呢,我们知道字母在计算机中是8位来表示的,如
果直接发送A,B,C,D。
我们知道对信息进行表示的目的是区分信息,根据编码的原理,我
们可以A编码为00,B编码为01,C编码为10,D编码为11;
于是我们想发送的是10个A,5个B,3个C,2个D,那么一共要发
送的比特是10*2 + 5 * 2 + 3 * 2 + 20* 2 = 40bits(每个字母2个bits,
其二进制的表达是00 00 00 00 00 00 00 00 00 00 01 01 01 01 01 10
10 10 11 11)。考点七: 哈夫曼树
基本概念
① 结点路径:从树中一个结点到另一个结点的之间的分支构成这两个
结点之间的路径。
② 路径长度:结点路径上的分支数目称为路径长度。
③ 权(值):各种开销、代价、频度等的抽象称呼。考点七: 哈夫曼树
基本概念
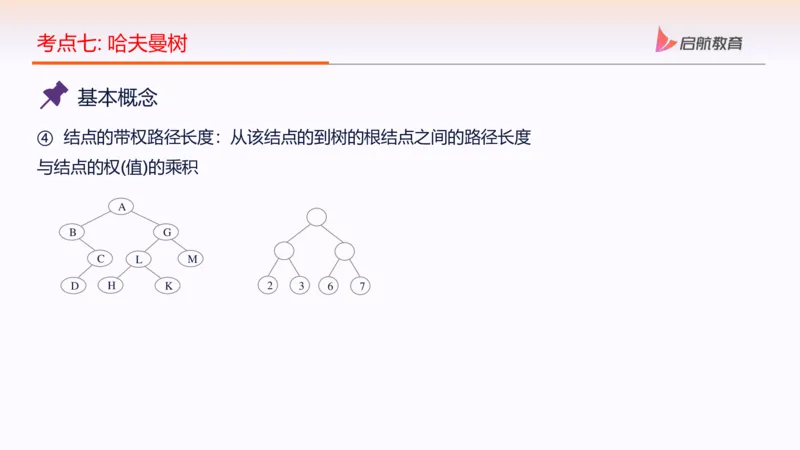
④ 结点的带权路径长度:从该结点的到树的根结点之间的路径长度
与结点的权(值)的乘积
A
B G
C L M
D H K 2 3 6 7考点七: 哈夫曼树
基本概念
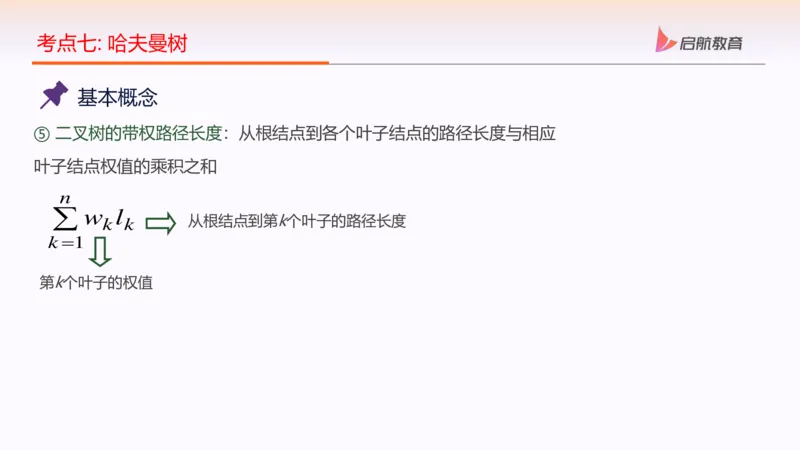
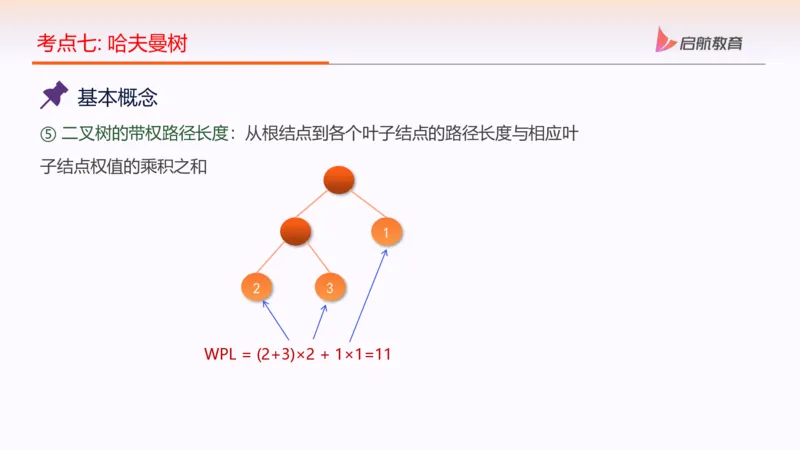
⑤ 二叉树的带权路径长度:从根结点到各个叶子结点的路径长度与相应
叶子结点权值的乘积之和
k
n
= 1
w
k
l
k 从根结点到第k个叶子的路径长度
第k个叶子的权值考点七: 哈夫曼树
基本概念
⑤ 二叉树的带权路径长度:从根结点到各个叶子结点的路径长度与相应
叶子结点权值的乘积之和考点七: 哈夫曼树
基本概念
⑤ 二叉树的带权路径长度:从根结点到各个叶子结点的路径长度与相应叶
子结点权值的乘积之和
1
2 3
WPL = (2+3)×2 + 1×1=11考点七: 哈夫曼树
基本概念
⑥ Huffman树:具有n个叶子结点(每个结点的权值为wi) 的二叉树不止
一棵,但在所有的这些二叉树中,必定存在一棵WPL值最小的树,称这
棵树为Huffman树(或称最优树) 。考点七: 哈夫曼树
基本概念
如图是权值分别为2、3、6、7,具有4个叶子结点的二叉树,它们的带
权路径长度分别为:
(a) WPL=22+32+62+72=36 ;
(b) WPL=21+32+63+73=47 ;
(c) WPL=71+62+23+33=34 。
其中(c)的 WPL值最小,可以证明是Huffman树。
7
2
6
2 3 6 7 3
2 3
6 7考点七: 哈夫曼树
基本概念
最优二叉树的特点
(1)权值越大的叶子结点越靠近根结点
(2)只有度为 0 和度为 2 的结点,不存在度为 1 的结点
7
2
6
2 3 6 7 3
2 3
6 7【哈夫曼树的构造】考点七: 哈夫曼树
树的带权路径长度:树中所有叶子结点的带权路径长度之和,记做:
WPL=w l+w l+⋯+w l =∑w l (i=1,2,⋯,n)
1 1 2 2 n n i i
n
w l
k k 从根结点到第k个叶子的路径长度
k =1
第k个叶子的权值考点七: 哈夫曼树
构造哈夫曼树的原则:
权值越大的叶结点越靠近根结点。
权值越小的叶结点越远离根结点。
n
w l
k k 从根结点到第k个叶子的路径长度
k =1
第k个叶子的权值 一般情况下,w >> l, w是带头大哥考点七: 哈夫曼树
• 根据树高度的定义,如果路径长度长一些,那么对应结点的高度就高
一些,在树中就靠下一些;反之就靠上一些;
• 对应的,出现次数少(权重小的)的结点高度高(在树中靠下),出
现次数多(权重大的)的结点高度低(在树中靠上)。
也就是说 w大的,l小;w小的,l大。考点七: 哈夫曼树
构造哈夫曼树的过程:
(1)给定的n0个权值{W1,W2,…,Wn0},构造n0棵只有一
个叶结点的二叉树,从而得到一个二叉树的集合F={T1,T2,…,
Tn0}。
(2)在F中选取根结点的权值最小和次小的两棵二叉树作为左、
右子树构造一棵新的二叉树,这棵新的二叉树根结点的权值为其左、
右子树根结点权值之和。
(3)在F中用新得到的二叉树代替这两棵树。
(4)重复(2)、(3)两步,当F中只剩下一棵二叉树时,这棵
二叉树便是所要建立的哈夫曼树。考点七: 哈夫曼树
图是权值集合W={8, 3, 4, 6, 5, 5}构造Huffman树的过程。所构造的
Huffman树的WPL是: WPL=62+33+43+82+53+53 =79
5 5 6 7 8
3 4 5 5 6 8
3 4
第一步
第二步
6 7 8 10 8 10 13
3 4 5 5 5 5 6 7
第三步
3 4
第四步
Huffman树的构造过程考点七: 哈夫曼树
图是权值集合W={8, 3, 4, 6, 5, 5}构造Huffman树的过程。所构
造的Huffman树的WPL是:
WPL=62+33+43+82+53+53 =79
31
13 18
13 18
6 7 8 10
6 7 8 10
3 4 5 5
3 4 5 5
第五步
第六步
Huffman树的构造过程考点七: 哈夫曼树
构造Huffman树时,为了规范,规定F={T ,T , ⋯,T }中权值小的二叉
1 2 n
树作为新构造的二叉树的左子树,权值大的二叉树作为新构造的二叉树
的右子树;
在取值相等时,深度小的二叉树作为新构造的二叉树的左子树,深度大
的二叉树作为新构造的二叉树的右子树。考点七: 哈夫曼树
因为每次两棵树合并, n个叶子结点
合并 n-1 次 n-1个分支结点
哈夫曼树共有 2n-1个结点【哈夫曼树的编码】考点七: 哈夫曼树
编码:给每一个对象标记一个二进制位串来表示一组对象
等长编码:用长度相等的二进制位串表示一组对象
酸 甜 酸 甜 苦 辣 酸 甜 苦 辣 咸 麻
0 1 00 01 10 11 000 001 010 011 100 101
省 市 区 出生日期 顺序 校验
身份证号码 22 01 04 19870126 444 7
编码的目的是什么? 数字化 编码效率取决于编码长度
如果每个对象的使用频率不等,如何获得较高的编码效率?考点七: 哈夫曼树
不等长编码:表示一组对象的二进制位串的长度不相等
设计不等长编码时,必须考虑解码的唯一性
一组对象 A B C D E
使用频率 35 25 15 15 10
AABACD
不等长编码 0 1 01 10 11
0 0 100110
00100110
0 01 00110考点七: 哈夫曼树
不等长编码:表示一组对象的二进制位串的长度不相等
设计不等长编码时,必须考虑解码的唯一性
层次路径的概念,从根结点开始,到达某结点p所经过的所有结点
称为结点p的层次路径。
请注意每个叶子节点的层次路径有且仅有一条,且相互之间不会
出现前缀。考点七: 哈夫曼树
哈夫曼编码
规定哈夫曼树中的左分支为0,右分支为1,则从根结点到每个叶结点
所经过的分支对应的0和1组成的序列便为该结点对应字符的编码。这样的
编码称为哈夫曼编码。
哈夫曼编码属0、1
二进制编码
权值越大的字符编码越短,反之越长。考点七: 哈夫曼树
哈夫曼编码
在一组字符的哈夫曼编码中,不可能出现一个字符的哈夫曼编码是另一
个字符哈夫曼编码的前缀。
例如,有4个字符的编码如下:
100,001,0,1 ×
这是哈夫曼编码吗?
每个叶子节点的层次路径有且仅有一
条,且相互之间不会出现前缀。
哈夫曼编码也称为前缀编码。考点七: 哈夫曼树
如何设计一个编码效率最高的前缀编码呢 ? 哈夫曼编码
例:一组字符{A, B, C, D, E, F, G}出现的频率分别是{9, 11, 5, 7, 8, 2, 3}
,设计最经济的编码方案
45
哈夫曼编码方案: 0 1
A:00
19 26
B:10
0 1 0 1
C:010
D:110 9 10 11 15
E:111 A 0 1 B 0 1
F:0110
5 5 7 8
G:0111
C 0 1 D E
2 3
F G考点七: 哈夫曼树
如何设计一个编码效率最高的前缀编码呢 ? 哈夫曼编码
例:一组字符{A, B, C, D, E, F, G}出现的频率分别是{9, 11, 5, 7, 8, 2, 3}
,设计最经济的编码方案
45
0 1
哈夫曼编码方案:
A:00 19 26
0 1 0 1
B:10
C:010 9 10 11 15
D:110 A 0 1 B 0 1
E:111 5 5 7 8
F:0110 C 0 1 D E
等长编码的长度:3
G:0111 2 3
F G
哈夫曼编码的平均长度:
(2×9+3×5+4×2+4×3+2×11+3×7+3×8)/45= 2.67考点七: 哈夫曼树
哈夫曼树的特点
➢ 哈夫曼树只有0度结点和2度结点
➢ 哈夫曼树的WPL值最小
➢ 哈夫曼树不唯一,因为哈夫曼树的左右子树可以交换,但是WPL值唯一
➢ 哈夫曼树本质上不属于二叉树,但是考试中我们认为哈夫曼树是二叉树
➢ 哈夫曼树的上层结点权值不小于下层结点的权值
➢ 哈夫曼编码只讨论叶子的编码【政哥题型总结】考点七: 哈夫曼树
1.设有13个值,用它们组成一棵哈夫曼树,则该哈夫曼树共有( )个结点。
A.13 B.12 C.26 D.25考点七: 哈夫曼树
1.设有13个值,用它们组成一棵哈夫曼树,则该哈夫曼树共有( )个结点。
A.13 B.12 C.26 D.25
D【解析】哈夫曼树只有度为0的结点和度为2的结点。所以给定n =13,那么
0
n =12,于是一共有25个结点。
2考点七: 哈夫曼树
2.有5个字符,根据其使用频率设计对应的哈夫曼编码,( )是不可能的哈夫
曼编码。
A.000,001,010,011,1 B.0000,0001,001,01,1
C.000,001,01,10,11 D.00,100,101,110,111考点七: 哈夫曼树
2.有5个字符,根据其使用频率设计对应的哈夫曼编码,( )是不可能的哈夫
曼编码。
A.000,001,010,011,1 B.0000,0001,001,01,1
C.000,001,01,10,11 D.00,100,101,110,111
D【解析】对于这种题目,有两种方法:第一种是查看是否符合前缀编码的定
义:在一组字符的哈夫曼编码中,不可能出现一个字符的哈夫曼编码是另一
个字符哈夫曼编码的前缀。考点七: 哈夫曼树
2.有5个字符,根据其使用频率设计对应的哈夫曼编码,( )是不可能的哈夫
曼编码。
A.000,001,010,011,1 B.0000,0001,001,01,1
C.000,001,01,10,11 D.00,100,101,110,111
D【解析】第二种是把哈夫曼树构造出来,查看违例,规则是哈夫曼树只有度
为0的结点和度为2的结点。通过观察,选项中的编码都符合前缀编码的条件,
需要通过构造哈夫曼树进行确定。根据哈夫曼树的定义,按照左0右1进行哈夫
曼树的构造,得到各个选项的哈夫曼树,
A.000,001,010,011,1考点七: 哈夫曼树
2.有5个字符,根据其使用频率设计对应的哈夫曼编码,( )是不可能的哈夫
曼编码。
A.000,001,010,011,1 B.0000,0001,001,01,1
C.000,001,01,10,11 D.00,100,101,110,111
D【解析】同理可以得到,从D选项对应的图中可以看到,存在度为1的结点,
所以不符合哈夫曼树的性质。考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后
计算它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
2 3 6 9 14 15 16 17 5 6 9 14 15 16 17
第一步 2 3
第二步考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后计算
它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
9 11 14 15 16 17
5 6 9 14 15 16 17
5 6
2 3
第二步
2 3
第三步考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后计算
它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
9 11 14 15 16 17 14 15 16 17 20
9 11
5 6
5 6
2 3
第三步
2 3
第四步考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后计算
它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
16 17 20 29
14 15 16 17 20
9 11
9 11 14 15
5 6
5 6
2 3
2 3
第四步
第五步考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后计算
它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
20 29 33
16 17 20 29
9 11
9 11 14 15 16 17
14 15
5 6
5 6
2 3
2 3
第五步 第六步考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后计算
它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
49
20 29 33
20 29 33
9 11
14 15 16 17
9 11
14 15 16 17
5 6
5 6
2 3
2 3
第六步
第七步考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后计算
它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
82
49
33
49
20 29 33
16 17
20 29
9 11
14 15 16 17
9 11
14 15
5 6
5 6
第七步
2 3
第八步
2 3考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后计算
它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
82 根据构造的哈夫曼树,得到WPL的值为
33
49 16×2+17×2+9×3+14×3+15×3+6×4
16 17
20 29 +2×5+3×5=229
9 11
14 15
5 6
2 3考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后计算
它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
平均编码长度:编码一个字符需要几个比特。
82
本题中,一共有82个字符,共需要229个比特,
33
49
因此平均编码长度是229/82。
16 17
20 29
9 11
14 15
5 6
2
3考点七: 哈夫曼树
3.设一组权值集合W={15,3,14,2,6,9,16,17},要求根据这些权值集合构造一
棵哈夫曼树,则这棵哈夫曼树的带权路径长度为( )。
A.129 B.219 C.189 D.229
D 【解析】要求哈夫曼树的带权路径长度,需要先把这棵树构造出来,然后计算
它的WPL值。根据哈夫曼树的构造方法,其构造步骤如下:
2, 3 ,6, 9, 14, 15, 16, 17
82 平均编码长度:编码一个字符需要几个比特。
33
49 推广到一般:
16 17
20 29 (1)平均编码长度 = WPL/σ𝑤
(2)当σ𝑤 = 1时,WPL=平均编码长度
9 11
14 15
5 6
2
3THANKSCON T EN T S
目录
考点一 基本术语 ★
考点二 树的性质和存储 ★★★
考点三 二叉树 ★★★★★
考点四 二叉树的遍历 ★★★★★
考点五 线索二叉树 ★★
考点六 树、森林和二叉树的关系 ★★★★
考点七 哈夫曼树 ★★★★★
考点八 并查集考点框架
定义
并查集的操作
并查集的实现【并查集的定义】考点八: 并查集
并查集(Union-find Sets)是一种非常精巧而实用的数据结构,他主要用
于处理一些不相交集合的合并问题。一些常见的用途有求连通子图、求最小
生成树的Kruskal算法和求最近公共祖先(Least Common Ancestors,
LCA)等
使用并查集时,首先会存在一组不相交的动态集合 S={S , S ,⋯,S },一般都
1 2 k
会使用一个整数表示集合中的一个元素。考点八: 并查集
每个集合可能包含一个或多个元素,并选出集合中的某个元素作为
代表。每个集合中具体包含了哪些元素是不关心的,具体选择哪个
元素作为代表一般也是不关心的。我们关心的是,对于给定的元素,
可以很快的找到这个元素所在的集合(的代表),以及合并两个元
素所在的集合,而且这些操作的时间复杂度都是常数级的。考点八: 并查集
◼ 并查集的数据结构记录了一组动态集合S={S , S ,⋯,S } 。
1 2 k
◼ 每个动态集合S (1≤i≤k)通过一个“代表”加以标识,该代表即
i
为所代表的集合中的某个元素。对于集合S ,选取其中哪个元素作
i
为代表是任意的。【并查集的操作】考点八: 并查集
并查集的基本操作有三个:
InitUFS(s):建立一个新的并查集,其中包含s个单元素集合
Union (x, y):把元素 x 和元素 y 所在的集合合并,要求 x 和 y 所在
的集合不相交,如果相交则不合并。
Find(x):找到元素 x 所在的集合的代表,该操作也可以用于判断两
个元素是否位于同一个集合,只要将他们各自的代表比较一下就可以
了。考点八: 并查集
用有根树来表示一个集合。多个集合形成一个森林,以每棵树的树根作
为集合的代表,并且根结点的父结点指向其自身,树上的其他结点都用
一个父指针表示它的附属关系。
4
3 2
1
{1,2,3,4}集合考点八: 并查集
用数组存放:t[i]对应i结点
4
3 2
1
{1,2,3,4}集合考点八: 并查集
4
3
4
2
3 2
1
1
{1,2,3,4}集合
{1,2,3,4}集合
查找1所在的集合:3次比较 查找1所在的集合:4次比较
树高度越小越好考点八: 并查集
初始状态 {1},{2},{3},{4},{5},{6},{7},{8},{9},{10}
parent
1 2 3 4 5 6 7 8 9 10
(2,4) {1},{2,4},{3},{5},{6},{7},{8},{9},{10}
1 3 4
5 6 7 8 9 10
2考点八: 并查集
1 3 4
5 6 7 8 9 10
2
(5,7) {1},{2,4},{3},{5,7},{6},{8},{9},{10}
7
1 3 4
6 8 9 10
2 5考点八: 并查集
1 3 4
6 7 8 9 10
2
5
(1,3) {1,3},{2,4},{5,7},{6},{8},{9},{10}
6 7 8 9 10
3
4
5
1 2考点八: 并查集
6 7 8 9 10
3
4
5
1 2
(8,9) {1,3},{2,4},{5,7},{6},{8,9},{10}
9
6 7 10
3
4
5 8
1 2考点八: 并查集
3 9
4 6 7 10
1 2 5 8
(1,2) {1,2,3,4},{5,7},{6},{8,9},{10}
4
9
6 7 10
2 4
5 8
3 2 3
1 1考点八: 并查集
如何保证A(根为a)和B(根为b)合并的树高度较低呢?
⚫ A和B的高度相同时,a作为b的孩子或者b作为a的孩子均可 合并树高度
=hA+1=hB+1。
⚫ A和B的高度不相同时,将较低的根作为较高根的孩子 合并树高度
=max(hA,hB)。
4
3
4
2 3
1 2
1考点八: 并查集
A A
B x B
x
4
4
2 3 1
2 3
1【并查集的实现】考点八: 并查集
1、结构体定义
为了方便,采用顺序方法存储森林,结点的类型声明如下:
typedef string ElemType;
typedef struct {
ElemType data; // 数据域
int rank; // 秩,用于启发式合并
int parent; // 父节点的下标
} UFSNode;
typedef struct {
UFSNode* nodes;
int size;
} UFSTree;考点八: 并查集
2、初始化并查集
建立一个存放并查集树的数组t.nodes,初始化每个结点的数据域data
为数组a的对应元素,rank值设置为0,parent值设置为自己。算法如下:考点八: 并查集
// 初始化并查集
bool InitUFS(UFSTree& t, ElemType a[], int n) {
if (n <= 0) {
return false;
}
t.nodes = (UFSNode*)malloc(sizeof(UFSNode) * n);
if (!t.nodes) {
return false;
}
t.size = n;
for (int i = 0; i < n; ++i) {
t.nodes[i].data = a[i]; // 初始化数据域
t.nodes[i].rank = 0; // 秩初始为0
t.nodes[i].parent = i; // 父节点初始为自身
}
return true;
}考点八: 并查集
3、查找一个元素所属的集合
元素所属的集合,就在分离集合森林中,每一棵分离集合树对应一个
集合。如果要查找某是要找这个元素对应的结点所在的分离集合树一
个结点所在的分离
不妨以分离集合树的根结点的编号来标识这个分离集合树,这样查找
集合树也就是查找该结点所在分离集合树的根结点。查找树的根结点
的方法很简单,找的那个结点),沿双只需任取树中的一个结点(不妨取
要查双亲结点为基点,走亲结点方向一直往树根走。
初始时,取一个结点,走到它的双亲结点,然后以一个没有双亲结点
的结点为止,这个给到双亲结点的双亲结点,,直至走到点就是树的
根结点考点八: 并查集
// 在并查集中查找下标为i的元素所在集合根节点的下标
int Find(UFSTree& t, int i) {
if (i < 0 || i >= t.size) {
return -1; // 下标越界
}
if (t.nodes[i].parent != i) {
return Find(t, t.nodes[i].parent);
}
return i;
}
对于n个元素,构成的分离集合树的高度最高为log n,
2
所以本算法的时间复杂度为O(log n)。
2考点八: 并查集
4、两个元素各自所属的集合的合并
在进行合并的时候,只需要让具有较小秩的根指向具有较大秩的根。如果
两根的秩相等,只需要使其中一个根指向另一个,同时秩增加1。考点八: 并查集
bool Union(UFSTree& t, int i, int j) {
i = Find(t, i); // 查找i所在集合的根节点下标
j = Find(t, j); // 查找j所在集合的根节点下标
if (i == -1 || j == -1) {
return false; // 下标越界
}
if (i == j) {
return true; // 两个元素已经在同一个集合中
}
// 将秩小的集合合并到秩大的集合中
if (t.nodes[i].rank < t.nodes[j].rank) {
t.nodes[i].parent = j;
} else if (t.nodes[i].rank > t.nodes[j].rank) {
t.nodes[j].parent = i;
} else { // 两个集合的秩相等
t.nodes[j].parent = i; // 将j所在集合合并到i所在集合中
++t.nodes[i].rank; // i的秩加1
}
return true;
对于n个元素,本算法的时间复杂度为O(log n)。
} 2THANKS第六讲:图及其应用
主讲人:刘财政
B站:@计算机考研刘财政考纲要求CON T EN T S
目录
考点一 图的基本概念 ★★★★
考点二 图的存储 ★
考点三 图的遍历 ★★
考点四 最小生成树 ★★★★★
考点五 最短路径 ★★
考点六 AOV网和拓扑排序 ★★★★★
考点七 AOE网和关键路径 ★★★★CON T EN T S
目录
考点一 图的基本概念 ★★★★
考点二 图的存储 ★
考点三 图的遍历 ★★
考点四 最小生成树 ★★★★★
考点五 最短路径 ★★
考点六 AOV网和拓扑排序 ★★★★★
考点七 AOE网和关键路径 ★★★★考点框架考点框架
图的引入
图的基本术语
图的基本性质
图抽象数据类型【图的引入】考点一: 图的基本概念
【问题】已知计算机专业的核心课程如下表所示,编制合适的教学计划。
【想法——数据模型】用顶点表示课程,如果从顶点 c到 c之间存在边
i j
<c,c>,则表示课程 c是课程 c的先修课。
i j i j
c c
课程编号 课程名称 先修课程
3 8
c
c 程序设计基础 无
1
1
c 电子技术基础 无 c c
2 4 6
c 离散数学 c
3 1
c 数据结构 c c c c
4 1
2 5 7
c 计算机原理 c c
5 1 2
c 操作系统 c c c
6 3 4 5
c 计算机网络 c c c
7 4 5 6
c 数据库原理及应用 c c
8 4 5考点一: 图的基本概念
【问题】假设有下图所示七巧板,使用至多 4 种不同颜色对七巧板涂色,
要求每个区域涂一种颜色,相邻区域的颜色互不相同。求涂色方案。
【想法——数据模型】将七巧板的每个区域看成一个顶点,如果两个区
域相邻,则这两个顶点之间有边相连,从而将七巧板抽象为图结构。
A B
B
C
A 抽象 F C
D G
E
F G
E D考点一: 图的基本概念
【问题】出席某国际会议的六个成员A、B、C、D、E、F,假设A会讲
汉语、法语和日语,B会讲德语、日语和俄语,C会讲英语和法语,D会
讲汉语和西班牙语,E会讲英语和德语,F会讲俄语和西班牙语,如将此
六人分成两组,能否出现同一组内任意两人不能直接交谈的情况?
【想法——数据模型】将成员看成一个顶点,如果两个成员可以直接交
谈,则这两个顶点之间有边相连,从而将分组问题抽象为图结构——二
部图。
A E F
V ={A, E, F}
1
V ={B, C, D}
2
B C D【图的基本术语】考点一: 图的基本概念
数据元素
通常表示为:
G = (V,E )
顶点之间边的集合
顶点的集合
图的顶点集合为什么不能是空集?考点一: 图的基本概念
a a a a a
1 2 i-1 i n
A
v v
0 1
B C
v
3
v v
D E F
4 2
线性结构中,数据元素之间具有线性关系,逻辑关系表现为前驱-后继;
树结构中,结点之间具有层次关系,逻辑关系表现为双亲-孩子
图结构中,任意两个顶点之间都可能有关系,逻辑关系表现为邻接考点一: 图的基本概念
v v 无向图
0 1
图(边是否有方向)
有向图
v
3
v v
4 2
无向边:表示为(v ,v ),顶点v 和v 之间的边没有方向
i j i j
无向图:图中任意两个顶点之间的边都是无向边考点一: 图的基本概念
v v
0 1 无向图
图(边是否有方向)
有向图
v v
4 2
有向边(弧):表示为<v ,v >,从v 到v 的边有方向
i j i j
有向图:图中任意两个顶点之间的边都是有向边考点一: 图的基本概念
2
v v
0 1
权:对边赋予的有意义的数值量
7
v
5 6
3
带权图(网图):边上带权的图
3
8
v v
4 2
非带权图
图(边上是否带权)
2
带权图
v v
0 1
7
5
8
v v
4 2考点一: 图的基本概念
v v
0 1
稠密图:边数很多的图
v
3
稠密图
图(边数的多寡)
v v 稀疏图
4 2
v v
0 1
稀疏图:边数很少的图
v
3
v v
4 2【图的基本性质】考点一: 图的基本概念
v v 邻接、依附:无向图中,对于任意两个顶
0 1
点 v 和顶点 v,若存在边(v,v),则称顶
i j i j
v
点 v和顶点 v互为邻接点,同时称边(v,
3 i j i
v)依附于顶点 v和顶点 v
j i j
v v
4 2
v 的邻接点: v v
0 1 、 4
v 的邻接点: v v
2 1 、 3考点一: 图的基本概念
v v
邻接、依附:有向图中,对于任意两个顶
0 1
点 v和顶点 v,若存在弧<v,v>,则称
i j i j
顶点 v 邻接到 v ,顶点 v 邻接自v ,同
i j j i
时称弧<v,v>依附于顶点 v和顶点 v
i j i j
v v
4 2
v 的邻接点: v v
0 1 、 2
v 的邻接点: v
2 0考点一: 图的基本概念
v v
无向完全图:无向图中,任意两个顶点之间都存在边
0 1
n 个顶点的无向完全图有多少条边?
n×(n-1)/2
v v
4 2考点一: 图的基本概念
v v 有向完全图:有向图中,任意两个顶点
0 1
之间都存在方向相反的两条弧
n×(n-1)
n 个顶点的有向完全图有多少条弧?
v
2考点一: 图的基本概念
v v
0 1 顶点的度:在无向图中,顶点 v 的度是
指依附于该顶点的边数,通常记为TD (v)
v
3
TD (v ) = 2,TD (v ) = 3
0 3
v v
4 2考点一: 图的基本概念
v v
0 1
在具有 n个顶点、e条边的无向图中,各
顶点的度之和与边数之和有什么关系?
v
3
v v
4 2
ni
=
− 1
0
T D ( v
i
) = 2 e考点一: 图的基本概念
v v
顶点的入度:在有向图中,顶点 v 的入度是
0 1
指以该顶点为弧头的弧的数目,记为ID (v);
顶点的出度:在有向图中,顶点 v 的出度是指
v v
以该顶点为弧尾的弧的数目,记为OD (v);
4 2
ID (v ) = 1, OD (v ) = 2,
0 0考点一: 图的基本概念
v v
在具有 n 个顶点、e 条边的有向图中,
0 1
各顶点的入度之和与各顶点的出度之和
有什么关系?与边数之和有什么关系?
v v
4 2
ni
=
− 1
0
I D ( v
i
) =
ni
=
− 1
0
O D ( v
i
) = e考点一: 图的基本概念
v v
路径:在无向图中,顶点v 和顶点v 之间
0 1
p q
的 路 径 是 一 个 顶 点 序 列 (v =v ,v ,…,
p i0 i1
v
v =v ),其中(v ,v)∈E(1≤j≤m)
3
im q ij-1 ij
v v
顶点 v 和顶点 v 之间的路径:
4 2
0 4
v v v v v v v v v v v
0 4、 0 1 3 4、 0 1 2 3 4、考点一: 图的基本概念
v v
路径:在有向图中,从顶点v 到顶点v 的
0 1 p q
路 径 是 一 个 顶 点 序 列 (v =v ,v , …,
p i0 i1
v =v ),其中<v ,v>∈E(1≤j≤m)
im q ij-1 ij
v v
从顶点 v 到顶点 v 的路径:
4 2
0 4
v v v v v
0 4、 0 1 4考点一: 图的基本概念
v v
0 1 回路(环):第一个顶点和最后一个顶点相同的路径
简单路径:序列中顶点不重复出现的路径
v v
4 2
简单回路(简单环):除了第一个顶点和最
后一个顶点外,其余顶点不重复出现的回路。考点一: 图的基本概念
v v
路径长度:非带权图——路径上边的个数
0 1
路径长度:带权图——路径上边的权值之和
v
3
顶点 v 和顶点 v 之间的路径长度:
0 4
v v v v :5
v v:1
4 2 0 4
0 4
v v v v :17
v v v v:3
0 1 3 4
2 0 1 3 4
v v v v v v v :21
0 1 v v v v v:4 0 1 2 3 4
0 1 2 3 4
7
5 v 6
3
3
8
v v
4 2考点一: 图的基本概念
不致混淆的情况下,路径和回路都是简单的
不存在平行边或者自环边。考点一: 图的基本概念
子图:若图G=(V, E),G'=(V', E'),如果V'V且E'E,则称图G'
是G的子图
v v v v v
0 1 0 0 1
v v v v v
3 2 3 2 3
v v
0 1
v v
3 2考点一: 图的基本概念
子图:若图G=(V, E),G'=(V', E'),如果V'V且E'E,则称图G'
是G的子图
1
1
2 3 0
2 3
0
4
4考点一: 图的基本概念
子图:若图G=(V, E),G'=(V', E'),如果V'V且E'E,则称图G'
是G的子图
v v v v
v v
0 1 0 1
0 1
v
v
3
3
v v v v
4 2 0 1
v
3
v v
4 2考点一: 图的基本概念
v v
0 1
连通顶点:在无向图中,如果顶点v 和顶点
i
v(i≠j)之间有路径,则称顶点v和v是连通的
j i j
v
3
连通图:在无向图中,如果任意两个顶点
v v
都是连通的,则称该无向图是连通图
4 2
v v v v v v
0 1 0 1 0 1
v v
3 3
v v v v v
4 2 2 4 2考点一: 图的基本概念
连通分量:非连通图的极大连通子图
含有极大顶点数
v v
0 1
依附于这些顶点的所有边
v v
0 1
v
4
v v v
5 3 2
v
6
v
v v 4
3 2
v
5
v
6
连通分量是对无向图的一种划分考点一: 图的基本概念
生成树:连通图的生成树是包含全部顶点的一个极小连通子图
v
多——构成回路
1
含有n-1条边
少——不连通
v v v v v
v v
0 3 2 0 1
0 1
v
v v
3
v
4 3
0
v v
v v
4 2
4 2
v v
4 1
v v
0 1
v v
3 2 v
3
v v
4 2考点一: 图的基本概念
生成树:连通图的生成树是包含全部顶点的一个极小连通子图
关于无向图的生成树的几个结论:
◆ 一棵有n个顶点的生成树有且仅有n-1条边;
◆ 如果一个图有n个顶点和小于n-1条边,则是非连通图;
◆ 如果多于n-1条边,则一定有环;
◆ 有n-1条边的图不一定是生成树。
a d a d a d
b c
b c
b c
图G的一棵生成树 图G的一棵生成树
无向图G考点一: 图的基本概念
v v 强连通顶点:在有向图中,如果从顶
0 1
点v到顶点v和从顶点v到顶点v均有
i j j i
路径,则称顶点v和v是强连通的
i j
强连通图:在有向图中,如果任意两个顶点
v v
3 2
都是强连通的,则称该有向图是强连通图
v v v
0 0 1
v v v
3 2 3考点一: 图的基本概念
强连通分量:非强连通图的极大连通子图
含有极大顶点数
依附于这些顶点的所有边 v
0
v v
0 1
v v
4 2
v v
3 2 v
1考点一: 图的基本概念
图中每一条边都可以附带有一个对应的数值,这种与边相关的数值
称为权。权可以表示从一个顶点到另一个顶点的距离或花费的代价。
边上带有权的图称为带权图,也称作网。
2
1
3 2
5
0
6 3
一个网【图抽象数据类型】考点一: 图的基本概念
图是一种与具体应用密切相关的数据结构,基本操作有很大差别
ADT Graph
DataModel
顶点的有穷非空集合和顶点之间边的集合
Operation
CreatGraph:图的建立
DestroyGraph:图的销毁,释放图占用的存储空间
DFTraverse:深度优先遍历图
简单起见,只讨论图的遍历
BFTraverse:广度优先遍历图
endADT【政哥题型总结】考点一: 图的基本概念
1、一个有 n 个结点的图,最少有()个连通分量,最多有()个连通分量
A.0 B.1 C.n-1 D.n考点一: 图的基本概念
1、一个有 n 个结点的图,最少有()个连通分量,最多有()个连通分量
A.0 B.1 C.n-1 D.n
B,D 【解析】根据连通分量的定义,给定n个结点的图,最少的情况是所有
的结点是联通的,需要有一个连通分量;给定n个结点的图,每一个孤零零的
点也是一个连通分量,此时该图中只有结点,没有边,最多有n个联通分量。考点一: 图的基本概念
2、在一个无向图中,所有顶点的度数之和等于所有边数()倍,在一个有向
图中,所有顶点的入度之和等于所有顶点出度之和的()倍。
A.1/2 B.2 C.1 D.4考点一: 图的基本概念
2、在一个无向图中,所有顶点的度数之和等于所有边数()倍,在一个有向
图中,所有顶点的入度之和等于所有顶点出度之和的()倍。
A.1/2 B.2 C.1 D.4
B,D【解析】根据度的性质,所有顶点的度数之和等于所有边数2倍;有顶
点的入度之和等于所有顶点出度之和的1倍,也等于图中边的数量。考点一: 图的基本概念
3、给定包含6个顶点的无向图G,顶点的度数值3,3,4,4,5,5,则图G中的边数为()。
A. 11 B. 12 C. 13 D. 14考点一: 图的基本概念
3、给定包含6个顶点的无向图G,顶点的度数值3,3,4,4,5,5,则图G中的边数为()。
A. 11 B. 12 C. 13 D. 14
B【解析】在无向图中,所有顶点度的和是图中边的2倍,给定包含6个顶点的无向
图G,顶点的度数值3,3,4,4,5,5,则图G中的边数为(3+3+4+4+5+5)/2=12,因
此选择B。考点一: 图的基本概念
4、若无向图G =(V,E)中含10个顶点,要保证图G 在任何情况下都是连通的,
则需要的边数最少是:( )
A.45 B.37 C.36 D.9考点一: 图的基本概念
B【解析】图连通有三个临界条件:假设给定n个顶点的无向图,
(1) 当边数E= n-1时,若图连通,构成生成树,则此时是图连通的最小边数,但
是无法确保任何情况下均连通。
(2)当边数E = (n-1)* n/2时,构成完全无向图,则此时可以确保图在任何
情况下均连通,但是无法实现边数最少。
(3)当边数E= (n-2)* (n-1)/2 + 1时,此时让(n-1)个顶点构成完全无
向图,再多一条边,则此时可以确保图在任何情况下均连通,且满足边数最少。
因此,若无向图G =(V,E)中含10个顶点,要保证图G 在任何情况下都是连通的,
则需要的边数最少是C(9,2)+1=9*8/2+1=37,因此选择B。考点一: 图的基本概念
5、非连通无向图有45条边,顶点数最少有多少个( )
A.10 B.11 C.12 D.13考点一: 图的基本概念
5、非连通无向图有45条边,顶点数最少有多少个( )
A.10 B.11 C.12 D.13
B【解析】当边数E= (n-2)* (n-1)/2 + 1时,此时让(n-1)个顶点构成
完全无向图,再多一条边,则此时可以确保图在任何情况下均连通,且满足
边数最少。,n个顶点无向图最多有C(n,2)=n(n-1)/2条边,n(n-1)/2=45,可
得n=10,外加一个孤立顶点,因此顶点数最少有10+1=11,因此选择B。THANKSCON T EN T S
目录
考点一 图的基本概念 ★★★★
考点二 图的存储 ★
考点三 图的遍历 ★★
考点四 最小生成树 ★★★★★
考点五 最短路径 ★★
考点六 AOV网和拓扑排序 ★★★★★
考点七 AOE网和关键路径 ★★★★考点框架考点框架
图的存储概述
邻接矩阵
邻接表
邻接多重表
十字链表【图的存储概述】考点二: 图的存储
映射
图的
图的
逻辑结构
存储结构
存储每个顶点的信息
存储每条边的信息考点二: 图的存储
在图中,任何两个顶点之间都可能存在关系(边)
无法通过存储位置表示这种任意的逻辑关系
图无法采用顺序存储结构
如何存储图呢? 如何存储顶点
分别考虑
如何存储边
图是由顶点和边组成考点二: 图的存储
映射
图的
图的
逻辑结构
存储结构
图的两种主要存储结构:
邻接矩阵
邻接表
邻接多重表
十字链表【邻接矩阵】考点二: 图的存储
邻接矩阵也称数组表示法,其基本思想是:
一维数组:存储图中顶点的信息
二维数组(邻接矩阵):存储图中各顶点之间的邻接关系
设G=(V,E)有 n个顶点,则邻接矩阵是一个 n×n的方阵,定义为:
1 若(v, v)∈E(或<v, v>∈E)
A[i][j]=
i j i j
0 其它考点二: 图的存储
G的邻接矩阵A是n 阶方阵,其定义如下:
(1)如果G是无向图,则:
A[i ][ j ]=1:若(i,j )∈E(G)
0:其他
不带权图
(2)如果G是有向图,则:
A[i ][ j ]=1:若<i,j >∈E(G)
0:其他考点二: 图的存储
(3)如果G是带权无向图,则:
A[i ][ j ]= w :若i≠j 且(i,j )∈E(G)
ij
0: i=j
∞: 其他
带权图
(4)如果G是带权有向图,则:
A[i ][ j ]= w :若i≠j 且<i,j>∈E(G)
ij
0: i=j
∞: 其他考点二: 图的存储
0 1 2 3
v v v v
vertex =
0 1 2 3
v v
0 1 v v v v
0 1 2 3
v
0 1 0 1
0
v
1 0 1 1
1
A[i][j] =
v v
3 2 v 0 1 0 1
2
v
1 1 1 0
3
无向图的邻接矩阵有什么特点? 对称矩阵
如何求顶点 v的度? 第 v 行(或第 v 列)非零元素的个数
如何判断顶点 i和 j 之间是否存在边? if (A[i][j] == 1)考点二: 图的存储
0 1 2 3
v v v v
vertex =
0 1 2 3
v v
0 1 v v v v
0 1 2 3
v
0 1 0 1
0
v
1 0 1 1
1
A[i][j] =
v v
3 2 v 0 1 0 1
2
v
1 1 1 0
3
如何求顶点 i的所有邻接点? 扫描第 i行
for (j = 0; j < n; j++)
if (A[i][j] == 1)
顶点 j 是顶点 i 的邻接点考点二: 图的存储
无向图邻接矩阵: 无向图邻接矩阵的特性
◆ 邻接矩阵是对称方阵;
◆ 邻接矩阵是唯一的
◆ 对于顶点v ,其度数是第i行的非0元素的个数;
i
◆ 无向图的边数是上(或下)三角形矩阵中非0元素个数。考点二: 图的存储
0 1 2 3
v v v v
vertex =
0 1 2 3
v v
0 1
v v v v
0 1 2 3
v
0 1 0 1
0
v
0 0 0 0
1
v v
A[i][j] =
3 2 v
1 0 0 0
2
v
1 0 1 0
3
有向图的邻接矩阵一定不对称吗? 顶点间存在方向相反的弧
如何求顶点 v的出度? 第 v 行非零元素的个数
第 v 列非零元素的个数
如何求顶点 v的入度?考点二: 图的存储
0 1 2 3
v v v v
2 vertex =
v v 0 1 2 3
0 1
v v v v
0 1 2 3
5 7 v 0 2 ∞ 5
0
v
2 0 ∞ 7
1
8
v v A[i][j] =
v
3 2 ∞ ∞ 0 8
2
v
5 7 8 0
3
网图的邻接矩阵可定义为:
w 若(v , v )∈E(或<v , v >∈E)
ij i j i j
arc[i][j]= 0 若i = j
∞ 其他考点二: 图的存储
邻接矩阵的特性
➢ 给定图,邻接矩阵唯一
➢ 邻接矩阵所占的空间开销是O(N2), 其中N是顶点个数,与边的个数无关,
➢ 邻接矩阵适合于稠密图,不适合于稀疏图
➢ 计算度通过遍历行或者列来实现考点二: 图的存储
#define MAXSIZE 100 // 最大顶点数
#define INF 65535 // 无穷大,用于表示两个顶点之间没有边
typedef char VertexInfo; // 顶点相关信息,这里表示顶点名称
typedef int ArcInfo; // 边相关信息,这里表示权值
typedef struct {
ArcInfo edges[MAXSIZE][MAXSIZE]; // 邻接矩阵
VertexInfo vexs[MAXSIZE]; // 存放顶点信息
int n, e; // 图的顶点数和边数
} MGraph;
typedef struct {
int src; // 边的起点
int dest; // 边的终点
ArcInfo weight; // 边的权值
} Edge;【邻接表】考点二: 图的存储
1、邻接表概述
基本思想:对图的每个顶点建立一个单链表,存储该顶点所有邻接顶点及其相
关信息。每一个单链表设一个表头结点。
第i个单链表表示依附于顶点V 的边(对有向图是以顶点V 为头或尾的弧)。
i i
0 v 1 2 3 ⋀
1
1 v 0 2 ⋀
v 2
4
v 2 v 0 1 3 4 ⋀
1 3
v
5 3 v 0 2 4 ⋀
4
v v
2 3 4 v 2 3 ⋀
5
┇ ┇
MAX_VEX-1
无向图及其邻接链表考点二: 图的存储
在图的邻接链表表示中,所有顶点结点用一个向量以顺序结构形式存储,
可以随机访问任意顶点的链表,该向量称为表头向量,向量的下标指示顶点
的序号。
0 v
1
1 v
2
2 v
3
3 v
4
4 v
5
┇ ┇考点二: 图的存储
每个单链表上添加一个表头结点(表示顶点信息)。并将所有表
头结点构成一个数组,下标为i 的元素表示顶点i 的表头结点。
0 v 1 3 4 ∧
0
1
1 v 0 2 3 ∧
1
2 v 1 3 4 ∧
2 3 0 2
3 v 0 1 2 4 ∧
3
4
4 v 0 2 3 ∧
4考点二: 图的存储
2、邻接表结点结构
链表中的结点称为表结点,每个结点由三个域组成,如图(a)所示。
其中邻接点域(adjvex)指示与顶点V 邻接的顶点在图中的位置(顶点编
i
号),链域(nextarc)指向下一个与顶点V 邻接的表结点,数据域(info)
i
存储和边或弧相关的信息,如权值等。对于无权图,如果没有与边相
关的其他信息,可省略此域。
每个链表设一个表头结点(称为顶点结点),由两个域组成,如图所
示。链域(firstarc)指向链表中的第一个结点,数据域(data) 存储顶点
名或其他信息。
表结点: adjvex info nextarc
顶点结点: data firstarc考点二: 图的存储
图的邻接表存储方法是一种顺序分配与链式分配相结合的存储方法。
1 3 4 ∧
0 v
0
1 v 0 2 3 ∧
1
找顶点2的边 2 v 1 3 4 ∧
2
3 v 0 1 2 4 ∧
3
4 v 0 2 3 ∧
4
边信息
两类结点 data firstarc adjvex nextarc weight
如权
头结点 边结点考点二: 图的存储
2
1
一个网
3 2
5
0
6 3
0 v 1 3 2 5 3 6 ∧
0
1 v 2 2 ∧
1
2 v ∧
2
3 v ∧
3
邻接表创建完毕考点二: 图的存储
邻接表表示不唯一。
1
0 v 1 3 4 ∧
0
2 3 0
0 v 3 1 4 ∧
0
4考点二: 图的存储
头插法,尾插法
1 2 3 ⋀
0 v
v 1
4
v 1 v 0 2 ⋀
1
2
v
5 2 v 0 1 3 4 ⋀
3
v 2 v 3 3 v 4 0 2 4 ⋀
4 v
2 3 ⋀
5
┇ ┇
MAX_VEX-1
无向图及其邻接链表考点二: 图的存储
头插法,尾插法
v
4
v 0 v 2 1 3 ⋀
1 1
v
1 v 0 ⋀
5
2
v v 2 v 3 0 1 4 ⋀
2 3 3
3 v 1 2 ⋀
4
(a) 有向图
4 v 1 3 ⋀
5
┇ ┇ ┇
MAX_VEX-1
(b) 正邻接链表,出度直观考点二: 图的存储
头插法,尾插法
v
4
v
1 0 v 1 2 ⋀
1
v
5 1 v 2 0 2 ⋀
2
v v 2 v 3 1 3 ⋀
2 3
v 2 0 4 ⋀
3 4
(a) 有向图 v 1 2 ⋀
4 5
┇ ┇ ┇
MAX_VEX-1
(c) 逆邻接链表,入度直观考点二: 图的存储
3、邻接表的特点
◆ 表头向量中每个分量就是一个单链表的头结点,分量个数就是图
中的顶点数目;
◆ 在无向图,顶点Vi的度是第i个链表的结点数;
无向图及其邻接链表考点二: 图的存储
边表中的结点表示什么? 对应图中的一条边
O
设图有n个顶点e条边,邻接表的空间复杂度是多少?
(n+e )
◆ 在边或弧稀疏的条件下,用邻接表表示比用邻接矩阵
表示节省存储空间
无向图及其邻接链表考点二: 图的存储
◆ 对有向图可以建立正邻接表或逆邻接表。正邻接表是以顶点Vi为出度(即为弧
的起点)而建立的邻接表;逆邻接表是以顶点Vi为入度(即为弧的终点)而建立的
邻接表;
◆ 在有向图中,第i个链表中的结点数是顶点Vi的出 (或入)度;求入 (或出)度,
须遍历整个邻接表;
◆ 在邻接表上容易找出任一顶点的第一个邻接点和下一个邻接点;考点二: 图的存储
#define MAXSIZE 100 // 最大顶点数
typedef int ArcInfo; // 边相关信息,这里表示权值
typedef struct ArcNode {
int adjvex; // 该边所指向的顶点的位置
struct ArcNode* nextarc; // 指向下一条边的指针
ArcInfo info; // 边相关信息,这里表示权值
} ArcNode; // 表结点(边结点)定义
typedef char VertexInfo; // 顶点相关信息,这里表示顶点名称
typedef struct VNode {
VertexInfo info; // 顶点相关信息,这里表示顶点名称
ArcNode* firstarc; // 指向第一条依附该顶点的边的指针
} VNode; // 表头结点(顶点结点)定义考点二: 图的存储
#define MAXSIZE 100 // 最大顶点数
typedef struct {
VNode adjlist[MAXSIZE]; // 邻接表的表头结点数组
int n, e; // 图中的顶点数n和边数e
} ALGraph; // 图的邻接表定义
typedef struct {
int src; // 边的起点
int dest; // 边的终点
ArcInfo weight; // 边的权值
} Edge;【邻接多重表】考点二: 图的存储
邻接多重表(Adjacency Multilist)是无向图的另一种链式存储结构。
邻接表是无向图的一种有效的存储结构,在无向图的邻接表中,
一条边(v,w)的两个表结点分别初选在以v和w为头结点的链表中,
很容易求得顶点和边的信息,但在涉及到边的操作会带来不便。
邻接多重表的结构和十字链表类似,每条边用一个结点表示;邻
接多重表中的顶点结点结构与邻接表中的完全相同,考点二: 图的存储
邻接多重表是无向图的另外一种存储结构,与十字链表类似。
与无向图的邻接表相比,对图的边的操作(标记或删除)更便利。
头结点类型 边结点类型:(i,j)
data firstedge mark ivex ilink jvex jlink weight
顶 的 附 第 标 边 点 下 边 点 下 边
点 边 该 一 志 的 i 一 的 j 一 的
信 顶 条 域 顶 的 条 顶 的 条 权
息 点 依 点 边 依 点 边 依
i 结 附 j 结 附
点 于 点 于
顶 顶
标志域mark标记边是否搜索过等,这里没有使用!考点二: 图的存储
0 1
一条边为(i,j ),不考虑边权值
邻接多重表 2
3 4
0 v 0 1 0 ∧ 3 ∧
0
v
1
1
2 v 2 1 2 3
2
v
3
3
4 v 4 1 ∧ 2 ∧ 4 ∧
4考点二: 图的存储
0
边(i,j ):创建一个边结点p
邻接多重表创建过程 2 采用头插法将其插入到i 头结点的ilink链表中
采用头插法将其插入到j 头结点的jlink链表中
1
读取边(0,1)
读取边(0,2)
读取边(1,2)
0 v ∧ 0 2 ∧ 0 ∧ 1 ∧
0
1 v ∧
1
1 2 ∧ 创
建
2 v ∧
2 完
毕【十字链表】考点二: 图的存储
在这种结构中,每条弧的弧头结点和弧尾结点都存放在链表中,并将弧
结点分别组织到以弧尾结点为头(顶点)结点和以弧头结点为头(顶点)结点
的链表中。考点二: 图的存储
十字链表是有向图的另外一种存储结构,它是邻接表和逆邻接表的结合。
头结点类型 边结点类型
data firstin firstout tailvex headvex hlink tlink weight
起 终 点 下 相 点 下 相 边
顶 入 出
点 点 ( 一 同 ( 一 同 的
点 边 边
出 个 起 入 个 终 权
信 信 信
边 边 点 边 边 点
息 息 息
) 结 的 ) 结 的考点二: 图的存储
0 1
十字链表 边权值没有画出
入边 出边
2 3
0 v 0 1 0 2 ∧
0
1 v ∧
1
2 v 2 0 2 3 ∧ ∧
2
3 v 3 0 ∧ 3 1 ∧ 3 2 ∧ ∧
3考点二: 图的存储
边<i,j>:创建一个边结点p
创建过程
采用头插法将其插入到i 头结点的hlink链表(出边)中
采用头插法将其插入到j 头结点的tlink链表(入边)中
0
2
读取边<0,1>
1
读取边<0,2>
读取边<1,2>
入边 出边
0 v ∧ ∧ 0 2 ∧ 0 1 ∧ ∧
0
1 v ∧ ∧ 创
1
1 2 ∧
建
完
2 v ∧ ∧ 毕
2【政哥题型总结】考点二: 图的存储
给定一个如图所示的无向图,画出该图的邻接矩阵和邻接表。考点二: 图的存储
给定一个如图所示的无向图,画出该图的邻接矩阵和邻接表。
【解析】按照邻接矩阵和邻接表的定义构造邻接矩阵和邻接表。该图是无向图,
在构造邻接矩阵时,使用1表示有边,使用0表示无边。该图的邻接矩阵如图所示。考点二: 图的存储
给定一个如图所示的无向图,画出该图的邻接矩阵和邻接表。
大家注意,邻接表的表示不是唯一的,其结点的顺序可能是不一样的,大家只需
要根据定义来画即可。该图的邻接表如图所示。THANKSCON T EN T S
目录
考点一 图的基本概念 ★★★★
考点二 图的存储 ★
考点三 图的遍历 ★★
考点四 最小生成树 ★★★★★
考点五 最短路径 ★★
考点六 AOV网和拓扑排序 ★★★★★
考点七 AOE网和关键路径 ★★★★考点框架考点框架
图遍历的概念
深度优先遍历
广度优先遍历【图遍历的概念】考点三: 图的遍历
从给定图中任意指定的顶点(称为初始点)出发,按照某种搜索方
法沿着图的边访问图中的所有顶点,使每个顶点仅被访问一次,这
个过程称为图的遍历。
图的遍历得到的顶点序列称为图遍历序列。考点三: 图的遍历
◼ 图的遍历(Travering Graph):从图的某一顶点出发,访遍图中的其
余顶点,且每个顶点仅被访问一次。图的遍历算法是各种图的操作
的基础。
◆ 复杂性:图的任意顶点可能和其余的顶点相邻接,可能在访问了
某个顶点后,沿某条路径搜索后又回到原顶点。考点三: 图的遍历
◼ 图的遍历(Travering Graph):从图的某一顶点出发,访遍图中的其余
顶点,且每个顶点仅被访问一次。图的遍历算法是各种图的操作的基础。
◆ 解决办法:在遍历过程中记下已被访问过的顶点。设置一个辅助向
量visited[1…n](n为顶点数),其初值为0,一旦访问了顶点v 后,使
i
visited[i]为1或为访问的次序号。
图的遍历算法有深度优先搜索算法和广度优先搜索算法。
采用的数据结构是(正)邻接链表。考点三: 图的遍历
深度优先遍历(DFS)。
广度优先遍历(BFS)。【深度优先遍历】考点三: 图的遍历
深度优先搜索(Depth First Search--DFS)遍历类似树的先序遍历,是树
的先序遍历的推广。
1)算法思想
设初始状态时图中的所有顶点未被访问,则:
⑴ :从图中某个顶点v 出发,访问v ;然后找到vi的一个邻接顶点v ;
i i i1
⑵:从v 出发,深度优先搜索访问和v 相邻接且未被访问的所有顶点;
i1 i1
⑶: 转⑴ ,直到和vi相邻接的所有顶点都被访问为止
⑷ :继续选取图中未被访问顶点v 作为起始顶点,转(1),直到图中所
j
有顶点都被访问为止。考点三: 图的遍历
v 1 3 4 ∧
0
0
v 0 2 3 ∧
1
1
v 1 3 4 ∧
2
2
v 0 1 2 4 ∧
3
3
v 0 2 3 ∧
4
4
11
v=2的DFS序列:
2 1 0 3 4
22 33 00
遍历过程结束
44
DFS思路:距离初始顶点越远越优先访问!考点三: 图的遍历
深度优先遍历的过程体现出后进先出的特点:用栈或递归方式实现。
如何确定一个顶点是否访问过? 设置一个visited[] 全局数组,
visited[i ]=0表示顶点i 没有访问; visited[i ]=1表示顶点i 已经访问过。
i visited[i ]考点三: 图的遍历
// 以src为源点,深度优先遍历图g,visited为访问标记数组,visit为访问函数
void DFS(ALGraph& g, int src, bool visited[], void (*visit)(VNode)) {
if (src >= g.n) {
return; // 超出范围
}
visited[src] = true; // 标记src已访问
visit(g.adjlist[src]); // 访问src
for (ArcNode* arc = g.adjlist[src].firstarc; arc; arc = arc->nextarc) {
if (!visited[arc->adjvex]) {
DFS(g, arc->adjvex, visited, visit); // 遍历未访问的邻接点
}
}
}考点三: 图的遍历考点三: 图的遍历
假设初始点=2,调用DFS(G,2)的执行过程如下
①DFS(G,2):访问顶点2,找顶点2的相邻顶点1,它未被访问过,转②;
②DFS(G,1):访问顶点1,找顶点1的相邻顶点0,它未被访问过转③;
③DFS(G,0):访问顶点0,找顶点0的相邻顶点1,它已被访问,找下一个相邻顶点3,
它未被访问过,转④;考点三: 图的遍历
④DFS(G,3):访问顶点3,找顶点3的相邻顶点1、2,它们均已被访问,找下一个相邻
顶点4,它未被访问过,转⑤;
⑤DFS(G,4):访问顶点4,找顶点4的相邻顶点,所有相邻顶点均已被访问,退出
DFS(G,4),转⑥;
⑥继续DFS(G,3):顶点3的所有后继相邻顶点均已被访问,退出DFS(G,3),转⑦;考点三: 图的遍历
⑦继续DFS(G,0):顶点0的所有后继相邻顶点均已被访问,退出 DFS(G,0),转⑧;
⑧继续DFS(G,1):顶点1的所有后继相邻顶点均已被访问,退出 DFS(G,1),转⑨;
⑨继续DFS(G,2):顶点2的所有后继相邻顶点均已被访问,退出DFS(G,1),转⑩;
⑩ 结束。考点三: 图的遍历
由算法思想知,这是一个递归过程。因此,先设计一个从某个顶点(编号)
为v0开始深度优先搜索的函数,便于调用。
在遍历整个图时,可以对图中的每一个未访问的顶点执行所定义的函数。
v
v
4
4
v
v
1
1
v
v
5
5
v v v v
2 3 2 3考点三: 图的遍历
由算法思想知,这是一个递归过程。因此,先设计一个从某个顶点(编号)
为v0开始深度优先搜索的函数,便于调用。
在遍历整个图时,可以对图中的每一个未访问的顶点执行所定义的函数。
v v
4 4
v v
1 1
v v
5 5
v v v v
2 3 2 3考点三: 图的遍历
v
v6 4
v
1
v7
v
5
v8
v v
2 3
➢ 对⽆向图进⾏DFS遍历 调⽤DFS函数的次数=连通分量数
➢ 对于连通图,只需调⽤1次 DFS考点三: 图的遍历
// 深度优先遍历图g,visit为访问函数
void DFSTraverse(ALGraph& g, void (*visit)(VNode)) {
bool visited[MAXSIZE] = {false}; // 初始化访问标记数组
for (int i = 0; i < g.n; ++i) {
if (!visited[i]) {
DFS(g, i, visited, visit); // 若未访问,则递归访问该顶点
}
}
}考点三: 图的遍历
对于具有n个顶点、e条边的有向图或无向图,DFS算法对图中的每个顶点最
多调用一次,因此其递归调用总次数为n。当访问某个顶点v时,DFS的时间主要
花在从该顶点出发查找它的邻接点上。
当用邻接表表示图时,需要遍历该顶点的所有邻接点,所以DFS的总时间为
O(n+e);
当用邻接矩阵表示图时,需要遍历该顶点行的所有元素,所以 DFS的总时间为
O(n2)。考点三: 图的遍历
深度优先遍历生成树
v v
4 4
v v
1 1
v v
5 5
v v v v
2 3 2 3
v
4
v
1
v
5
v v
2 3考点三: 图的遍历
深度优先生成森林
v
4
v6
v
1
v v7
5
v8
v v
2 3
v
4
v6
v
1
v v7
5
v8
v v
2 3【广度优先遍历】考点三: 图的遍历
1、广度优先搜索(BFS)
广度优先搜索(Breadth First Search--BFS)遍历类似树的按层次遍历的过程。
1)算法思想
设初始状态时图中的所有顶点未被访问,则:
⑴ 从图中某个顶点v 出发,访问v ;
i i
⑵ 访问v 的所有相邻接且未被访问的所有顶点v ,v ,…,v ;
i i1 i2 im
⑶ 以v ,v , …,v 的次序,以v (1<=j<=m)依此作为v ,转⑴;
i1 i2 im ij i
⑷ 继续选取图中未被访问顶点v 作为起始顶点,转⑴,直到图中所有顶点
k
都被访问为止。考点三: 图的遍历
广度优先搜索遍历体现先进先出的特点,用队列实现。
(1)访问初始点v,接着访问v 的所有未被访问过的邻接点v,v,…,v 。
1 2 t
(2)按照v,v,…,v的次序,访问每一个顶点的所有未被访问过的邻接
1 2 t
点。
(3)依次类推,直到图中所有和初始点v有路径相通的顶点都被访问过为
止。
如何确定一个顶点是否访问过? 设置一个visited[]数组, visited[i ]=0表示
顶点i 没有访问; visited[i ]=1表示顶点i 已经访问过。
i visited[i ]考点三: 图的遍历
0 v 1 3 4 ∧
0
1 v 0 2 3 ∧
1
2 v 1 3 4 ∧
2
3 v 0 1 2 4 ∧
3
4 v 0 2 3 ∧
4
11 v=2的BFS序列:
2 1 3 4 0
22 33 00
遍历过程结束
44
BFS思路:距离初始顶点越近越优先访问!考点三: 图的遍历
// 以src为源点,广度优先遍历图g,visited为访问标记数组,visit为访问函数
void BFS(ALGraph& g, int src, bool visited[], void (*visit)(VNode)) {
if (src >= g.n) { return; }// 超出范围
queue<int> q;
q.push(src); // 将src入队
visited[src] = true; // 标记src已访问
visit(g.adjlist[src]); // 访问src
while (!q.empty()) {
int v = q.front();
q.pop();
for (ArcNode* arc = g.adjlist[v].firstarc; arc; arc = arc->nextarc) {
if (!visited[arc->adjvex]) {
q.push(arc->adjvex); // 将未访问的邻接点入队
visited[arc->adjvex] = true; // 标记邻接点已访问
visit(g.adjlist[arc->adjvex]); // 访问邻接点
}
}
}
}考点三: 图的遍历
0 v 1 3 4 ∧
0
1 v 0 2 3 ∧
1
2 v 1 3 4 ∧
2
3 v 0 1 2 4 ∧
3
4 v 0 2 3 ∧
4
11
22 33 00
44考点三: 图的遍历
由算法思想知,先设计一个从某个顶点(编号)为v0开始广度优先搜索的
函数,便于调用。
在遍历整个图时,可以对图中的每一个未访问的顶点执行所定义的函数。
v v
4 4
v v
1 1
v v
5 5
v v v v
2 3 2 3考点三: 图的遍历
由算法思想知,先设计一个从某个顶点(编号)为v0开始广度优先搜索的
函数,便于调用。
在遍历整个图时,可以对图中的每一个未访问的顶点执行所定义的函数。
v
4
v
v 4
1
v
1
v
5
v
5
v v
2 3
v v
2 3考点三: 图的遍历
v
4
v6
v
1
v
v7
5
v8
v v
2 3
➢ 对⽆向图进⾏ BFS遍历 调⽤BFS函数的次数=连通分量数
➢ 对于连通图,只需调⽤1次 BFS考点三: 图的遍历
// 广度优先遍历图g,visit为访问函数
void BFSTraverse(ALGraph& g, void (*visit)(VNode)) {
bool visited[MAXSIZE] = {false}; // 初始化访问标记数组
for (int i = 0; i < g.n; ++i) {
if (!visited[i]) {
BFS(g, i, visited, visit); // 若未访问,则递归访问该顶点
}
}
}考点三: 图的遍历
对于具有n个顶点、e条边的有向图或无向图,在BFS算法中每个顶点都进队
一次,因此执行时间与DFS相同。
当图采用邻接表表示图时,BFS的总时间为O(n+e);
当图采用邻接矩阵表示图时,BFS的总时间为O(n2)。考点三: 图的遍历
广度优先遍历生成树
v
4
v
v 4
1
v
1
v
5 v
5
v v
2 3 v v
2 3
v
4
v
1
v
5
v v
2 3考点三: 图的遍历
广度优先遍历生成树
v
4
v
v 4
1
v
1
v
5 v
5
v v
2 3 v v
2 3
v
4
v
1
v
5
v v
2 3考点三: 图的遍历
图的遍历可以系统地访问图中的每个顶点,因此,图的遍历算法是图的最基本、最
重要的算法,许多有关图的操作都是在图的遍历基础之上加以变化来实现的。
关于图的遍历:
1、深度优先遍历使用栈这种数据结构,广度优先遍历使用队列这种数据结构
2、每个连通分量调用一次遍历算法,那么调用遍历算法的次数等于连通分量的数量
3、使用邻接矩阵的遍历结果是唯一的;使用邻接表时,由于邻接表不是唯一的,所以遍
历结果不是唯一的,但是一旦给定邻接表,遍历结果唯一,即必须按照邻接表的顺序遍历。
4、使用邻接矩阵的时间复杂度是O(n^2),使用邻接表的时间复杂度是O(n+e)
5、两种遍历算法会得到深度优先遍历树和广度优先遍历树考点三: 图的遍历
特别说明:
使用邻接矩阵的遍历结果是唯一的;
6 ∞ 6 2 ∞ ∞
a b 3
6 ∞ 3 4 3
3
2 e
4
5
2 3 ∞ 1 ∞
1
c d
∞ 4 1 ∞ 5
∞ 3 ∞ 5 ∞考点三: 图的遍历
特别说明:
使用邻接表时,由于邻接表不是唯一的,所以遍历结果不是唯一的,但
是一旦给定邻接表,遍历结果唯一,即必须按照邻接表的顺序遍历
v
4
v
1
v
5
v v
2 3考点三: 图的遍历
特别说明:
使用邻接表时,由于邻接表不是唯一的,所以遍历结果不是唯一的,但
是一旦给定邻接表,遍历结果唯一,即必须按照邻接表的顺序遍历
1 2 3 ⋀
0 v
v 1
4
v 1 1 v 0 2 ⋀
2
v
5 2 v 0 1 3 4 ⋀
3
v v 3 v 0 2 4 ⋀
2 3 4
v
4 2 3 ⋀
5THANKSCON T EN T S
目录
考点一 图的基本概念 ★★★★
考点二 图的存储 ★
考点三 图的遍历 ★★
考点四 最小生成树 ★★★★★
考点五 最短路径 ★★
考点六 AOV网和拓扑排序 ★★★★★
考点七 AOE网和关键路径 ★★★★考点框架考点框架
最小生成树的定义
Prim算法
Kruskal算法
最小生成树唯一性讨论【最小生成树的定义】考点四: 最小生成树
一个连通图的生成树是一个极小连通子图,它含有图中全部n个顶点和构
成一棵树的(n-1)条边。
0 0
一棵生成树
2 1 5 2 1 5
3 4 3 4考点四: 最小生成树
由广度优先遍历得到的生成树称为广度优先生成树。
0 0
BFS生成树
2 1 5 2 1 5
3 4 3 4考点四: 最小生成树
由深度优先遍历得到的生成树称为深度优先生成树。
0 0
DFS生成树
2 1 5 2 1 5
3 4 3 4考点四: 最小生成树
⚫ 对于非连通图:需多次调用遍历过程。每个连通分量中的顶点集和遍历
时走过的边一起构成一棵生成树。所有连通分量的生成树组成非连通图
的生成森林。
0
0
4
4
生成森林
2 1 6
2 1 6
5
5
3
3考点四: 最小生成树
生成树:关于无向图的生成树的几个结论:
◆ 一棵有n个顶点的生成树有且仅有n-1条边;
◆ 如果一个图有n个顶点和小于n-1条边,则是非连通图;
◆ 如果多于n-1条边,则一定有环;
◆ 有n-1条边的图不一定是生成树。
0 0
一棵生成树
2 1 5 2 1 5
3 4 3 4考点四: 最小生成树
设图的顶点表示城市,边表示两个城市之间的高铁线路,边的权值指的是
两个城市之间的高铁修建费用。
单位:十亿元
哈尔滨
10
20
6
西安 北京
6
20
济南
5
4
5
10
成都 郑州考点四: 最小生成树
设图的顶点表示城市,边表示两个城市之间的高铁线路,边的权值指的是
两个城市之间的高铁修建费用。
n个城市之间最多可以建n(n-1)/2条线路,如何选择其中的n-1条,使总
的建造费用最低?
单位:十亿元
哈尔滨
10
20
6
西安 北京
6
20
济南
5
4
5
10
成都 郑州考点四: 最小生成树
如果连通图是一个带权图,则其生成树中的边也带权,生成树中所有边的权
值之和称为生成树的代价。
最小生成树(Minimum Spanning Tree ; MST) :带权连通图中代价最小
的生成树称为最小生成树。
如下特点:
➢ 一棵有n个顶点的生成树有且仅有n-1条边;
➢ 这n-1条边使这n个顶点相联通;
➢ n-1条边的权值之和最小;考点四: 最小生成树
最小生成树(Minimum Spanning Tree ; MST) :带权连通图中代价最
小的生成树称为最小生成树。
如下特点:
➢ 一棵有n个顶点的生成树有且仅有n-1条边;
➢ 这n-1条边使这n个顶点相联通;
➢ n-1条边的权值之和最小;
单位:十亿元 哈尔滨 单位:十亿元 哈尔滨
10
10
20
6
6
西安 北京 西安 北京
6
20 济南
5 济南
4 5
5 4
5
10
成都 郑州 成都 郑州考点四: 最小生成树
0
1
1
0 1 2
0
1
1
1 1
1
1
3
1 2
1 2
1 3
3 0 3
1 3
1
图G
1 2
不是图G的最小生成树
1
3
都是图G的最小生成树考点四: 最小生成树
➢ 最⼩⽣成树的边数 = 顶点数 - 1。砍掉⼀条则不连通,增加⼀条边则会出现回路
➢ 如果⼀个连通图本身就是⼀棵树,则其最⼩⽣成树就是它本身
➢ 只有连通图才有⽣成树,⾮连通图只有⽣成森林
➢ 这n-1条边使这n个顶点相联通
➢ 这n-1条边的权值之和最小
➢ 最小权值一定包含在某个最小生成树中
➢ MST树形可能不唯一
单位:十亿元 哈尔滨 单位:十亿元 哈尔滨
10
10
20
6
6
西安 北京 西安 北京
6
20 济南
5 济南
4 5
5 4
5
10
成都 郑州 成都 郑州考点四: 最小生成树
MST的如下性质【常考】:
设G=(V,E)是一个带权连通图,U是顶点集V的一个非空子集。若u∈U ,
v∈V-U,且(u, v)是U中顶点到V-U中顶点之间权值最小的边,则必存在一棵包
含边(u, v)的最小生成树。
证明: 用反证法证明。设图G的任何一棵最小生成树都不包含边(u,v)。设T是G
的一棵生成树,则T是连通的,从u到v必有一条路径(u,…,v),当将边(u,v)加入到
T中时就构成了回路。则路径(u, …,v)中必有一条边(u’,v’) ,满足u’∈U ,
v’∈V-U 。删去边(u’,v’) 便可消除回路,同时得到另一棵生成树T’。
由于(u,v)是U中顶点到V-U中顶点之间权值最小的边,故(u,v)的权值不会高于
(u’,v’)的权值,T’的代价也不会高于T, T’是包含(u,v) 的一棵最小生成树,
与假设矛盾。【普里姆(Prim)算法】考点四: 最小生成树
普里姆(Prim)算法是一种构造性算法,用于构造最小生成树。过程如下:
(1)初始化U={v}。v到其他顶点的所有边为候选边;
(2)重复以下步骤n-1次,使得其他n-1个顶点被加入到U中:
①从候选边中挑选权值最小的边输出,设该边在V-U中的顶点是k,将k加入U中;
②考察当前V-U中的所有顶点j,修改候选边:若(j,k)的权值小于原来和顶点k
关联的候选边,则用(k,j)取代后者作为候选边。
V-U
U V-U U
v
v k j
最 k
小
小的边作
边
为候选边考点四: 最小生成树
如何求U、V-U两个顶点集之间的最小边?(只求一条)
只考虑V-U中顶点j到U顶点集的最小边(无向图),比较来找最小边
如何存储顶点j到U顶点集的最小边?
U
V-U
k (j,closest[j ])是顶点j 的最小边,
j
权值为lowcost[j ]
v
closest[j ] 顶点j 到U的最小边
lowcost[k]=0
lowcost[j ]!=0
一个顶点属于哪个集合?
图采用哪种存储结构更合适? 邻接矩阵考点四: 最小生成树
普里姆算法思路
局部最优 + 调整 = 全局最优
普里姆算法分析
Prim()算法中时间复杂度为O(n2)。考点四: 最小生成树
Prim算法示例演示(起点0)
28 00 1
0 1
16
10 14
6 2
6 2 5
5
18
24
25 12
4 3
4 3
22
U={0}
图G
普里姆算法求解最小生成树的过程考点四: 最小生成树
28
00 1
0 1
10 16
14
6 2
6 2 55
5
18
24
25 12
4 3
4 3
22
U={0,5}
图G
普里姆算法求解最小生成树的过程考点四: 最小生成树
28
00 1
0 1
10 16
14
6 2
6 2 55
5
18
24
25 12
44 3
4 3
22
图G
U={0,5,4}
普里姆算法求解最小生成树的过程考点四: 最小生成树
28 00 1
0 1
10 16
14
6 2
6 2 55
5
18
24
25 12
44 33
4 3
22
图G U={0,5,4,3}
普里姆算法求解最小生成树的过程考点四: 最小生成树
28
00 1
0 1
10 16
14
6 22
6 2 55
5
18
24
25 12
44 33
4 3
22
图G U={0,5,4,3,2}
普里姆算法求解最小生成树的过程考点四: 最小生成树
28
00 1
0 1
10 16
14
6 22
6 2 55
5
18
24
25 12
44 33
4 3
22
图G U={0,5,4,3,2}
普里姆算法求解最小生成树的过程考点四: 最小生成树
如图所示;假设从v0出发,开始构建最小生成树。
V
0 11
10
V 16 17 V
1 5
V
6
19
12
26
18
V
24 7
7
V
8 8
16
21
V V
2 4
V
22
3 20
(a)带权图考点四: 最小生成树
V V
0 11 0
10 10
V 16 17 V V
1 5 1
V
6
19
(b)加入v1
12
26
18
V
24 7
7
V
8 8
16
21
V V
2 4
V
22
3 20
(a)带权图考点四: 最小生成树
V V
0 11 0
11
10 10
V 1 16 17 V 5 V 1 V 5
V
6
19
(d)加入v5
12
26
18
V
24 7
7
V
8 8
16
21
V V
2 4
V
22
3 20
(c)带权图考点四: 最小生成树
V V
0 11 0 11
10 10
V 1 16 17 V 5 V 1 V 5
V
6
19
12
12
26
18
V
24 7
7 V
V 8
8 8
16
21
V V
2 4
(f)加入v8
V
22
3 20
(e)带权图考点四: 最小生成树
V V
0 11 0
10 10 11
V 1 16 17 V 5 V 1 V 5
V
6
19
12
12
26
18
V
24 7
7 V
V 8 8
8 8
16
21
V V V
2 4 2
(h)加入v2
V
22
3 20
(g)带权图考点四: 最小生成树
V V
0 11 0
11
10 10
V 1 16 17 V 5 V 1 16 V 5
V
V 6
6
19
12
12
26
V
24 7
7 V
V 8 8
8 8
16
21
V V V
2 4 2
(j)加入v6
V
22
3 20
(i)带权图考点四: 最小生成树
V V
0 11 0
10 10 11
V V V 16 V
1 16 5 1 5
V
V 6 19
6
19
12
12
26
V
V 7
24 7
7 V
V 8 8
8 8
16
21
V V V
2 4 2
(n)加入v7
V
22
3 20
(m)带权图考点四: 最小生成树
V
0
10 11
V
0 11
10
V 16 V
1 5
V
6 19
V V
16
1 5
12
V
6 V
19 7
12 7
V
26
8
8
V
24 7
V
7 V
V 2 4
8 8
16
21
V V
2 4
(q)加入v4
V
22
3 20
(p)带权图考点四: 最小生成树
V
0
10 11
V
0 11
10
V 16 V
1 5
V
V V 6 19
16
1 5
12
V
6
19 V
7
12
7
26 V
8
8
V
24 7
16
7 V
V V
4
8 8 2 V
21 16 3
V V
2 4
(y)加入v3
V
22
3 20
(x)带权图考点四: 最小生成树
设置一个一维数组closedge[n],用来保存V- U中各顶点到U中顶点具有权值
最小的边。数组元素的类型定义是:
struct {
int adjvex ; /* 边所依附于U中的顶点 */
int lowcost ; /* 该边的权值 */
} closedge[MAX_EDGE] ;
例如: closedge[j].adjvex=k,表明边(v , v )是V-U中顶点vj到U中权值最小的
j k
边,而顶点v 是该边所依附的U中的顶点。 closedge[j].lowcost存放该边的权
k
值。考点四: 最小生成树考点四: 最小生成树
设带权连通图有n个顶点,则算法的主要执行是二重循环: 求closedge
中权值最小的边,频度为n-1; 修改closedge数组,频度为n 。因此,
整个算法的时间复杂度是O(n2),与边的数目无关。
适合于稠密图;【克鲁斯卡尔(Kruskal)算法】考点四: 最小生成树
克鲁斯卡尔(Kruskal)算法也是一种求带权无向图的最小生成
树的构造性算法。
按权值的递增次序选择合适的边来构造最小生成树的方法。
➢ 一棵有n个顶点的生成树有且仅有n-1条边;
➢ 这n-1条边使这n个顶点相联通;
➢ n-1条边的权值之和最小;考点四: 最小生成树
(1)置U的初值等于V(即包含有G中的全部顶点),TE的初值为空集(即
图T中每一个顶点都构成一个连通分量)。
(2)将图G中的边按权值从小到大的顺序依次选取:
若选取的边未使生成树T形成回路,则加入TE;
否则舍弃,直到TE中包含(n-1)条边为止。考点四: 最小生成树
➢ 算法实例
V
0 11
10
V 16 17 V
1 5
V
6
19
12
26
18
V
24 7
7
V
8 8
16
21
V V
2 4
V
22
3 20
(a)带权图考点四: 最小生成树
V
0 11
10
V
7
7
V 16 17 V
1 5
V
V
4
6
19
12
26 (a)选择权重7
18
V
24 7
7
V
8 8
16
21
V V
2 4
V
22
3 20
(a)带权图考点四: 最小生成树
V
0 11 V
10 V 7
8 8 7
V
2
V 16 17 V
1 5 V
4
V
6
19
12 (b)选择权重8
26
18
V
24 7
7
V
8 8
16
21
V V
2 4
V
22
3 20
(a)带权图考点四: 最小生成树
V
0 11 V V
10 10 0 7
7
V
1
V 16 17 V
1 5 V
V 4
8 8
V
6
19
V
12 2
26
18 (c)选择权重10
V
24 7
7
V
8 8
16
21
V V
2 4
V
22
3 20
(a)带权图考点四: 最小生成树
V
11
0
10
V
0 11
10 V
1 V
5
V 16 17 V
1 5 V V
8 8 7
7
V
6
V
19
2
12
26
V
18
4
V
24 7
7
(d)选择权重11
V
8 8
16
21
V V
2 4
V
22
3 20
(a)带权图考点四: 最小生成树
V
11
0
10
V
0 11
10
V
1 V
5
12
V 16 17 V
1 5 V
7
V V 7
6 8 8
19
12 V
18 26 2 V
4
V
24 7
7
(e)选择权重11
V
8 8
16
21
V V
2 4
V
22
3 20
(a)带权图考点四: 最小生成树
V
11
0
10
V
0 11
10
V
16
1 V
5
V
12 6
V 16 17 V
1 5
V
V V 7
6 8 8
19 7
12 V 16
26 2
18
V V
24 7 4
7 V
V 3
8 8
16
21
V V (f)选择权重16
2 4
V
22
3 20
(a)带权图考点四: 最小生成树
V
11
0
10
V
0 11
10 V
16
1 V
5
V
12 6
19
V 16 17 V
1 5
V
V 6 8 8 V
7
19
7
12 V
26 2
18 16
V
24 7
V
7 4
V
V
8 8 3
16
21
V V
2 4 (g)选择权重19
V
22
3 20
(a)带权图考点四: 最小生成树
如何存储连通分量呢? 并查集
并查集:集合中的元素组织成树的形式:
(1)查找两个元素是否属于同一集合:所在树的根结点是否相同
(2)合并两个集合——将一个集合的根结点作为另一个集合根结点的孩子
V
11
0
10
V
1 V
5
V V
8 8 7
7
V
2
V
4考点四: 最小生成树
设带权连通图有n个顶点,e条边,则算法的主要执行是:
➢ Vset数组初始化:时间复杂度是O(n) ;
➢ 边表按权值排序:若采用堆排序或快速排序,时间复杂度是O(e㏒e) ;
➢ 适合于稀疏图;【最小生成树唯一性讨论】考点四: 最小生成树
通过学习普利姆和克鲁斯卡尔算法,我们掌握了构造最小生成树的方法,但是
我们这里提出几个问题,
(1) 同一个算法(普利姆或者克鲁斯卡尔算法)最小生成树的构造过程是否唯一的
(2) 不同算法(普利姆或者克鲁斯卡尔算法)最小生成树的构造过程是否唯一的
(3) 不同算法(普利姆或者克鲁斯卡尔算法)构造的最小生成树是否是唯一的考点四: 最小生成树
Prim算法
3
6
4
8
3
10 3
6
6
4
1 4
4
2
3 2
4
2 5
5
(a)带权图
(b)加入4
(c)加入5考点四: 最小生成树
3
6
4
4
2
3
6
2 5
4
8
3
10 6
4 (d)加入5
1
4
2
2
3
3
4 6
2 5
5
4
(a)带权图
(c)加入5
2
4
2
5
(e)加入5考点四: 最小生成树
3 3 3
6 6 6
4 4 4
1 1
4 4 4
2 3 2 3 2
2 5 2 5 2 5
(d)加入5 (f)加入1 最小生成树1
3
3
3 6
6
6 1
1
4
4
4
3
3
2
2
2
4
4 2 2 4
2
5
5
5
(e)加入5 (g)加入1 最小生成树2考点四: 最小生成树
Kruskal算法
3
6
4
4
4
8
10
1
1
4
2
2
2 3
3
2
5
4 5
2
5
(a)带权图
(b)加入权重2 (c)加入权重3考点四: 最小生成树
4
Kruskal算法 1
4
2
3
6
3
4
4
8
10
2 5
1
1
4
2 2 (d)加入权重4
3
3
4
4
2
2 5
5
1
(a)原
(c)加入权重3
2
图
3
4
2
5
(e)加入权重4考点四: 最小生成树
4 3 6 3 6
4 4
1 1 1
4 4 4
2 2 2
3 3 3
2 5 2 5 2 5
(d)加入权重4 (f)加入权重6 最小生成树1
3 6
3
6
4
4
1 1 4
1
2 2
3 3 2
3
2 4 5 2 4 5
4
2
5
(e)加入权重4 (g)加入权重6
最小生成树2考点四: 最小生成树
当图的权重都不相等时,不同算法构造的最小生成树是唯一的,但是不同
算法的构造过程可能不唯一的;当图的权重都不相等时,同一个算法的构造过
程可能是唯一的,且构造的最小生成树是唯一的。这个逻辑比较容易想通,因
为每一个条边的权重都不相等。
当图中存在相同权值时,这三个问题都是不唯一的;也就是同一个算法
(普利姆或者克鲁斯卡尔算法)最小生成树的构造过程可能是不唯一的;不同
算法(普利姆或者克鲁斯卡尔算法)最小生成树的构造过程可能是不唯一的;
不同算法(普利姆或者克鲁斯卡尔算法)构造的最小生成树可能是不唯一的;【政哥题型总结】考点四: 最小生成树
1.已知图G的邻接矩阵如下,根据普里姆(Prim)算法,求图G从顶点1出发的最
小生成树,要求表示出其每步的生成过程。(用图或表的方式均可)考点四: 最小生成树
1.已知图G的邻接矩阵如下,根据普里姆(Prim)算法,求图G从顶点1出发的最
小生成树,要求表示出其每步的生成过程。(用图或表的方式均可)考点四: 最小生成树
1.已知图G的邻接矩阵如下,根据普里姆(Prim)算法,求图G从顶点1出发的最
小生成树,要求表示出其每步的生成过程。(用图或表的方式均可)
2
6
3
5
5
1
6
1
6
3
4
5
6
5
6
4
已知邻接矩阵,根据普里姆(Prim)算法,从当前情况出发,选择最小的边,
构造出图的结构,过程如图所示。考点四: 最小生成树
2
6
3
1
1
5
5
1
6
1 3
6
3
(a)
4
5
6
5
6
4考点四: 最小生成树
2
6
3
1 1
1 1
5
5
1
6
1 3 3
4
6
6
3
(a)
4
(b)
5
6
5
6
4考点四: 最小生成树
2
6
3 1 1
1 1
5
5
1
6
3 3
1
4
6
6
(a)
3
4 (b)
5
6
5
2
6
4
1 5
1
3
4
6
(c)考点四: 最小生成树
2
6
3
1 1
1 1
5
5
1
6
1 3 3
4
6
6
3 (a)
4
(b)
5
6
5
2
4 6 3
2
5
1 5
1
1 5
3
1
4
3
4 6
(c) 6
(d)考点四: 最小生成树
2 2
6
3 3
5 5
5 1 5
1
6
1
1
6
3
3
4
4
5
6
6
5
(d)
2
6
4 3
5
1 5
1
3
5 4
6
(e)
4考点四: 最小生成树
2、试写出用克鲁斯卡尔(Kruskal)算法构造图所示的一棵最小生成树的过程。考点四: 最小生成树
1 1 2
1
2
5 6
5
4 4
4
3 1
6 6 3
6
(a) (b)
(c)考点四: 最小生成树
1 1 2
1
2
5 6
5
4 4
4
3 1
6 6 3
6
(a) (b)
(c)
1
1 1
2
6 5 6
5
12
8
4 4
8
1 3 1
4 3
6 6
5 4
(d) (e)考点四: 最小生成树
1 1 2
1
2
5 6
5
4 4
4
3 1
6 6 3
6
(a) (b)
(c)
1 2
1 1
6
6 12 5
5
4 8
4 8
1
1 3
3 6 5 4
6 4
(e)
(d)
18
1
2
6
5
12
4
8
1
3
6
5 4
(f)THANKSCON T EN T S
目录
考点一 图的基本概念 ★★★★
考点二 图的存储 ★
考点三 图的遍历 ★★
考点四 最小生成树 ★★★★★
考点五 最短路径 ★★
考点六 AOV网和拓扑排序 ★★★★★
考点七 AOE网和关键路径 ★★★★考点框架考点框架
最短路径的概念
迪杰斯特拉算法
弗洛伊德算法【最短路径的概念】考点五: 最短路径
v v
路径:在无向图中,顶点v 和顶点v 之间
0 1 p q
的 路 径 是 一 个 顶 点 序 列 (v =v ,v ,…,
p i0 i1
v
v =v ),其中(v ,v)∈E(1≤j≤m)
3 im q ij-1 ij
顶点 v 和顶点 v 之间的路径:
v v
0 4
4 2
v v v v v v v v v v v
0 4、 0 1 3 4、 0 1 2 3 4、考点五: 最短路径
最短路径:非带权图——边数最少的路径
最短路径:带权图——边上的权值之和最少的路径考点五: 最短路径
考虑带权有向图,把一条路径(仅仅考虑简单路径)上所经边的权值
之和定义为该路径的路径长度或称带权路径长度。
c c c c
1 2 3 m
v v v u
1 2
路径长度=c + c + … + c
1 2 m
路径:(v,v,v,… ,u)
1 2
从源点到终点可能不止一条路径,把路径长度最短的那条路径称为最短路径。考点五: 最短路径
若用带权图表示交通网,图中顶点 哈尔滨
20
表示地点,边代表两地之间有直接道路, 6 10
西安 北京
边上的权值表示路程(或所花费用或时 6
20
间) 。从一个地方到另一个地方的路径 济南
5
4
5
长度表示该路径上各边的权值之和。
10
成都 郑州
单位:百元考点五: 最短路径
从一个地方到另一个地方的路径长度 哈尔滨
20
表示该路径上各边的权值之和。问题: 6 10
西安 北京
➢ 两地之间是否有通路? 6
➢ 在有多条通路的情况下,哪条最短? 20 济南
5
4
5
考虑到交通网的有向性,直接讨论的
10
是带权有向图的最短路径问题,但解决问 成都 郑州
单位:百元
题的算法也适用于无向图。考点五: 最短路径
1、问题引入:
从一个地方到另一个地方的路径长度表示该路径上各边的权值之和。
将一个路径的起始顶点称为源点,最后一个顶点称为终点。
哈尔滨
20
10
6
西安 北京
6
20
济南
5
4
5
10
成都 郑州
单位:百元考点五: 最短路径
如何求图中的最短路径?
Dijkstra算法:单源点最短路径问题
Floyd算法:任意两点之间的最短路径问题【迪杰斯特拉算法】考点五: 最短路径
问题描述:给定一个带权有向图G与源点v,求从v到G中其他顶点的最短路径,
并限定各边上的权值大于或等于0。
单源最短路径问题:Dijkstra算法
哈尔滨
20
10
6
西安
北京
6
20
济南
5
4
5
10
成都 郑州
单位:百元考点五: 最短路径
• 信号量机制PV原语:操作系统,进程同步
• 银⾏家算法:操作系统,死锁
• 解决哲学家进餐问题:操作系统,死锁
• Dijkstra最短路径算法:数据结构
你在写什么?
不知道,
1972年图灵奖得主
反正不是我学考点五: 最短路径
◆ 基本思想
从图的给定源点到其它各个顶点之间客观上应存在一条最短路径,在这组最
短路径中,按其长度的递增次序,依次求出到不同顶点的最短路径和路径长度。
即按长度递增的次序生成各顶点的最短路径,即先求出长度最小的一条最短路径,
然后求出长度第二小的最短路径,依此类推,直到求出长度最长的最短路径。
6
西安 北京
5
20
成都考点五: 最短路径
设给定源点为V ,S为已求得最短路径的终点集,开始时令S={V } 。当求得
s s
第一条最短路径(V ,V )后,S为{V ,V } 。根据以下结论可求下一条最短路径。
s i s i
设下一条最短路径终点为V ,则V 只有:
j j
◆ 源点到终点有直接的弧<V ,V >;
s j
◆ 从V 出发到V 的这条最短路径所经过的所有中间顶点必定在S中。即只有
s j
这条最短路径的最后一条弧才是从S内某个顶点连接到S外的顶点V 。
j
6
西安 北京
5
20
成都考点五: 最短路径
若定义一个数组dist[n],其每个dist[i]分量保存从Vs 出发中间只经过集合S
中的顶点而到达Vi的所有路径中长度最小的路径长度值,则下一条最短路径的
终点V 必定是不在S中且值最小的顶点,即:
j
dist[i]=Min{ dist[k] | V ∈ V-S }
k考点五: 最短路径
◆ 算法步骤
① 令S={Vs} ,用带权的邻接矩阵表示有向图,对图中每个顶点Vi按以下原则
置初值:
0 i =s
dist[i]= W i≠s且<v ,v >∈E, w 为弧上的权值
si s i si
∞ i≠s且<v ,v >不属于E
s i
② 选择一个顶点V ,使得:dist[j]=Min{ dist[k] | V ∈V-S }
j k
V 就是求得的下一条最短路径终点,将V 并入到S中,即S=S∪{V } 。
j j j
③ 对V-S中的每个顶点V ,修改dist[k],方法是:
k
若dist[j]+W <dist[k],则修改为:
jk
dist[k]=dist[j]+W (V ∈V-S )
jk k
④ 重复②,③,直到S=V为止。考点五: 最短路径
用带权的邻接矩阵表示有向图,
◆ 设数组pre[n]保存从V 到其它顶点的最短路径。若pre[i]=k,表
s
示从V 到V 的最短路径中,V 的前一个顶点是V ,即最短路径序列是
s i i k
(V , …, V , V ) 。
s k i
◆ 设数组final[n],标识一个顶点是否已加入S中。考点五: 最短路径
10 4
∞ 20 60 ∞ 10 65
0 20
65
20
35 ∞ ∞ 30 70 ∞ ∞
5
60
80 ∞ ∞ ∞ 40 ∞ ∞
1
15
3 ∞ ∞ ∞ ∞ 35 ∞
30 40
2 ∞ ∞ ∞ ∞ ∞ 20
70 ∞ ∞ 15 80 ∞ ∞考点五: 最短路径
◆ 算法实例
• 源点到终点有直接的弧<Vs,Vj>;
• 从Vs 出发到Vj 的这条最短路径所经过的所有中间顶点必定在S中
顶点 1 2 3 4 5 S
步骤
初态 Dist 20 60 ∞ 10 65 {0}
pre 0 0 0 0 0考点五: 最短路径
• 源点到终点有直接的弧<Vs,Vj>;
• 从Vs 出发到Vj 的这条最短路径所经过的所有中间顶点必定在S中
顶点 1 2 3 4 5 S
步骤
初态 Dist 20 60 ∞ 10 65 {0}
pre 0 0 0 0 0考点五: 最短路径
• 源点到终点有直接的弧<Vs,Vj>;
• 从Vs 出发到Vj 的这条最短路径所经过的所有中间顶点必定在S中
顶点 1 2 3 4 5 S
步骤
初态 Dist 20 60 ∞ 10 65 {0}
pre 0 0 0 0 0
Dist 20 60 ∞ 10 65
pre 0 0 0 0 0考点五: 最短路径
顶点 1 2 3 4 5 S
步骤
初态 Dist 20 60 ∞ 10 65 {0}
pre 0 0 0 0 0
1 Dist 20 60 ∞ 10 65 {0, 4}
pre 0 0 0 0 0
Dist 20 60 ∞ 10 30
pre 0 0 0 0 4考点五: 最短路径
• 源点到终点有直接的弧<Vs,Vj>;
• 从Vs 出发到Vj 的这条最短路径所经过的所有中间顶点必定在S中
顶点 1 2 3 4 5 S
步骤
初态 Dist 20 60 ∞ 10 65 {0}
pre 0 0 0 0 0
1 Dist 20 60 ∞ 10 65 {0, 4}
pre 0 0 0 0 0
2 Dist 20 60 ∞ 10 30 {0, 4, 1}
pre 0 0 0 0 4
Dist 20 50 90 10 30
pre 0 1 1 0 4考点五: 最短路径
• 源点到终点有直接的弧<Vs,Vj>;
• 从Vs 出发到Vj 的这条最短路径所经过的所有中间顶点必定在S中
顶点 1 2 3 4 5 S
步骤
初态 Dist 20 60 ∞ 10 65 {0}
pre 0 0 0 0 0
1 Dist 20 60 ∞ 10 65 {0, 4}
pre 0 0 0 0 0
2 Dist 20 60 ∞ 10 30 {0, 4, 1}
pre 0 0 0 0 4
3 Dist 20 50 90 10 30 {0, 4, 1, 5}
pre 0 1 1 0 4
Dist 20 45 90 10 30
pre 0 5 1 0 4考点五: 最短路径
顶点 1 2 3 4 5 S
步骤
初态 Dist 20 60 ∞ 10 65 {0}
pre 0 0 0 0 0
1 Dist 20 60 ∞ 10 65 {0, 4}
pre 0 0 0 0 0
2 Dist 20 60 ∞ 10 30 {0, 4, 1}
pre 0 0 0 0 4
3 Dist 20 50 90 10 30 {0, 4, 1, 5}
pre 0 1 1 0 4
4 Dist 20 45 90 10 30 {0, 4, 1, 5, 2}
pre 0 5 1 0 4
Dist 20 45 85 10 30
pre 0 5 2 0 4考点五: 最短路径
顶点 1 2 3 4 5 S
步骤
初态 Dist 20 60 ∞ 10 65 {0}
pre 0 0 0 0 0
1 Dist 20 60 ∞ 10 65 {0, 4}
pre 0 0 0 0 0
2 Dist 20 60 ∞ 10 30 {0, 4, 1}
pre 0 0 0 0 4
3 Dist 20 50 90 10 30 {0, 4, 1, 5}
pre 0 1 1 0 4
4 Dist 20 45 90 10 30 {0, 4, 1, 5, 2}
pre 0 5 1 0 4
5 Dist 20 45 85 10 30 {0, 4, 1, 5, 2, 3}
pre 0 5 2 0 4考点五: 最短路径
void Dijkstra(MatGraph g,int v)
{ int dist[MAXV],path[MAXV];
int s[MAXV];
int mindis,i,j,u;
for (i=0;i<g.n;i++)
{ dist[i]=g.edges[v][i]; //距离初始化
s[i]=0; //s[]置空
dist和path
if (g.edges[v][i]<INF) //路径初始化
数组初始化
path[i]=v; //顶点v到i有边时
else
path[i]=-1; //顶点v到i没边时
}
s[v]=1; //源点v放入S中考点五: 最短路径
for (i=0;i<g.n;i++) //循环n-1次
{ mindis=INF;
for (j=0;j<g.n;j++)
if (s[j]==0 && dist[j]<mindis)
{ u=j; 找最小路径长度顶点u
mindis=dist[j];
}
s[u]=1; //顶点u加入S中
for (j=0;j<g.n;j++) //修改不在s中的顶点的距离
if (s[j]==0)
if (g.edges[u][j]<INF &&
调
dist[u]+g.edges[u][j]<dist[j])
整
{ dist[j]=dist[u]+g.edges[u][j];
path[j]=u;
}
}
Dispath(dist,path,s,g.n,v); //输出最短路径
}考点五: 最短路径
◆ Dijkstra算法的主要执行是:
◆ 数组变量的初始化:时间复杂度是O(n) ;
◆ 求最短路径的二重循环:时间复杂度是O(n2) ;
因此,整个算法的时间复杂度是O(n2) 。考点五: 最短路径
◆ 负边和负回路
0
4
5
1 5
-10
Dijkstra算法目光短浅的,只会关心局部的最优解问题,这是贪心算法
的问题。
• Dijkstra 算法不适⽤于有负权值的带权图
• Dijkstra 算法不适⽤于有负回路的带权图考点五: 最短路径
◆ Prim和Dijkstra
0
4
1 5
3
0
4 Prim算法
5
1 5
3
0
4
5
1 5
Dijkstra算法【弗洛伊德算法】考点五: 最短路径
◆ 问题描述:对于一个各边权值均大于零的有向图,对每一对顶点i≠j,求
出顶点i与顶点j之间的最短路径和最短路径长度。
哈尔滨
20
10
6
西安
北京
6
20
济南
5
4
5
10
成都 郑州
单位:百元考点五: 最短路径
用Dijkstra算法也可以求得有向图G=(V,E)中每一对顶点间的最短路径。
方法是:每次以一个不同的顶点为源点重复Dijkstra算法便可求得每一对顶点
间的最短路径,时间复杂度是O(n3) 。
哈尔滨
20
10
6
西安
北京
6
20
济南
5
4
5
10
成都 郑州
单位:百元考点五: 最短路径
用Dijkstra算法也可以求得有向图G=(V,E)中每一对顶点间的最短路径。
方法是:每次以一个不同的顶点为源点重复Dijkstra算法便可求得每一对顶点
间的最短路径,时间复杂度是O(n3) 。
哈尔滨
20
10
6
西安
北京
6
20
济南
5
4
5
10
成都 郑州
单位:百元考点五: 最短路径
用Dijkstra算法也可以求得有向图G=(V,E)中每一对顶点间的最短路径。
方法是:每次以一个不同的顶点为源点重复Dijkstra算法便可求得每一对顶点
间的最短路径,时间复杂度是O(n3) 。
哈尔滨
20
10
6
西安
北京
6
20
济南
5
4
5
10
成都 郑州
单位:百元考点五: 最短路径
弗罗伊德(Floyd)提出了另一个算法,其时间复杂度仍是O(n3) , 但算法形
式更为简明,步骤更为简单,数据结构仍然是基于图的邻接矩阵。
• 图灵奖得主,文学学士
• 前后断言法的创始人
• 堆排序算法
• Floyd-Warshall算法
➢ 一个被计算机耽误的文学家考点五: 最短路径
算法:迭代(递推)思路
假设有向图G=(V,E)采用邻接矩阵存储。设置一个二维数组A用于存放当前
顶点之间的最短路径长度,分量A[i][j]表示当前顶点ij的最短路径长度。
i j
0~k的顶点
按顶点0,1,2,…的顺序依次考虑
递推产生一个矩阵序列:
A A … A … A
0 1 k n-1。
A[i][j]:i j的路径上所经过的顶点编号不大于k的最短路径长度。
k考点五: 最短路径
初始时,有A [i][j]=g.edges[i][j]。
-1
若A 已经求出。
k-1
考虑顶点k:求从ij的最短路径经过编号为k顶点的情况。
kk
i j
ij有两条路径,
取最短的一条!
A [i,j]
k-1
A[i,j]=MIN{ A [i,j],A [i,k]+A [k,j] }
k k-1 k-1 k-1
A [i][j]=g.edges[i][j]
-1
A[i,j]=MIN{ A [i,j],A [i,k]+A [k,j] } 0≤k≤n-1
k k-1 k-1 k-1考点五: 最短路径
算法设计(解决2个问题)
(1)用二维数组A存储最短路径长度:
➢ A[i][j]表示考虑顶点0~k后得出的ij的最短路径长度。
k
➢ A [i][j]表示最终的ij的最短路径长度。
n-1
(2)用二维数组path存放最短路径:
➢ path [i][j]表示考虑顶点0~k后得出的ij的最短路径。
k
➢ path [i][j]表示最终ij的最短路径。
n-1考点五: 最短路径
如何用path存放最短路径?
path [i][j]表示考虑过0~x的顶点得到ij的最短路径,存放该路径上顶点j的前
x
一个顶点编号。
k
考虑过0~k-1顶点的情况
a
……
i b j
path [i][j]=b
k-1
现在考虑顶点k
若经过顶点k的路径更短: path [i][j] = a= path [k][j]
k k-1
否则: path [i][j] = b= path [i][j] 不改变
k k-1考点五: 最短路径
2
V V
0 1
8
4
5
V
2考点五: 最短路径
◆ 算法实现
◆ 定义二维数组Path[n][n](n为图的顶点数) ,元素Path[i][j]保存从V 到V 的最
i j
短路径所经过的顶点。
◆ 若Path[i][j]=k:从V 到V 经过V ,最短路径序列是(V , …, V , …, V ) ,则路
i j k i k j
径子序列:(V , …, V )和(V , …, V )一定是从V 到V 和从V 到V 的最短路径。从
i k k j i k k j
而可以根据Path[i][k]和Path[k][j]的值再找到该路径上所经过的其它顶点,…依
此类推。考点五: 最短路径
2
V V
0 1 0 2 8
8
4
∞ 0 4
5
5 ∞ 0
V
2
用Floyd算法求任意一对顶点间最短路径
步骤 初态 k=0 K=1 K=2
0 2 8 0 2 8 0 2 6 0 2 6
A ∞ 0 4 ∞ 0 4 ∞ 0 4 9 0 4
5 ∞ 0 5 7 0 5 7 0 5 7 0
-1 -1 -1 -1 -1 -1 -1 -1 1 -1 -1 1
Path
-1 -1 -1 -1 -1 -1 -1 -1 -1 2 -1 -1
-1 -1 -1 -1 0 -1 -1 0 -1 -1 0 -1
S { } { 0 } { 0, 1 } { 0, 1, 2 }考点五: 最短路径
步骤 初态 k=0 K=1 K=2
0 2 8 0 2 8 0 2 6 0 2 6
A ∞ 0 4 ∞ 0 4 ∞ 0 4 9 0 4
5 ∞ 0 5 7 0 5 7 0 5 7 0
-1 -1 -1 -1 -1 -1 -1 -1 1 -1 -1 1
Path
-1 -1 -1 -1 -1 -1 -1 -1 -1 2 -1 -1
-1 -1 -1 -1 0 -1 -1 0 -1 -1 0 -1
S { } { 0 } { 0, 1 } { 0, 1, 2 }
根据上述过程中Path[i][j]数组,得出:
V 到V :最短路径是{ 0, 1 } ,路径长度是2 ;
0 1
V 到V :最短路径是{ 0, 1, 2 } ,路径长度是6 ;
0 2
V 到V :最短路径是{ 1, 2, 0 } ,路径长度是9 ;
1 0
V 到V :最短路径是{ 1, 2 } ,路径长度是4 ;
1 2
V 到V :最短路径是{ 2, 0 } ,路径长度是5 ;
2 0
V 到V :最短路径是{ 2, 0, 1 } ,路径长度是7 ;
2 1考点五: 最短路径
5
0 1 0 5 ∞ 7
7
∞ 0 4 2
3 4 3 2
3 3 0 2
2 2 3
∞ ∞ 1 0
1
A path
-1 -1
0 1 2 3 0 1 2 3
求path
0 0 5 ∞ 7 0 -1 0 -1 0
∞和ii:-1
1 ∞ 0 4 2 1 -1 -1 1 1
2 3 3 0 2 2 2 2 -1 2
(i,j)有边:i
3 ∞ ∞ 1 0 3 -1 -1 3 -1考点五: 最短路径
5 0
考虑顶点 :
0 1
7
没有任何路径修改
3 4 3 2
A=A ,path =path
2 2 3
0 -1 0 -1
1
A path
0 0
0 1 2 3 0 1 2 3
0 0 5 ∞ 7 0 -1 0 -1 0
1 ∞ 0 4 2 1 -1 -1 1 1
2 3 3 0 2 2 2 2 -1 2
3 ∞ ∞ 1 0 3 -1 -1 3 -1考点五: 最短路径
5
1
0 1 考虑顶点 :
7
3 4 3 2 0→2:由无路径改为0→1→2,长度为9,
path[0][2]改为1
2 2 3
1
A path
1 1
0 1 2 3 0 1 2 3
0 0 5 ∞9 7 0 -1 0 - 1 1 0
1 ∞ 0 4 2 1 -1 -1 1 1
2 3 3 0 2 2 2 2 -1 2
3 ∞ ∞ 1 0 3 -1 -1 3 -1考点五: 最短路径
2
5
考虑顶点 :
0 1
7
1→0:由无路径改为1→2→0,长度为7,
3 4 path[1][0]改为2
3 2
3→0:由无路径改为3→2→0,长度为4,
path[3][0]改为2
2 2 3
1 3→1:由无路径改为3→2→1,长度为4,
path[3][1]改为2
A path
2 2
0 1 2 3 0 1 2 3
0 0 5 9 7 0 -1 0 1 0
1 ∞ 7 0 4 2 1 - 2 1 -1 1 1
2 3 3 0 2 2 2 2 -1 2
3 ∞4 ∞ 4 1 0 3 - 2 1 - 2 1 3 -1考点五: 最短路径
3
5
考虑顶点 :
0 1
7
➢ 0→2:由0→1→2改为0→3→2 ,长度为8,
3 4 3 2 path[0][2]改为3
➢ 1→0:由1→2→0改为1→3→2→0,长度
2 2 3 为6, path[1][0]改为2
1 ➢ 1→2:由1→2改为1→3→2 ,长度为3,
path[1][2]改为3
path
A 3
3
0 1 2 3
0 1 2 3
3
8 0 -1 0 1 0
0 0 5 9 7
2 3
1 2 -1 1 1
6 3
1 7 0 4 2
2 2 2 -1 2
2 3 3 0 2
3 2 2 3 -1
3 4 4 1 0考点五: 最短路径
求最终结果 A path
3 3
0 1 2 3 0 1 2 3
0 0 5 8 7 0 -1 0 3 0
1 66 0 3 2 1 2 -1 3 1
2 3 3 0 2 2 2 2 -1 2
3 4 4 1 0 3 2 2 3 -1
求最短路径长度:
由A数组可以直接得到两个顶点之间的最短路径长度。
3
如A[1][0]=6
3
说明顶点1到0的最短路径长度为6。考点五: 最短路径
A path
求最终结果 3 3
0 1 2 3 0 1 2 3
0 0 5 8 7 0 -1 0 3 0
2 3 1
1 6 0 3 2 1 2 -1 3 1
2 3 3 0 2 2 2 2 -1 2
3 4 4 1 0 3 2 2 3 -1
求最短路径:
求顶点1 0的最短路径:
path [1][0]=2
3
path [1][2]=3
3
path [1][3]=1
3
查找的顶点序列为0、2、3、1,则顶点1 0的最短路径1→3→2→0。考点五: 最短路径
void Floyd(MatGraph g) //求每对顶点之间的最短路径
{ int A[MAXVEX][MAXVEX]; //建立A数组 A和path数
int path[MAXVEX][MAXVEX]; //建立path数组 组初始化
int i, j, k;
for (i=0;i<g.n;i++)
for (j=0;j<g.n;j++)
{ A[i][j]=g.edges[i][j];
if (i!=j && g.edges[i][j]<INF)
path[i][j]=i; //i和j顶点之间有一条边时
else //i和j顶点之间没有一条边时
path[i][j]=-1;
}考点五: 最短路径
for (k=0;k<g.n;k++) //求A [i][j]
k
{ for (i=0;i<g.n;i++)
for (j=0;j<g.n;j++)
if (A[i][j]>A[i][k]+A[k][j]) //找到更短路径
{ A[i][j]=A[i][k]+A[k][j]; //修改路径长度 调
path[i][j]=path[k][j]; //修改最短路径为经过顶点k
整
}
}
}考点五: 最短路径
◆ 算法分析
时间复杂度,O(N3)
空间复杂度为O(N2)考点五: 最短路径
◆ 进一步分析
2
V V
0 1
4
-9
V
2
Floyd 算法不能解决带有“负权回路”的图(有负权值的边组成回
路),这种图有可能没有最短路径考点五: 最短路径
◆ 小结
算法 用途 时间复杂度 特点
Dijkstra 单源最短路径 O(n2) 不适合负权
Floyd 多源最短路径 O(n3) 不适合负权回路THANKSCON T EN T S
目录
考点一 图的基本概念 ★★★★
考点二 图的存储 ★
考点三 图的遍历 ★★
考点四 最小生成树 ★★★★★
考点五 最短路径 ★★
考点六 AOV网和拓扑排序 ★★★★★
考点七 AOE网和关键路径 ★★★★考点框架
如果我们把每个环节看成图中一个顶点,在这样一个有
AOV 向图中,用顶点表示活动,用弧表示活动之间的优先关
系,那么这样的有向图称为AOV网(Activity On Vertex)
拓扑排序就是对一个有向图构造拓扑序列的过程,构造会
有两种结果:如果此图全部顶点都被输出了,说明它是不存
拓扑排序 在回路的AOV网;如果没有输出全部顶点,则说明这个图存
在回路,不是AOV网。
拓扑排序算法:
从AOV网中选择一个入度为0的顶点输出,然后删去此
顶点,并删除以此顶点为弧尾的弧。重复这个步骤直到输
出图中全部顶点,或者找不到入度为0的顶点为止。考点框架
AOV网
拓扑排序概念
拓扑排序【AOV网】考点六: AOV网和拓扑排序
例如,计算机专业的学生必 课程代号 课程名称 先修课程
须完成一系列规定的基础课
C 高等数学 无
1
C 程序设计 无
2
和专业课才能毕业,假设这
C 离散数学 C
3 1
C 数据结构 C ,C
4 2 3
些课程的名称与相应代号有
C 编译原理 C ,C
5 2 4
C 操作系统 C ,C
6 4 7
如下关系:
C 计算机组成原理 C
7 2考点六: AOV网和拓扑排序
C C C
课程代号 课程名称 先修课程
1 3 4
C 高等数学 无
1
C
C 程序设计 无 6
2
C 离散数学 C
3 1
C
C 数据结构 C ,C 7
4 2 3
C 编译原理 C ,C
5 2 4
C
C
C 操作系统 C ,C 5
2
6 4 7
C 计算机组成原理 C
7 2考点六: AOV网和拓扑排序
有向无环图(Directed Acycling Graph):是图中没有回路(环)的有向
图。是一类具有代表性的图,主要用于研究工程项目的工序问题、工程
时间进度问题等。考点六: AOV网和拓扑排序
对工程的活动加以抽象:图中顶点表示活动,有向边表示活动之间的优先
关系,这样的有向图称为顶点表示活动的网(Activity On Vertex Network ,
AOV网) 。【拓扑排序概念】考点六: AOV网和拓扑排序
拓扑序列:设有向图G=(V,E)具有 n 个顶点,则顶点序列 v, v, …, v
0 1 n-1
称为一个拓扑序列,当且仅当满足下列条件:若从顶点 v到 v有一条路
i j
径,则在顶点序列中顶点 v必在顶点 v之前
i j
幼儿园
学前班 小学 中学 大学考点六: AOV网和拓扑排序
由某个集合上的一个偏序得到该集合上的一个全序的操作。
即偏序是指集合中仅有部分元素之间可以比较,而全序是指集合中
任意两个元素之间都可以比较。
在图论中,由⼀个有向⽆环图的顶点组成的序列,当且仅当满⾜下
列条件时,称为该图的⼀个拓扑排序:
① 每个顶点出现且只出现⼀次。
② 若顶点A在序列中排在顶点B的前⾯,则在图中不存在从顶点B到顶
点A的路径。考点六: AOV网和拓扑排序
在AOV网中,若有有向边<i, j>,则i是j的直接前驱,j是i的直接后继;
推而广之,若从顶点i到顶点j有有向路径,则i是j的前驱,j是i的后继。
在AOV网中,不能有环,否则,某项活动能否进行是以自身的完成
作为前提条件。
检查方法:对有向图的顶点进行拓扑排序,若所有顶点都在其拓扑
有序序列中,则无环。考点六: AOV网和拓扑排序
拓扑排序:对一个有向图构造拓扑序列的过程,构造AOV网中顶点的
一个拓扑线性序列(v’1,v’2, ⋯,v’n),使得该线性序列不仅保持原来
有向图中顶点之间的优先关系,而且对原图中没有优先关系的顶点之间
也建立一种(人为的)优先关系。
幼儿园
学前班 小学 中学 大学考点六: AOV网和拓扑排序
拓扑排序:对一个有向图构造拓扑序列的过程
v v
3 5
v
1
v v
2 6
v
0
v
4
拓扑序列 1:v v v v v v v
0 1 2 3 4 5 6
拓扑序列 2:v v v v v v v
0 1 3 2 4 5 6【拓扑排序】考点六: AOV网和拓扑排序
拓扑序列的本质是什么?
使得AOV网中所有应该存在的前驱和后继关系都能得到满足
哪一个顶点作为拓扑序列的第一个顶点?
没有前驱的顶点
v v 拓扑序列1:v v v v v v v
3 5 0 1 2 3 4 5 6
v 拓扑序列2:v v v v v v v
0 1 3 2 4 5 6
1
v v 拓扑序列3:v v v v v v v
0 1 3 2 5 4 6
2 6
v
拓扑序列4:v v v v v v v
0 1 3 0 2 4 5 6
v 拓扑序列5:v v v v v v v
4 1 3 0 2 5 4 6考点六: AOV网和拓扑排序
步骤
基本原理
(3)重复上述两
(1)从有向图中 (2)从图中删
步,直到剩余的图
选择一个没有前驱 去该顶点,并且
中不再存在没有前
(即入度为0)的 删去从该顶点发
驱的顶点为止。
顶点并且输出它。 出的求全解部问有题向边。考点六: AOV网和拓扑排序
v v v
1 2 2 v
2
v 4 v 3 v 4 v 3 v 4 v 3
v v v v v
6 5 6 5 5
(a) 有向图 (b) 输出v 后 (c) 输出v 后
1 6考点六: AOV网和拓扑排序
v v v
2 2 2
v v
4 3 v
3
v
5 v v
5 5
(c) 输出v 后
6
(d) 输出v 后 (e) 输出v 后
4 3
v
5
(f) 输出v 后
2考点六: AOV网和拓扑排序
算法:拓扑排序TopSort
输入:AOV网 G=(V,E)
输出:拓扑序列
1. 重复下述操作,直到输出全部顶点,或AOV网中不存在没有前驱的顶点
1.1 从AOV网中选择一个没有前驱的顶点并且输出;
1.2 从AOV网中删去该顶点,并且删去所有以该顶点为尾的弧;
v v
拓扑序列:
3 5
v
1 v v v v v v v
0 1 2 3 4 5 6
v v
2 6
v
0
v
4考点六: AOV网和拓扑排序
图采用什么存储结构呢? 邻接表
算法:拓扑排序TopSort
输入:AOV网 G=(V,E)
输出:拓扑序列
1. 重复下述操作,直到输出全部顶点,或AOV网中不存在没有前
驱的顶点
1.1 从AOV网中选择一个没有前驱的顶点并且输出;
1.2 从AOV网中删去该顶点,并且删去所有以该顶点为尾的弧;考点六: AOV网和拓扑排序
邻接表
图采用什么存储结构呢?
在邻接表中,如何求顶点的入度? 顶点表中增加入度域
算法:拓扑排序TopSort
输入:AOV网 G=(V,E)
输出:拓扑序列
1. 重复下述操作,直到输出全部顶点,或AOV网中不存在没有前
驱的顶点
1.1 从AOV网中选择一个没有前驱的顶点并且输出;
1.2 从AOV网中删去该顶点,并且删去所有以该顶点为尾的弧;考点六: AOV网和拓扑排序
邻接表
图采用什么存储结构呢?
在邻接表中,如何求顶点的入度? 顶点表中增加入度域
如何查找没有前驱的顶点? 设置栈
in vertex firstedge
v v
0 1
0 3 v ∧
0
0 3 ∧
1 0 v
1
v v v
2 3 4 2 1 v 0 3 ∧
2
v
1 3 3 v 0 5 ∧
3
v v
4 5 S 4 0 v 2 3 5 ∧
4
∧
5 2 v
5考点六: AOV网和拓扑排序
图:带入度的邻接表 栈:入度为 0 的顶点(编号)
算法:TopSort
输入:有向图G=(V,E)
输出:拓扑序列
1. 栈 S 初始化;累加器 count 初始化;
2. 扫描顶点表,将入度为 0 的顶点压栈;
3. 当栈 S 非空时循环
3.1 j = 栈顶元素出栈;输出顶点j;count++;
3.2 对顶点 j 的每一个邻接点 k 执行下述操作:
3.2.1 将顶点 k 的入度减 1;
3.2.2 如果顶点 k 的入度为 0,则将顶点 k 入栈;
4. if (count<vertexNum) 输出有回路信息;考点六: AOV网和拓扑排序
void CountInDegree(ALGraph& g, int indegree[]) {
// 初始化入度数组
for (int i = 0; i < g.n; ++i) {
indegree[i] = 0;
}
for (int i = 0; i < g.n; ++i) {
for (ArcNode* p = g.adjlist[i].firstarc; p; p = p->nextarc) {
++indegree[p->adjvex];
}
}
}考点六: AOV网和拓扑排序
in vertex firstedge
v v
0 1
0 3 v ∧
0
0 3 ∧
1 0 v
1
v v v
2 3 4 2 1 v 0 3 ∧
2
v
1 3 3 v 0 5 ∧
3
v v
4 5 S 4 0 v 2 3 5 ∧
4
∧
5 2 v
5考点六: AOV网和拓扑排序
// 拓扑排序
// 若图G无回路,返回true,并通过topo返回G的一个拓扑序列
// 否则,返回false
bool TopologicalSort(ALGraph& g, VNode topo[]) {
int indegree[MAXSIZE];
CountInDegree(g, indegree);
queue<int> q;
for (int i = 0; i < g.n; ++i) {
if (indegree[i] == 0) {
q.push(i); // 将入度为0的顶点入队
}
}考点六: AOV网和拓扑排序
in vertex firstedge
v v
0 1
0 3 v
∧
0
1 0 v 0 3 ∧
1
v v 42
2 3
2 1 0 v 0 3 ∧
2
1
3 3 2 v
0 5 ∧
3
v v
4 5 S 4 0 v
2 3 5 ∧
4
5 2 1 v ∧
5考点六: AOV网和拓扑排序
// 拓扑排序
// 若图G无回路,返回true,并通过topo返回G的一个拓扑序列
// 否则,返回false
bool TopologicalSort(ALGraph& g, VNode topo[]) {
int cnt = 0;
while (!q.empty()) {
int v = q.front();
q.pop();
topo[cnt++] = g.adjlist[v];
for (ArcNode* p = g.adjlist[v].firstarc; p; p = p->nextarc) {
if (--indegree[p->adjvex] == 0) { // 将v的邻接点的入度减1
q.push(p->adjvex); // 将入度为0的顶点入队
}
}
}
return cnt == g.n;
}考点六: AOV网和拓扑排序
in vertex firstedge
v v
0 1
0 3 v
∧
0
1 0 v 0 3 ∧
1
v v 42
2 3
2 1 0 v 0 3 ∧
2
1
3 3 2 v
0 5 ∧
3
v v
4 5 S 4 0 v
2 3 5 ∧
4
5 2 1 v ∧
5考点六: AOV网和拓扑排序
◆拓扑排序唯一性问题:
v
4
v
1
v
6
v
0 v
3
v
2
v
5
拓扑序列往往是不唯一的,且有两种情形会导致拓扑序列不唯一。如图所示,
存在一个入度为0的点,但是存在顶点1和顶点2,顶点4和顶点5平行(他们之间
无前驱或者后继的关系)的情况,此时顶点1和顶点2,顶点4和定点5的先后顺
序在拓扑序列中是不确定的。考点六: AOV网和拓扑排序
◆拓扑排序唯一性问题:
v
4
v
1
v
6
v
3
v
2
v
5
如图所示,存在多个入度为0的点,也就是顶点1和顶点2的入度为0,那么他们
之间的先后关系也是不确定的。考点六: AOV网和拓扑排序
◆ 拓扑排序遇到有环图:
睡觉
学习 学习
吃饭
考研er的日常生活
➢ 入度为零的不存在考点六: AOV网和拓扑排序
◆ 拓扑排序遇到有环图:
查专业
买书
睡觉
学习 学习
吃饭
考研er的日常生活
➢ 入度为零的存在但是存在环考点六: AOV网和拓扑排序
◆ 拓扑排序遇到有环图:
产生的拓扑序列包含全部的顶点
产生的拓扑序列不包含全部的顶点【政哥题型总结】考点六: AOV网和拓扑排序
1.已知有向图G=(V,E),其中V={v ,v ,v ,v ,v ,v ,v },E={<v ,
1 2 3 4 5 6 7 1
v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,
2 1 3 1 4 2 5 3 5 3 6 4
v >,<v ,v >,<v ,v >},G的一个拓扑序列是( )。
6 5 7 6 7
A.(v ,v ,v ,v ,v ,v ,v ) B.(v ,v ,v ,v ,v ,v ,v )
1 4 3 6 2 5 7 4 3 2 6 4 5 7
C.(v ,v ,v ,v ,v ,v ,v ) D.(v ,v ,v ,v ,v ,v ,v )
1 3 4 5 2 6 7 1 2 5 3 4 6 7考点六: AOV网和拓扑排序
1.已知有向图G=(V,E),其中V={v ,v ,v ,v ,v ,v ,v },E={<v ,
1 2 3 4 5 6 7 1
v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,
2 1 3 1 4 2 5 3 5 3 6 4
v >,<v ,v >,<v ,v >},G的一个拓扑序列是( )。
6 5 7 6 7
A.(v ,v ,v ,v ,v ,v ,v ) B.(v ,v ,v ,v ,v ,v ,v )
1 4 3 6 2 5 7 4 3 2 6 4 5 7
C.(v ,v ,v ,v ,v ,v ,v ) D.(v ,v ,v ,v ,v ,v ,v )
1 3 4 5 2 6 7 1 2 5 3 4 6 7
A【解析】本题中的图G如图所示。
V2
V5
V1
V7
V3
V6
V4考点六: AOV网和拓扑排序
1.已知有向图G=(V,E),其中V={v ,v ,v ,v ,v ,v ,v },E={<v ,
1 2 3 4 5 6 7 1
v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,
2 1 3 1 4 2 5 3 5 3 6 4
v >,<v ,v >,<v ,v >},G的一个拓扑序列是( )。
6 5 7 6 7
A.(v ,v ,v ,v ,v ,v ,v ) B.(v ,v ,v ,v ,v ,v ,v )
1 4 3 6 2 5 7 4 3 2 6 4 5 7
C.(v ,v ,v ,v ,v ,v ,v ) D.(v ,v ,v ,v ,v ,v ,v )
1 3 4 5 2 6 7 1 2 5 3 4 6 7
A【解析】本题中的图G如图所示。
V2 V2
V5 V5
V1
V7 V7
V3 V3
V6 V6
V4 V4
输出v1后考点六: AOV网和拓扑排序
V2
V5 v1 v2
V5 V7
v1 v3
V3
V7
V3 v1 v4
V6
V4
V6
V4
输出v2后
输出v1后
V2
V2
V5
V5
V7
V7
V3
V6
V6
V4
输出v3后 输出v4后考点六: AOV网和拓扑排序
V5 V5
v1 v2 v3
V7 V7
V3
v1 v2 v4
V6 V6
V4 V4
输出v2后 输出v3后
V5
V7
V3
V6
输出v4后考点六: AOV网和拓扑排序
V5
v1 v2 v3 v4
V5
V7
V7
V6
V6
V4
输出v3后
输出v4后
V7 V7
v1 v2 v3 v4 v5 v6
输出v6后
V6
输出v5后
输出v7
v1 v2 v3 v4 v5
v1 v2 v3 v4 v5 v6 v7考点六: AOV网和拓扑排序
1.已知有向图G=(V,E),其中V={v ,v ,v ,v ,v ,v ,v },E={<v ,
1 2 3 4 5 6 7 1
v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,
2 1 3 1 4 2 5 3 5 3 6 4
v >,<v ,v >,<v ,v >},G的一个拓扑序列是( )。
6 5 7 6 7
A.(v ,v ,v ,v ,v ,v ,v ) B.(v ,v ,v ,v ,v ,v ,v )
1 4 3 6 2 5 7 4 3 2 6 4 5 7
C.(v ,v ,v ,v ,v ,v ,v ) D.(v ,v ,v ,v ,v ,v ,v )
1 3 4 5 2 6 7 1 2 5 3 4 6 7
A【解析】本题中的图G如图所示。
本题的图G的拓扑排序可以得到
V2
多个正确的拓扑序列,如(v ,v ,
V5 1 4
V1
v ,v ,v ,v5,v )或(v ,v ,
V7
3 6 2 7 1 3
V3
v ,v ,v ,v ,v )等。
4 2 6 5 7
V6
V4考点六: AOV网和拓扑排序
1.已知有向图G=(V,E),其中V={v ,v ,v ,v ,v ,v ,v },E={<v ,
1 2 3 4 5 6 7 1
v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,
2 1 3 1 4 2 5 3 5 3 6 4
v >,<v ,v >,<v ,v >},G的一个拓扑序列是( )。
6 5 7 6 7
A.(v ,v ,v ,v ,v ,v ,v ) B.(v ,v ,v ,v ,v ,v ,v )
1 4 3 6 2 5 7 4 3 2 6 4 5 7
C.(v ,v ,v ,v ,v ,v ,v ) D.(v ,v ,v ,v ,v ,v ,v )
1 3 4 5 2 6 7 1 2 5 3 4 6 7
A【解析】本题中的图G如图所示。
上述方法是常规的做法,其实我们
V2
还可以根据选项来找违例。例如,
V5
V1 看B选项,<v ,v >与<v ,v >
6 4 4 6
V7
V3 是违背的;
V6
V4考点六: AOV网和拓扑排序
1.已知有向图G=(V,E),其中V={v ,v ,v ,v ,v ,v ,v },E={<v ,
1 2 3 4 5 6 7 1
v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,
2 1 3 1 4 2 5 3 5 3 6 4
v >,<v ,v >,<v ,v >},G的一个拓扑序列是( )。
6 5 7 6 7
A.(v ,v ,v ,v ,v ,v ,v ) B.(v ,v ,v ,v ,v ,v ,v )
1 4 3 6 2 5 7 4 3 2 6 4 5 7
C.(v ,v ,v ,v ,v ,v ,v ) D.(v ,v ,v ,v ,v ,v ,v )
1 3 4 5 2 6 7 1 2 5 3 4 6 7
A【解析】本题中的图G如图所示。
上述方法是常规的做法,其实我们
V2
还可以根据选项来找违例。例如,
V5
V1 看C选项,<v ,v >与<v ,v >
5 2 2 5
V7
V3 是违背的;
V6
V4考点六: AOV网和拓扑排序
1.已知有向图G=(V,E),其中V={v ,v ,v ,v ,v ,v ,v },E={<v ,
1 2 3 4 5 6 7 1
v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,v >,<v ,
2 1 3 1 4 2 5 3 5 3 6 4
v >,<v ,v >,<v ,v >},G的一个拓扑序列是( )。
6 5 7 6 7
A.(v ,v ,v ,v ,v ,v ,v ) B.(v ,v ,v ,v ,v ,v ,v )
1 4 3 6 2 5 7 4 3 2 6 4 5 7
C.(v ,v ,v ,v ,v ,v ,v ) D.(v ,v ,v ,v ,v ,v ,v )
1 3 4 5 2 6 7 1 2 5 3 4 6 7
A【解析】本题中的图G如图所示。
上述方法是常规的做法,其实我们
V2
还可以根据选项来找违例。例如,
V5
V1 看D选项,<v ,v >与<v ,v >
5 3 3 5
V7
V3 是违背的。
V6
V4考点六: AOV网和拓扑排序
2.在有向图G的拓扑序列中,若顶点v 在顶点v 之前,则下列情形不可能出现
i j
的是( )。
A.G中有弧<v ,v > B.G中有一条从v 到v 的路径
i j i j
C.G中没有弧<v ,v > D.G中有一条从v 到v 的路径
i j j i考点六: AOV网和拓扑排序
2.在有向图G的拓扑序列中,若顶点v 在顶点v 之前,则下列情形不可能出现
i j
的是( )。
A.G中有弧<v ,v > B.G中有一条从v 到v 的路径
i j i j
C.G中没有弧<v ,v > D.G中有一条从v 到v 的路径
i j j i
D【解析】在有向图G的拓扑序列中,若顶点v 在顶点v 之前,则存在3种情况,
i i
如图所示,其中第①种情况对应A选项,第②种情况对应B选项,第③种情况对
应C选项,此时v 和v 之间没有强制的先后关系,这就涉及了拓扑序列的不唯一性。
i j
①
Vi Vj
② Vi V Vj
Vi V2
③
V1
Vj V3考点六: AOV网和拓扑排序
2.在有向图G的拓扑序列中,若顶点v 在顶点v 之前,则下列情形不可能出现
i j
的是( )。
A.G中有弧<v ,v > B.G中有一条从v 到v 的路径
i j i j
C.G中没有弧<v ,v > D.G中有一条从v 到v 的路径
i j j i
D【解析】D选项G中有一条从v 到v 的路径,那意味着,二者的关系如图所示,
j i
那么在拓扑序列中,顶点v 在顶点v 之前
j i
Vj V ViTHANKSCON T EN T S
目录
考点一 图的基本概念 ★★★★
考点二 图的存储 ★
考点三 图的遍历 ★★
考点四 最小生成树 ★★★★★
考点五 最短路径 ★★
考点六 AOV网和拓扑排序 ★★★★★
考点七 AOE网和关键路径 ★★★★考点框架
AOE(Activity On Edge):在一个表示工程的带权有向图中,用
关键路径 顶点表示事件,用有向边表示活动,用边上的权值表示活动的
持续时间,这种有向图的边表示活动的网称为AOE网。考点框架
AOE网
关键路径与关键活动
最早时间和最晚时间【AOE网】考点七:AOE网和关键路径
什么是工程?工程有什么共性?
几乎所有的工程都可以分为若干个称作活动的子工程
活动之间存在某些制约关系
每个活动通常需要一个持续的时间考点七:AOE网和关键路径
源点:整个工程的开始点,其入度为0
终点:整个工程的结束点,其出度为0
AOE网(边表示活动的网):在一个表示工程的带权有向图中,用顶
点表示事件,用有向边表示活动,边上的权值表示活动的持续时间
➢ 用一个带权有向图(DAG)描述工程的预计进度。
➢ 顶点表示事件,有向边表示活动,边e的权c(e)表示完成活动e所需
的时间(比如天数)。考点七:AOE网和关键路径
v
事件 事件含义
1
a =4 a =6
0 4
v 源点,整个工程开始
0
v a =2 v
0 2 3
v 活动 a 完成,活动 a 和 a 可以开始
1 0 2 4
a =3 a =4
v
v 活动 a 和 a 完成,活动 a 可以开始 1 3
2 1 2 3 2
v 活动 a 和 a 完成,整个工程结束
3 3 4
AOE网的性质:
(1)只有在进入某顶点的各活动都已经结束,该顶点所代表的事件才能发生
(2)只有在某顶点所代表的事件发生后,从该顶点出发的各活动才能开始【关键路径与关键活动】考点七:AOE网和关键路径
AOE网能够解决什么问题?
(1) 完成整个工程至少需要多少时间?
(2)为缩短完成工程所需的时间, 应当加快哪些活动?考点七:AOE网和关键路径
从AOE网中源点到汇点的最长路径,具有最大长度的路径叫关键路径。
汇点
b g
6
1 8 2
a
e k
4
1 7
4
源点
5
c h
一条关键路径
4
2
d f考点七:AOE网和关键路径
从AOE网中源点到汇点的最长路径,具有最大长度的路径叫关键路径。
关键路径是由关键活动构成的,关键路径可能不唯一。
不按期完成关键活动就会影响整个工程的进度
换言之,要缩短整个工期,必须加快关键活动的进度考点七:AOE网和关键路径
如何求关键路径呢? 求关键活动
如何求关键活动呢?关键活动为什么是关键的?
关键活动的开始时间不能推迟
关键活动的最早开始时间和最晚开始时间相等考点七:AOE网和关键路径
如何求关键路径呢? 挨个数 P1:22
a7=8
a3=9
v v
3 6
v a11=2
1 a8=4
a4=13
a1=3
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12
a10=11
v
2 v
5
a6=7考点七:AOE网和关键路径
如何求关键路径呢? 挨个数 P1:22
P2:21
a7=8
a3=9
v v
3 6
v a11=2
1 a8=4
a4=13
a1=3
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12
a10=11
v
2 v
5
a6=7考点七:AOE网和关键路径
如何求关键路径呢? 挨个数 P1:22
P2:21
a7=8
a3=9
v v P3:27
3 6
v a11=2
1 a8=4
a4=13
a1=3
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12
a10=11
v
2 v
5
a6=7考点七:AOE网和关键路径
如何求关键路径呢? 挨个数 P1:22
P2:21
a7=8
a3=9
v v P3:27
3 6
v a11=2 P4:33
1 a8=4
a4=13
a1=3
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12
a10=11
v
2 v
5
a6=7考点七:AOE网和关键路径
如何求关键路径呢? 挨个数 P1:22
P2:21
a7=8
a3=9
v v P3:27
3 6
v a11=2 P4:33
1 a8=4
a4=13
a1=3
P5:33
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12
a10=11
v
2 v
5
a6=7考点七:AOE网和关键路径
如何求关键路径呢? 挨个数
a7=8
a3=9
v v
3 6
v a11=2 P4:33
1 a8=4
a4=13
a1=3 P5:33
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12
a10=11
v
2 v
5
a6=7
该AOE网的关键路径是: (v0, v2, v4, v7 , v8) 和(v0, v2, v5 , v7 , v8) 。考点七:AOE网和关键路径
如何求关键路径呢? 挨个数
a7=8
a3=9
v v
3 6
v a11=2 P4:33
1 a8=4
a4=13
a1=3 P5:33
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12
a10=11
v
2 v
5
a6=7
关键路径活动是:a2,a5,a6,a9,a10,a12。【最早时间和最晚时间】考点七:AOE网和关键路径
事件v的最早开始时间:规定源点事件的最早开始时间为0。定义图中任一事件v
的最早开始时间(early event)ee(v)等于x、y、z到v所有路径长度的最大值:
ee(v)=0 当v为源点时
ee(v)=MAX{ee(x)+a,ee(y)+b,ee(z)+c} 否则
ee(x) x
a
b
从左向右推进计算
ee(y) y v ee(v)=?
c 这是为什么源点要唯一!
ee(z) z考点七:AOE网和关键路径
事件v的最迟开始时间:定义在不影响整个工程进度的前提下,事件v必须发生的
时间称为v的最迟开始时间(late event) ,记作le(v)。le(v)应等于ee(y)与v到
汇点的最长路径长度之差:
le(v)=ee(v) 当v为汇点时
le(v)=MIN{le(x)-a,le(y)-b,le(z)-c} 否则
le(x)
x
a
b 从右向左推进计算
le(v)=? v y le(y)
这是为什么汇点要唯一!
c
le(z)
z考点七:AOE网和关键路径
ee(x) le(y)
活动a
x y
时间为c
活动a的最早开始时间e(a)指该活动起点x事件的最早开始时间,即:
e(a)=ee(x)
活动a的最迟开始时间l(a)指该活动终点y事件的最迟开始时间与该活
动所需时间之差,即:
l(a)=le(y)-c考点七:AOE网和关键路径
F
B
E
a =4
a =4
2
A C 11
G I
D
H
a =2
6
先进行拓扑排序,假设拓扑序列为:ABCDEFGHI
计算各事件的ee(v)如下:
ee(A)=0
ee(B)=ee(A)+c(a)=6
1
ee(C)=ee(A)+c(a)=4
2
ee(D)=ee(A)+c(a)=5
3
ee(E)=MAX(ee(B)+c(a),ee(C)+c(a)}=MAX{7,5}=7
4 5考点七:AOE网和关键路径
F
B
E
a =4
a =4
2
A C 11
G I
D
H
a =2
6
ee(F)=ee(E)+c(a)=16
7
ee(G)=ee(E)+c(a)=14
8
ee(H)=ee(D)+c(a)=7
6
ee(I)=MAX{ee(F)+c(a ),ee(G)+c(a ),ee(H)+c(a)}
10 11 9
=MAX(18,18,11}=18考点七:AOE网和关键路径
F
B
E
a =4
a =4
2
A C 11
G I
D
H
a =2
6
拓扑序列为ABCDEFGHI,按拓扑逆序IHGFEDCBA计算各事件的le(v)如下:
le(I)=ee(I)=18
le(H)=le(I)-c(a)=14
9
le(G)=le(I)-c(a )=14
11
le(F)=le(I)-c(a )=16
10考点七:AOE网和关键路径
F
B
E
a =4
a =4
2
A C 11
G I
D
H
a =2
6
le(E)=MIN(le(F)-c(a),le(G)-c(a)}={7,7}=7
7 8
le(D)=le(H)-c(a)=12
6
le(C)=le(E)-c(a)=6
5
le(B)=le(E)-c(a)=6
4
le(A)=MIN(le(B)-c(a),le(C)-c(a),le(D)-c(a)}={0,2,7}=0
1 2 3考点七:AOE网和关键路径
F
B
E
a =4
a =4
2
A C 11
G I
D
H
a =2
6考点七:AOE网和关键路径
F
B
E
a =4
a =4
2
A C 11
G I
D
H
a =2
6
le(E)=MIN(le(F)-c(a),le(G)-c(a)}={7,7}=7
7 8
le(D)=le(H)-c(a)=12
6
le(C)=le(E)-c(a)=6
5
le(B)=le(E)-c(a)=6
4
le(A)=MIN(le(B)-c(a),le(C)-c(a),le(D)-c(a)}={0,2,7}=0
1 2 3考点七:AOE网和关键路径
a7=8
a3=9
v v
3 6
v a11=2
1 a8=4
a4=13
a1=3
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12 a10=11
v
2 v
5
a6=7
我们把l(i)- e(i)定义为松弛量,而关键活动的松弛量为0;其实是关键活动的
时间决定了整个工期的进度。考点七:AOE网和关键路径
➢ 若关键活动耗时增加,则整个⼯程的⼯期将增⻓
➢ 缩短关键活动的时间,可以缩短整个⼯程的⼯期
a7=8
a3=9
v v
3 6
v a11=2
1 a8=4
a4=13
a1=3
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12 a10=11
v
2 v
5
a6=7考点七:AOE网和关键路径
➢ 若有多条关键路径,只提⾼⼀条关键路径上的关键活动速度并不能
缩短整个⼯程的⼯期,只有加快那些包括在所有关键路径上的关键
活动才能达到缩短⼯期的⽬的。
a7=8
a3=9
v v
3 6
v a11=2
1 a8=4
a4=13
a1=3
a9=6 a12=5
v v v
4 7 8
v
0
a2=10
a5=12 a10=11
v
2 v
5
a6=7THANKS