ARTICLE · 1002033
一款免费、开源、超快的万能文档转 Markdown 工具,Word/PPT/Excel/PDF 统统拿下,Star 19K+ !
Word、PPT、Excel、PDF、RTF、EPUB……格式一多,转换工具就得堆一堆。有的只认 docx,有的 PDF 要调 OCR,有的表格直接丢内容。最要命的是,不同工具出来的 Markdown 风格还不一样,入库前还得再洗一遍。
一句话介绍 anydoc:扔进去任何办公文档,出来就是统一风格的 GitHub 风格 Markdown。
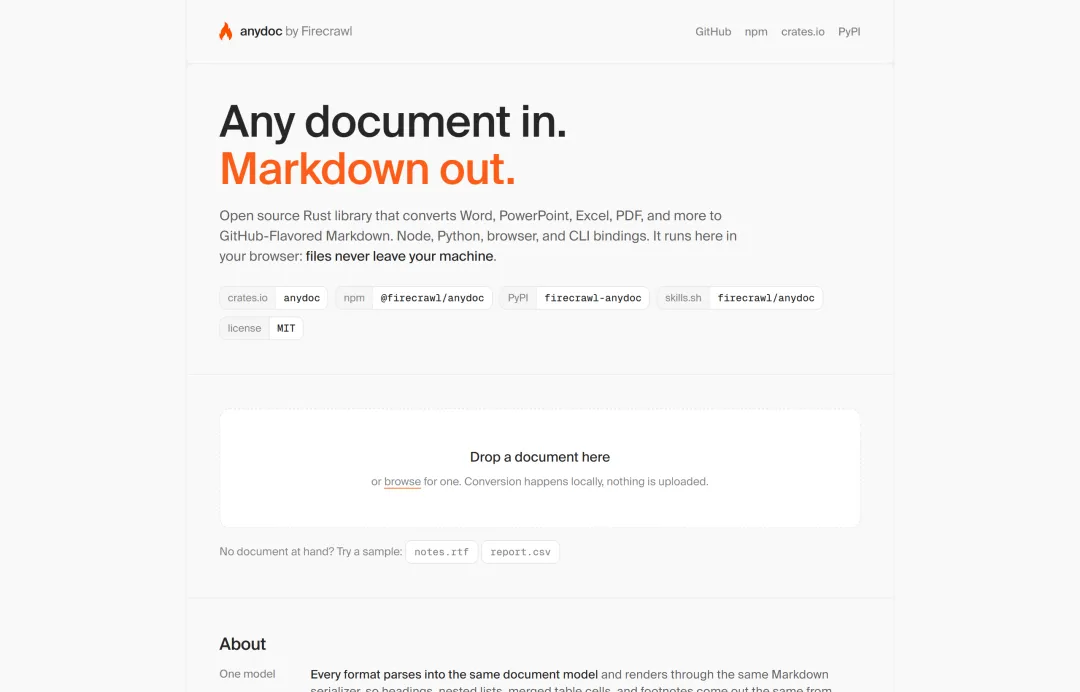
这是 Firecrawl 团队开源的 Rust 库,支持 14 种格式,中位转换耗时不到 5 毫秒——你没看错,是毫秒。而且它自带 Node.js、Python、浏览器(WASM)和 CLI 四套绑定,不管你用什么技术栈都能直接用。
项目简介
anydoc 的定位很清晰:一个输入模型 + 一个输出序列化器 = 所有格式行为一致。
不管是 2003 年的老 .doc 还是昨天刚存的 .pptx,标题层级、嵌套列表、合并单元格、脚注,出来的 Markdown 格式完全相同。这意味着你不用再为"这个格式表头怎么丢了""那个格式列表缩进不对"这类问题折腾。
核心参数一览:
语言:Rust Star:19,836 协议:MIT 支持格式:Word(.doc/.docx/.docm)、PowerPoint(.ppt/.pptx/.pps/.pot/.pptm/.ppsx/.ppsm)、Excel(.xls/.xlsx/.xlsm/.xlsb)、OpenDocument(.odt/.ods/.odp)、RTF、EPUB、CSV、PDF
核心特性
一套模型吃遍所有格式
每种格式先解析成统一的文档对象模型(Document Model),再由同一个 Markdown 序列器输出。修一个格式的表格转义 bug,等于同时修了全部格式。
按文件内容识别格式,不看扩展名
有人把 .docx 改名叫 .pdf?没关系。anydoc 读文件头的真实标记(PDF magic header、RTF open group、OLE stream 名、ZIP mimetype)来判断格式,改个后缀名骗不到它。
纯 Rust 实现,快到离谱
没有 ML 模型,不调外部服务,中位转换时间 4.4 毫秒。在 100 份真实文档的基准测试里,它是唯一覆盖全部 14 种格式的工具,综合得分 81 分,第二名只有 63 分。
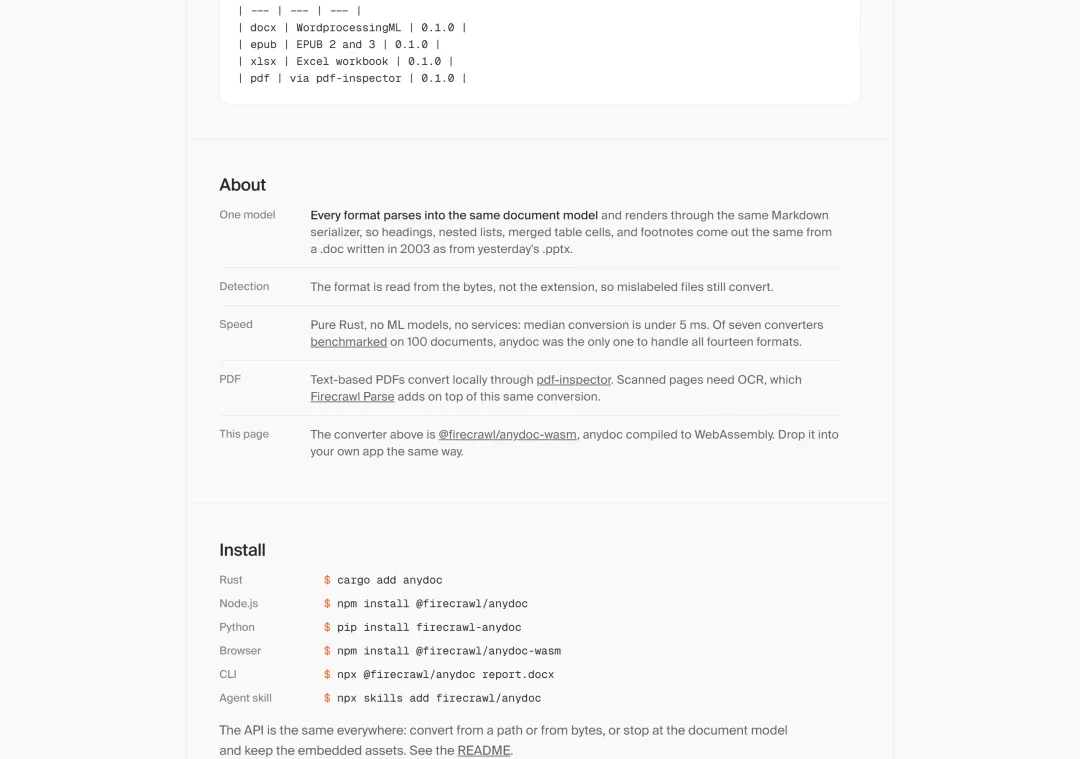
PDF 原生支持 + 可选 OCR 兜底
文本型 PDF 本地直接转,走的是内置的 pdf-inspector。遇到扫描件或图片型页面,可以一键切换到 Firecrawl Parse 托管 OCR,同一份 Markdown 输出,零额外适配成本。
怎么用
安装方式有六种,挑你顺手的来:
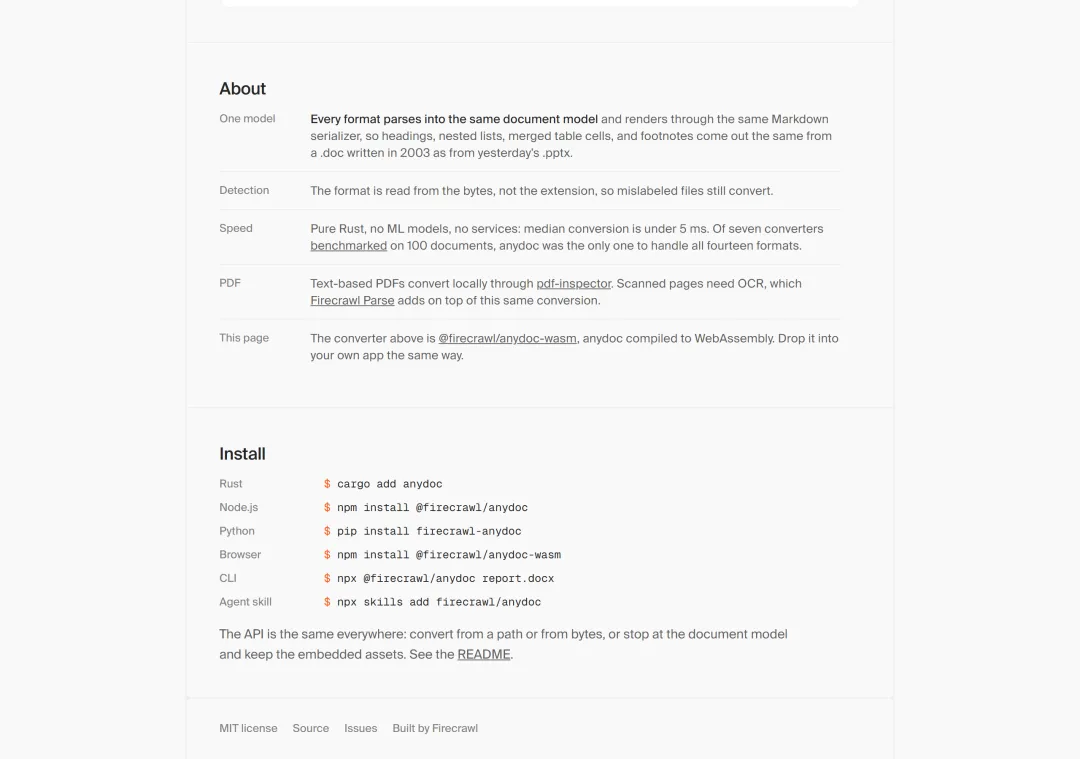
CLI 最省事(推荐)
# 全局安装npm install -g @firecrawl/anydoc# 转换 Word → stdoutnpx @firecrawl/anydoc report.docx# 转换 PPT → 文件npx @firecrawl/anydoc slides.pptx -o slides.md# 从 stdin 读 CSVnpx @firecrawl/anydoc - --format csv < data.csv第一次运行 npx 会自动下载对应平台的预编译二进制文件,之后就是本地执行,不再联网。
Python 三行搞定
pip install firecrawl-anydocimport anydocmarkdown = anydoc.to_markdown("report.docx")print(markdown)Python 版本会释放 GIL,多线程场景不卡其他任务。
Node.js 编程调用
import { toMarkdown } from'@firecrawl/anydoc';const md = awaittoMarkdown('report.docx');// 或从字节流转换const md2 = awaittoMarkdownBytes(buffer);Node.js 版本跑在 libuv 线程池上,不会阻塞事件循环。
Agent Skill:让 AI 自己读文档
npx skills add firecrawl/anydoc装完之后,Claude Code、Codex、Cursor 这类 AI 编程助手就能自己调用 anydoc 来读你丢过去的 Office 文档了。
效果长啥样
拿一份真实的 Word 文档(含一级/二级标题、加粗/斜体、无序列表、嵌套列表、合并单元格表格)实测:
npx @firecrawl/anydoc review.docx输出:
# 2026 年 Q3 开源选型评审本次评审覆盖 **文档解析** 与 *知识库入库* 两条链路。## 候选清单- anydoc:Rust 实现,十四种格式- markitdown:Python 实现,六种格式 - 需要额外确认 OCR 能力## 评分表| 工具 | 格式数 | 中位耗时 || --- | --- | --- || anydoc | 14 | 4.4 ms || libreoffice | 12 | 1129.5 ms |结论:入库前统一转 Markdown。标题、粗体、斜体、列表层级、表格全部保留,干干净净的 GFM Markdown。
PPT 也能转,演讲者备注会变成引用块:
**开源文档解析选型**anydoc / markitdown / pandoc 对比> 开场先说清痛点:格式太杂,入库口径不一致。**三条结论**- 一套输出模型,格式差异被吃掉- 中位耗时 4.4 ms,够进实时链路- 扫描件走 hosted OCR 兜底> 这页留 30 秒给提问。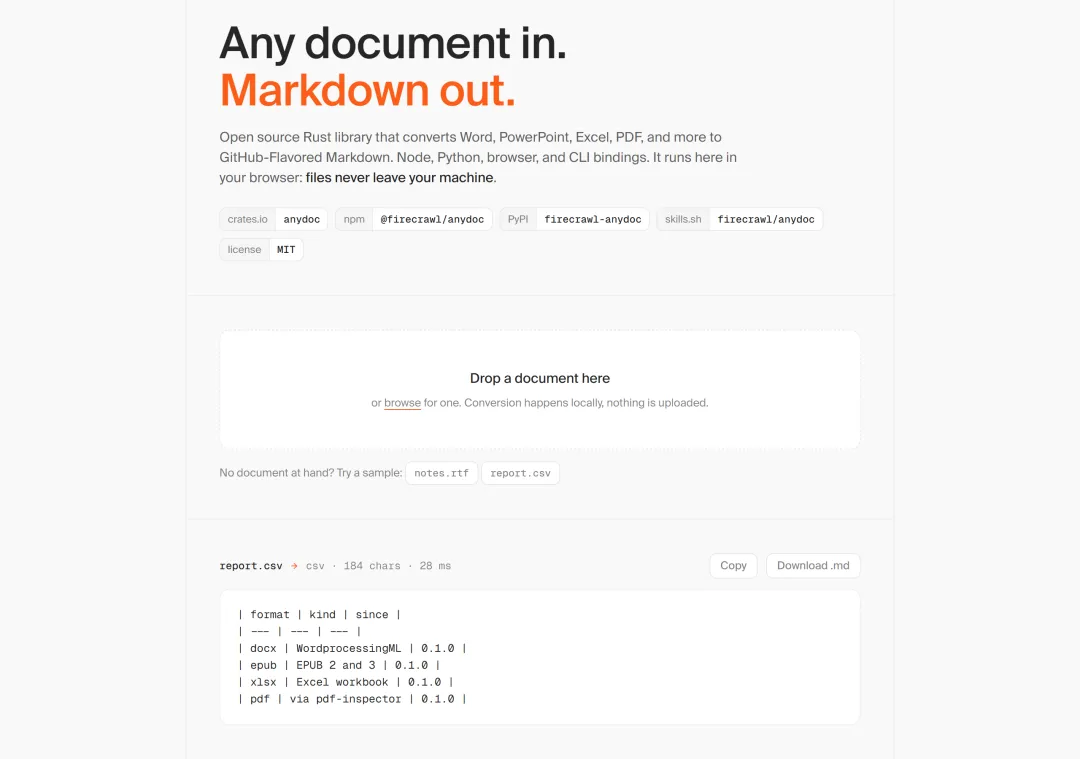
Demo 页面用的是 WASM 编译版,文件在你浏览器里完成转换,不会上传到任何服务器。点「Try a sample」可以直接试 notes.rtf 或 report.csv 两个示例。
为什么值得用
对个人开发者:写博客、整理笔记、把老板发的 Word 方案转成 Markdown 存 Obsidian,一条命令的事。不用再开 Word 复制粘贴了。
对团队 / 企业:知识库入库(比如 MaxKB)、RAG 管道预处理、合同/标书结构化提取——只要涉及"多种文档格式 → 统一文本",anydoc 都能当标准转换层。14 种格式全覆盖意味着不用再维护"这个格式用 A 工具、那个格式用 B 工具"的分支逻辑。
速度带来的可能性:4.4 毫秒的中位耗时意味着它可以塞进实时链路。用户上传文档 → anydoc 转 Markdown → 送进 LLM / 向量库,整条链路可以在亚秒级完成。
扫描件也不怕:本地搞不定的扫描 PDF,一行参数切到 Firecrawl Parse 托管 OCR,输出还是同款 Markdown,代码不用改。
收尾
如果你也被"格式太多、转换太慢、输出不一致"折磨过,anydoc 值得放进工具箱。Rust 写的就是稳,19K+ Star 一个月涨出来的,社区认可度摆在那里。
下次再收到一堆 .docx/.pptx/.pdf,试试 npx @firecrawl/anydoc,也许就回不去了。
https://github.com/firecrawl/anydoc