ARTICLE · 1006699
纯文本 RAG 为何在真实文档前失效:多模态知识理解的失效边界与四层架构
纯文本 RAG 为何在真实文档前失效:多模态知识理解的失效边界与四层架构
周一早上 9 点,一位数据分析师给你搭的企业知识库提了个问题:"Q3 华东区退货率环比 Q2 变化多少?" 这个数据白纸黑字(准确说是彩色柱状图)躺在一份季度经营报告 PDF 的第 14 页。系统检索了 3 秒,返回:"未找到相关信息。" 分析师截图发到群里,配了句"这库还不如我自己翻"。
你打开日志排查。检索管线一切正常:向量库连得上,Embedding 服务健康,Top-K 也召回了那份报告的若干 chunk。问题出在更上游——那张记录退货率的柱状图,在文档入库时被 PDF 文本抽取器直接跳过了。图里的数字从来没进过索引。不是检索"没找到",是这条信息压根不存在于系统的世界里。
这不是个例。企业里真正有价值的文档——经营报告、财务报表、产品手册、合同、工程图纸、扫描件——信息大量沉淀在版面结构、表格、图表、公式和图片里。有一个经常被引用的经验判断:真实业务文档里,超过一半的关键信息不是以"连续自然段文本"形式存在的。纯文本 RAG 管线的第一步就把这半壁江山扔掉了,后面的 Embedding 再好、重排再准、Prompt 再精巧,都是在剩下那一半信息里打转。
这篇文章要回答三件事:纯文本 RAG 到底在哪些场景失效、失效的机制根因是什么、以及一个能"看懂"真实文档的系统应该长成什么样。我会先把失效边界诊断清楚,再拆解根因,然后对比三条应对路线,最后给出多模态知识系统的四层架构,并说明它和大家熟悉的通用 RAG 五层架构差在哪。
先说清楚读者是谁:如果你已经搭过一套 RAG,跑通了文本问答,但一接入真实的企业 PDF、扫描件、财报就开始出现"莫名其妙查不到"的问题,那这篇文章就是写给你的。它不教你从零搭 RAG(那是通用 RAG 的内容),而是帮你看清纯文本管线的天花板在哪、以及要突破这个天花板需要往系统里加哪些东西。整个系列都建立在一个前提上:你不缺检索的基础能力,你缺的是让系统"看懂"非文本内容的能力。
一、失效诊断:纯文本 RAG 在哪些文档前面装不下去
要谈多模态,先得说清楚"不多模态会死在哪"。抽象地喊"文档很复杂"没用,得能精确判断一份文档、一个查询会不会踩中纯文本管线的盲区。
先给一个判断流程。当一个查询命中失败时,不要急着调 Embedding 模型或改 chunk 大小,先沿着下面这条决策树走一遍,定位失败发生在哪一层。
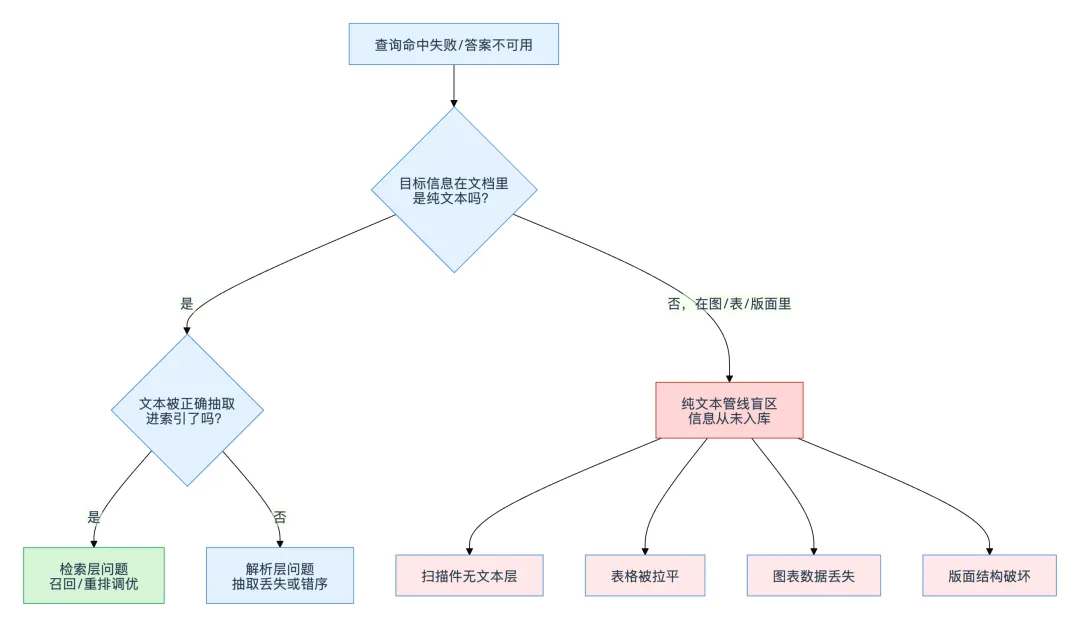
这张决策树的价值在于把责任划清:走到最右边 C 分支的失败,属于纯文本管线的结构性盲区,调检索参数永远修不好;走到 D 的才是检索层能解决的问题。很多团队的误区是把 C 类失败当成 D 类来治,于是不断换 Embedding 模型、加重排,指标却纹丝不动——因为信息根本没进系统。
这个误区之所以普遍,是因为两类失败在表象上一模一样:都是"用户问了问题,系统答不好"。区分它们需要一个额外动作——回到源文档,确认目标信息以什么形态存在,以及它到底进没进索引。这个动作很多团队跳过了,直接从"答得不好"跳到"检索不行",于是把所有精力砸在检索调优上。一个实用的排查习惯是:每当出现命中失败,先把召回的原始 chunk 拉出来人眼看一遍,如果 chunk 里压根没有目标信息(或者信息是乱序的、残缺的),那问题就在理解层,别在检索层浪费时间。这个"先看召回内容、再看召回排序"的顺序,能省掉大量方向性错误的调优。
把最右边这一列失效展开,可以归纳成五种典型特征。它们不是并列的现象,而是"信息在从文档到索引的路上被丢失或破坏"的五种不同形态。
这张表可以直接当排查清单用。诊断的第一动作不是看查询,而是看目标信息在源文档里以什么形态存在——文本、表格、图表还是版面关系。这决定了它会不会踩中上面某一类盲区。
把这五类失效逐个说透,才能理解它们为什么修不好,而不是笼统地归为"文档复杂"。
扫描件无文本层是最容易被忽视的一类,因为它连"错误内容"都不产生。很多企业的合同、发票、老档案是扫描进系统的,本质是一张张图片包在 PDF 容器里,没有可选中的文本层。抽取器对着一张图片调 get_text,返回的是空字符串。这类文档如果不做 OCR,等于根本没入库。更隐蔽的情况是"混合型 PDF"——前几页是电子版有文本层,中间夹了几页扫描件,抽取时前几页正常、扫描页静默变空,人工抽检很难发现这个断层。
表格被拉平的危害在于它产生的是"看起来对、实际错"的内容。一张财务表在人眼里是二维的行列结构,但在 PDF 底层它只是一堆带坐标的文本片段。抽取器按坐标的物理顺序(通常是从上到下、从左到右)把这些片段串起来,行列的对应关系就丢了。检索时这段乱序文本还可能因为包含"华东""毛利率""32%"这些关键词而被召回,于是 LLM 拿到一段它自己都对不齐的文本,只能瞎猜——这比召回不到更危险,因为它会给出一个看起来言之凿凿的错误答案。
图表数据丢失是覆盖面最广的一类。柱状图、折线图、饼图里的数值,在文档里既没有对应的文字,OCR 也读不出趋势(顶多读出坐标轴刻度和图例文字)。一份经营分析报告的核心结论往往就在几张图里,纯文本管线把图整个跳过,等于把报告最值钱的部分扔了。
版面结构破坏主要出现在多栏排版的论文、杂志、双栏报告里。抽取器不理解"左栏读完读右栏"这个人类阅读约定,会把同一水平线上的左右栏文字交错拼接,产生语义完全断裂的句子。读者问"第二章的结论",召回的可能是左栏某句话和右栏某句话缝合出来的怪物。
跨页表断裂则是长表格特有的问题。一张 12 个月的月度数据表跨了两页,抽取时被页边界一刀切成两半,页眉页脚("第 X 页""公司机密")还会混进表格数据里。查"全年月度数据"时,最多召回半张表,另一半在另一个 chunk 里,两者还未必都被召回。
这五类失效的共同点是:它们都发生在"文档 → 文本"这一步,都是静默的,且都无法靠调检索参数修复。这是判断一个查询失败该不该归因于多模态盲区的核心依据。
为了让"表格被拉平"这类失效更具体,看一段真实会发生的抽取代码。很多团队线上跑的就是类似逻辑:
import fitz # PyMuPDF,最常见的 PDF 文本抽取库defextract_text(pdf_path: str) -> str: doc = fitz.open(pdf_path) chunks = []for page in doc:# get_text("text") 按内部字符流顺序输出,不理解表格/多栏 chunks.append(page.get_text("text"))return"\n".join(chunks)# ── AI 视角 ──# "这段代码干净利落地把 PDF 转成了纯文本,可以直接送去切分和 Embedding 了"# ── 实际含义 ──# get_text("text") 对一张 3 列 5 行的表格,输出的是字符在页面上的物理排列顺序,# 可能变成 "指标 Q1 Q2 Q3 毛利率 32% 35% 华东 华南 ..." 这种行列错位的乱序流。# 表头和数据的对应关系(毛利率对应哪个区域哪个季度)在这一步就永久丢失了。问题的隐蔽性在于:这段代码不报错、不抛异常、输出的字符串看起来"有内容"。它甚至能通过大部分单元测试(断言返回非空字符串)。但对表格而言,字符顺序正确不等于语义正确。下游的切分、Embedding、检索全都建立在这段错序文本之上,错误被静默地放大了。
图表的失效比表格更彻底。表格好歹还剩一堆乱序的字符,图表则是连字符都没有:
defextract_with_images(pdf_path: str): doc = fitz.open(pdf_path) text_parts, image_count = [], 0for page in doc: text_parts.append(page.get_text("text"))# 图片被识别出来了,但只是拿到二进制/xref,没有任何内容理解 image_count += len(page.get_images())# 返回的是文本 + "这页有几张图",图里的数据依旧是零return"\n".join(text_parts), image_count# ── AI 视角 ──# "我们连图片都统计了,说明管线是支持图文的"# ── 实际含义 ──# image_count 只是知道"这里有张图",等价于一个占位符。# 柱状图里 "华东 Q3 退货率 8.2%" 这个数据点,既没被 OCR,也没被理解,# 对检索系统来说,这个数字从未存在过。这两段代码合起来说明一个残酷的事实:纯文本管线的失败往往是静默的。它不会告诉你"我丢了一张图的数据",它只会在某个查询命中失败时,让你误以为是检索不准。诊断多模态失效的关键,就是学会识别这种"沉默的丢失",而不是被表面上"有文本返回"迷惑。
二、根因机制:信息是在哪一步、为什么被丢掉的
诊断出五类失效之后,得往下追一层:为什么纯文本管线会系统性地丢掉这些信息?这不是某个库的 bug,而是整条管线的设计假设决定的。
纯文本 RAG 的入库管线可以抽象成一条流水线,每一个环节都携带着一个隐含假设。信息的丢失,就发生在这些假设不成立的地方。
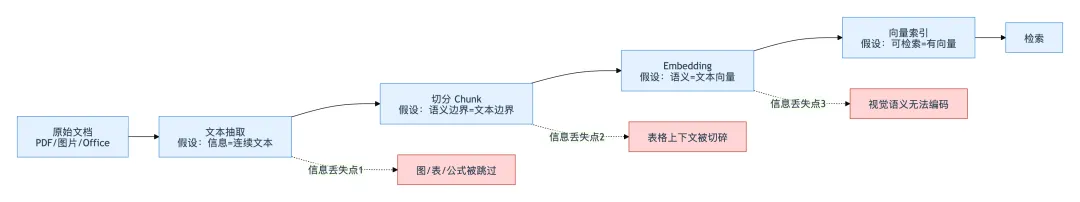
四个假设里,最致命的是第一个——"文档里的信息等于连续的文本"。这个假设在纯文字文档(比如一篇博客、一份说明书正文)上成立,所以纯文本 RAG 在这类语料上表现良好,很多人由此建立了"RAG 就该这么做"的直觉。但企业文档不是博客。当你把这个假设套到一份财报上,管线的第一步就把所有非文本信息判了死刑,后面三个环节再精巧也是在残缺的输入上做优化。
这里值得追问一个工程上的"为什么":既然文本抽取会丢信息,为什么这条管线还是成了行业默认做法?答案是历史路径依赖。早期 RAG 的验证场景(客服 FAQ、文档问答)确实以纯文本为主,文本抽取 → 切分 → Embedding 这条链路简单、便宜、成熟,工具链完备。它的失效在纯文本场景里看不出来,直到大家把它推广到真实企业文档,盲区才暴露。这就是典型的"在简单场景验证的假设,被无意识地带到了复杂场景"。
信息丢失点之间还存在传递放大关系,不是孤立的。用一条因果链把它串起来:
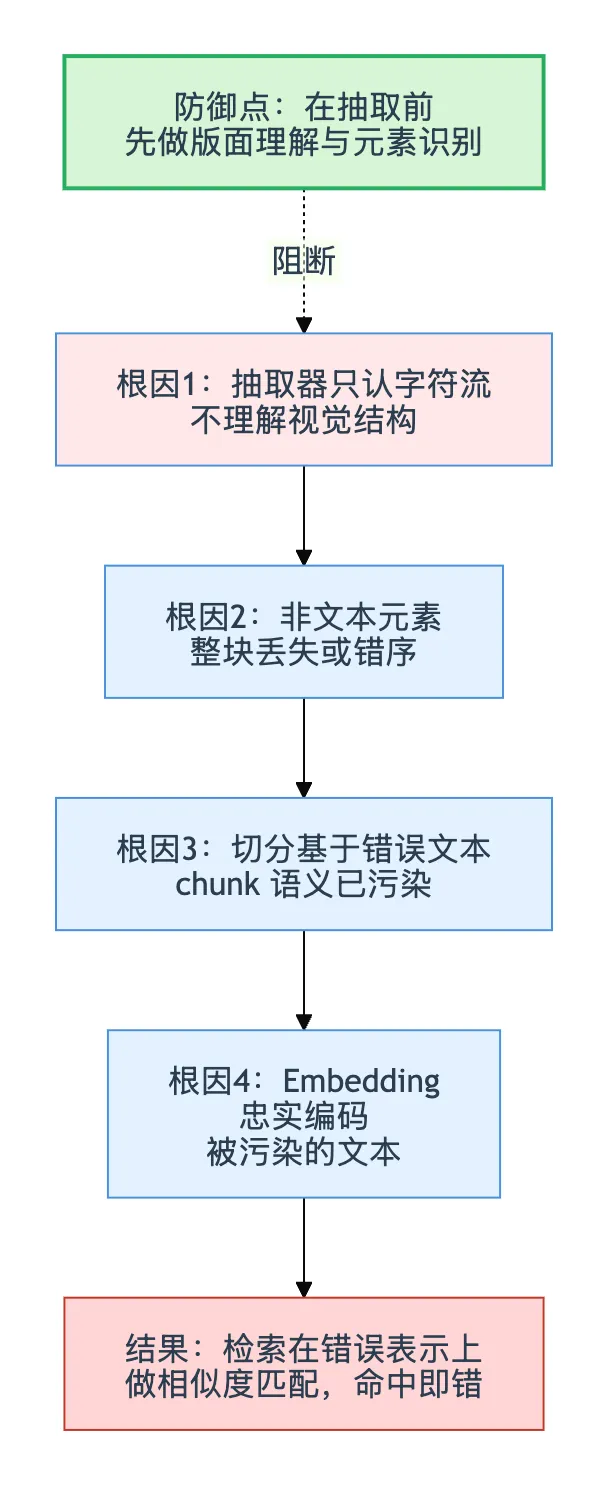
这条链条揭示一个重要判断:在错误的表示上做检索优化,是在放大错误而不是修正它。Embedding 模型是忠实的——你喂给它一段行列错位的表格文本,它会一丝不苟地把这段错序文本编码成向量。向量质量越高,越精确地表示了那段"错误的内容"。这解释了为什么很多团队"换了更强的 Embedding 模型,指标反而没变":模型没问题,问题在它编码的输入本身就是坏的。
因果链上的绿色节点标出了唯一有效的阻断点——在文本抽取之前,先做版面理解与元素识别。也就是说,不能把文档当成"一段待抽取的文本",而要先当成"一个待理解的版面":这里有几个文本块、几张表、几张图,它们的阅读顺序和归属关系是什么。只有先建立这个结构认知,后面的抽取才有意义。这正是多模态知识理解要解决的核心问题,也是它和纯文本管线的分水岭。
换个角度看这个分水岭:纯文本管线是"先读字、后拼意",多模态理解是"先看结构、再读内容"。前者默认文档是一维的字符序列,后者承认文档是二维的版面。这个维度差异是根本性的——一维视角下,一张跨两栏的表格就是一串位置相邻的字符,没法不错序;二维视角下,系统先知道"这里有一张占据页面右半部分的表格",再去读它的内容,行列关系自然保留。所有五类失效,追到底都是"用一维视角处理二维版面"造成的。把处理维度从一维升到二维,是多模态理解在方法论上真正的跃迁,不是简单的"多支持了几种文件格式"。
这个判断也解释了为什么"给纯文本 RAG 打补丁"这条路走不通。有的团队试图不改架构,靠在文本抽取后加一堆规则(识别表格关键词、正则修复错序)来救,结果规则越堆越多、覆盖不全、维护成本爆炸。因为问题的根在维度——你用一维的输出打多少补丁,都补不回二维结构里的信息。唯一的解法是把版面理解提前到抽取之前,让系统从一开始就在二维视角下工作。这是架构级的改变,不是打补丁能替代的。
再看一个能量化说明丢失严重性的例子。假设一份财报页面有一张核心表格,用两种方式处理:
# 方式一:纯文本抽取(丢失行列关系)raw = "地区 Q1 Q2 Q3 华东 320 350 410 华南 280 300 290"# 检索 "华东 Q3 销售额",向量匹配到这段文本,但 LLM 无法可靠对齐# "410" 到底属于华东 Q3 还是华南 Q1?连人读这段乱序都费劲# 方式二:结构化理解后的表示(保留行列语义)structured = {"table_title": "2023 各区域季度销售额(万元)","rows": [ {"region": "华东", "Q1": 320, "Q2": 350, "Q3": 410}, # 行列关系明确 {"region": "华南", "Q1": 280, "Q2": 300, "Q3": 290}, ]}# 检索时可以精确定位 region=华东 且 quarter=Q3 → 410,答案可验证同样一张表,方式一让 LLM 在乱序字符里猜对应关系(大概率猜错且无法验证),方式二让答案变成一次确定的字段查找。差异不在检索算法,而在信息以什么结构进入系统。这就是为什么多模态知识系统必须把"理解"独立成一层,而不是塞进抽取的一行代码里。
这里还藏着一个更深的机制问题值得追问:为什么"错误的表示"在检索阶段几乎无法被发现?根源在于向量检索的相似度匹配是"内容无关"的——它只比较向量之间的几何距离,不判断内容对不对。一段行列错位的表格文本,只要包含查询里的关键词,就会被编码成一个和查询向量距离较近的向量,从而被召回。检索系统没有任何机制去质疑"这段文本本身是不是坏的"。可以用一段代码把这个盲区显式化:
import numpy as npdefcosine(a, b):return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))# 假设 embed() 是任意 Embedding 模型query = embed("华东 Q3 毛利率")# 正确结构化的表述good = embed("华东地区 2023 年 Q3 毛利率为 35%")# 被拉平的错序文本(行列错位,人读都费劲)bad = embed("地区 Q1 Q2 Q3 华东 32% 35% 华南 毛利率")print(cosine(query, good)) # 例如 0.82print(cosine(query, bad)) # 例如 0.79 —— 差距很小,照样会被召回# ── AI 视角 ──# "两个候选相似度都很高,检索工作得很好,把它们都召回了"# ── 实际含义 ──# bad 的相似度只比 good 低一点点,因为它包含了同样的关键词。# 检索层无法判断 bad 是一段行列错位、语义已损坏的文本。# 相似度衡量的是"词面接近度",不是"内容正确性"。坏内容照样能拿高分。这段代码点破了一个反直觉的事实:检索质量指标(相似度分数)和内容正确性是两个正交的维度。你可以有一个相似度很高、但内容完全错误的召回结果。这也解释了为什么在错误表示上做的所有检索优化都是徒劳——你在优化一个"词面接近度",而问题出在"内容正确性"上,两者根本不在一个维度。要修复它,必须回到入库阶段,保证进入系统的内容本身是结构正确的。
三、策略对比:三条应对路线,各自的适用条件与代价
明确了根因在"信息以什么结构入库",接下来要选路线。面对纯文本管线的盲区,工程上有三条主流应对策略,它们在因果链上的阻断位置不同,成本和效果也差得很远。
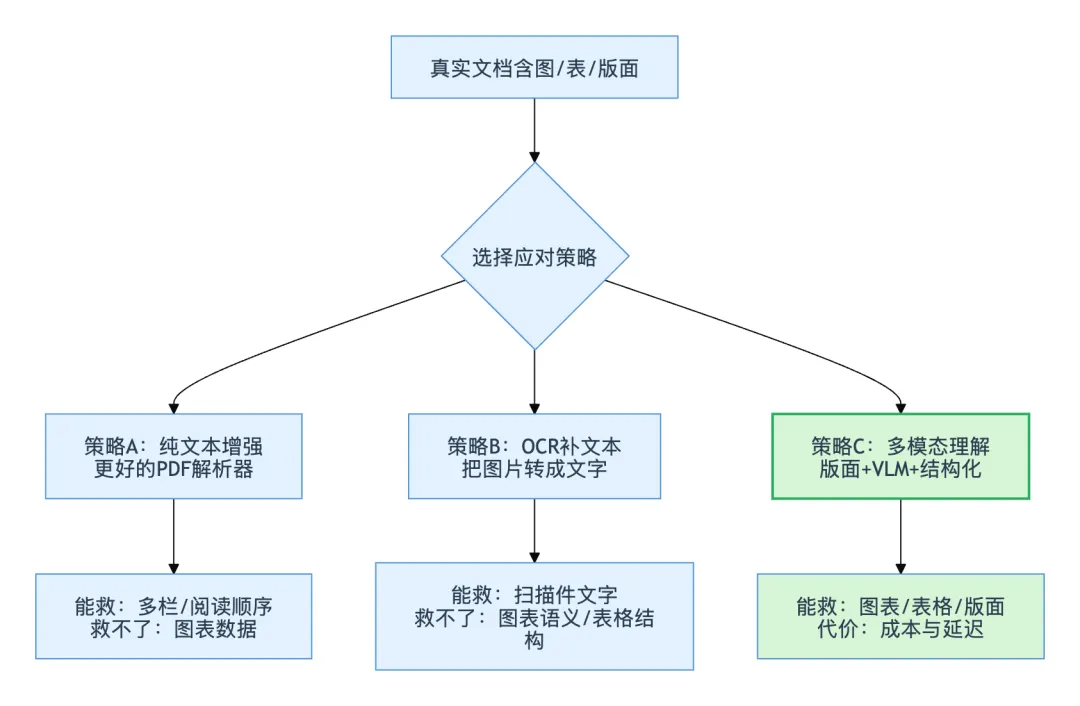
三条策略不是"哪个更先进"的排序,而是在不同因果链节点上的阻断,覆盖范围和代价各不相同。用一张表把本质差异摆清楚:
从表里能看出一个关键判断:这三条策略不是互斥的,而是分层递进的。一个成熟系统通常同时用到三者——用策略 A 恢复版面阅读顺序,对扫描件用策略 B 补出文字层,对图表和复杂表格用策略 C 做深度理解。真正的工程决策不是"选哪一条",而是"对哪类文档、哪类元素用哪条"。
值得澄清一个常见的认知偏差:很多人以为策略 B(OCR)能解决图表问题,毕竟 OCR 也是"从图片里读东西"。但 OCR 读的是"字符",图表的价值在"数据关系和趋势"。OCR 面对一张折线图,最多读出坐标轴刻度、图例文字和标题,读不出"这条线从 Q1 到 Q3 上升了 30%"这个真正被问到的信息。趋势藏在线条的几何形态里,不是字符。这就是为什么图表理解必须用策略 C(VLM 能理解视觉语义),OCR 顶多算个半吊子。把这层区分想清楚,能避免"上了 OCR 以为万事大吉,结果图表查询照样失败"的返工。
同样,策略 A 的"更强解析器"也有明确天花板。再强的 PDF 解析器,本质还是在字符流层面工作——它能把多栏文本的阅读顺序恢复对,能把表格的行列尽量对齐,但它无法凭空造出图表里根本不存在于文本层的数据。解析器再好,也只能把"已经是文本的东西"处理得更好,处理不了"从来就不是文本的东西"。理解这个天花板,才不会在"换个更好的解析库"上反复试错,而是及时判断出"这类文档必须上策略 C"。
那为什么不干脆全上策略 C,对所有文档都用 VLM 做深度理解?因为代价不对称。策略 C 的单文档成本可能是策略 A 的几十倍(VLM 调用 + GPU 推理),延迟从毫秒级涨到秒级甚至十秒级。对一份纯文字的会议纪要用 VLM 逐页理解,是纯粹的浪费。这里的工程原则是:理解的深度要匹配信息的密度。信息密度低的文档(纯文字),策略 A 足够;信息密度高、非文本占比大的文档(财报、图纸),才值得付策略 C 的成本。
用一段路由逻辑把这个原则落地——入库时先做一次轻量判断,决定每一页走哪条策略:
defroute_page_strategy(page_features: dict) -> str:"""根据页面特征路由处理策略,避免对简单页面过度处理"""# 特征由轻量版面分析给出:文本覆盖率、表格数、图表数、是否含文本层 text_ratio = page_features["text_coverage"] # 文本占版面比例 has_text_layer = page_features["has_text_layer"] # 是否为可选中文本 n_charts = page_features["chart_count"] n_tables = page_features["table_count"]ifnot has_text_layer:return"ocr"# 扫描件:先 OCR 补文字层(策略B)if n_charts > 0or n_tables > 0:return"multimodal_understand"# 含图表:走 VLM 深度理解(策略C)if text_ratio > 0.8:return"text_enhance"# 纯文字页:轻量解析即可(策略A)return"multimodal_understand"# 复杂版面:保守走理解路线# 这段路由的收益:让 80% 的简单页走廉价路径,把昂贵的 VLM 预算# 集中在真正需要的 20% 页面上,整体成本和延迟都可控。分层路由到底能省多少,用一个粗略的成本模型算一笔账就清楚了。假设一批文档共 10 万页,其中 20% 含图表需要 VLM 理解,其余 80% 是纯文字或简单版面:
defestimate_ingest_cost(total_pages, vlm_ratio, vlm_cost_per_page=0.03, text_cost_per_page=0.0002):"""对比'全量VLM'与'分层路由'两种入库策略的成本"""# 全量 VLM:每页都过 VLM all_vlm = total_pages * vlm_cost_per_page# 分层路由:只有 vlm_ratio 比例的页走 VLM,其余走廉价文本路径 routed = (total_pages * vlm_ratio * vlm_cost_per_page + total_pages * (1 - vlm_ratio) * text_cost_per_page)return all_vlm, routedall_vlm, routed = estimate_ingest_cost(100_000, 0.2)print(f"全量VLM: ${all_vlm:.0f}") # $3000print(f"分层路由: ${routed:.0f}") # 约 $616print(f"节省: {(1-routed/all_vlm)*100:.0f}%") # 约 79%数字会随单价浮动,但结论是稳定的:分层路由把入库成本降到全量 VLM 的约五分之一,而覆盖度几乎不损失(因为省掉的都是本来就不含图表的页面)。这就是"理解深度匹配信息密度"这条原则的直接经济价值。它也说明一个判断——多模态系统贵不贵,很大程度上不取决于用哪个 VLM,而取决于有没有把 VLM 用在刀刃上。同样一个 VLM,无脑全量跑和精准路由跑,成本差一个数量级。
这段路由代码本身不复杂,但它体现的思路是多模态系统能落地的前提:不做一刀切的深度理解,而是按需分配理解成本。如果没有这一层路由,要么成本失控(全走策略 C),要么信息丢失(全走策略 A)。它也回答了一个常见质疑——"多模态理解太贵,落不了地":贵是因为没做分层,做了分层之后,昂贵的部分只作用在少数高价值页面上。
路由本身也有代价和边界,不能把它当成免费的银弹。它依赖一次轻量版面分析来产出 page_features,这次分析本身要花时间(虽然远比 VLM 便宜),而且它的判断可能出错——把一页含关键小图表的页面误判成"纯文字",信息照样丢。工程上通常给路由留一个"保守偏置":拿不准的页面宁可多花点钱走理解路线,也不轻易判成简单页。因为漏理解的代价(信息永久丢失、事后无法补救)远大于过度理解的代价(多花一点 VLM 预算)。这是一个典型的非对称风险决策——两类错误的后果不对等时,就该往后果轻的那一侧偏。
还有一个容易被忽略的落地问题:路由策略需要能随时调整和回灌。今天判定"纯文字页走策略 A",明天发现某类文档的"纯文字页"其实常带小图标数据,就得能快速把这类文档的路由规则改掉并重新入库。所以路由规则最好是配置化、可按文档类型覆盖的,而不是写死在代码里。这一点在第 7 篇讲生产落地时会再展开。
四、系统性方案:多模态知识系统的四层架构
策略确定后,要把它组织成一个可运行的系统。多模态知识系统的骨架是四层:理解层、表示层、检索层、生成层。这四层的划分不是随意的,而是对应了信息从"原始文档"到"可信答案"必须经过的四次形态转换。
为什么是四层,不是三层或五层?关键在于每一层都对应一次"表示形态的质变",层与层之间的接口是稳定的、可替换的。理解层把"版面像素"变成"结构化元素",表示层把"结构化元素"变成"向量与索引",检索层把"查询+索引"变成"候选证据",生成层把"证据"变成"答案"。这四次转换里,每一次的输入输出形态都完全不同,强行合并任意两层都会让接口变脏、耦合变强。比如把理解层和表示层合并,就会出现"解析逻辑和编码逻辑纠缠在一起,换个 Embedding 模型要动解析代码"的糟糕局面。分成四层,恰好让每一层内部高内聚、层间低耦合,这是它相对其他划分方式的核心优势。
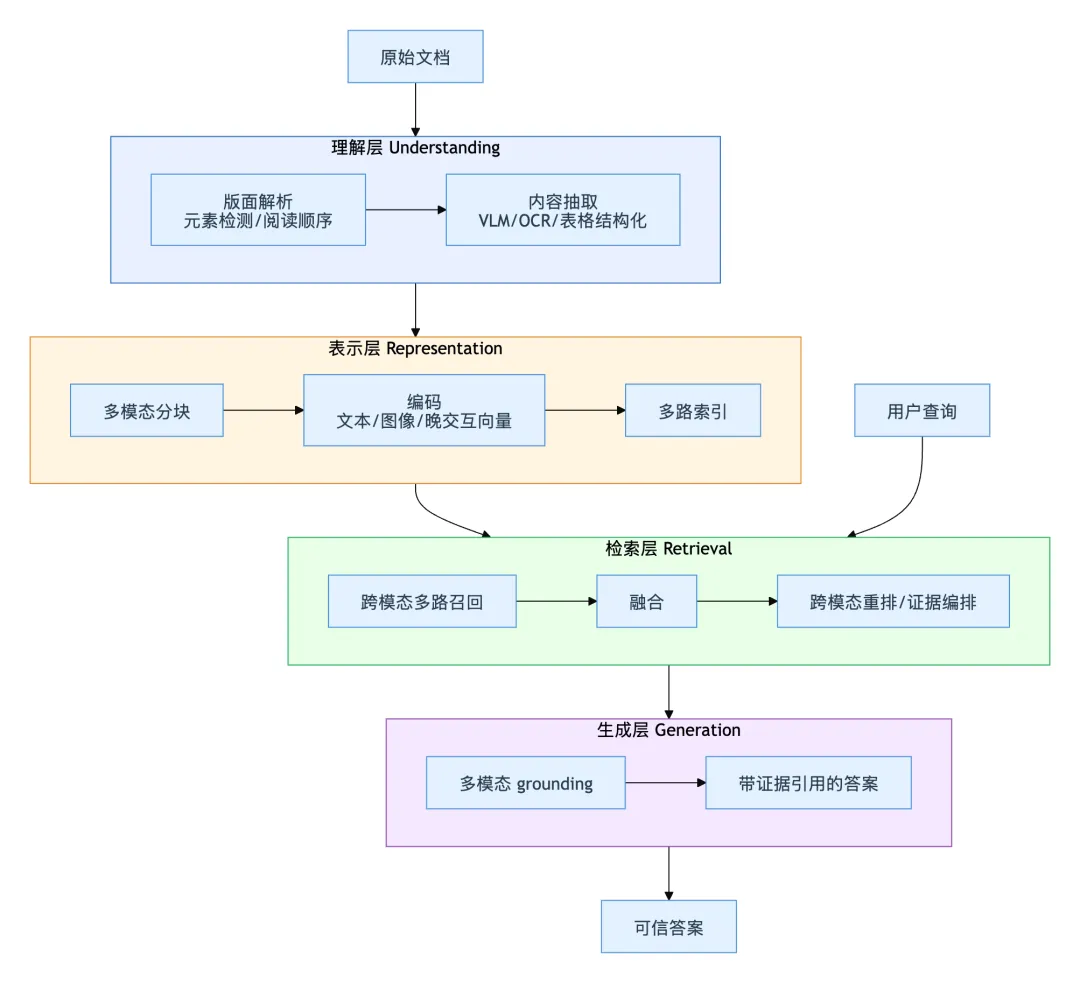
每一层解决一个特定的形态转换问题,本系列后续 6 篇文章正是沿着这四层逐层深入。这里先把每层的职责、为什么必须独立成层、以及它相对纯文本管线的增量讲清楚。
理解层:把"版面"变成"结构化元素与语义"。 这是纯文本管线完全缺失的一层,也是整个系统价值的地基。它先做版面解析(检测出文本块、表格、图、公式,恢复阅读顺序),再做内容抽取(用 VLM 把图表反解成数据、把表格结构化、对扫描件做 OCR)。它独立成层的理由在第二节已经论证过:信息丢失的根因在抽取前缺少结构认知,必须有一层专门负责"先看懂文档长什么样"。这一层对应本系列第 2 篇(版面解析)和第 3 篇(VLM 内容理解)。
表示层:把"结构化元素"变成"可检索的向量与索引"。 理解层产出的是文本、表格、图像描述、结构化数据的混合物,表示层要决定它们怎么编码、怎么存。这里有一个关键设计选择——是把所有模态映射到统一向量空间(用 CLIP 这类图文对齐模型),还是各模态分别建索引再关联。还有一条 2024 年出现的新路线 ColPali,直接对文档截图做 patch 级晚交互检索,跳过前面的解析抽取。这些选择各有代价,是本系列第 4 篇的主题。
表示层还有一个纯文本 RAG 里不存在的分块难题。纯文本切分只需要考虑"文本语义边界在哪",多模态分块却要处理"图文绑定"——一张图和它的图注、一张表和它上方那句解释性文字,在语义上是一个整体,切分时不能把它们拆散。如果把图注切到一个 chunk、把图切到另一个 chunk,检索时召回了图注却丢了图,或者召回了图却不知道它在说什么,两边都残缺。所以多模态分块要以"理解层识别出的元素"为单位,把强相关的元素捆在一起,而不是机械地按字数切。这个看似细节的设计,直接影响检索时证据的完整性。
检索层:把"查询"和"多模态索引"匹配起来。 这一层要处理跨模态检索的核心难题——用户用文本提问,答案可能在图表里,如何让文本查询命中图像内容。它包括多路召回(文本稠密路、稀疏路、图像路、表格路、晚交互路并行)、融合(把不同模态、不同打分口径的候选合并)、重排与证据编排(选出最相关的证据并绑定出处)。这是本系列第 5、6 篇的内容,也是和已有纯文本混合检索方案的正交扩展点。
检索层最棘手的地方在于"模态失配"和"分数不可比"这两个问题叠加。模态失配是指查询和答案不在同一模态——用户打字问问题,答案可能是一张图;反过来也有以图搜文的场景。要让文本查询召回图像,要么依赖统一向量空间(把文本和图像编码到同一空间,可以直接算距离),要么依赖理解层把图像转成了文本描述(退回到文本检索)。这两条路各有取舍,是第 4、5 篇要展开的核心。分数不可比则是指:BM25 的分数、稠密向量的余弦相似度、晚交互的 MaxSim 分数,量纲和分布完全不同,直接比大小没有意义,必须先归一化或用 RRF 这类基于排名的融合方法。把这些细节讲清楚,是检索层能不能真正跨模态工作的关键。
生成层:把"证据"变成"可信答案"。 多模态生成不只是把文本拼进 Prompt,而是要把检索到的图、表、截图连同文本一起送进 VLM,让模型基于视觉证据回答,并给出可视化的引用(比如高亮原图里的数据点)。它还要控制幻觉、管理送入 VLM 的上下文成本。这是本系列第 7 篇的主题。
生成层有一个纯文本 RAG 不会遇到的新矛盾:视觉证据的 token 成本极高。一张图送进 VLM 可能等价于几百上千个 token,而检索层召回的候选里可能有好几张图。如果不加控制地全塞进去,一次问答的成本和延迟都会失控。所以生成层必须和检索层的证据编排配合——只把最关键的少量视觉证据送进 VLM,其余用理解层已经生成的文本描述代替。这又回到了那个贯穿全系列的主线:什么时候用重量级的视觉理解,什么时候用轻量级的文本代理,取决于这条信息值不值得那个成本。
把这四层放到一次真实查询里看,数据流是这样的:
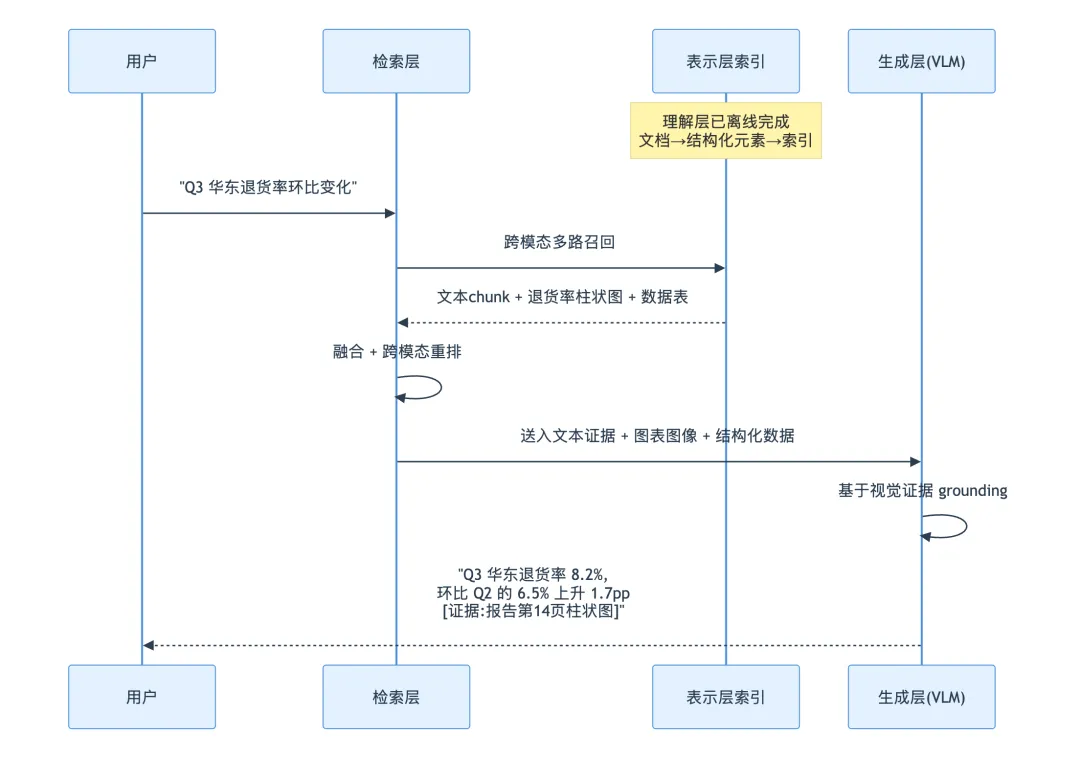
对比第一节开头那个"未找到"的翻车场景,差异一目了然:理解层在离线阶段就把第 14 页的柱状图反解成了数据并入了索引,所以检索层能召回它,生成层能基于它作答,还能给出可视化出处。同一个查询,在四层架构下从"信息不存在"变成了"有据可查"。
这里要强调理解层的离线特性,这是一个重要的工程权衡。理解层最贵(VLM 调用密集),但它可以在文档入库时一次性完成,结果沉淀进索引,之后所有查询共享这份理解成果。也就是说,把昂贵的理解成本从"每次查询"转移到"一次入库"。这是多模态系统成本可控的关键:查询时不再实时调 VLM 解析文档,只在必要时(生成阶段)用 VLM 基于已召回的证据作答。这个"离线重、在线轻"的划分,直接决定了系统能不能扛住线上 QPS。
四层之间的接口设计,是这套架构能不能各层独立演进的关键。理解层交给表示层的,不应该是"一堆文本",而是一组带类型、带出处、带结构的元素——每个元素标明它是文本块、表格还是图表,来自哪一页的什么位置,如果是表格还要带上结构化后的行列数据。这样表示层才能针对不同类型做不同编码(文本走文本 Embedding,图表走图像编码或结构化字段索引)。同理,检索层交给生成层的不是纯文本,而是一组带模态标记和出处的证据,生成层才知道哪些要作为图像送进 VLM、哪些引用要标注到原图坐标。可以用一个统一的元素结构把这个接口固化下来:
from dataclasses import dataclassfrom typing importOptional@dataclassclassDocElement:"""理解层输出、贯穿四层的统一元素结构""" elem_type: str# "text" | "table" | "chart" | "figure" | "formula" doc_id: str page: int bbox: tuple# (x0, y0, x1, y1) 元素在页面上的坐标,用于可视化引用 text: Optional[str] # 文本内容或 VLM 生成的描述 structured: Optional[dict] # 表格/图表反解出的结构化数据 image_ref: Optional[str] # 若为图/表,指向裁剪出的图像文件# 关键:bbox 和 doc_id/page 让答案能精确回指到原文档的具体位置,# 这是"可信答案"(带可视化出处)能实现的前提。# 有了统一结构,各层只依赖这个契约,理解层换 VLM、检索层换融合算法,# 都不会波及其他层。这是分层架构真正的收益——可独立替换和演进。这个 DocElement 结构看似只是个数据类,但它承载了一个重要设计决策:用元素级的、带坐标和出处的表示贯穿全链路,而不是在层与层之间传递裸文本。裸文本一旦跨层,类型、出处、结构就都丢了,后面想做可视化引用、想按类型分模态检索都无从下手。这也是纯文本管线的另一处硬伤——它从头到尾只有"文本"这一种数据形态,无法表达"这段内容来自第 14 页那张柱状图"。多模态架构靠这个结构,把出处和模态信息一路带到生成层,才能实现"答案标注可视化证据"这种纯文本 RAG 做不到的能力。
最后把四层架构和大家熟悉的通用 RAG 五层架构做个对照,看清增量在哪:
从这张对照表能看出,多模态四层不是推翻通用 RAG,而是在每一层做了"从文本到多模态"的能力升级。通用 RAG 的方法论(切分、Embedding、召回、重排)依然适用,只是每一层都要处理更丰富的模态。这也解释了为什么本系列不重复讲通用 RAG 基础——那是地基,本系列讲的是地基之上专门为多模态加盖的部分。
全局总结:一张图看懂从失效到架构的推理链
回到最初那个"Q3 退货率藏在柱状图里"的翻车场景,整篇文章其实是一条完整的推理链:从现象到根因,再到策略和架构。
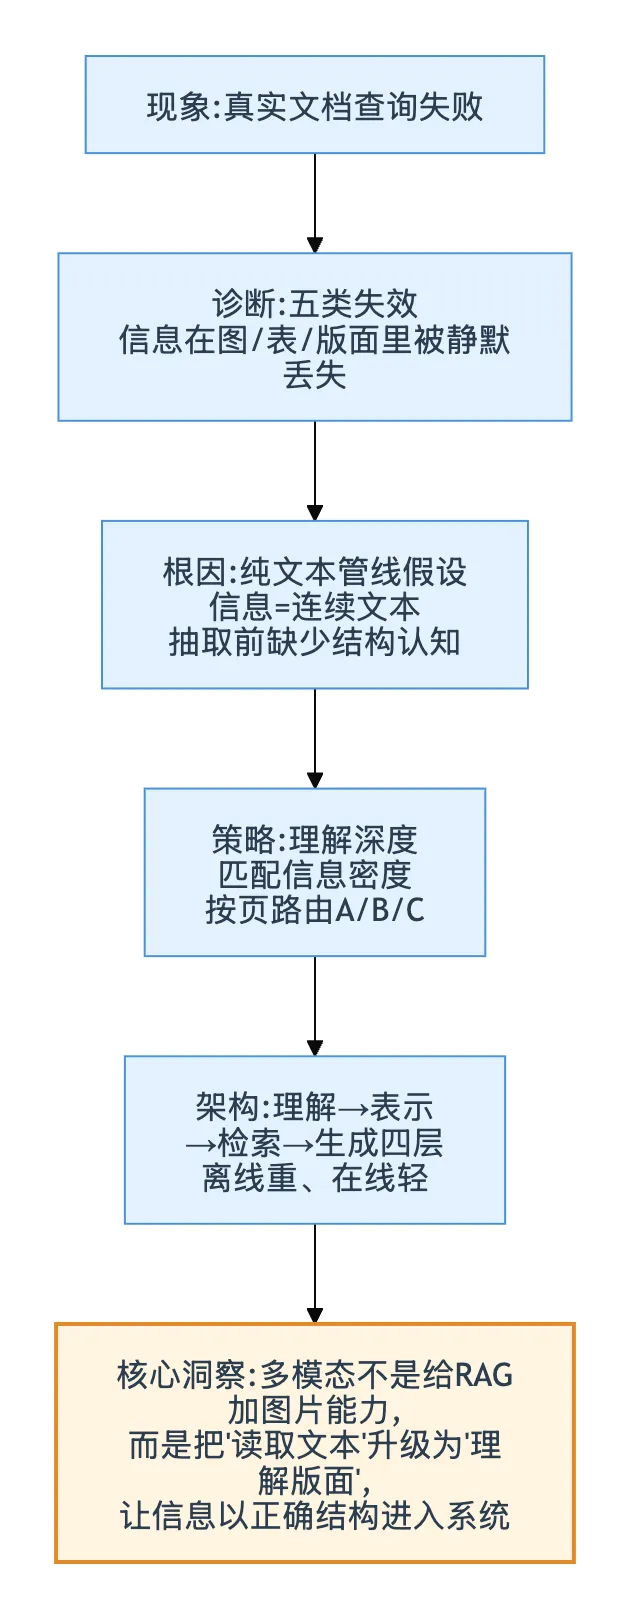
如果要用一句话概括整个主题的底层逻辑:多模态知识理解要解决的根本问题,不是"检索得准不准",而是"信息有没有以正确的结构进入系统"。 检索、重排、生成都是在已入库信息上的优化,而多模态理解决定了系统的信息边界本身。边界之外的信息,再强的检索也够不着。这个判断听起来简单,但它会改变你排查问题和分配资源的整个方式——遇到查不准,先问"信息进来了吗、进来时结构对吗",而不是条件反射地去调检索参数。把这个顺序刻进团队的排查习惯里,比记住任何一个具体技术都更能提升系统的实际效果。
后续六篇会沿着四层架构逐层展开:第 2、3 篇拆解理解层的解析与 VLM 抽取,第 4 篇讲表示层的编码与索引选型,第 5、6 篇讲检索层的跨模态召回与重排,第 7 篇讲生成层与生产落地。每一篇都会回到"信息以什么结构存在、以什么结构被检索、以什么结构被使用"这条主线上。
在动手读后续篇章前,有一个心智模型值得先建立起来:把整个多模态知识系统想象成一条"信息保真"的流水线。原始文档里的信息保真度是 100%,每经过一层就可能损失一部分。纯文本管线在第一层(抽取)就把保真度砍到 50% 以下,后面再怎么优化,天花板也就是那 50%。多模态四层架构的每一层设计,本质都是在回答同一个问题——"怎么让信息在这一层的损失最小"。理解层保住非文本信息,表示层保住模态和结构,检索层保住跨模态的可达性,生成层保住证据和出处。读后续每一篇时,都可以用"这一层在防止什么信息损失"这个视角去看,会比记住一堆技术名词更有用。
也正因为如此,评价一个多模态系统好不好,最终不该只看某个环节的技术是否新潮,而要看端到端的信息保真度——用户能问到的信息,占文档里真正存在的信息的比例有多高。这个比例,才是纯文本 RAG 和多模态知识系统真正的差距所在,也是本系列所有技术选择的终极评判标准。
边界与演进
工程判断
四层架构的核心假设是:文档里的非文本信息值得被理解的成本。这个假设不总是成立。如果你的知识库全是纯文字的规章制度、代码文档、纯文本 FAQ,那么理解层的版面分析和 VLM 抽取就是纯开销,通用 RAG 足够。多模态架构的价值和文档的"视觉信息密度"正相关——财报、图纸、扫描合同、带截图的运维手册收益最大,纯文字语料收益接近零。
落地中最容易被低估的不是技术最复杂的 VLM 抽取,而是看起来最简单的版面路由(第三节那段 route_page_strategy)。团队往往一上来就纠结用哪个 VLM,却忽略了如果路由不准,要么把简单页送去做昂贵理解(成本爆炸),要么把复杂页判成简单页(信息又丢了)。路由的准确率直接决定整个系统的成本效益比,值得投入精力做好它。
另一个被低估的点是理解层结果的可维护性。理解层是离线跑的、结果沉淀进索引,这带来一个隐性负担——当你换了更强的 VLM,或者修复了某类文档的解析 bug,历史文档的理解结果不会自动更新,必须重新入库。对一个几十万页的知识库,全量重新理解一次成本不小。所以从第一天起就要把"理解版本"记进每个元素(比如 DocElement 加一个 understand_version 字段),这样才能做到只重跑受影响的文档,而不是每次都全量重来。这个在早期几乎无感、到了规模化阶段却能救命的设计,是很多团队踩过坑才补上的。
替代方案对比
四层架构选择"离线理解 + 在线检索",本质是在成本、延迟和覆盖度之间取平衡:既不像全量 VLM 那样在线烧钱,也不像纯 OCR 那样丢信息,通过离线一次性理解把成本摊薄到入库阶段。这三条替代路径不是错的,而是各自适配不同规模——文档极少时全量 VLM 最省事,纯文字为主时 OCR 加通用 RAG 足够,只有当文档规模、视觉密度和查询频次三者同时上来,离线理解加在线检索的四层架构才显出它的综合优势。选型的本质,是判断你的场景落在这三者的哪个区间。
适用边界与局限性
这套架构最适合"文档量大、视觉信息密集、查询高频"的企业知识库场景——文档多所以离线理解成本能被大量查询摊薄,视觉信息密集所以理解层有价值,查询高频所以在线轻量的收益明显。如果是"文档少、查询少"的场景(比如个人偶尔查几份 PDF),直接用全量 VLM 端到端可能更划算,不必搭这套重管线。此外,理解层的质量强依赖版面分析和 VLM 的能力,对于极端复杂的版面(手绘图纸、密集嵌套表格),当前技术仍会有相当的错误率,需要配合人工校验和评估反馈闭环——这正是本系列第 7 篇要展开的内容。
最后留一个判断供落地时参考:要不要上多模态,别凭感觉,先做一次抽样测量。从你的知识库里随机抽 100 页,人工标注每页的关键信息里有多少是非文本的(表格、图表、扫描内容),再算纯文本管线能召回其中多少。如果非文本信息占比低于 10%,多模态的投入产出比不划算,把通用 RAG 调好就够;如果超过 30%,那纯文本管线正在系统性地损失价值,多模态改造的收益会非常明显。用数据而不是直觉来做这个决策,能避免既不该上时盲目上、也不该省时硬省的两种浪费。