ARTICLE · 1007430
DeepSeek开始说话,AI助手正在离开输入框
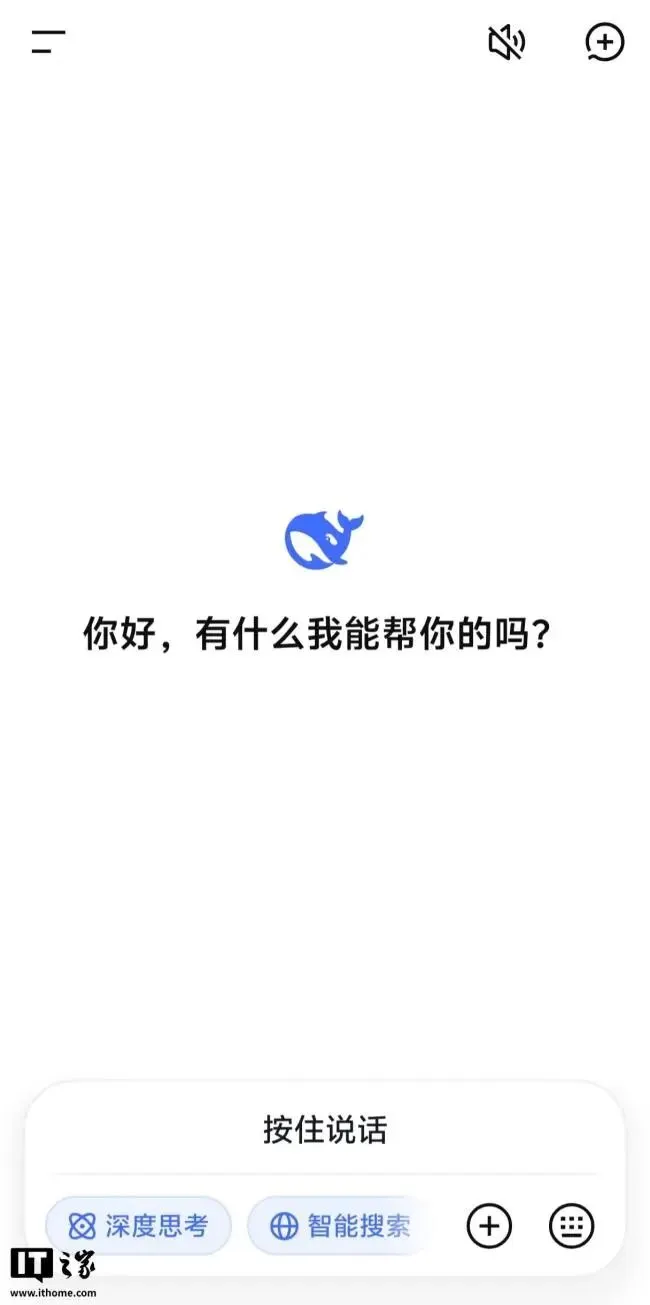
DeepSeek 语音入口
以前我们打开 AI,先要把问题“打成一句话”。
这件事看上去很小,却一直在筛选用户:会提问的人、能把脑子里一团想法整理成文字的人,才更容易把 AI 用起来。至于那些正在走路、开车、做饭、带娃,或者只是懒得把一件复杂事情拆成十行字的人,AI 常常停在一个看得见、却懒得打开的输入框里。
现在,这层门槛正在松动。
9 月 12 日,有参与灰度测试的用户发现,DeepSeek App 右上角出现了语音入口,并可在设置中选择四种朗读音色:贝壳、白浪、海星和暗潮。它仍处于小范围测试,能否覆盖更多用户、具体交互如何完善,都还要等待产品后续验证;但“让模型开口”这一步,已经足够说明一个方向:AI 助手正在从一个文字工具,变成随时可以接话的陪伴式界面。
输入框之外,才是更多人的真实生活
语音并不新鲜。手机上的语音输入、智能音箱的唤醒词、车里的助手,早就存在多年。
但大模型时代的语音,重点不在“把声音变成文字”,而在于它终于能接住一段没有被整理过的话。
你可以一边收拾桌面,一边说:“帮我把下午的会拆成三件事,第一件先找谁确认?”
你也可以在临出门时问:“把这段英文邮件读出来,顺便告诉我对方真正想让我做什么。”
文字交互要求我们先完成一次自我编辑;语音交互允许思路先流出来,再由 AI 帮忙整理。这是两种完全不同的使用姿势。
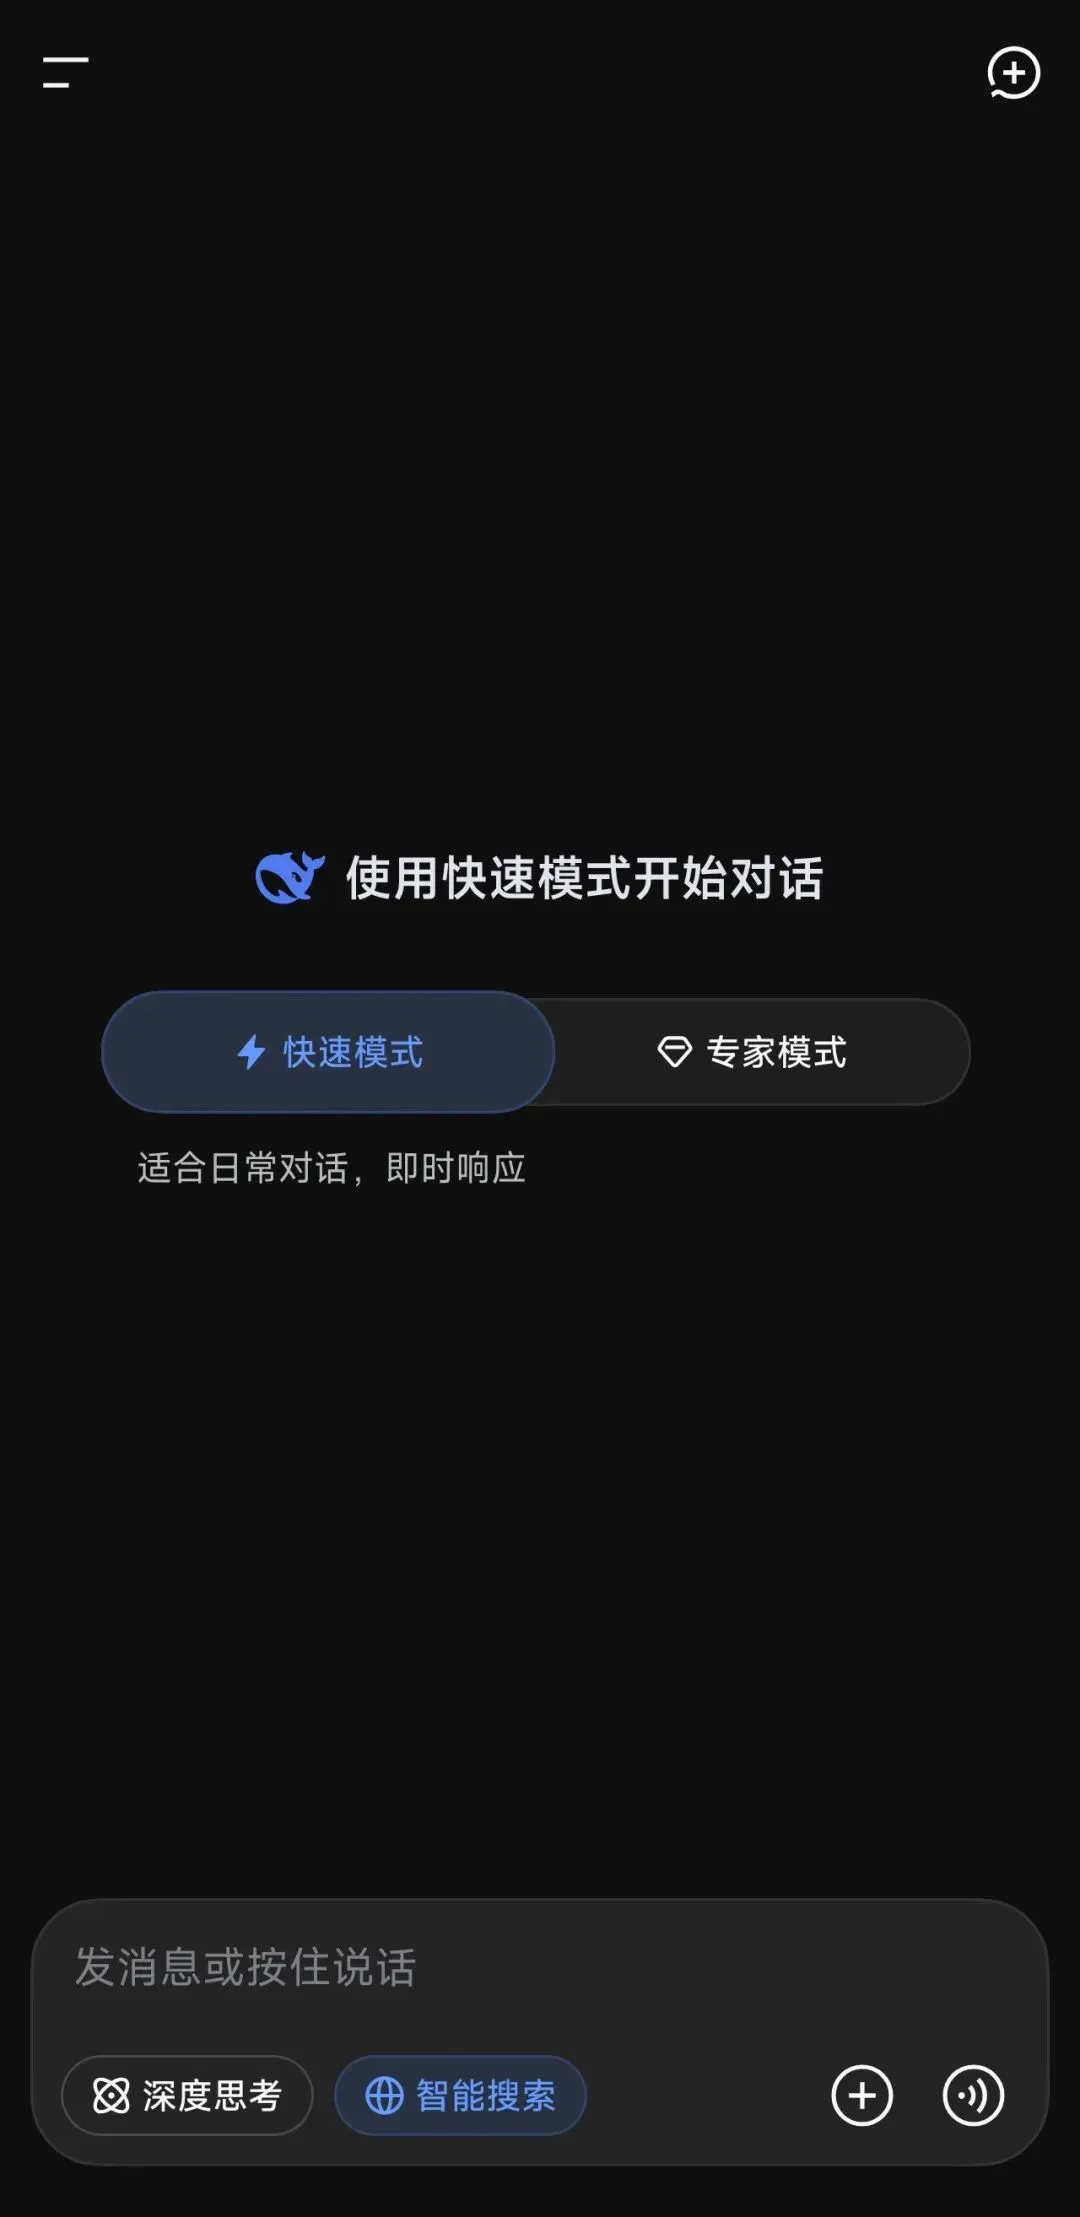
DeepSeek App 对话界面
如果说输入框里的 AI 像一张随叫随到的白纸,能说话的 AI 则更像一个随身的“思考缓冲区”。它未必每次都给出完美答案,却可以在想法还没成形时,先替你记住、追问、归纳。
这也是语音功能真正值得关注的地方:它把 AI 从“坐下来再用的工具”,往“生活中不断续上的能力”推了一步。
AI助手的三道门槛
把这次变化放大看,AI 助手正在跨过三道门槛。
第一道,是会不会用。
过去,用户得知道模型能做什么、提示词怎么写、深度思考和搜索该不该打开。对熟练用户来说,这些是效率;对更多人来说,却是额外的学习成本。
第二道,是愿不愿意开。
许多人的痛点不是“AI 不够强”,而是“这件小事值不值得我掏出手机、组织语言、敲一段字”。当交互从打字变成说一句话,启动成本会明显下降。
第三道,是能不能留下来。
一次性问答很容易被别的 App 替代。真正能留在日常里的助手,要能在不同场景里被自然唤起:通勤时、家务中、会议前、灵感冒出来的几秒钟。语音是进入这些碎片时刻的入口之一。
所以,别把这轮功能更新只理解成多了一个小喇叭。它实际在争夺的,是用户每天那些原本不会打开 AI 的时刻。
声音不只是“好听”
灰度测试中出现的四种音色,也很有意思。
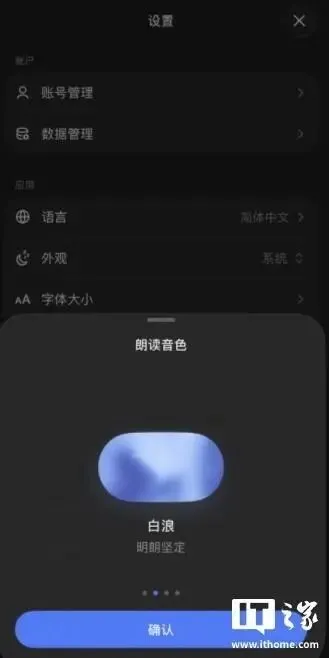
DeepSeek 的朗读音色设置
有人会把音色选择理解为一项轻量的个性化配置。但只要 AI 开始通过声音进入生活,声音就会影响人愿不愿意继续和它相处。
一段需要快速确认的工作内容,可能更适合清晰、稳定的声音;一段较长的解释,声音的节奏、停顿和亲和度会直接影响耐心;对有阅读障碍、视力不便,或正处于移动场景的用户而言,语音甚至不只是体验优化,而是更平等的入口。
当然,声音越自然,边界也越需要清楚。用户需要知道自己在和谁对话、哪些内容会被处理、误听或误答时怎样纠正。语音降低了表达门槛,也会放大隐私、误触和过度依赖的问题。好的产品不会只把声音做得像人,更要把控制权留给人。
接下来该看什么
一次灰度测试,还不足以判断一款语音助手的最终体验。比起急着比较音色,更值得盯住四件事:
能否自然打断与续说。 人说话会改口、补充、插话;如果交互仍像留言,语音就只是换了一种输入法。 能否听懂不完整表达。 真正高频的语音,不会都是标准问题,而是半句话、代词和临时上下文。 能否把“听到”变成“办成”。 语音之后若不能调用搜索、整理、提醒、文件与任务,体验仍会止步于聊天。 能否把隐私和权限讲明白。 麦克风、录音、数据留存与删除机制,决定了用户愿不愿意把它带进更多场景。
语音没有让模型突然更聪明。它只是让模型更接近人们原本说话、思考和行动的方式。
而产品竞争往往就发生在这里:不是谁的能力列表更长,而是谁先让用户在最不方便打字的时候,仍然愿意打开它。
DeepSeek开始说话,真正的考题才刚刚出现——当 AI 不再只等你输入,它能不能成为那个在你需要时,既听得懂也不越界的助手?