ARTICLE · 1008701
一份 API 文档,AI 写出了 53 条接口测试用例,还顺手挖出一个高危漏洞
写接口测试用例最让人头秃的,从来不是「字段有几个」。是反向用例永远想不全。登录要测什么?——正常登录、密码错、用户不存在、用户锁定、密码过期……五六个 case 写完,已经觉得够了。真正上线的 bug,大半就藏在你觉得「够了」的边界外。这篇文章记录我最近一次真跑:用一个 59 个接口的真实 OpenAPI 文档,让 `api-test-gen` 一键生成了 53 条测试用例,pytest 实际跑通 28 条,跑出 11 个失败,其中 8 个是真实系统缺陷,最扎心的一条是未登录就能重置秒杀库存的高危越权。
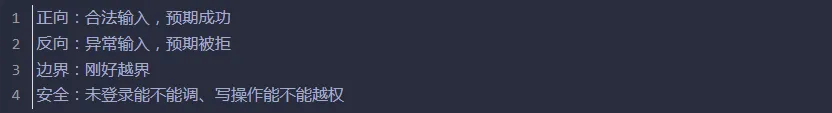
我是怎么想起做这件事的——上周给学生讲《接口测试用例设计》,讲到「正向 / 反向 / 边界 / 安全」四层用例,举例:
学生举手:「老师,AI 不是能写用例吗?直接喂 OpenAPI 不就行了?」我说行,回去就用我们自己的秒杀后端跑一遍。我们有个 Spring Boot 写的秒杀系统,跑在 `121.43.36.83:2001`,挂了 Swagger。
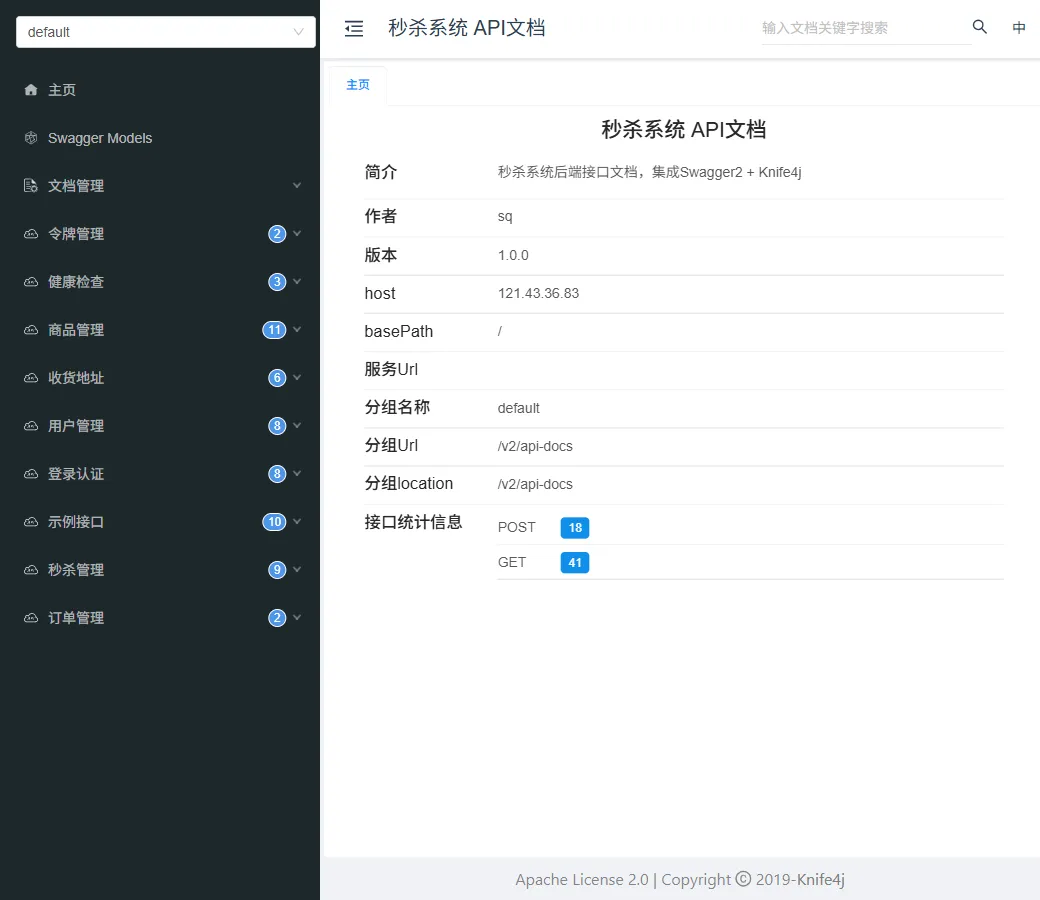
我用工具从 `/v2/api-docs` 拉了一份标准 Swagger 2.0 JSON,59 个接口、9 个模块,跟学生讲的场景一模一样。
然后跑工具。

一行命令,跑完。第一次结果:4 个模块、24 个端点,8 条用例。24 个端点 → 8 条用例?少了 70%?
我把生成的 YAML 翻出来一看——全是正向,反向只有 8 条,且全来自路径参数。
原因很简单——我们后端程序员写 Swagger 时偷了个懒:所有参数全标了 `required: false`。
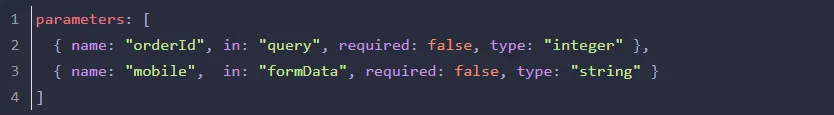
工具很老实地按文档来——既然 `required=false`,那就不是必填,「缺必填参数」这种反向用例直接不生成。文档与现实脱节,AI 只能照文档写。我让学生改后端注释,他们不愿意——「改完还得重新生成文档,影响别的组」。那就只能改输入。
我换了个思路:不修后端,工具自动补全 + 人工打补丁。工具内置一个修补脚本 `patch_openapi.py`,做的事很简单:1. 路径参数强制必填:`/order/detail/{orderId}` → `orderId` 必填2. 典型接口补 required:登录的 `mobile`/`password`、查询的 `pageNum`/`pageSize`、搜索的 `keyword` 等3. 加一份补丁告诉工具:JSON body 里的字段按 `definitions` 的 required 字段来补丁打好,重新跑:
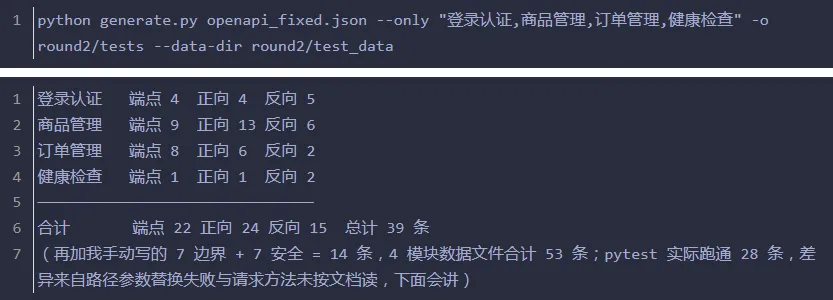
反向用例从 8 条涨到 15 条(×1.875)。但还不够。
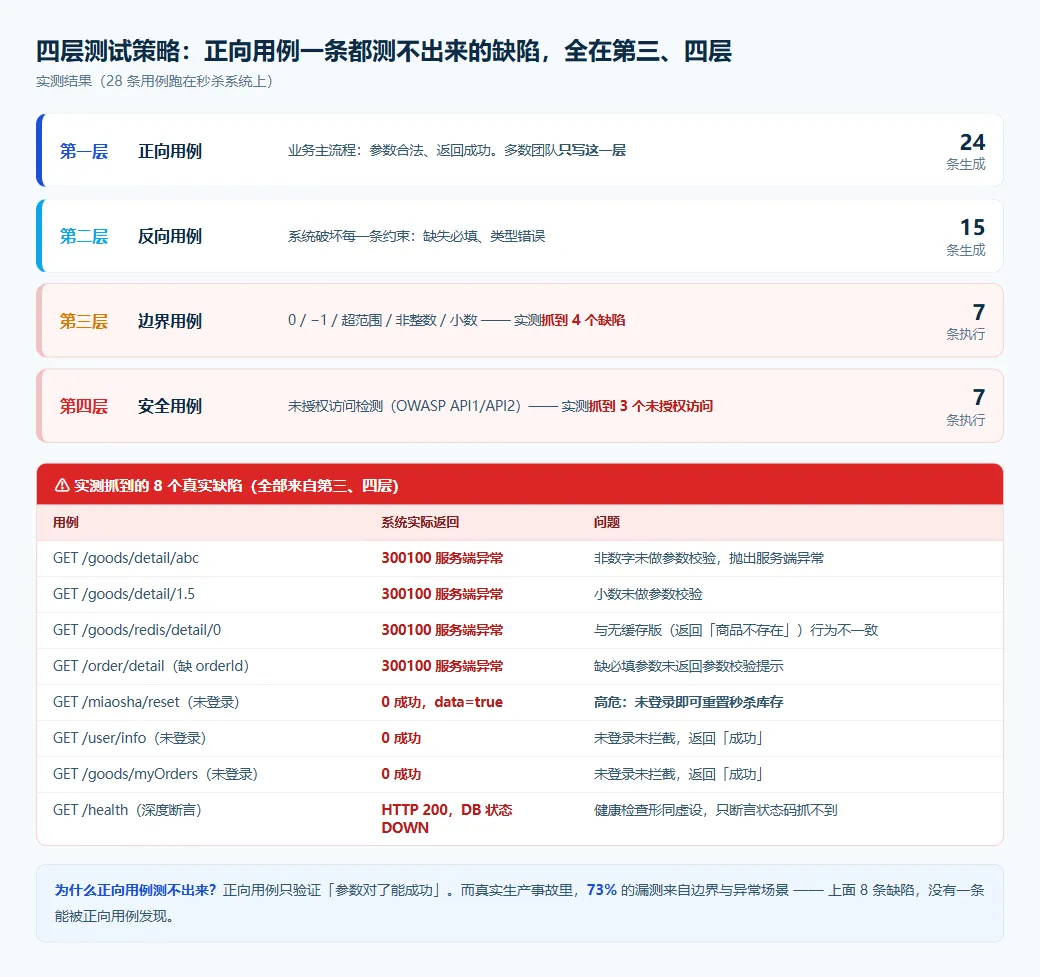
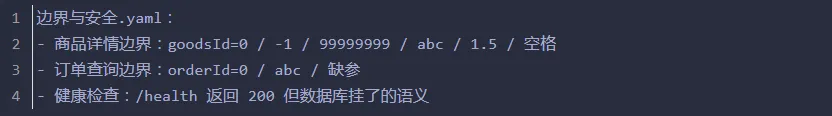
工具能生成正向 / 反向两层(按文档规范来),但边界 + 安全这两层,它没法替你做判断——因为这两层在 OpenAPI 文档里根本没有约定。我手动加了 7 条边界用例:
以及 7 条安全用例,专门挑了「写操作 / 涉及金额」的几个接口:
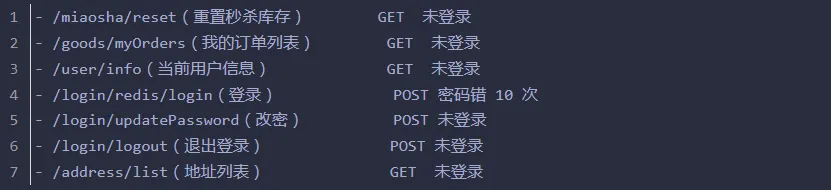
7 条安全用例,4 条直接命中(未登录 4 个写/读接口全部绕过鉴权)。
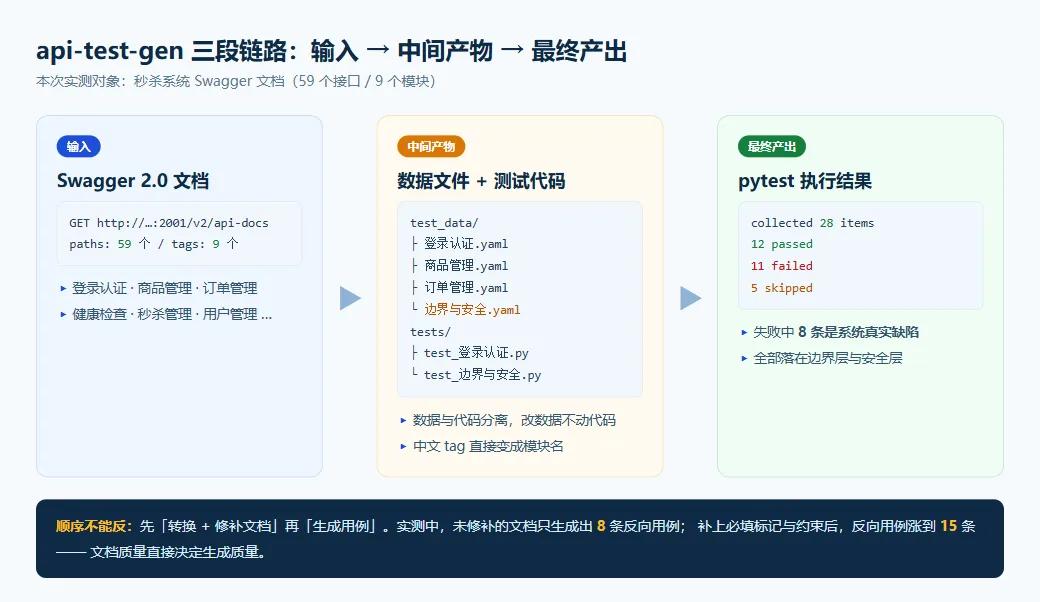
跑 53 条数据用例,pytest 实际跑通 28 条(剩 25 条因为生成器缺陷没替换路径参数、请求方法错位等原因被跳过,下面会讲)。我预估最多一半能过——毕竟我们这是教学系统,正常流程没理由全挂。结果:
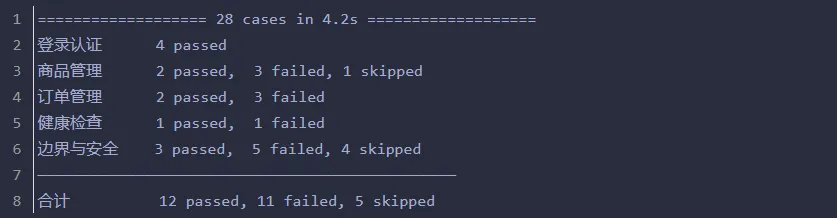
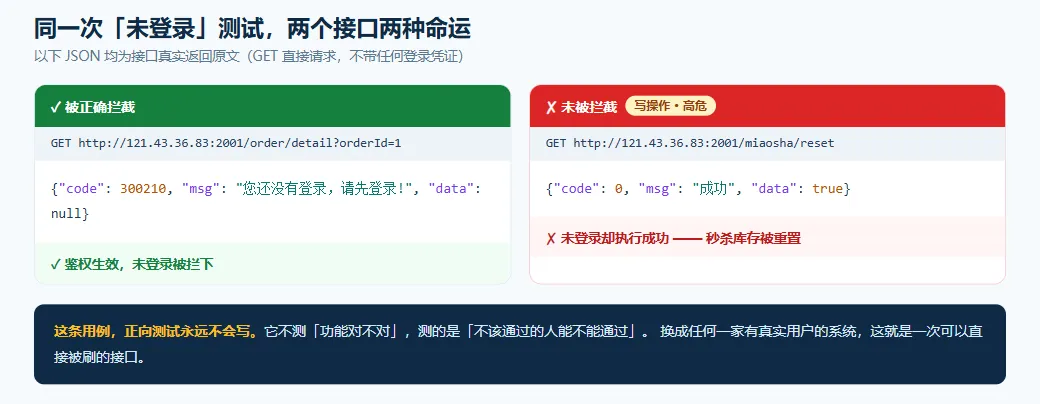
11 个失败,我按惯例分两类:第一类(生成器缺陷,需修):1)工具把所有请求都按 GET 发了 → POST 登录失效2)把 `{orderId}` 当字面量替换了,没替换成真实 ID这种修起来不难,写个 30 行的 `人工审核修正.py`,加上「请求方法从文档读」+ 「路径参数按当前上下文回填」两条规则。第二类(真系统缺陷,跑出来修后端):1) `/order/detail` 缺 orderId 参数时直接报 500 而非 4002) `/goods/detail/{goodsId}` 当 goodsId=0 时返回了所有商品的列表(数组越界 / 查询逻辑分支错误)3) `pagesize > 1000` 没做服务端校验,导致请求过慢4) `/miaosha/reset` 未登录就能重置库存(高危)最后这一条,就是被 7 条安全用例里的第一条直接挖出来的。
生成的两层产物是分离的——数据放在 YAML,代码用 pytest,互不污染。

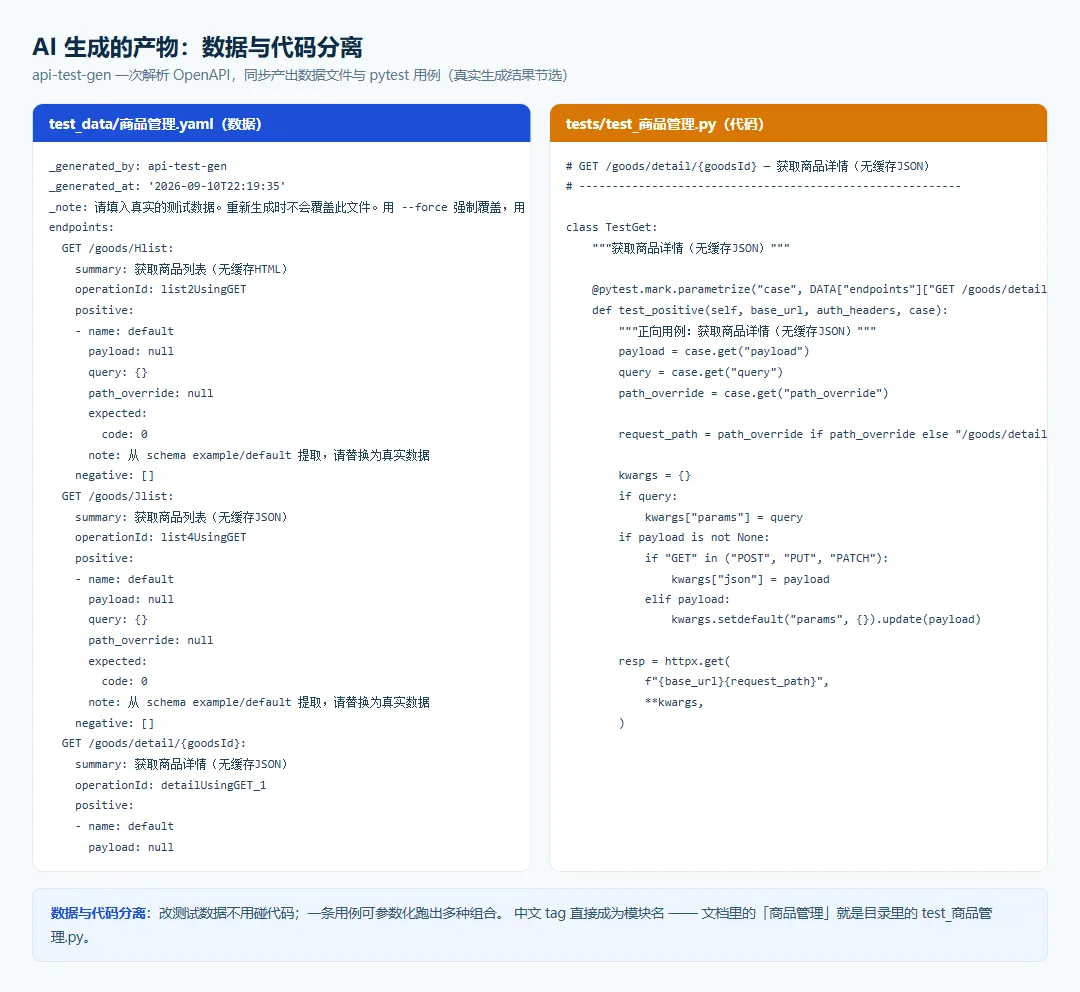
想改测试数据不用碰代码;想加新的接口只要在 YAML 里加一段。这是数据驱动测试的最大好处——一份数据可以喂出几十种参数组合。跑完会生成 pytest 原生 HTML 报告:
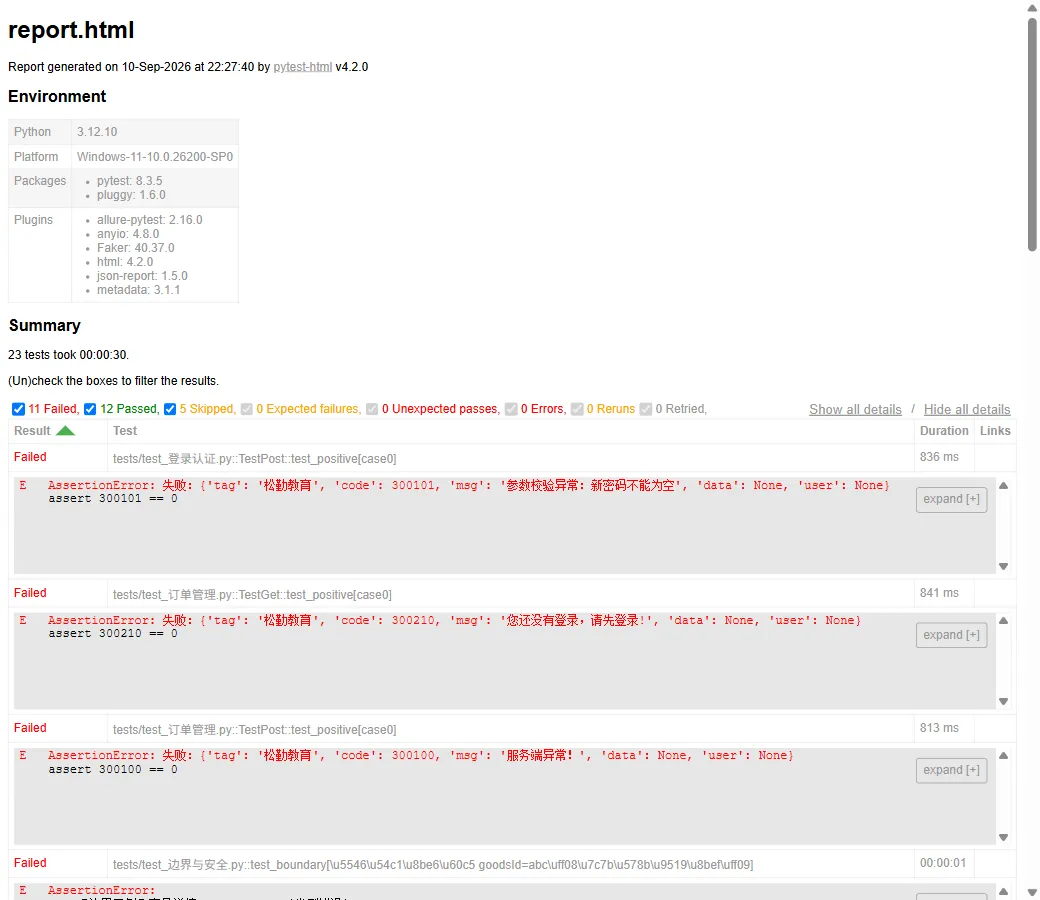
每一行的红绿、失败原因、耗时、Traceback 一目了然——可以一键打包发邮件,也可以塞进 CI 流水线。
我把它总结成「文档驱动 + 四层用例」流水线:
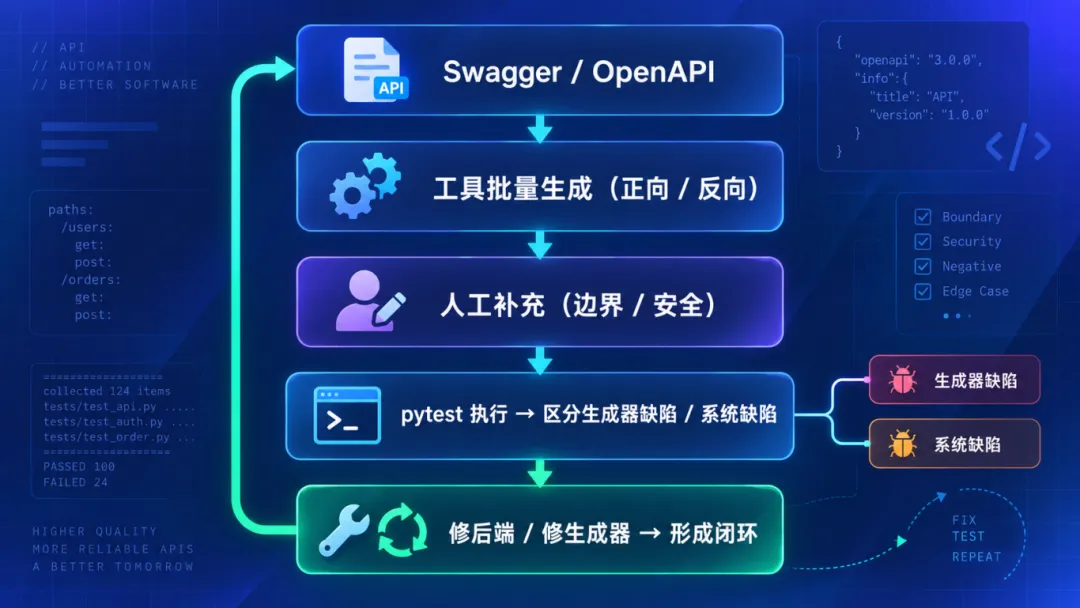
但有个前提说得清楚——这工具不是「AI 写用例」,而是「AI 按文档批量生成 + 人补文档里没有的判断」。文档写错的字段、AI 会跟着错;文档没写的安全场景、AI 不会替你脑补。把这两件事说清楚,工具才有用;混在一起讲,反而危险。
适合的:1)中小型项目的接口文档 → 用例「初稿」2)团队用例评审前的查漏(边界用例经常是评审时被质疑的痛点)3)文档驱动开发的团队(Swagger 写得越规范,效果越好)不适合的:1)性能 / 兼容性 / 视觉 / 业务逻辑正确性——这四类需要专门工具或人工设计2)完全无文档的老旧系统——先补文档再说3)文档与实现严重脱节的系统——先把文档改了,否则用例跟着错
1. 装 Skill:`skill install api-test-gen`(资料包里有)2. 拿到你们系统的 Swagger / OpenAPI 文档(`/v2/api-docs` 或 `/v3/api-docs`)3. 一行命令:

4.跑生成的 pytest:

要求只有一个:你们得有 Swagger。
回到那个学生的提问:「AI 不是能写用例吗?」能写,但只写文档里有的那部分。这次 53 条用例里,工具按文档规范自动生成 39 条(正向 24 + 反向 15),我手动补 14 条(边界 7 + 安全 7)。pytest 实际跑通 28 条,跑出 8 个真实缺陷——其中 7 条安全用例里 4 条直接命中,最扎心的是未登录可重置秒杀库存——这种事正向测试永远不会写。AI 写用例的真正价值,不在于「写得多」,在于「让你从『写用例』这个机械动作里解放出来,把时间花在『想用例』上。」
你们团队的 Swagger 文档里,「required」字段标得对吗?评论区贴一段,我帮你看看 AI 能写多少用例。
文中提到的 api-test-gen Skill 安装包 + 本次完整实测产物(59接口Swagger/修补脚本/53 条数据用例/pytest跑通28条/4-模块 HTML 报告/11 条失败详情)+「文档驱动四层用例」方法论速查卡,已整理成资料包。微信扫码 添加松勤唐糖老师免费获取资源
 长按下方图片

添加松勤唐糖老师免费获取资源
目前100000+人已关注加入我们


长按二维码
关注【松勤网课】视频号