ARTICLE · 1009889
AI真实落地案例系列·正传③:长记忆Agent落地实战:蒸馏、遗忘、KV缓存的企业取舍真相
看完前两篇大家会发现一个规律:Demo级AI靠模型,生产级AI靠记忆与调度。
我们在推理引擎系列讲清了AI怎么思考,在Agent记忆系统系列吃透了三级记忆、蒸馏、抗污染、遗忘机制。
但理论再好,不上生产都是空谈。
企业真实长周期场景——政企办公、长期客户对接、项目持续跟进、多轮业务沉淀,全都绕不开一个核心需求:长记忆。
可行业真实现状极其统一:
开启长记忆=越用越卡、成本暴涨、答案跑偏;关闭长记忆=变回弱智、记不住业务、无法落地。
长上下文就是长记忆吗?今天这篇,我们完全以企业真实踩坑案例为核心,把记忆理论翻译成可直接复用的生产规则。
同时深度联动我们记忆体系、推理体系、算力硬件番外,讲透长记忆Agent的落地取舍。
01
两个真实企业落地惨案:长记忆是最大隐形坑
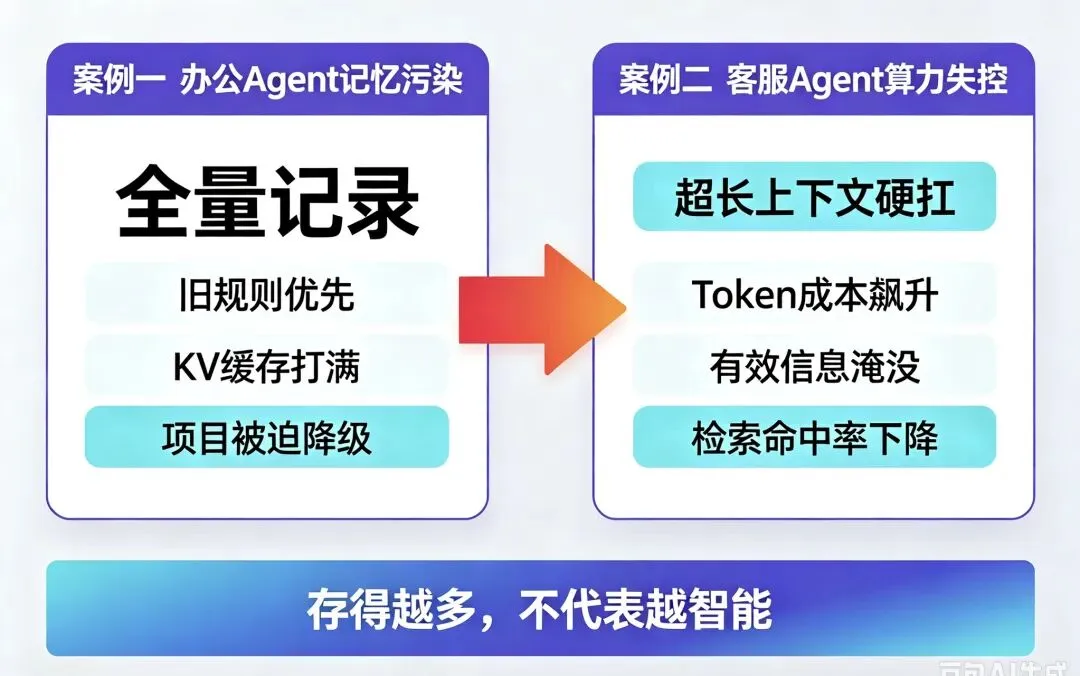
案例1:大型企业智能办公Agent——记忆不筛选,最终彻底瘫痪
某中大型企业上线内部办公Agent,需求很朴素:
长期记住员工审批习惯、常用流程、历史咨询记录,实现千人千面办公辅助。
上线初期体验极佳,智能、贴合习惯、不用重复说明需求。
上线1个月后问题集中爆发:
1. 对话上下文无限堆积,KV缓存持续打满,响应延迟从1秒暴涨至6–10秒;
2. 新旧规则混杂,新制度更新后,AI仍优先沿用旧记忆作答;
3. 无效闲聊、重复咨询、错误试探内容全部留存,记忆污染持续累积。
最终结果:
算力成本翻倍、速度严重卡顿、答案越来越不准,项目被迫关闭长记忆功能,退回普通问答工具。
核心根源(完全贴合我们记忆系列结论)
只做「记录」,不做筛选、蒸馏、遗忘。
很多企业误以为:存得越多越智能。
真实工程逻辑恰恰相反:不懂遗忘的记忆,一定会拖垮整套系统。
案例2:万人级客服Agent——长上下文硬扛,算力无底洞
某平台万人级客服AI,为了解决“用户重复说明问题”,直接拉满超长上下文窗口,试图硬承载所有历史对话。
落地后出现两个致命问题:
1. Token成本持续飙升,日均开销逐月递增,无法控本;
2. 长上下文信息冗余严重,有效信息被淹没,关键业务记忆检索命中率暴跌;
3. 结合Dylan Patel算力访谈(推理番外④|吃透Semi Analysis顶级访谈:AI推理的真实瓶颈,从来不是芯片堆料)结论:超长上下文直接打爆HBM带宽与缓存调度,硬件层瓶颈彻底暴露。
团队后期复盘:
不是模型不够长,是没有分层记忆、没有记忆压缩、没有缓存淘汰策略。
02
行业核心真相:企业长记忆,绝对不能“全部硬存”
我们理论系列讲过:三级记忆、蒸馏压缩、主动遗忘、记忆可信度分级。
正传①提到的Roman Ugarte ‑ Lenny's Podcast 访谈,Grok Bot采用后台常驻运行的设计,用户关闭设备之后,Agent依然可以在云端持续工作、累积会话记忆。
但Roman也在访谈中坦诚了对应的工程代价:一旦允许智能体长时间驻留运行,记忆就会不停累积,KV缓存开销会持续上涨。
哪怕基座模型性能很强,如果缺少记忆蒸馏与主动裁剪遗忘机制,系统一样会出现记忆过载、内容混淆漂移的问题。
前沿产品尚且如此,企业做长记忆Agent,更不能天真地选择全部原始对话直接保存。
放到生产环境,对应四条血淋淋的落地规则:
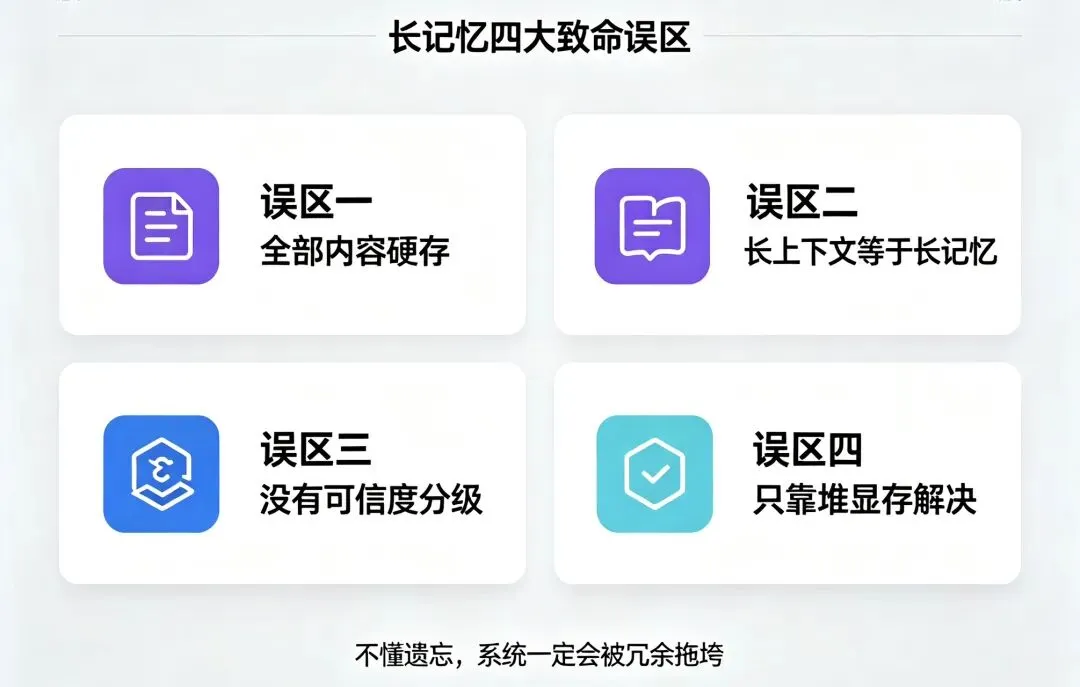
1. 原始对话≠有效记忆
用户闲聊、重复提问、试探性对话、临时操作,绝对不能长期留存。
全部存入长期记忆,就是直接制造污染与冗余。
2. 记忆必须有权重与可信度
企业落地必须给记忆分层定级:
• 已核实业务结论、固定流程:高可信,长期留存
• 单次临时对话、参考性内容:中低可信,短期留存
• 错误试探、无效闲聊、过期内容:直接过滤、定期清除
这也是海外企业CRM智能体的通用落地准则:不是所有记忆都平等,不同可信度的记忆,绝对不能同等参与推理。
3. 长上下文解决的是“单次对话”
长记忆系统解决的是跨天、跨轮、跨场景的长期业务沉淀。
长记忆与长上下文两者完全不同,绝大多数企业把二者混为一谈,导致全部方案做错。
4. 所有长记忆功能,最终受限于硬件调度
呼应算力番外核心观点:
长记忆、高频检索、海量历史比对,会持续压榨KV缓存、HBM读写、CPU调度资源。
软件层不做取舍优化,单纯堆硬件、扩显存,属于无效投入。
03
生产级长记忆Agent:企业唯一可行的四层落地逻辑
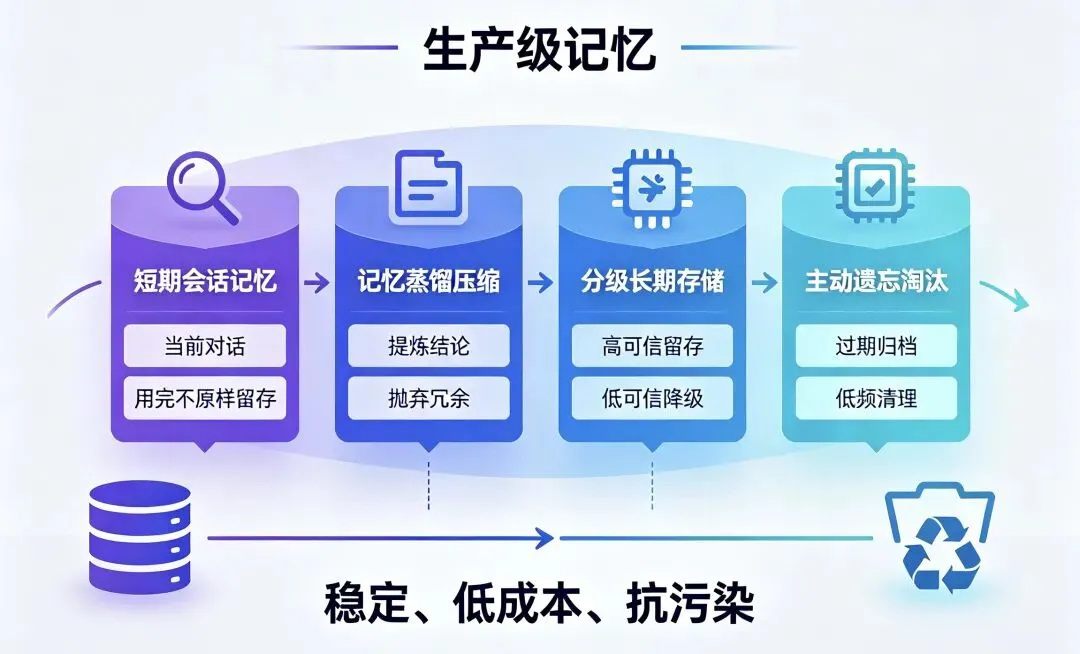
结合我们全套理论+真实案例复盘,企业可用、稳定、可控的长记忆方案只有一套:
第一层:实时短期记忆(上下文窗口)
存放当前单次会话,保证本轮对话流畅、逻辑连贯。
会话结束后,不原样留存,不占用长期缓存。
第二层:记忆蒸馏压缩(核心优化)
会话结束自动执行:
提炼本轮有效业务结论、关键参数、用户偏好,抛弃冗余话术。
用浓缩记忆替代原始长对话,是降本+抗污染的核心手段。
第三层:分级长期记忆存储
蒸馏后的有效内容,按业务类型归档入库:
• 流程偏好、固定规则、关键资料 → 长期记忆库
• 临时咨询、单次需求、可变内容 → 短期滚动记忆库
第四层:定时主动遗忘 + 过期淘汰
设置两套生产策略:
1. 时效淘汰:过期制度、旧流程、作废规则自动失效
2. 低频遗忘:长期未触发、低价值记忆逐步降级清理
这套流程,完美解决两个最大痛点:越用越脏、越跑越贵。
04
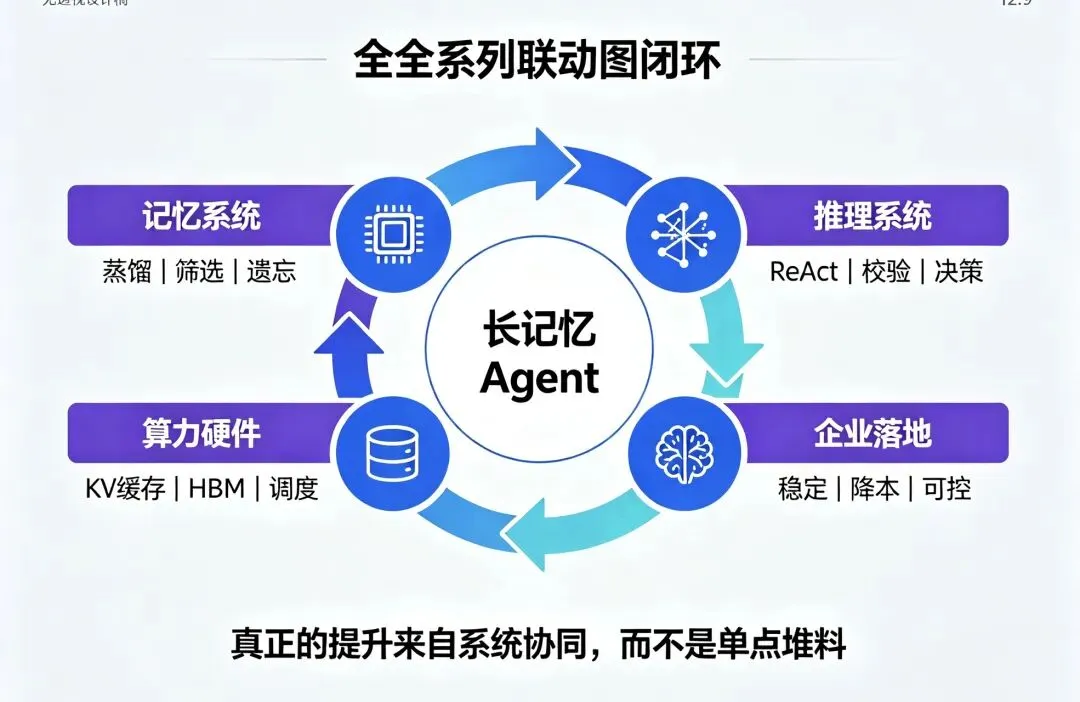
联动全账号四大系列,形成闭环
1. 联动记忆系列
三级记忆、蒸馏、遗忘、抗污染,全部从理论转为生产流程。
2. 联动推理系列
记忆筛选、可信度判断、蒸馏提炼,全部依赖ReAct分步推理、自我校验。
没有推理能力,记忆无法智能取舍。
3. 联动算力番外
所有长记忆功能,都会暴涨KV缓存与读写压力。
软件层优化到位,才能避免硬件层无限堆料,实现软硬件协同降本。
4. 联动架构进化系列
现代大模型落地能力,早已不靠基座参数堆叠,
靠的是外部记忆系统+推理调度系统的架构补齐。
05
最终落地小结(企业可直接照搬)
1. 企业长记忆翻车,99%不是模型问题,是记忆治理问题;
2. 只记录、不蒸馏、不遗忘,最终一定会污染系统、拖垮算力;
3. 长上下文 ≠ 长记忆,二者场景完全不同,不可混用;
4. 生产级记忆必须分层、压缩、定级、淘汰,做系统性取舍;
5. 记忆优化既是算法工程,也是软硬件协同的降本核心。
下一篇正传④:多智能体落地真相:为什么市面上炫酷的多Agent协同,99%都是企业伪需求。
AI辅助生成,相关内容经人工复核
往期文章回顾阅读:
【AI真实落地案例系列】
AI真实落地案例系列·正传①:为什么90%企业AI Agent项目,最后都“烂尾停更”
AI真实落地案例系列·正传②:RAG落地真相:看起来最简单,实际上坑最深
【Agent记忆系统系列】
Agent记忆系统系列④:记忆污染与记忆漂移,当AI的回忆开始骗人
Agent记忆系统系列⑤:记忆系统的天花板,现实工程如何做取舍
【Agent记忆系统·番外篇】
【推理引擎进化系列】
推理引擎系列·番外① 金三木案例:单链CoT的边界与分布式多智能体反驳推理
推理引擎进化系列④:两大执行范式 ReAct 与 Plan‑and‑Solve
推理引擎进化系列⑥:AI推理的天花板,就算叠加CoT‑ReAct‑Reflection,有些问题依旧解不开
【推理引擎进化系列·番外④】
【Al底层算力系列】
终于分清!近存计算、存算一体,谁才是AI内存墙真正的终极解法?
觉得内容有收获,欢迎转发给身边关注AI、科技行业的朋友
欢迎到公众号主页查看其它专题合集