ARTICLE · 1010893
文档加载全景:RAG 的第一步不是算法,是先把文档拿进来
上一篇我们做出了 v0.0 挂号助手:3 条硬编码的假索引、关键词匹配、塞进 Prompt——三步跑通。
但你心里清楚,那 3 条 chunk 是我抄死在代码里的。
真到了医疗场景,病历是 PDF、检验报告是扫描件、医师指南是 docx;真到了法律场景,法条年年修订、判决书双栏排版、合同有批注有修订痕迹——这些怎么进 RAG,上一篇一个字没讲。
这一步缺了,后面 Embedding、向量库、混合召回全是空中楼阁。
所以第二章第一篇,我们先把「文档从哪来」这件事想透。
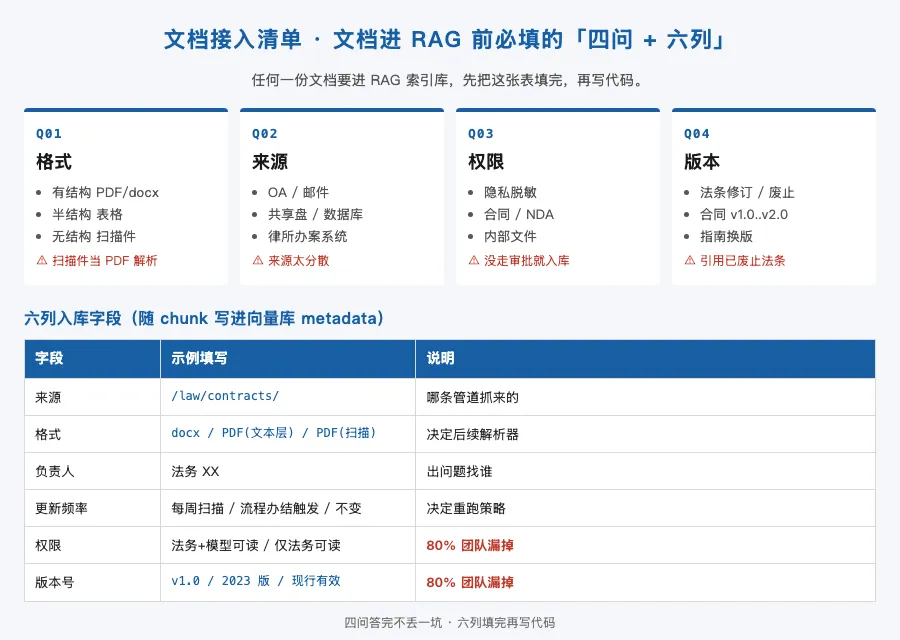
一、先想清楚一件事:文档从哪来
做 v0.1 之前,我建议你在纸上把每一类文档列出来,按下面四问过一遍——只要有一项答不上来,后面 RAG 再准也是埋雷。
问 1:格式是什么
有结构:PDF、docx、html、md——能解析出文本流; 半结构:表格(PDF 里的二维表、Word 里的 Table 对象)、表单(PDF AcroForm); 无结构:扫描件 PDF、图片、传真件——需要 OCR,多模态留到第三章。
这一步最大的坑,是把扫描件当 PDF 直接解析。很多医院的检验报告导出来是 PDF,但其实是「图+文字图层」(俗称「双层 PDF」),旧一点的连文字图层都没有。你以为在解析文字,其实解析的是像素。后面我会留一手当 OCR 的伏笔。
问 2:来源在哪
公文系统 OA / 邮件附件 / 法务共享盘 / 律所办案系统 / 医院 HIS 导出; 一类源就有一个抓取节奏:邮件是「新邮件到达触发」,OA 是「流程办结触发」,共享盘是「定时扫描」。
v0.0 阶段我建议只接一个源——手动上传或单一目录监听,别一上来就挂五个数据源。接得多,改动节奏就乱。
问 3:能不能进库(权限)
患者隐私(《个人信息保护法》、HIPAA):姓名、身份证、手机号必须脱敏; 客户合同(NDA、未公开条款):是否允许进向量库要法务拍板; 内部文件(未公开财报、未公开技术方案):是否允许模型读取要安全部门拍板。
这一步没有任何技术捷径,只能走审批流。我见过有人把所有 PDF 往库一塞,上线后被法务叫停,全量回滚——比技术事故更麻烦。
问 4:版本与生效日期
法条:2024 版《公司法》刚出,2023 版同时还有效,要看用户查的是哪 一年的案件; 合同:v1.0、v1.1、v2.0 共存,某天一份「已作废 v1.0」突然命中检索词就 引出去了; 指南:《临床诊疗指南》每隔 2-3 年更新,老版不能直接删——医学生还 要参考。
最经典的翻车现场:今年我们做了一个律所 RAG 知识库,上线 3 个月有律师反馈——「你给我的法条,是 2014 年废止的婚姻法司法解释三」。查下来是:法规源文件里同时挂着「现行有效」「已修改」「已废止」三栏标签,我们入库时只抓正文,没抓标签。
RAG 引用已作废旧法条 ≠ 技术 bug,是事故现场。
二、上手段:文档接入清单
任何一份文档要进 RAG 索引库,我让你先填一张表,再写代码:
这六列里,「权限」和「版本号」是 80% 团队漏掉的。
权限决定哪些文档能进库、哪些人能看到召回结果;版本号决定一份文档能不能被一条已废止的法律引用答非所问。
把它们和 chunk 一起写进向量库 metadata(元数据)(后续在 Embedding 篇和向量库篇我们会把这一步拆开来),这是后面所有「医疗事故」「法律事故」的第一道防火墙。
三、第一步只做一件事:把文档拿到本地
说完清单,这一篇不写代码——别急,EP009 立刻上 PDFBox、EP010 上 POI,把 PDF 和 Word 分别拆给你看。
这一篇只给你三个建议:
- 先把来源收口
:所有要进 RAG 的文档先复制到固定目录(推荐 /data/rag-corpus/{yyyy-MM}/按月分),别直接从生产路径读; - 先按格式分目录
:按 pdf/docx/scan/md/分开,给后续解析器路由用; - 先做最小解析试错
:每类格式挑 5-10 份样例,人工校验解析结果是「可用的」再继续——别 等写了 80% 才发现「双层 PDF 没文字层」。
这三条落地了,第二章就稳了。
给读者的三分钟自检
你能列出要入 RAG 的所有文档来源 你能回答「哪些文档不能进库」(隐私/合同/未公开) 你能回答「版本怎么管」(法条/合同/指南) 你的来源/格式/负责人/更新频率/权限/版本号六列已经能填出来 你的样例文档已经手工抽查过解析结果
任何一项答不上来,先别写代码——先把业务摸清楚,再让代码替你扛活。
下一篇(立骨 · 02),我们正式开干:用 Apache PDFBox 解析判决书 PDF。你会看到一条最朴素的双栏民事判决书,是怎么被 PDFTextStripper 拆得顺序错乱、表格碎成一行行、图片里的字一个都拿不到的——以及我们怎么按页切分、怎么把表格和图片单独留占位,留给后面的切块器和多模态接管。
我们下一篇见。
声明:本系列所有内容均为个人原创(含基于公开文档、资料、书籍与个人实践的重述和代码实现)。文中医疗、法律相关案例均为脱敏的合成示例,与公司核心业务完整脱离,只讲技术,不构成医疗建议或法律意见。