ARTICLE · 1011584
Chisle:一个插件把 AI 助手的 Token 砍到 52%!
大家好,这里是「AI 开源提效指南」。
之前安装的技能和插件因为重装机器都丢了,最近Token不够用了,试着找找开源的技能,今天发现一个不错的!
有个叫 Jay Pokale 的开发者做了个小插件(JayPokale/Chisle),专门治 AI 助手话多的毛病。
装完之后不用改任何配置,Claude Code、Pi、Cursor 就会开始少说废话、少造抽象、少读没用的内容。
大家平时盯的是模型“说了多少”,其实 Token 大头往往是它“读了多少”。
作者拿自己五周的真实工作记录统计过:工具输出占了会话内容的 67.5%。更夸张的是,超过 8k 字符的大块输出只占工具结果数量的 4%,却吃掉了全部会话内容的四分之一。
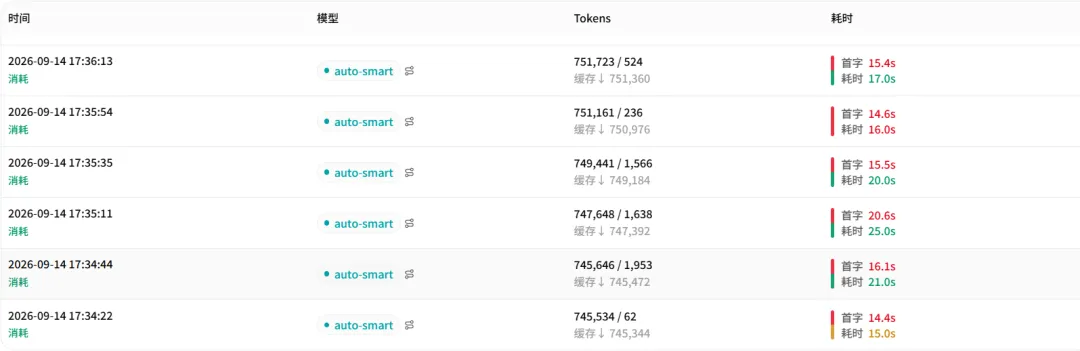
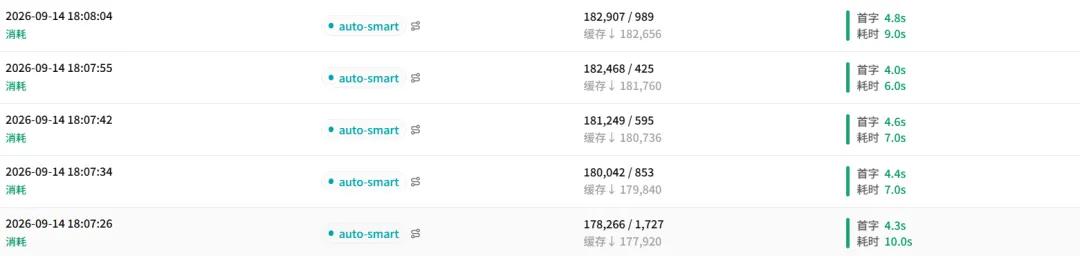
先看下我安装前后的token消耗差异(codex):
安装之前:
安装之后:
Chisle 的做法是在会话的三个节点各加一层拦截:
管它怎么写 管它读到什么 管它读多少
三层各自独立,也能单独开关。
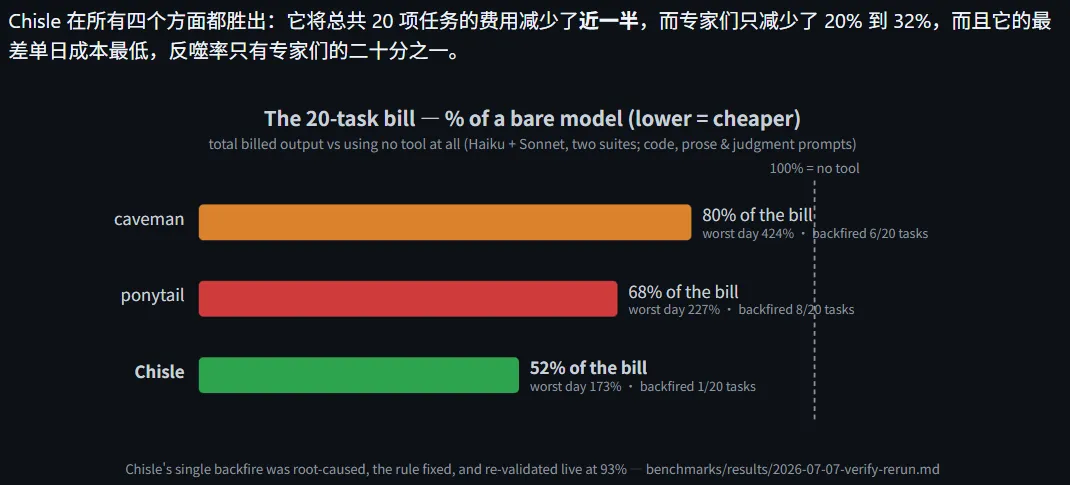
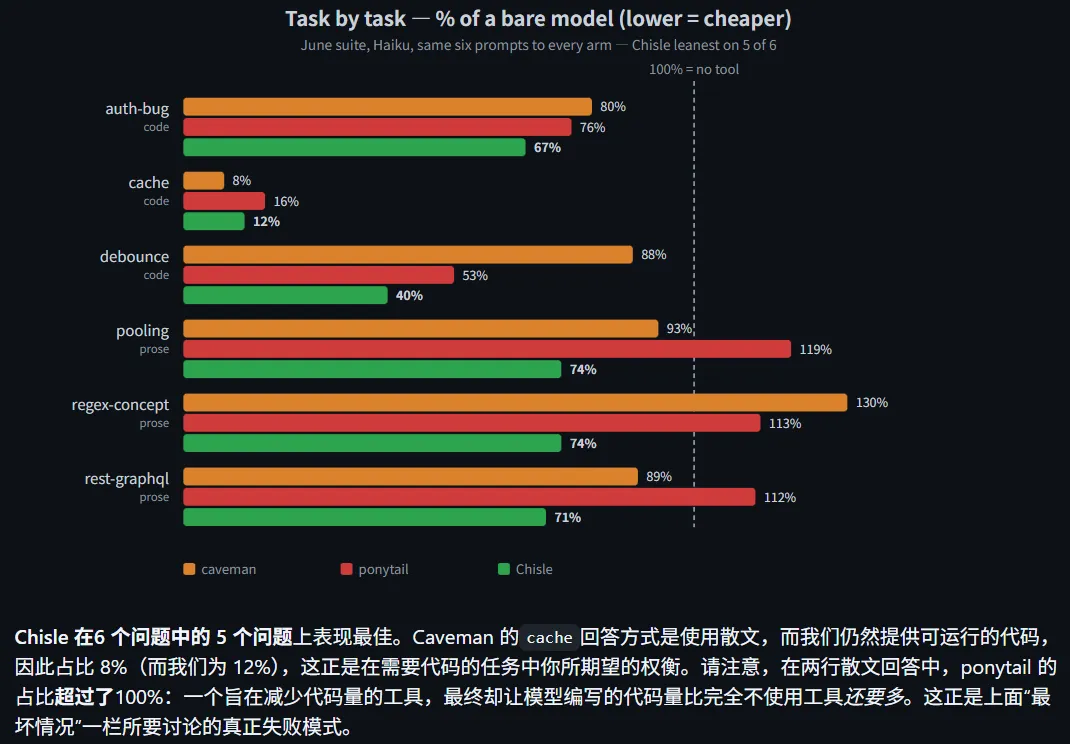
同一模型、同一批 20 道题,套上这层规则后总 Token 掉到裸模型的 52%,平均每道题 69%,最坏的一天是 1.73 倍。对照的两个同类工具,最坏一天分别是 4.24 倍和 2.27 倍,翻车次数 6 次和 8 次,它只有 1 次。
它不挑客户端,也不挑模型,规则是纯文本,谁读都行。
这是作者提供的测试截图:
项目介绍
Chisle 是给 AI 编码助手用的效率规则集 + 运行时压缩器。
它在同一次会话里同时管三件事:模型怎么写、模型读到什么、模型读了多少。
前两件靠注入进上下文的规则正文,第三件靠接在工具返回事件上的压缩 hook。
读取习惯那一块也是规则,但目标是「别把整个文件读进来」。
和同类工具最大的区别是:所有压缩和改写都发生在本地,压缩器里没有模型调用、没有网络请求、没有第三方依赖;也没有强度档位需要你去调,只有开或关。
核心能力
提示词规则注入:会话开始时把规则正文注入上下文(约 1.6k token),日常每一轮只补一句约 50 token 的提醒。只有全新会话发整份,恢复、清空、压缩这三种情况只回一行,避免同一份规则反复计费。 七级代码阶梯:从「这东西需要存在吗」一路问到「能不能就一行」,停在第一个成立的台阶上。同时规定安全、错误处理、无障碍这些永远不在削减范围内。 推理也计费:规则里单独写了一段,把阶梯定义成停止规则而不是一张要念出来的清单,明确「不要在已经排除的选项上重新权衡」,同时保留「理解问题这件事一步都不能省」。 工具输出压缩:一个纯 Node 标准库的 PostToolUsehook,按白名单挑工具,把超大输出清洗、切中段、去重复之后,换掉模型真正读到的那份。可恢复的省略:切中段之前先把完整原文落到磁盘,替换标记里带上文件路径。之后想找某一行是精确搜索,而不是重跑命令——对不可重放的命令。 返回结构还原:压缩后的文本必须按工具原本的返回结构塞回去,认不出的结构宁可不替换也不瞎猜。 读取习惯规则:先按符号搜索再读匹配区间、从源头收窄输出、已经在上文里的文件不重复读、构建和测试日志只留失败项和汇总。 九个客户端一条命令:自动探测机器上装了哪些助手,按插件、包、追加规则段、项目内规则文件四种方式分别安装。 仓库里自带完整跑分工具:四组对照的实时测试脚本、离线回放脚本,以及带自动判分的正确性测试和真实仓库测试套件。
快速开始
1. 环境要求
Node ≥ 18(安装器和 npx需要)要做输入侧压缩和 /chisle开关切换,需要 Claude Code 或 Pi其余七个客户端只会拿到常驻规则那一部分
2. 安装方式
# npm,自动探测并逐个安装npx chisle# 或者用 shell 启动器curl -fsSL https://raw.githubusercontent.com/JayPokale/Chisle/main/install.sh | bash# Windowsirm https://raw.githubusercontent.com/JayPokale/Chisle/main/install.ps1 | iex# 只装某一个客户端,先看会动哪些文件npx chisle --only claude --dry-run# Claude Code 走原生插件市场claude plugin marketplace add JayPokale/Chisleclaude plugin install chisle@chisle# Pi 走包管理pi install npm:chisle3. 使用示例
$ npx chisle...── summary ── detected: 2 installed: claude-hooks, codexDone. Restart your agent. Type /chisle in Claude Code or Pi, or just start coding.If Chisle earns its keep, a star helps others find it: https://github.com/JayPokale/Chisle$ npx chisle --listchisle: detected agents: ? Claude Code ? Pi ? Gemini CLI ? Codex CLI ? Cursor (project-scoped) ? Windsurf (project-scoped) ? Cline (project-scoped) ? Kiro (project-scoped) ? GitHub Copilot (project-scoped)Run npx chisle to install for the detected (?) agents.4. 升级和卸载的两个坑
npx chisle@latest --update # 刷新所有已经装了 Chisle 的客户端,不会新装任何客户端npx chisle --uninstall # 全部清掉这两个坑作者写在了 README 里,也是代码里的真实情况:
第一,直接重跑 npx chisle不会升级。
每条安装路径在检测到已经装过时都会跳过,于是升级命令会打印一段成功摘要,实际上一个文件都没改。
--update 就是把「强制覆盖」和「装过没有」两个判断绑在一起。
第二,npx chisle 可能拿到的是上一次缓存的包,所以升级必须加 @latest。
这两个细节在 CHANGELOG 都有。
另外,Cursor、Windsurf、Cline、Kiro、Copilot 这五个是把规则文件写进项目仓库的,所以要升级得去每个有规则文件的项目里各跑一次。
接入九个客户端
九个客户端每个带一条探测表达式和安装方式。 Claude Code 和 Pi 支持最完整,其余七个只拿静态规则。
settings.json 合并 + 状态栏徽标 | claude命令 | ||
pi命令 | |||
gemini命令 | |||
~/.codex/AGENTS.md 追加一段带标记的规则 | codex命令或 | ||
.cursor/rules/chisle.mdc | cursor命令或 | ||
.windsurf/rules/chisle.md | ~/.windsurf、~/.codeium/windsurf 目录 | ||
.clinerules/chisle.md | cline | ||
.kiro/steering/chisle.md | kiro~/.kiro 目录 | ||
.github/copilot-instructions.md | copilot |
探测表达式的语法是自己定的,用 || 串多个条件:cmd: 查命令在不在,dir: 查目录,file: 查文件,vscode-ext: 去四个扩展目录里翻(.vscode、.vscode-server、.cursor、.windsurf 的 extensions/)。
命令探测用 sh -c "command -v xxx",Windows 上换 where——这也是它能跨平台的原因,整个安装器没引入任何依赖。
安装器的完整命令面
npx chisle | |
npx chisle --list | |
npx chisle --stats | |
npx chisle@latest --update | |
npx chisle --only <id> | |
npx chisle --dry-run | |
npx chisle --force | |
npx chisle --uninstall-u | |
npx chisle --config-dir <路径> | $CLAUDE_CONFIG_DIR 或 ~/.claude) |
npx chisle --no-color | |
npx chisle --help-h |
除了 /chisle 开关,Claude Code 里还有三个斜杠命令(定义在 commands/*.toml):
/chisle-audit [路径]:一次过审一个 diff、一个文件或整个仓库,同时列出过度设计的代码和啰嗦的注释文档,按能砍掉的量从大到小排,只报告不改动/chisle-review [文件]:只看当前的 diff 或某个文件,挑出过度工程、只服务一个实现的抽象、重新发明的标准库/chisle-help:速查卡
全部开关
# 默认模式:环境变量优先,其次是配置文件,最后默认 onexport CHISLE_DEFAULT_MODE=off# 或写进 ~/.config/chisle/config.json{ "defaultMode": "off" }# 输入侧压缩,Claude Code 和 Pi 共用的开关CHISLE_COMPRESS=0 # 关掉整个压缩CHISLE_COMPRESS_SCRUB=0 # 只关无损清洗CHISLE_COMPRESS_DEDUP=0 # 只关重复标记CHISLE_COMPRESS_SPILL=0 # 只关落盘副本(关了就没有找回原件的通道)CHISLE_COMPRESS_MAX_CHARS=8000 # 超过这个字符数才切中段CHISLE_COMPRESS_HEAD_LINES=60 # 保留开头多少行CHISLE_COMPRESS_TAIL_LINES=40 # 保留结尾多少行CHISLE_COMPRESS_TOOLS=bash,grep # 覆盖工具白名单CHISLE_UPDATE_CHECK=0 # 关掉版本检查(默认只在大版本更新时提一次,缓存三天)三条线、三个 hook——Chisle 接在会话的哪几个瞬间
Chisle 的架构可以一句话概括:它没有常驻进程,没有服务端,全部逻辑接在客户端自己的生命周期事件上,只有三个挂点,各管一块。
1. 架构概览
三个挂点对应会话里三个不同频率的时刻,这是有意设计的——注入规则最贵(约 1.6k token),所以只在新会话发生一次;每轮提醒很便宜(约 50 token),所以每轮都发;压缩按需触发,只在工具真的返回了大块输出时干活。
会话开始(每个新会话一次)└─ SessionStart → chisle-activate.js → 写开关标志 + 注入整份规则 恢复/清空/压缩时只回一行每一轮提问(每次输入)└─ UserPromptSubmit → chisle-mode-tracker.js → 解析开关 + 补一句提醒每次工具返回(每次调用后)└─ PostToolUse → chisle-compress-output.js → 清洗 → 省略 → 去重 → 换回原结构2. 模块职责
settings.json,写入前把客户端会拒绝的条目清掉,原子落盘 | |
[CHISLE] 徽标,从标准输入里的额度信息画进度条,并显示累计省下的 token | |
--check 模式供 CI 比对 | |
tool_result 压缩 | |
压缩器的三层与原件备份机制
既要把输出压小,又不能让模型因此看不到它本该看到的东西。
第一道关卡:哪些工具允许碰
白名单是写死的,而不是黑名单:
// hooks/chisle-compress-output.js:52// Read/Edit/Write 故意不在这里:它们的输出要参与精确匹配的编辑const SAFE_TOOLS = ['Bash', 'Agent', 'WebFetch', 'WebSearch', 'Grep', 'Glob'];这件事必须用白名单。
原因:Read 的输出会被后面 Edit 的 old_string 拿去做精确匹配,如果把中间切掉,模型就会对着一段它从来没见过的文本做编辑。
这是会直接改坏文件的路径,所以只能用明确允许,而不能用默认允许、个别排除。
mcp__ 开头的工具单独放行,因为它们是只读信息工具。
这个决定有数据支撑:实测语料里最大的一块不可压缩的超大输出就是整文件的 Read,327 次调用、562 万字符。
压缩器碰不了它,于是规则侧单独给出了读取习惯那一块去上游解决。
第二道关卡:三层依次过
三层的分工是这样的:
第一层 scrub() 是无损的。
它去掉终端控制码、行尾空格,把连续三个以上换行并成一个,把连续四行以上的相同内容收成一行再加一个「重复 N 次」的标记。这一层不丢任何信息,只在超过 1k 字符时才跑。
第二层 compress() 是有损的,但损失被围了起来。留头 60 行、尾 40 行,中间整段切掉之前,先用一条正则把像报错的行挑出来(error、failed、exception、traceback、panic、timed out、cannot find 等 20 多个模式),最多挑 12 行、每行最多 300 字符,塞在标记下面。这一步正面回答了一个真实的失败场景:一个三千行的构建日志里唯一重要的那一行,很可能就在中间。
第三层是去重,只在同一个会话、同一个工具、逐字节完全相同的情况下触发,1800 多个字符才参与比较。
第三道关卡:省得不够就别替换
MIN_WIN = 64:压完如果没省下 64 个字符,就返回 null,客户端那边什么都不改。
这个门槛看着不起眼,但它是“不要为了省一点反而引入风险”的兜底。
原件备份机制:先把完整内容落到磁盘
替换标记里带上这个路径,于是恢复一行变成了精确搜索,而不是重跑那条命令。
作者写这段的时候讲得很清楚:重跑命令比省下的那几个字符更贵,而且在命令本身不可重放的时候根本就是错的。
目录权限 0700、文件 0600,只留最近 40 个,CHISLE_COMPRESS_SPILL=0 可以关。
更细的一层是:整段落盘失败也不影响压缩本身照常发生,因为这一步是尽力而为的——只是丢了那条找回原件的路径。
这种“主路径不依赖可选步骤成功”的写法在这个文件里出现了不止一次。
敢把翻车那次跑分一起发出来的基准
这个项目花在「证明自己有用」上的功夫,比花在功能上的多。
仓库里有一套完整的跑分工具,原始记录全部提交在 benchmarks/results/ 下。
四套测试,各答一个问题
caveman、ponytail、本工具,同 20 道题,四组只有注入的系统提示不同;用隔离的 HOME 和配置目录,避免个人设置泄漏进来 | ||
主要结果
20 道题、四组对照、Token相对裸模型的百分比:
caveman | 424% | |||
ponytail | ||||
| Chisle | 52% | 69% | 173% | 1 / 20 |
分类对比:
caveman | ponytail | |||
|---|---|---|---|---|
| 44% | ||||
| 87% | ||||
| 45% |
和 caveman、ponytail、headroom 比,差的到底是什么
这四个是同一类问题上的四种解法:
caveman | ponytail | headroom | ||
|---|---|---|---|---|
npx | ||||
选哪个其实取决于你怕什么:
只在意长回复的提示词, caveman那种专精路线在纯散文上确实更极致(在它占了上风的短代码提示那档,它也更强)在意代码少写抽象, ponytail的惰性代码规则更专注但如果你在意的是最坏情况,也就是「本来就小的一段输出,会不会被这套规则搞大」,那 52% 的均值意义不大,1/20 的翻车率和 173% 的上限才是关键——对照组的 6/20 和 8/20 说明这不是罕见情况 而如果你的Token大头在工具输出(跑 CI、看日志、翻代码库的都是),那另外几个根本没覆盖这一块,跟它们比是错位的
总结
Chisle 是一个给 AI 编码助手用的三块效率插件,它把「让模型少说废话」和「让模型少读垃圾」放在同一个安装包里,并且用一套公开的、连失败跑分一起发布的基准来支撑自己的说法。
想省token可以来试试!
参考资料
项目仓库:https://github.com/JayPokale/Chisle官方文档:https://chisle.jaypokale.me相关文章:https://github.com/JayPokale/Chisle/blob/main/benchmarks/results/2026-09-14-quality-and-agentic.md🎯 觉得这份工具干货有用?希望收到您的支持:
⭐ 星标 / 置顶公众号,第一时间解锁最新工具分享! ✅ 点赞「推荐」,让更多技术伙伴发现优质干货! 🔗 转发给团队小伙伴,一起高效提效! 💬 底部留言区,告诉我您想找的工具/项目方向!
📬 长期追踪优质开源工具
关注「AI 开源提效指南」|日更开源神器,玩转技术提效! 回复 【容器加速器】,即刻开启你的高效探索之旅~