ARTICLE · 1014533
AI Agent顶会刷新算法!思维链+混和训练破解推理与速度难题!
具身智能/世界模型方向,正在出现哪些值得学生关注的新研究切口?
ICLR2026、CVPR2026已收录的工作来看,研究者正在围绕几个具体问题展开探索:机器人如何利用视频学习环境变化?如何兼顾推理能力与执行速度?如何看清操作细节?又如何在学习动作时保留大模型原有的知识?
这些问题背后,对应着世界模型与动作学习、推理与执行效率、像素级感知、参数高效微调,以及扩散模型条件学习等方法。
对于正在准备毕业论文、寻找科研创新点或者想发顶会顶刊的同学非常有参考价值。下面整理了近100篇2026年顶会论文,附官方代码,扫描下方二维码领取。
添加好友,回复「具身智能2026」
免费领取:论文合集+公开项目与代码入口
1、ICLR 2026|Unified Vision-Language-Action Model
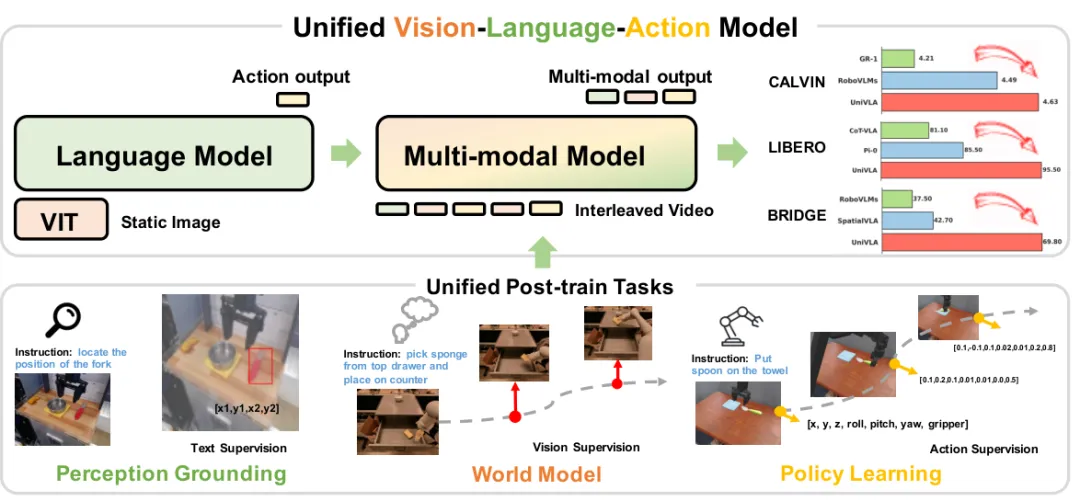
机器人完成连续操作,需要理解物体怎样随动作发生变化。只有当前画面的语义信息,往往不足以支撑复杂的多步骤任务。UniVLA将视觉、语言和动作统一为离散Token序列,通过自回归模型进行联合建模。训练时,先利用不要求动作标注的数据开展世界模型后训练,再将动作加入序列,学习下游机器人策略。论文在CALVIN、LIBERO等仿真基准,以及真实ALOHA机器人操作任务中进行了验证;其中,作者报告的LIBERO平均成功率为95.5%。
创新点:世界模型+自回归动作学习,让机器人从视频中学习环境变化,并把这些知识用于动作决策。解决了利用视频经验,提高连续操作能力的问题。
2、 ICLR 2026|Hybrid Training for Vision-Language-Action Models
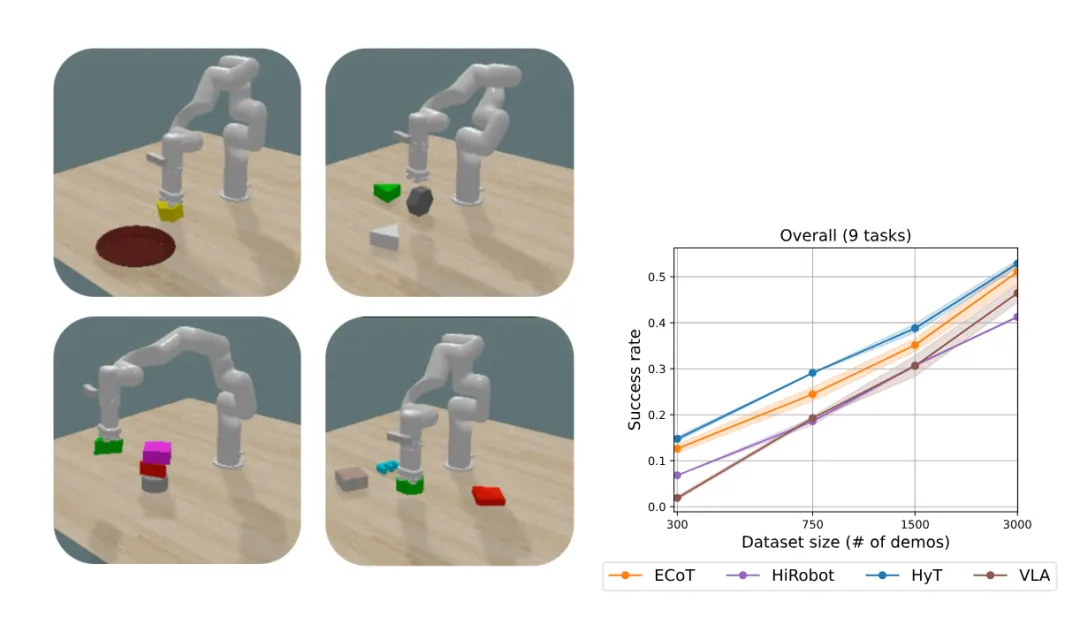
让机器人在行动之前生成思维链,可以帮助它理解任务与规划步骤。但在真实控制中,生成更长的推理内容也会增加等待时间。HyT提出混合训练框架,让VLA模型在训练时学习推理轨迹与动作之间的联系,并支持多种条件输出方式。
执行时,模型可以直接预测动作,也可以生成中间推理,或者按照给定意图执行。论文通过仿真和真实机器人实验研究了这种训练方式。会议官方收录与摘要
创新点:思维链+混合监督训练,它将“训练时利用推理监督”和“执行时输出完整推理”分开处理,同时兼顾推理能力与控制速度。
3、 ICLR 2026|PixelVLA: Advancing Pixel-level Understanding in Vision-Language-Action Model
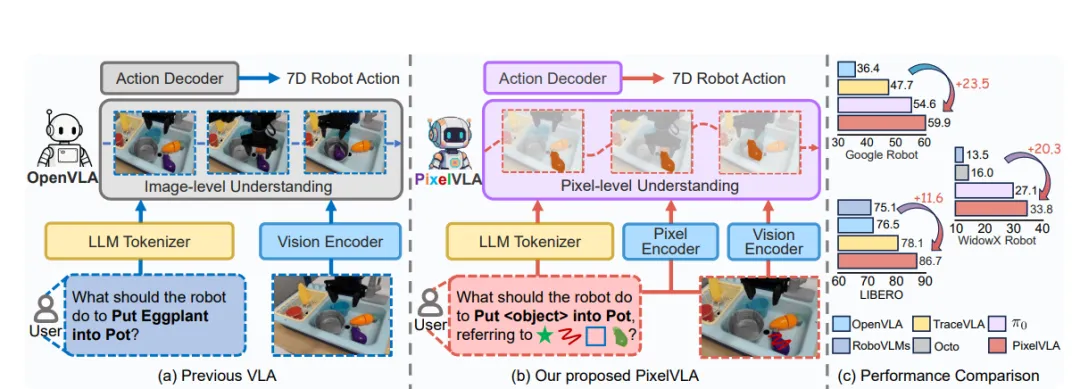
PixelVLA聚焦现有VLA模型的细粒度场景理解和交互方式。它在视觉运动指令微调框架中,引入多尺度像素感知编码器和视觉提示编码器,使模型同时处理文本与视觉提示。作者还设计了两阶段自动标注流程,从已有机器人数据中构建Pixel-160K,为像素级理解与动作学习提供训练数据,并在多个VLA基准上验证方法。
创新点:像素级感知+视觉提示学习,将像素感知编码器和视觉提示编码器接入VLA,结合自动标注数据训练,精准定位操作区域,并理解点、区域等视觉指令。
添加好友,回复 「具身智能2026」
领取本文论文合集+公开项目与代码入口
4、CVPR 2026|Exploring Conditions for Diffusion Models in Robotic Control
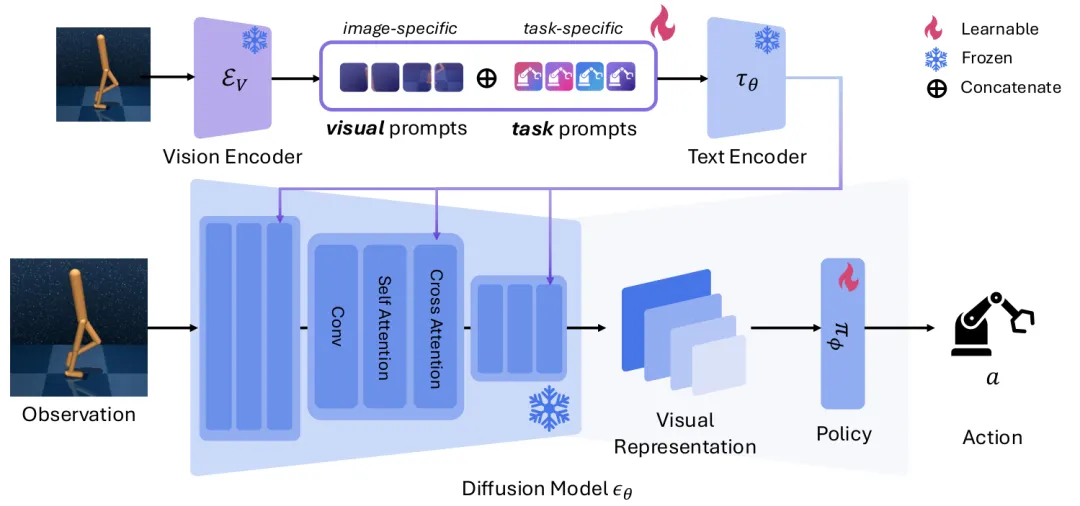
预训练文生图扩散模型包含丰富的视觉信息,如何提取其中对机器人控制有用的特征,是这篇论文关注的问题。直接使用文本条件,对部分控制任务帮助有限,甚至可能带来负面影响,论文将这一现象与预训练图像和机器人环境之间的差异联系起来。为此,ORCA在保持扩散模型主体冻结的情况下,引入可学习的任务提示与逐帧视觉提示,生成适应控制任务的视觉表示。
创新点:扩散模型+任务自适应提示学习,使预训练扩散模型提供更贴近控制需求的特征,服务于运动控制、机械臂操作和灵巧手任务。
看完这些前沿论文,相信你对具身智能与世界模型的研究方向已经有了更清晰的认识,也可以着手准备 CVPR、ICLR、AAAI、CoRL 等会议的选题与投稿。但如果你在科研过程中仍然面临方向不明确或不清楚撰写论文与选择投稿渠道,欢迎关注六纬科研。六纬科研,陪你把研究想法逐步落到实践。
扫码免费领取科研大礼包