ARTICLE · 1014620
AI4PDEs 84|不用梯度训练,小波基直接求解PDE
AI FOR SCIENCE · 第 84 期
PINN 一定要靠梯度下降吗?PIMWNN 把 PDE 训练改写成多分辨小波最小二乘
固定 Shannon 小波基、逐级补入高频、只求输出系数:看懂 PIMWNN 为什么快,以及张量积维数灾难如何把代价追回来
论文档案 · PAPER PROFILE
论文原标题Physics-informed multiresolution wavelet neural network method for solving partial differential equations
中文标题求解偏微分方程的物理信息多分辨小波神经网络方法
作者:Feng Han、Jianguo Wang✉、Guoliang Peng、Xueting Shi
第一署名单位:强脉冲辐射环境模拟与效应全国重点实验室、西北核技术研究所(西安)
发表期刊:Computer Physics CommunicationsAvailable online 9 December 2025 · Volume 320(March 2026), Article 109986
论文 DOI:10.1016/j.cpc.2025.109986
开源代码:论文注明数据可按请求提供;截至 2026 年 9 月 3 日未核验到作者公开的完整代码或数据仓库。
把“训练网络”换成“解一组系数”
❶ PIMWNN 最反直觉的地方,是它几乎不训练隐层
说到物理信息神经网络,人们通常会想到一条漫长的梯度下降轨迹:把方程残差、初边值条件塞进损失函数,再反复调整成千上万个权重。PIMWNN 走的是另一条路。它先把一套有明确频率层级的小波基固定好,让网络只负责这些基函数的线性组合;对线性偏微分方程,最后真正未知的只剩一列输出系数。
这一区别决定了它面对 PINN 两个老问题时的姿态。训练速度慢,它就尽量绕开全参数非凸优化;高频难学,它不等待网络从低频慢慢摸到细节,而是显式加入更细尺度的小波。换句话说,PIMWNN 不是让同一个黑箱更努力,而是先换掉表示解的坐标系。
粗尺度画轮廓,细尺度补纹理
❷ 多分辨分析把频率结构直接写进网络
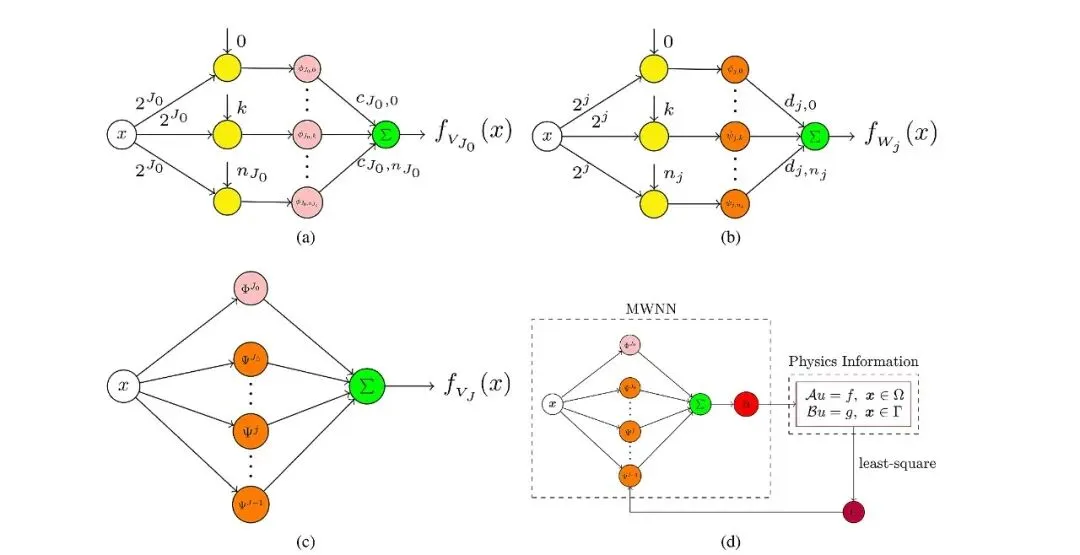
从尺度函数、小波子网到物理约束:PIMWNN 的结构源自论文 Fig. 1
Fig. 1 的前三部分展示了这套坐标系:尺度函数子网描述给定粗分辨率下的主体轮廓,不同层级的小波子网依次承接更细的局部变化,最后把所有通道求和。论文采用 Shannon 小波,因此节点的平移与缩放不是训练出来的隐语义,而是预先定义的基函数位置和频带。结构图最后一部分再把方程与边界信息接到网络输出上。
固定基上的未知解展开
û(x) = Σᵢ aᵢ θᵢ(x)
[A; B; C]a ≈ [f; g; h]
θᵢ 是预先确定的尺度函数或小波函数,aᵢ 才是待求权重;A、B、C 分别汇集方程、边界与初值在配点上的约束。
一旦未知解写成这类线性展开,线性微分算子作用在每个基函数上仍然是已知量。把所有配点的方程残差、边界值和初值排成矩阵,就得到一个通常超定的线性系统;所谓“训练”,实际是用最小二乘找到最合适的系数向量。这解释了速度从哪里来:它省掉的是隐层参数在损失地形里反复迭代的过程。
跳过梯度下降,不等于计算免费
尺度越细,基函数越多,矩阵越宽;最小二乘的内存、条件数和分解成本会随之上升。PIMWNN 把困难从非凸训练转移到了基选择和线性代数,而不是让困难消失。
“抗频谱偏置”首先是一种表示能力
❸ 每加一级尺度,频谱窗口就向高波数推进
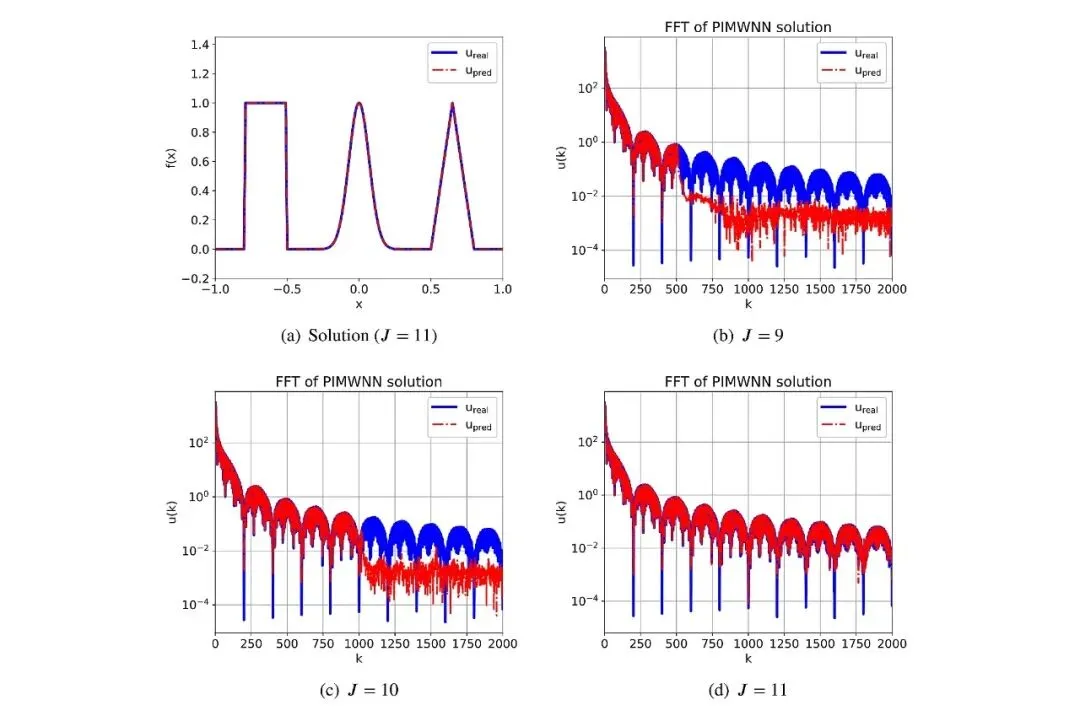
尺度逐级增加时,PIMWNN 捕捉到更高波数的频谱成分源自论文 Fig. 2
Fig. 2 用一个同时含平台、尖峰和折角的一维函数测试频率覆盖。最高尺度为 9 时,预测频谱与精确频谱大致在波数 500 以内吻合;尺度增至 10 和 11,吻合区间推进到约 1000 和 2000。对应的相对二范数误差,也就是 L2 相对误差,从 1.055×10^-2 降到 2.018×10^-4。
这组结果更准确的解读不是“小波天然消灭所有频谱偏置”,而是研究者能用尺度参数显式决定候选空间里有没有相应高频。二维高斯函数也呈现同样规律:最高尺度设为 3×3 时,论文报告 L2 相对误差 1.181×10^-7,CPU 时间约 0.050 秒。精度提升来自更丰富的基,但节点和求解成本也同步增长。
从尖峰输运到突然出现的热源
❹ 强梯度结果亮眼,但比较口径并不完全统一
在线性非稳态问题里,PIMWNN 可以把空间和时间一起当作输入,而不是先离散时间再逐步推进。复杂振荡初值与尖峰高斯初值两个输运算例,论文分别报告 9.555×10^-4 和 3.413×10^-4 的 L2 相对误差;后者用时约 0.483 秒。它说明固定多尺度基对移动尖峰和高频振荡很有吸引力。
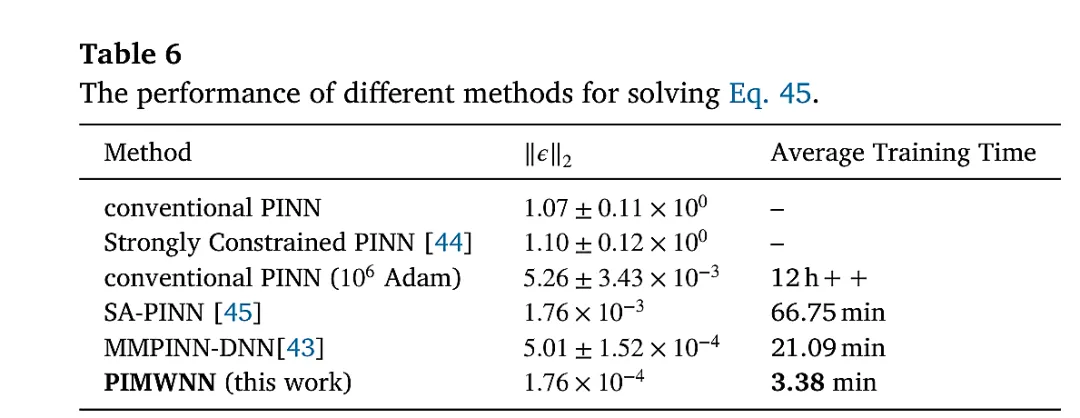
强热源大梯度:PIMWNN 的误差与平均训练时间对照源自论文 Table 6
Table 6 是文章里最醒目的效率对照。强热源在中间时刻突然制造很陡的温度梯度,PIMWNN 的误差为 1.76×10^-4,平均训练时间 3.38 分钟;MMPINN-DNN 为 5.01±1.52×10^-4 和 21.09 分钟,SA-PINN 则为 1.76×10^-3 和 66.75 分钟。就这张表而言,PIMWNN 同时占据更低误差和更短时间。
不过,这些横向数字混合了作者本机实现和文献报告的不同架构,未形成统一计算预算下的系统基准。论文虽说明实验在 Intel Core i7 2.20 GHz、16 GB 内存的笔记本上运行,却没有为所有外部方法重新跑同一代码,也没有给出多次随机重复。因此,这些结果适合证明“该实现值得重视”,还不足以建立无条件的速度排名。
非线性会把迭代重新带回来
❺ Burgers 方程不是一次最小二乘就结束
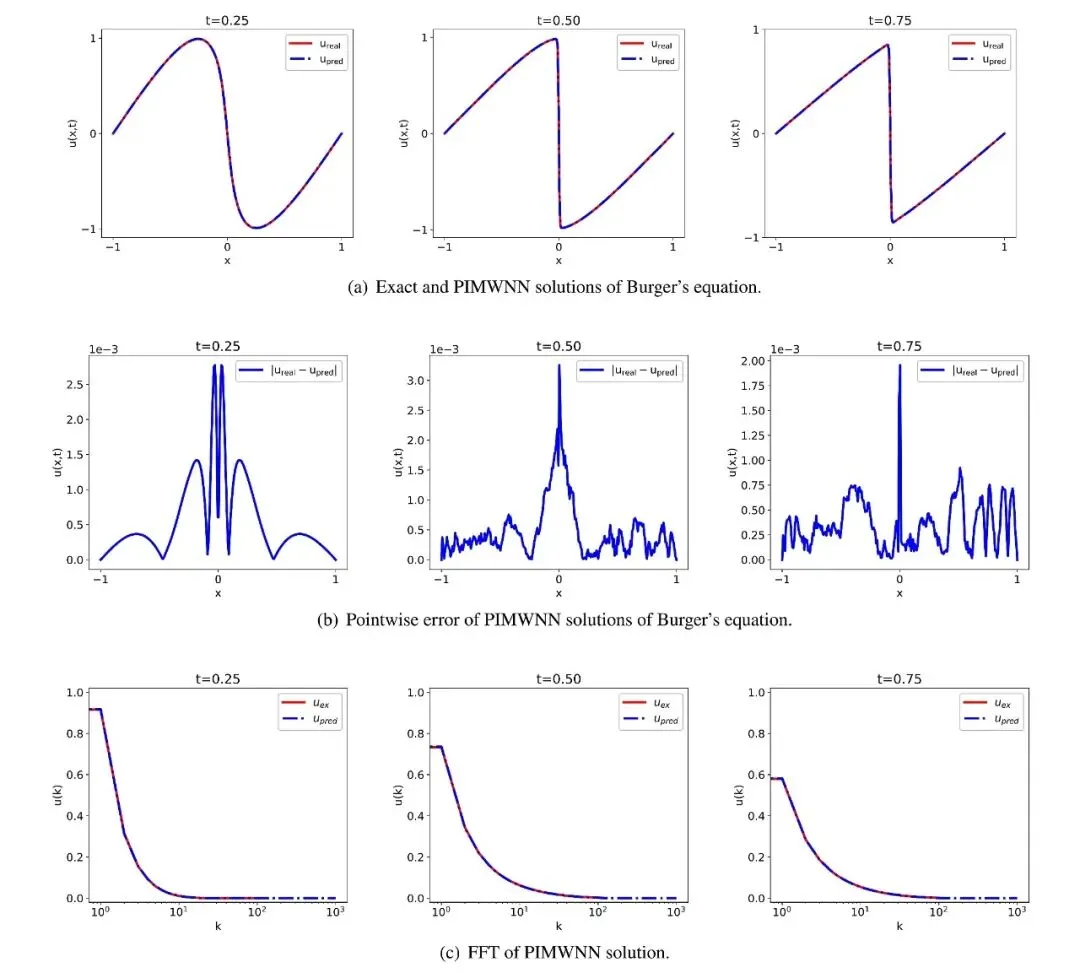
Burgers 方程:三个时刻的解、逐点误差与频谱源自论文 Fig. 15
Fig. 15 展示了 Burgers 方程在三个时刻的陡峭解形、逐点误差和频谱。论文给出的整体 L2 相对误差是 8.86×10^-4,所示时刻的误差维持在 10^-3 量级。图中预测曲线与参考曲线几乎重合,最显著的误差集中在梯度最陡的位置,这与多尺度表示需要在局部高频处投入更多基函数的直觉一致。
但这里必须收回“跳过迭代”的口号。作者先用后向 Euler 离散时间,再用 Picard 方法线性化非线性对流项;时间步长为 0.001,每一步做 10 次 Picard 迭代。PIMWNN 加速的是每个线性子问题的表示与求解,并没有把非线性本身变成一次闭式计算。
真正的瓶颈从优化转向维度与线性代数
❻ 张量积会让高维基函数迅速膨胀
多分辨小波在一维里很自然,但论文的高维构造依赖一维基的直积。维度增加后,候选基数量会组合式增长,隐层节点随之膨胀,最小二乘矩阵也出现更多列。作者明确承认,这会限制实际应用中的速度和可扩展性,并把区域分解、自适应选基和快速最小二乘列为下一步方向。
证据链还有两个需要保留的缝隙。第一,Helmholtz 算例正文写出的相对误差是 6.887×10^-2,而 Table 3 在相同最高尺度设置下列的是 2.174×10^-3,二者不能同时作为最终结果。第二,现有实验以低维制造解和既有基准为主,没有报告矩阵条件数、三维规模、噪声逆问题或随机重复。数据也仅注明按请求提供,未核验到公开完整实现。
因此,PIMWNN 最稳妥的定位是一种结构化的物理基函数法:它借用神经网络的表达框架,却把可解释的多尺度基和线性求解放到核心位置。对低维、频率丰富且可用配点稳定约束的问题,它可能比通用深网络更直接;对高维、多物理、逆问题或强噪声场景,基的选择、线性系统稳定性和尺度自适应仍需新的证据。
AI 模拟审稿
如果把它当作一篇多尺度 PDE 求解方法论文
① 优点方法机制清楚且有解释性:固定 Shannon 多分辨基负责频率覆盖,物理约束负责确定系数,线性问题最终落到最小二乘。论文用稳态、非稳态、强梯度和非线性算例展示了同一框架的广度。
② 局限张量积基在高维会快速膨胀,最小二乘系统的条件数和内存代价没有系统分析;部分基线来自不同文献与配置,Helmholtz 误差还存在正文和表格不一致,现有证据不足以支持普遍速度优势。
③ 下一步启示最值得推进的是区域分解与自适应选基:让局部简单区域停留在粗尺度,只在尖峰、界面和高频处增加小波;同时报告条件数、统一墙钟时间、多随机重复,并扩展到三维、噪声逆问题和真实多物理数据。
关注智核学术 · 看懂方法背后的问题
免责声明:本文为第三方学术解读,并包含 AI 辅助整理与 AI 模拟审稿,仅供学术交流;不构成正式同行评审、工程验证或决策依据。文中观点不代表论文作者、所属机构或期刊立场,论文事实与数据请以原文为准。