ARTICLE · 1014832
逐页喂 PDF、生成可追溯知识库:这款 PDF 阅读神器 GitHub 爆火
一、开篇:500 页的技术书,你啃到第几页就放弃了?
书架上躺着《深入理解 Java 虚拟机》《Designing Data-Intensive Applications》《算法导论》——每一本都是几百页起步的硬核大部头。翻开目录,看完前三章就劝退;收藏进「以后再读」文件夹后,这个「以后」通常不会来。
更扎心的是,你可能花了一周读完 500 页,真正能被记住、能讲给别人听的核心知识点,不到全书 5%。这正是很多人阅读专业书的真实写照:投入大量时间,回报却不成比例。
echohive42/AI-reads-books-page-by-page 这个 GitHub 上斩获 2669 Stars 的项目,用一种工程化思路正面回应了这个问题:让 AI 像一个耐心的阅读助手,逐页拆解 PDF,把知识点按页累积成结构化知识库,并按设定间隔产出渐进式摘要。
二、项目定位:让 AI 替你读完 500 页
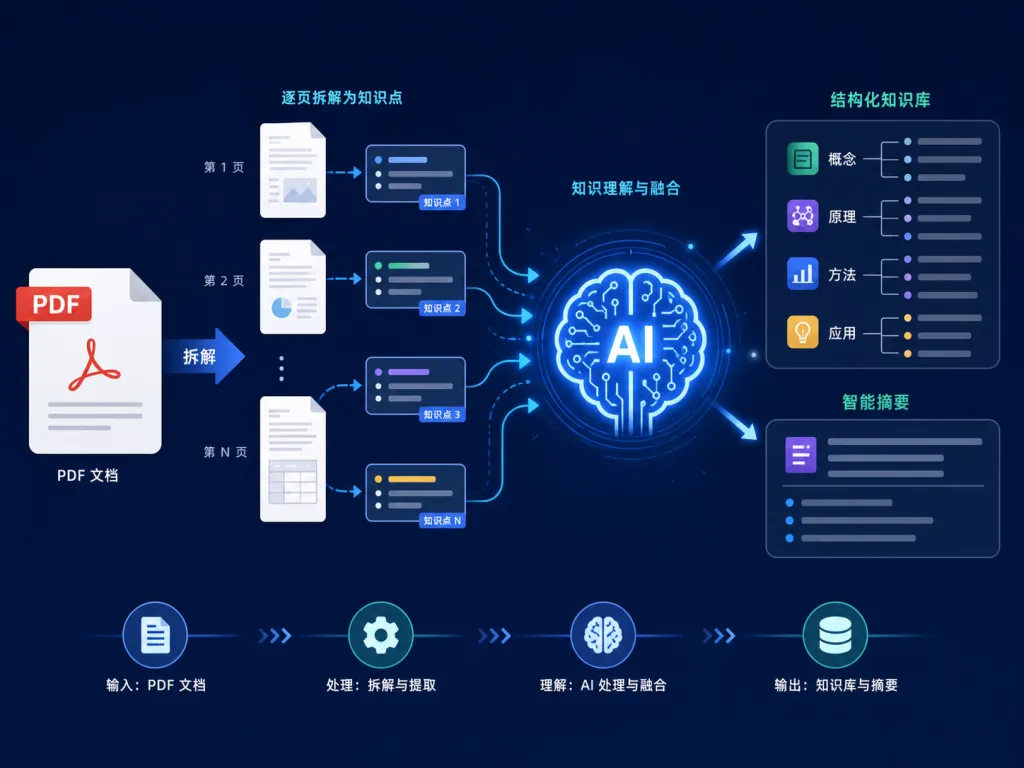
这个项目本质上是一个逐页 PDF 知识抽取与摘要工具,基于 Python 构建。它把传统意义上「读完一本书」这件事,拆解成三个可量化的工程动作:逐页提取知识点、累积成结构化知识库、按间隔生成摘要。
几个关键词定义它的核心定位:逐页处理(page-by-page)、知识库持久化(persistent knowledge base)、渐进式摘要(progressive summary)。它不是简单的「PDF 转 TXT」工具,而是把每页内容送进大模型,提炼出真正的知识点,再把它们组织成可追溯、可复用的资产。
项目当前已收获 2669 Stars,对一个专注于「读书」这一垂直场景的工具来说,这个数字说明它确实戳中了一群人长期被忽略的阅读痛点。
三、核心功能深度解析
1. 逐页知识点抽取
这是整个工具的基石。脚本调用 OpenAI API,对 PDF 每一页单独发送分析请求,返回一个 Pydantic 结构化对象 PageContent,包含 has_content(页面是否含有有效内容)和 knowledge(该页提取出的知识点列表)。
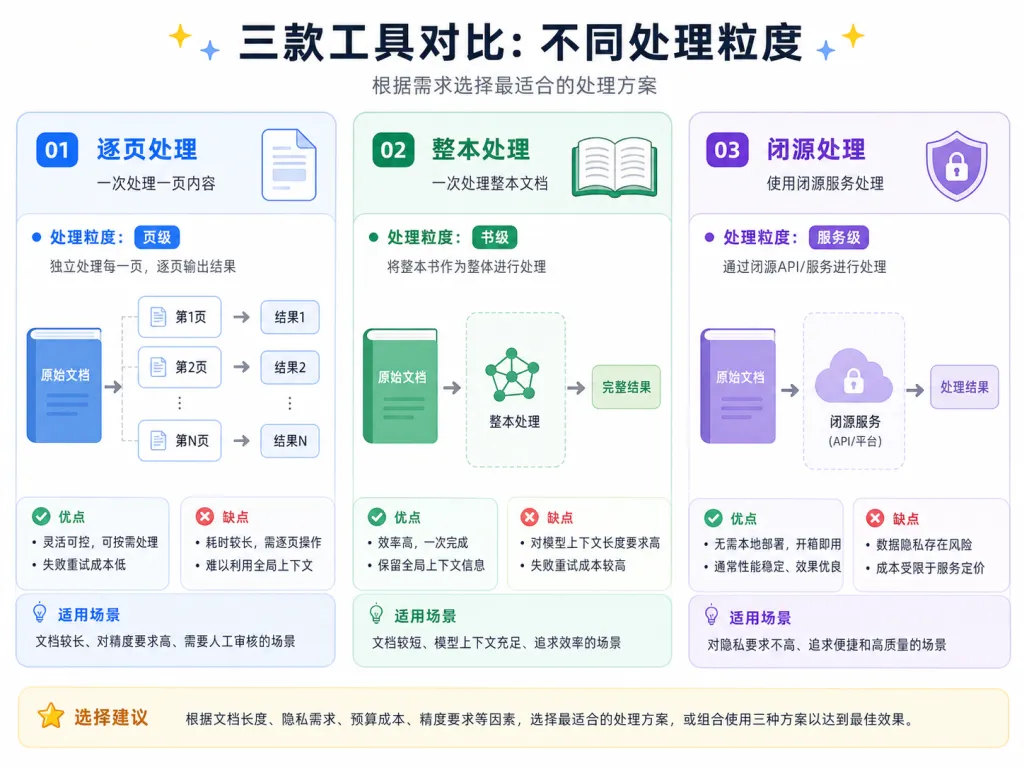
对比传统摘要工具的「整本书一次性喂给模型」,逐页处理有三个明显优势:一是不会因为上下文窗口超限而丢失内容;二是每页的提取结果都可以独立校验和追溯;三是遇到目录、索引、空白页这种「无效内容」可以自动跳过,不污染知识库。
2. 持久化知识库
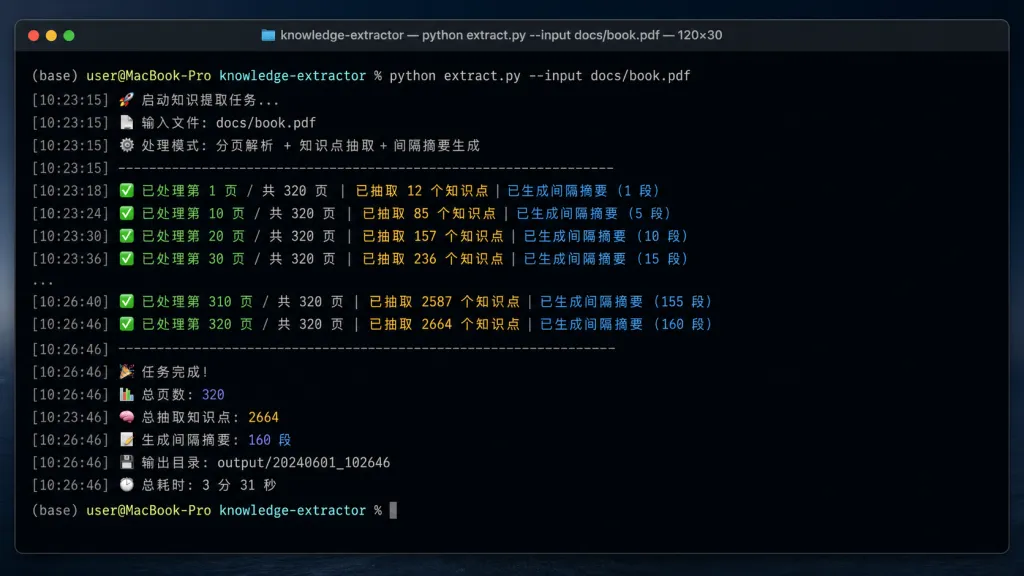
脚本在 book_analysis/knowledge_bases/ 目录下维护一个 JSON 文件,把每一页抽取出的知识点持续累积。每处理完一页就立即落盘,这就是项目 README 里强调的「Resume capability」:如果你中断了程序,下次运行会从已有的知识库继续,不会重复处理、也不会丢失进度。
这个设计非常工程化——它把「读书」这个行为变成了一种可暂停、可恢复、可增量更新的数据流任务。
3. 间隔摘要与最终摘要
通过配置 ANALYSIS_INTERVAL(例如设为 10),脚本每处理 10 页就基于当前累积的知识库生成一次阶段性摘要;处理完全书后,再生成一份全局摘要。所有摘要都以 Markdown 格式保存到 book_analysis/summaries/目录,命名规则自动区分「interval」和「final」。
这相当于给你一份「滚动目录」:你可以每隔 10 页就看到一次「读到现在为止,这本书讲了什么」,而不是非要等到读完才能回忆。
4. 智能内容过滤与彩色终端
脚本会自动识别目录页、索引页、参考文献页这类无实质内容的页面,跳过它们以避免浪费 API 调用和污染知识库。同时,终端输出使用 colorama 进行彩色高亮,关键进度信息一眼可见。
四、技术亮点与性能数据
从架构角度看,这个项目有几个值得关注的设计选择:
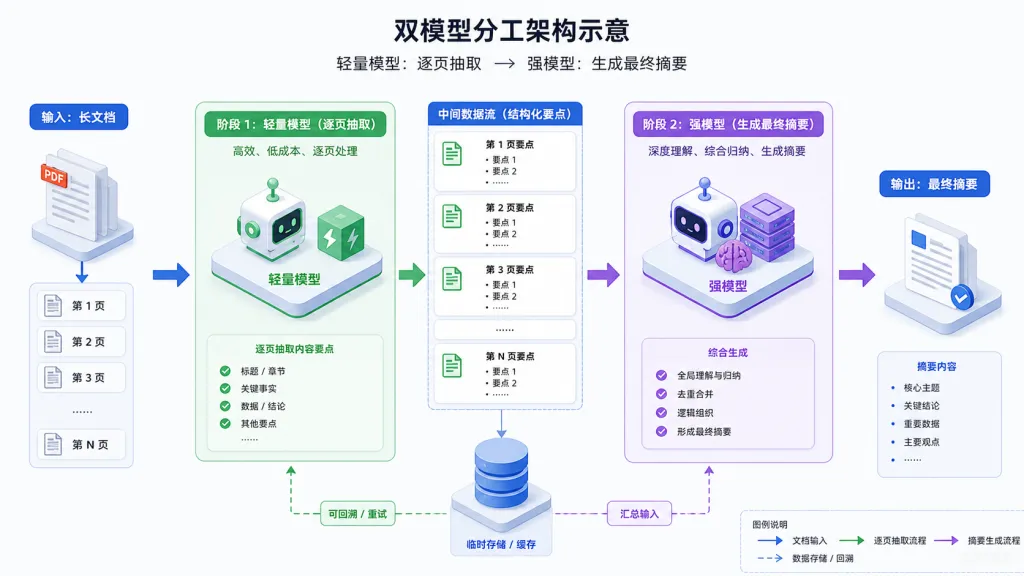
双模型分工。项目允许通过 MODEL 和 ANALYSIS_MODEL 分别配置「逐页分析」与「整体摘要」所使用的模型。这意味着你可以在逐页抽取时用速度更快的模型降低成本,在生成最终摘要时切换到更强的模型保证质量——这是一个典型的「按任务分层调度」思路。
测试模式。通过设置 TEST_PAGES=5,你可以只让脚本处理前 5 页快速验证流程,跑通再放开到全书。这个细节对调试 LLM 应用非常关键。
结构化输出 + 校验。所有 API 返回值都用 Pydantic 模型约束,类型错误会立刻抛异常,而不是把脏数据悄悄写进知识库。
生态兼容性。项目依赖 pypdf、openai、pydantic、colorama 这几个主流 Python 库,对 Python 3.8+ 友好,部署到任何云函数或本地环境都没有额外门槛。
五、适用场景与人群
场景一:技术书速读与知识沉淀。读《系统设计面试》这类 300+ 页的英文技术书时,让脚本先跑一遍生成知识库和摘要,再针对薄弱章节精读,效率提升肉眼可见。
场景二:研究论文批量处理。把多篇论文 PDF 灌进同一套流程,可以快速建立某个研究方向的结构化知识库。
场景三:构建个人 RAG / 第二大脑。输出的 JSON 知识库和 Markdown 摘要可以直接喂给向量数据库,配合检索增强生成(RAG)做成可对话的「私人读书助手」。
适合谁:需要长期啃硬核书的技术人、研究者、AI 应用开发者。不适合谁:只想快速看个乐呵的休闲读者,以及对调用 OpenAI API 成本敏感又没有 API Key 的用户。
六、竞品对比
| AI-reads-books-page-by-page | ||||
相比之下,这个项目胜在「可审计、可定制、可扩展」:你能清楚看到每一页抽出了什么知识,能用任何兼容 OpenAI 协议的模型替代,能把输出直接接入自己的下游系统。
七、如何快速上手
克隆仓库并安装依赖:
git clone https://github.com/echohive42/AI-reads-books-page-by-page
cd AI-reads-books-page-by-page
pip install -r requirements.txt
配置环境变量:在项目根目录创建
.env,写入OPENAI_API_KEY。修改
read_books.py顶部的常量:PDF_NAME:你的 PDF 文件名ANALYSIS_INTERVAL:每多少页生成一次摘要,建议设为 10TEST_PAGES:先设为 5 跑通流程运行
python read_books.py,观察终端彩色进度输出,去book_analysis/summaries/查看生成的摘要。
进阶建议:跑通后把 MODEL 换成更便宜的 gpt-4o-mini 处理逐页任务,ANALYSIS_MODEL 保留 gpt-4o 用于最终摘要,可以在几乎不损失质量的前提下砍掉一半 API 成本。
八、总结与行动建议
echohive42/AI-reads-books-page-by-page 的核心价值在于:它把「读一本厚书」这件很多人做不到的事,变成了一条可工程化、可追溯、可复用数据的流水线。2669 Stars 的背后,是一群被「读完就忘」折磨已久的人,终于找到了一种让 AI 真正分担阅读负担的方式。
如果你书架上正躺着一本「买来就没读完过」的书,建议现在就克隆这个项目,先用 TEST_PAGES=5 跑通流程,再放开到全书。
链接:https://github.com/echohive42/AI-reads-books-page-by-page。
值得一试的理由只有一个:你不再需要假装自己会读完整本书。
#ai-reads-books-page-by-page #AiReadsBooksPageByPage #echohive42 #数据库 #DevOps #容器化 #开源项目 #GitHub