ARTICLE · 1014833
企业做AI知识库,到底该选公有云API还是自建私有化大模型?

企业在推进 AI 知识库与 RAG(检索增强生成)系统落地的过程中,模型选型(Model Selection)是决定整个技术架构生命周期与总拥有成本(TCO)的核心决策点。
市场主流的两种路线——公有云商业 API(如 OpenAI、Claude、DeepSeek Cloud)与开源私有化部署大模型(如 Llama 3、Qwen 2.5 系列私有化部署)——并非简单的“便宜与否”或“安全与否”的单维选择,而是涉及数据合规、算力吞吐、响应延迟、定制化能力与运维工程复杂度的多维系统工程权衡。
一、 两种选型路线的底层架构与流水线对比
两种选型在架构层面构成了截然不同的数据流向与技术栈依赖。
1. 公有云 API 架构流水线
数据流出企业边界,依赖公有云服务商提供的托管推理 Endpoint。
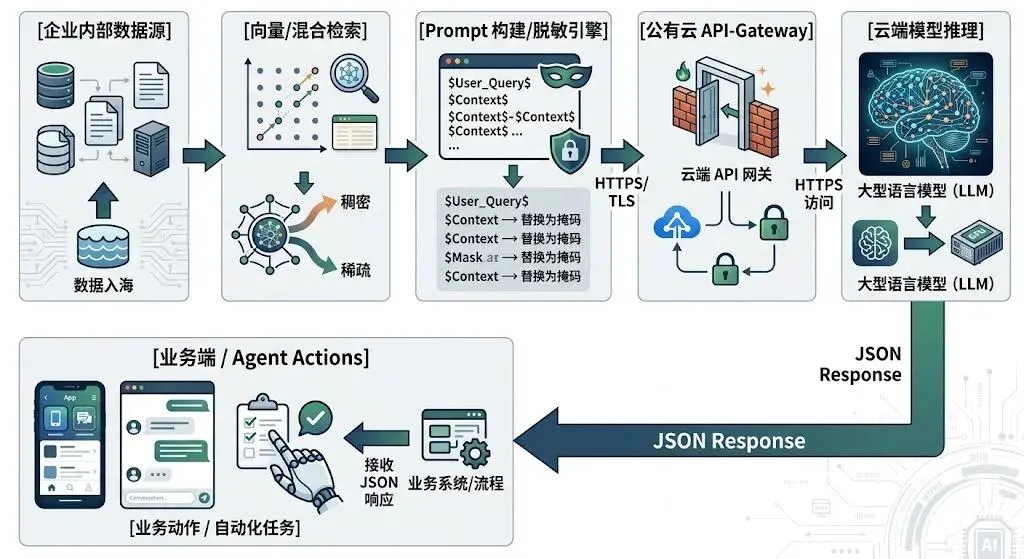
技术栈:侧重于前端 RAG 数据管道(ETL)、Prompt 工程、Context 剪裁与客户端重试机制。
架构特点:免运维算力集群,架构轻量,但对外网带宽、网络抖动(Jitter)及服务商 SLA/限流(Rate Limit)有强依赖。
2. 私有化部署大模型架构流水线
数据全程保留在企业 VPC / 本地内网,自建算力与推理服务。
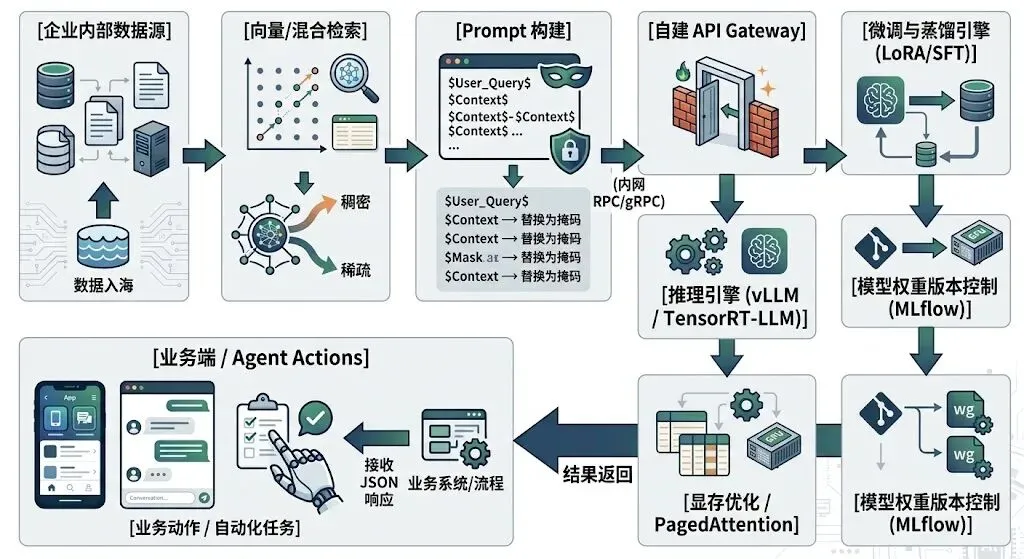
技术栈:需构建完整的 MLOps/LLMOps 体系,涵盖 vLLM / TensorRT-LLM 推理加速、PagedAttention 显存管理、Continuous Batching 调度、LoRA 微调流水线。
架构特点:数据零外流,网络延迟极低,但技术栈极深,固定算力成本与工程运维门槛极高。
二、 多维评估矩阵(Evaluation Matrix)
在进行架构选型时,建议从以下 7 个关键技术指标进行多维对齐与综合评估:
| 评估维度 | 公有云 API 路线 | 自建私有化大模型路线 | 架构权衡建议 |
| 数据安全与合规 (Security) | 数据需经过加密传输至外网。虽然服务商承诺“不用于训练”,但仍难以通过绝大多数金融/政企的数据不出域/专网隔离合规审计。 | 数据与权重完全收敛在企业 VPC / 本地内网,天然满足等保三级及最高级别的合规审计要求。 | 核心红线:若存在绝对的“数据禁出国/禁出域”法规要求,直接选私有化。 |
| 知识推理与复杂指令能力 | 顶级闭源模型(如 GPT-4o / Claude 3.5)拥有极高参数量,在复杂逻辑推理、长文本多跳检索、JSON Schema 强约束输出上处于顶尖水平。 | 7B-70B 参数级的开源模型在通用推理上弱于顶级闭源模型;但在特定领域(如特定格式抽取、专业术语理解)可通过 SFT/蒸馏 追平。 | 依赖高阶泛化推理选 API;业务场景集中、逻辑固定选私有化微调。 |
| 时延与吞吐性能 (Latency & Throughput) | 受公有云网络 RTT 及多租户资源争抢影响,首 Token 延迟(TTFT)与生成延迟波动态势明显,并发受到 RPM/TPM 限流。 | 内网 RPC 传输(微秒级),搭配 TensorRT-LLM / vLLM 的 PagedAttention 技术,可实现极低且稳定的 TTFT 和高吞吐并发。 | 对实时响应、高并发 (QPS > 100) 的系统,私有化部署具有确定性优势。 |
| 上下文窗口有效性 (Context Retention) | 支持 128K 至 1M+ 超长上下文,但在长文本“中间失忆(Lost in the Middle)”问题上仍依赖服务商底座能力。 | 受显存(VRAM)物理限制,通常设置 8K - 32K 窗口。虽然可扩展,但显存开销随上下文长度成二次方或线性暴涨。 | 依赖超长 Context 选 API;私有化路线更适合配合精细化 Chunking 与 Rerank 控制 Context 长度。 |
| 定制化与可控性 (Customization) | 仅能进行 Prompt 工程或云端 Fine-tuning。无法调整模型采样底层机制、注意力掩码或自定义 Tokenizer。 | 完全掌控全链路:可自定义 Tokenizer、灵活挂载 LoRA 适配器、调整 Logits 概率分布,甚至针对特定领域自建 Pre-train/SFT。 | 需要深度改造模型底层行为或私有领域语言特化时,必须私有化。 |
| 工程运维门槛 (MLOps Complexity) | 极低。仅需要 API Key 管理、客户端熔断重试与 Token 用量监控。 | 极高。需要精通 GPU 显存调度、集群拓扑(NVLink/ InfiniBand)、模型量化(AWQ/FP8)、推理引擎调优及硬件故障自愈。 | 无专业 MLOps/基础设施运维团队的企业,切勿轻易尝试大规模私有化集群。 |
| 成本结构 (TCO) | 完全可变成本(OPEX):按 Token 计费。低 QPS 场景下极具性价比;高 QPS 持续并发时 Token 成本将呈线性暴涨。 | 高固定成本(CAPEX):昂贵的 GPU 硬件采购/租赁 + 7×24 小时空载电费 + MLOps 人力成本。高 QPS 下边际成本趋近于零。 | 计算拐点:当每日消耗 Token 数极其庞大,且 GPU 利用率持续保持高位时,私有化 TCO 才会优于 API。 |
三、 混合架构(Hybrid Architecture):企业落地的终极形态
在真实的生产环境中,单一路线往往难以同时满足“敏感数据合规”与“复杂逻辑推理”的双重需求。企业级 AI 知识库的演进方向通常是分层治理的混合架构(Hybrid Gateway Architecture)。
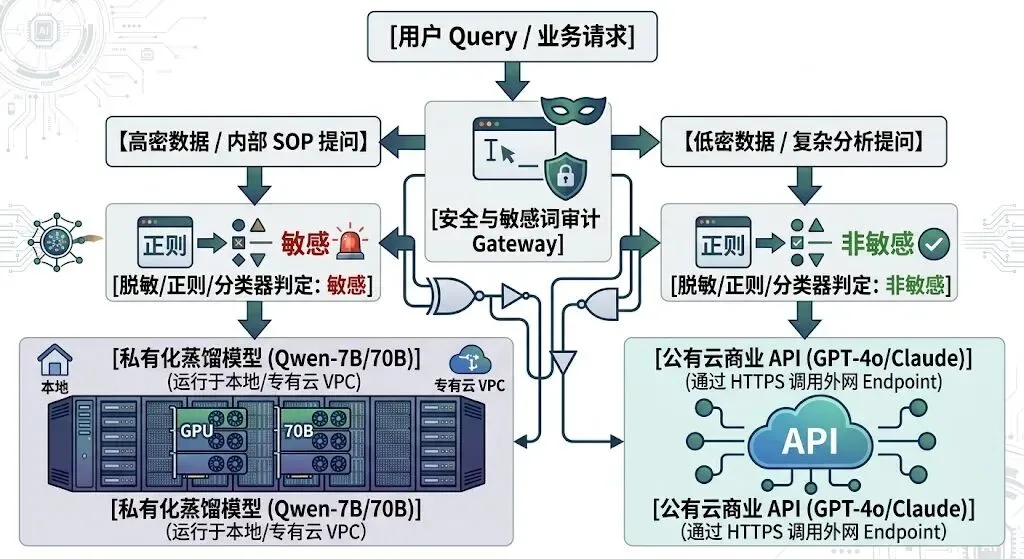
流量分流网关(Traffic Router):在 RAG 检索链路前置 API 网关,根据数据安全等级(Data Classification)对 Query 进行动态分类。
敏感/高密知识库:涉及核心技术源码、财务数据、人事档案的问答,路由至本地部署的精简参数模型(如 7B/14B + SFT),确保绝对安全与极低延迟。
公开/复杂逻辑分析:针对非敏感信息的长文档归纳、跨领域复杂推理,路由至公有云顶级 API,利用其强推理能力保证生成质量。
总结
企业在选择大模型路线时,应当脱离单纯的技术崇拜,回归数据边界、QPS 规模与团队工程能力的客观评估:
选公有云 API:适合数据合规要求灵活、业务处于探索期、QPS 较低且缺乏 MLOps 运维能力的企业,用最小代价换取顶尖推理能力。
选私有化部署:适合数据合规要求极其苛刻(金融/政企/军工)、业务场景高度聚焦、QPS 极高且具备硬件运维能力的企业。
选择混合架构:是绝大多数中大型企业在安全、性能与成本三者之间取得最佳平衡的终极工程解法。
如果你也在做同样的事,欢迎在留言区详聊;
欢迎关注寒渊(Hyen)公众号。