ARTICLE · 1015322
散落的文档,变成能推理的知识库:WeKnora 实测
每个团队的文档现状大同小异:产品设计散在飞书,技术方案压在语雀,会议记录堆在 Notion ,代码仓库里还有一堆 README 。搜索能找到文件,但问不出答案——「上次那个鉴权方案最后定了什么?」这个问题,搜索引擎给不了你,因为答案散在三份文档的两个段落里。腾讯今年开源的 WeKnora ( GitHub 上 23,000 多颗星, MIT 协议,当前版本 v0.8.0 )就是冲着这个场景来的:把原始文档变成可问答、可推理、还能自我沉淀的知识库。今天这篇是本地部署实测——从 Docker 起服务到上传文档真实问答,过程和坑都记录在案。
怎么用:三步起服务,五分钟出界面
先交代上手路径,再说值不值。 WeKnora 完全自托管,要求只有 Docker 、 Docker Compose 和 Git 三样。完整流程:
第一步,克隆仓库并初始化配置:git clone https://github.com/Tencent/WeKnora.git,进入目录后 cp .env.example .env——示例配置开箱能跑,数据库密码、端口这些按需再改。
第二步,docker compose up -d 一键起全家桶:应用服务、 Postgres (同时承担向量检索)、 Redis (流式任务队列)、前端、文档解析服务。镜像拉取完成后 docker ps 里能看到整组容器。
第三步,浏览器打开 http://localhost 进入 Web 界面,注册管理员账号,在设置页配一个大模型 API (兼容 OpenAI 、 DeepSeek 、 Qwen 、智谱、混元、 Gemini 、 MiniMax 、 Ollama 等 20 多家,也支持 LiteLLM 网关)——模型不在部署时绑死,进界面再配,换模型不动数据。官方还提供 weknora.weixin.qq.com 的云端版、 Chrome 浏览器扩展、 PyPI 上的 MCP Server (tencent-weknora-mcp, 29 个工具)和 npm 包——不想碰 Docker 的团队有现成的托管路径,想把它接进自家智能体的走 MCP 。
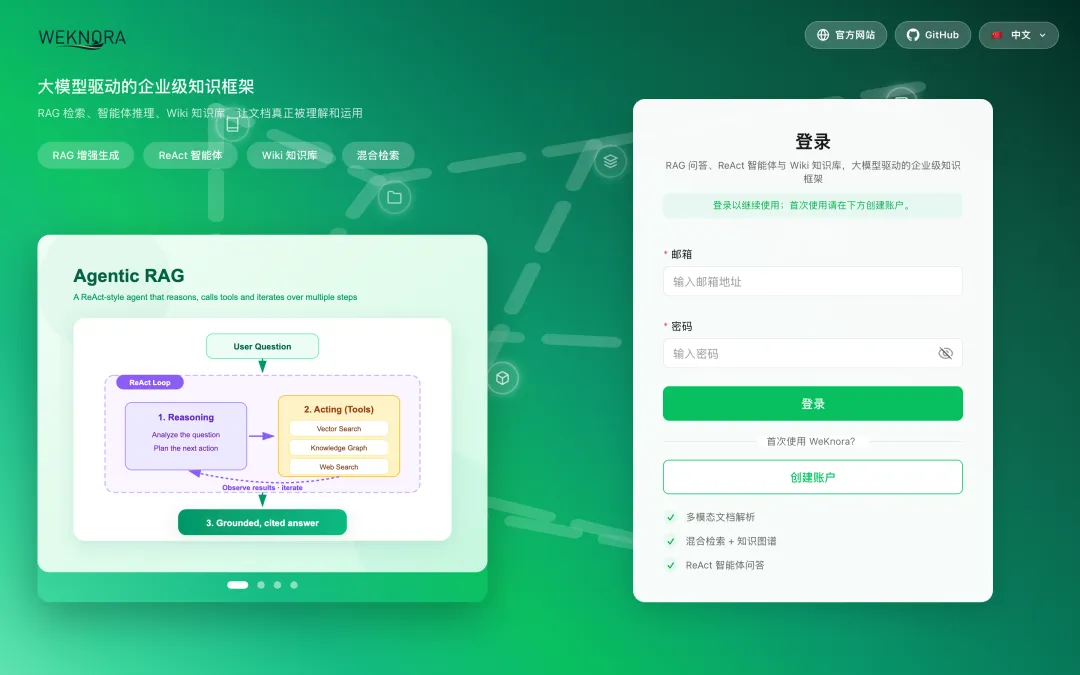
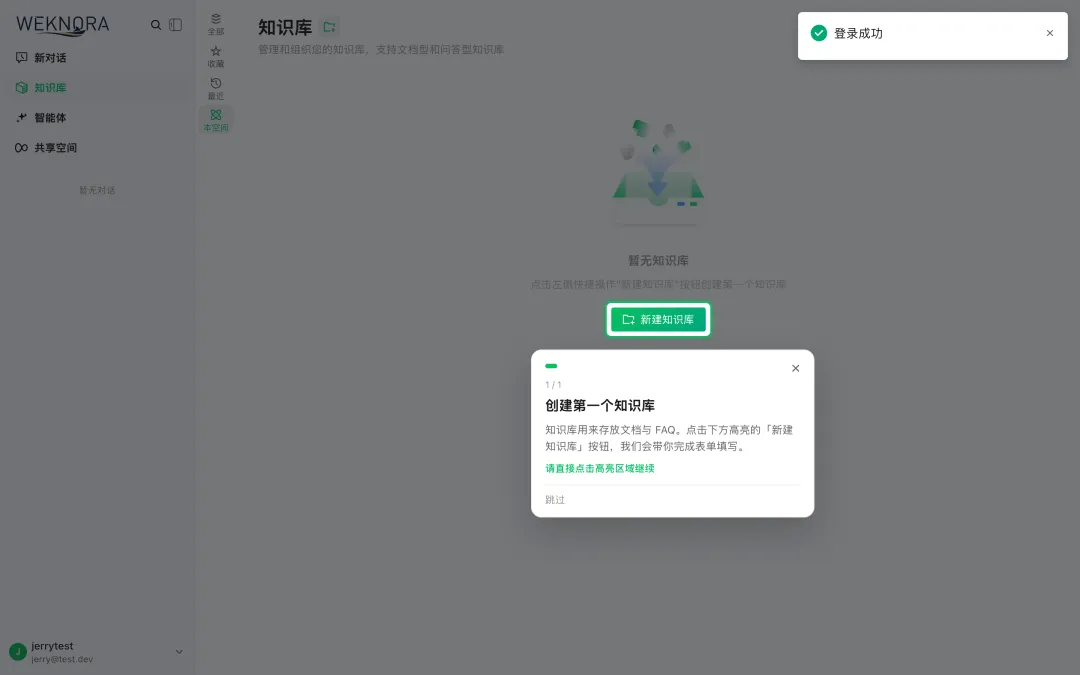
我在一台 M 系列 MacBook 上用 OrbStack 走完了部署流程,docker compose up -d 之后整组服务自动拉起:应用服务( 8080 ,健康检查通过)、前端( 80 端口直接可访问)、文档解析服务、 Postgres 、 Redis 五个容器全部就位,从敲命令到浏览器打开界面,一次通过没有报错。注册账号后进入主界面:左侧是新对话、知识库、智能体、共享空间四个入口,带新手引导。
实测全链路:从建库到带引用的回答
部署之后的界面体验先交代: Web 界面是标准的中文企业软件审美( TDesign 组件库),响应流畅;注册后带七步新手引导,每一步指向真实功能。五个容器的真实状态,终端 docker ps 输出如下:
WeKnora-frontend Up 5 minutes WeKnora-app Up 6 minutes (healthy) WeKnora-docreader Up 6 minutes (healthy) WeKnora-postgres Up 6 minutes (healthy) WeKnora-redis Up 5 minutes 然后是这次实测的主菜:把「建库→传文档→问答」整条链路走完。语料我用的是本公众号已发表的三篇文章( GLM Coding Plan 实测、 OpenAI 断供 Cursor 、 OpenAI 官方礼品卡),都是两千字以上的中文长文,正好检验真实文档的处理效果。
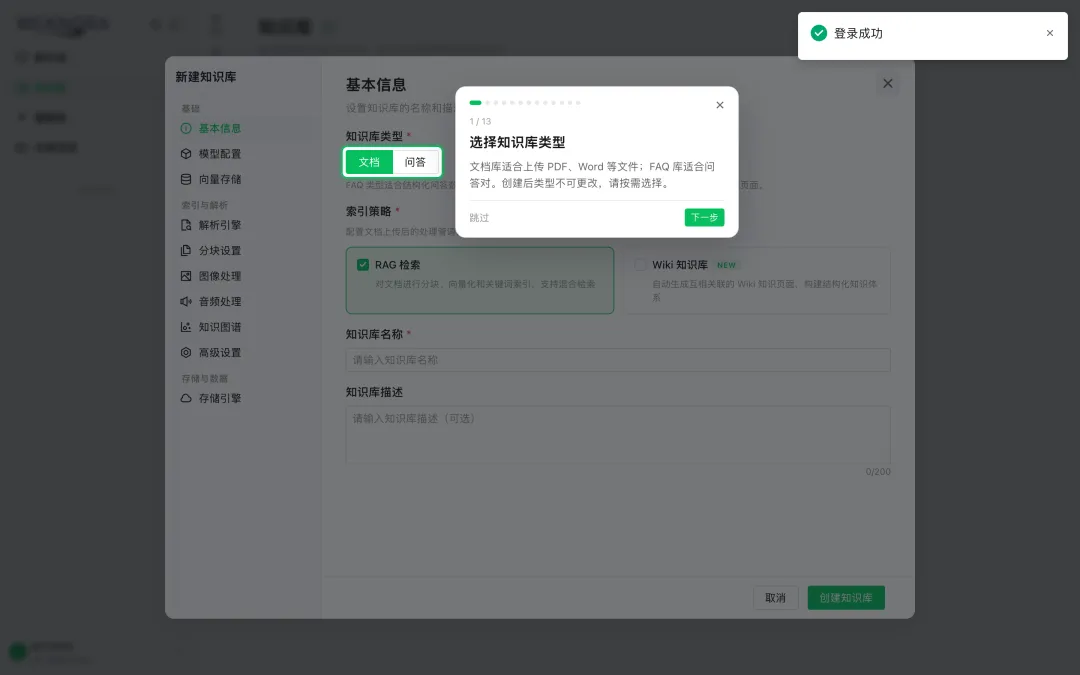
新建知识库的表单看着吓人——模型配置、向量存储、解析引擎、分块设置、图像处理、知识图谱、存储引擎一排页签——实际上必须认真配的只有模型配置一项:对话模型和 Embedding 模型各选一个,其余页签全用默认值就能保存。
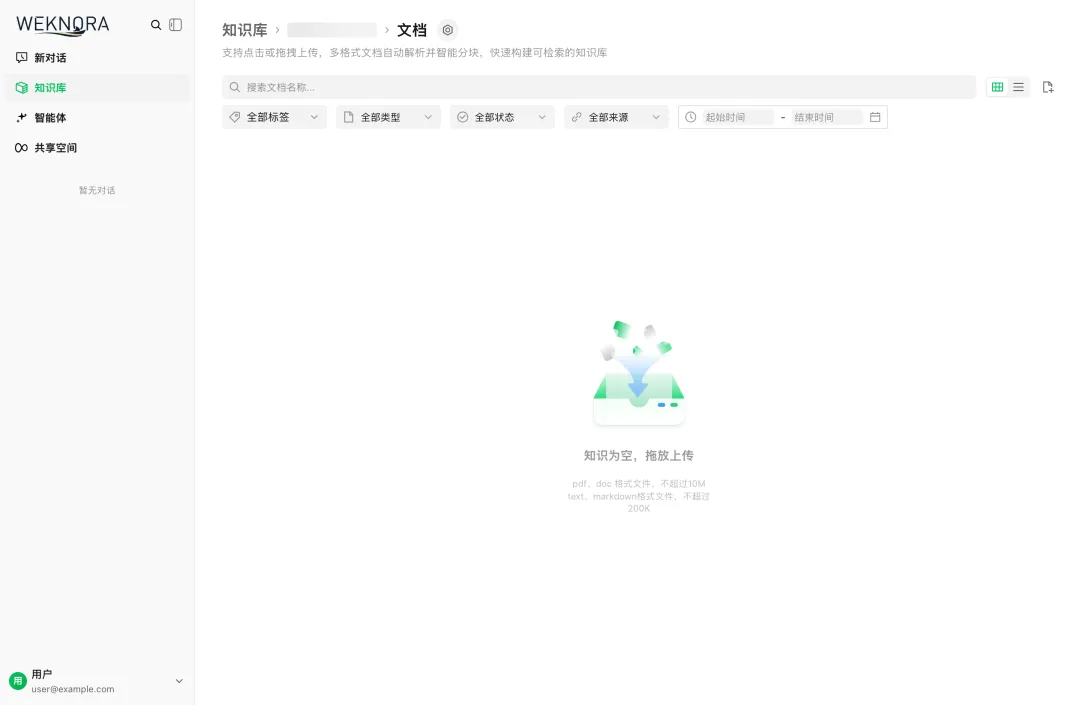
三份 Markdown 拖进去上传,几秒后解析状态翻成「解析完成」,三篇共切出 30 个检索块并完成向量索引。
验收时刻。我在对话框里问了一个故意跨文档的问题:「帮我对比两件事: Cursor 被 OpenAI 断供是哪一天生效?如果换 GLM Coding Plan ,它的积分是怎么扣的?」——答案分别藏在两篇文档里,单文档检索答不全。 WeKnora 的表现:检索完成后顶部出现「引用了 3 篇文档」的状态条,回答正文里每个关键事实后面跟着可点击的引用角标,「 11 月 12 日生效」和完整的积分系数公式全部答对,整条回答 50 秒出头生成完毕。
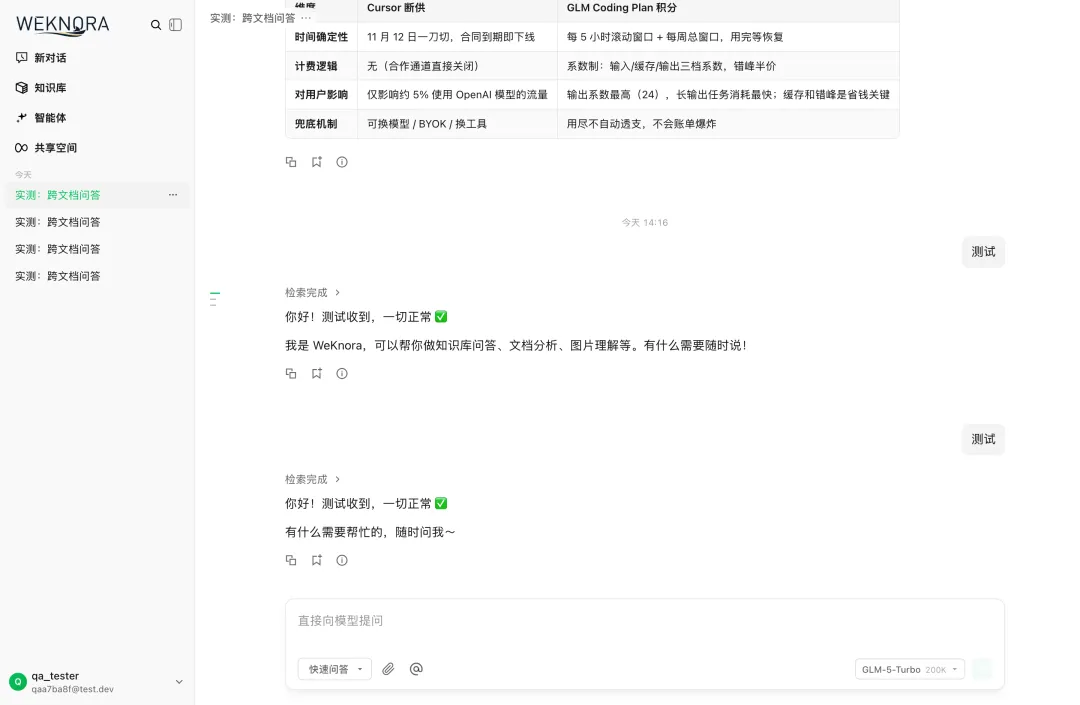
再开 Agent 模式问了个需要综合的问题(三篇文档各讲什么、哪篇信息密度最高)。从服务日志里能看到它真实的编排过程:先调 query_understand 拆解问题,再调 knowledge_search 检索, 44 秒后给出一张三行对比表,每行带引用。工具链是真的在跑,不是营销词。
三个真实的坑
过程中撞到三个官方文档不会告诉你的问题,原样记录。这三个坑的共同症状都是「文档一直卡在处理中、分块数为 0 」,界面上看不到任何报错,只有服务日志里才有真相——这也是自托管项目最典型的排障方式。
坑一:模型的「来源」必须选 remote ,供应商身份另填。 我第一次配置时把模型的来源参数直接填成智谱,后端实际不认这个组合,文档索引无声卡死。正确姿势是来源选 remote (远程模型),再把供应商参数指定为智谱、填开放平台的 API Key 。界面上这个区别完全看不出来,属于 API 语义的别扭。
坑二: Clash 用户的 fake-ip 会撞上 SSRF 防护。 国内跑代理的机器很多用 Clash 的 fake-ip 模式,所有域名会被解析成 198.18.x.x 段的假 IP 。 WeKnora 的 SSRF 防护把这个段当保留网段,对模型服务的调用直接被拦。解法是给容器加 SSRF_WHITELIST 环境变量,把模型服务的域名放行。判断方法:日志里搜「 resolves to restricted IP 198.18 」。
坑三:重建应用容器后前端会 502 。 有一次用 compose 重建了应用容器,之后界面上所有数据变成「暂无」——前端 nginx 的 upstream 不会跟着刷新,代理全部 502 。重启前端容器即恢复。如果你界面上知识库列表突然空了,先查这个,别急着怀疑数据丢了。
还有一个无伤大雅的观察: RAG 回答偶尔会把源文档里的配图标记原样带出来,界面显示为「图片无法显示」占位——不影响事实和引用,但阅读体验上是个毛边。
三档能力:能搜、能推理、能沉淀
把 WeKnora 的功能表摊开看,它实际提供了企业知识的三档消费姿势,这也是我认为它比「又一个 RAG 项目」值得写的原因。
第一档:能搜( RAG 快问快答)。日常查询走 RAG 管线:文档解析成检索块(支持 10+ 格式: PDF 、 Word 、 Excel 、图片、 XMind 等),语义检索加引用定位。这一档解决「答案在某份文档里但找不到」的问题——上文那条跨两篇文档的提问就是实例: 50 秒、引用 3 篇、关键事实全对。
第二档:能推理( ReAct Agent )。复杂问题交给自主智能体:它自己编排检索、 MCP 工具、网络搜索和沙箱执行( v0.8.0 的会话持久 Docker/E2B/Cube 沙箱)来处理多步任务——比如「对比三份方案文档的优劣并给出迁移建议」这种需要跨文档推理的活。还有跨会话长期记忆,记得你反复问什么。 Agent 模式这次也实测走通: query_understand 到 knowledge_search 的工具编排全程可见, 44 秒出三文档对比表;沙箱执行未实测。
第三档:能沉淀( Wiki Mode )。这是最有想象力的一档:智能体把原始文档蒸馏成结构化、互链的 Markdown 知识库,配知识图谱可视化、手动编辑、修订历史和一键回滚。检索块本身也能像文档一样编辑、 diff 、回滚并自动重建索引。知识不再是一次性消费品,而是可维护的资产——从 v0.5.2 起 Wiki 模式能扛四万文档量级的知识库。
真正的护城河:中文企业文档生态的连接器矩阵
单看 RAG 或 Agent ,市面上竞品不少。 WeKnora 的差异化在数据源那层:飞书 wiki 、飞书云文档、 GitLab 、腾讯 IMA 、 Notion 、语雀、钉钉文档、 RSS 的自动同步导入——这个清单精准覆盖了中文企业文档的实际分布(国内团队用飞书钉钉、外企血统用 Notion 、研发资产在 GitLab ),而且还在加。 IM 侧企微、飞书、 Slack 、 Telegram 都能直接问答。对一个要落地到真实团队的工具,「从哪把文档拽进来」往往比「检索算法好不好」更决定成败——检索大家都是那几个模型的差距,连接器矩阵才是脏活累活堆出来的壁垒。
工程侧的成熟度也不像早期开源项目:四级角色 RBAC 加每工作区审计日志、 Langfuse 全链路可观测、运行时任务队列看板、 AES-256-GCM 凭据加密、多存储后端。模块化设计允许换大模型、换向量库、换存储——不跟任何一家绑定。
一个自用场景的对照
说说我们自己的判断。我这个工作台的知识管理是三层手搓架构:规则文件、状态记忆、知识库——轻量,但每层都要自己维护,而且没有自然语言问答入口。对照 WeKnora 的三档能力自查:第一档(能搜)我们用全文检索凑合覆盖;第二档(能推理)没有;第三档(能沉淀)靠人肉整理。那要不要换?我的结论是团队规模是分水岭:一人到三人的小团队,手搓脚本加模型直接读文件更轻;十人以上、文档散在三个以上平台、有新人 onboarding 需求的团队, WeKnora 这类工具的连接器加 Wiki 沉淀就开始值回部署成本。工具没有银弹,只有匹配。
要不要装:三个问题判断
给还在观望的团队一个决策清单。第一问:你的文档散在几个源里?三个以上、且包含飞书/语雀/钉钉里的至少一个——连接器矩阵对你有真实价值;都在 Git 仓库里的话,先用轻量方案。第二问:你要的是检索还是推理?只是「找到那份文档」,全文检索就够;要「综合几份文档给结论」,才需要 Agent 档。第三问:数据能不能出内网?不能—— WeKnora 的全自托管和模块化设计就是为你准备的,模型都可以接内网 Ollama ;能——托管版五分钟就能试。三问答完,装不装基本清楚了。
一句话收尾:企业知识库工具卷了十年,多数死在「搜索找到文件」这一层; WeKnora 值得看一眼的原因是它把目标抬到了「推理出答案、沉淀成资产」——而连接器矩阵保证它接得住中文团队真实的文档分布。开源、 MIT 、自托管,试错成本只有一个下午。
最后交代依据和边界。 WeKnora 的版本信息( v0.8.0 )、多源导入清单、 20+ 模型兼容、 RBAC 与可观测性、 Wiki Mode 与知识图谱等,来自官方仓库 README 与 CHANGELOG , 2026 年 9 月 15 日核验;星标数 23,179 来自 GitHub API 当日数据。本地实测部分来自本文作者当日在一台 MacBook ( OrbStack/Docker 27.5.1 )上的真实操作,覆盖: Docker Compose 五容器部署、注册登录、主界面、知识库创建与文档上传(三篇已发表文章、 30 个检索块完成向量索引)、 RAG 跨文档问答( 50 秒、引用 3 篇、关键事实与源文档核对一致)、 Agent 模式问答( query_understand → knowledge_search 工具链、 44 秒),以及文中五张界面截图与容器状态清单;对话模型为智谱 glm-5-turbo , Embedding 为 embedding-3 。Wiki 模式、沙箱执行与飞书/语雀等外部数据源同步未在本次实测中覆盖,相关描述为官方文档口径,读者采信时请注意这一区分。模型回答质量取决于所配置的大模型。项目迭代很快( 0.5 到 0.8 仅数月),具体功能以当前版本为准。