ARTICLE · 1016968
我用 WorkBuddy 做了一个 PDF/Word/PPT 转 Markdown 的微信小程序
我用 AI 做了一个微信小程序,能把 PDF、Word、PPT 转成 Markdown。
中间翻了一次车:PDF 里的表格,转出来直接没了。
下面是我把它修好的全过程。
1. 我到底想做个什么
Markdown 是一种很朴素的纯文本格式,没有排版、没有页眉页脚,AI 读起来比 PDF 顺得多。
我经常要把 PDF、Word、PPT 转成 Markdown,再交给 ChatGPT、Claude 处理。
网上的转换网站,不是有广告,就是格式支持不全,还要先把文件传上去。
所以干脆自己做一个,只给自己用。
文件解析我不打算从零开始写,直接用微软开源的 MarkItDown。
思路很简单:
MarkItDown 负责转换,WorkBuddy 负责把它做成一个能用的小程序。
我把需求一次性说清楚,剩下的交给它。大意就是这五句:
帮我做一个本地文件转 Markdown 的小工具。
底层用 MarkItDown,第一版支持 PDF / DOCX / PPTX。
要能上传文件、预览结果、一键复制和下载,转换失败要有明确提示。
所有文件只在本机处理,不上传第三方服务器。
用 Python 写,做成能在本地浏览器直接打开就用的小工具。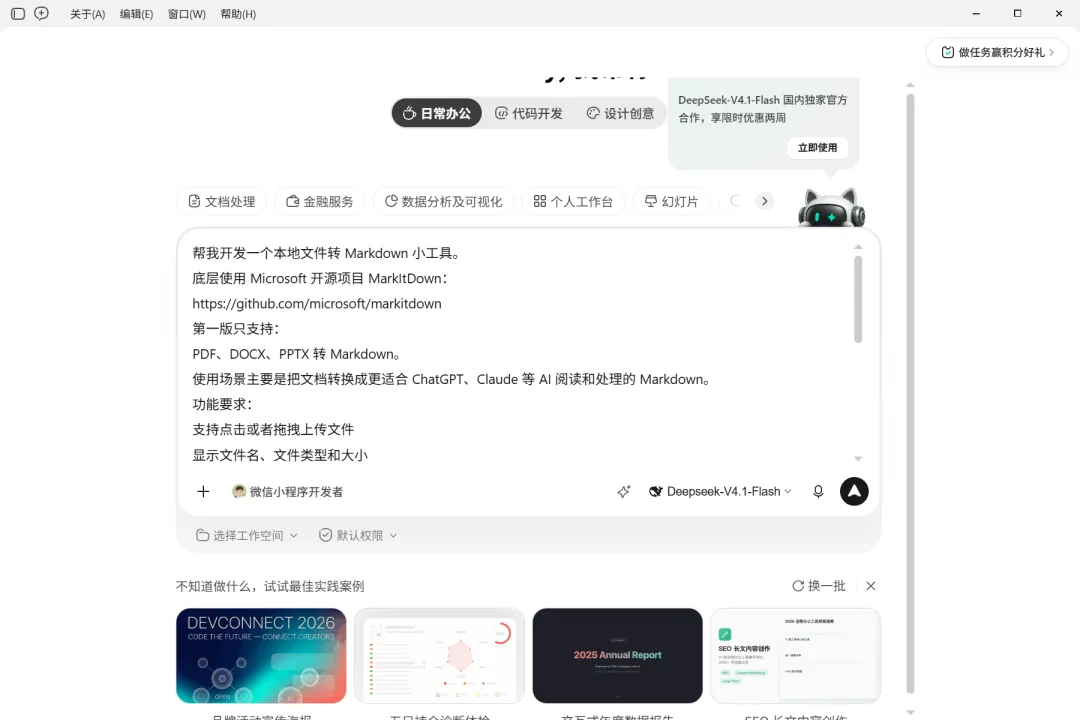
(上面这些词看不懂没关系,重点只有一个:把想要什么说清楚。我实际发过去的完整需求放在文末附录,想看可以翻。)
然后就让 WorkBuddy 开始干活。
2. 第一版很快就跑起来了
环境、代码、页面基本都交给它处理。
没多久,一个最基础的版本就出来了。
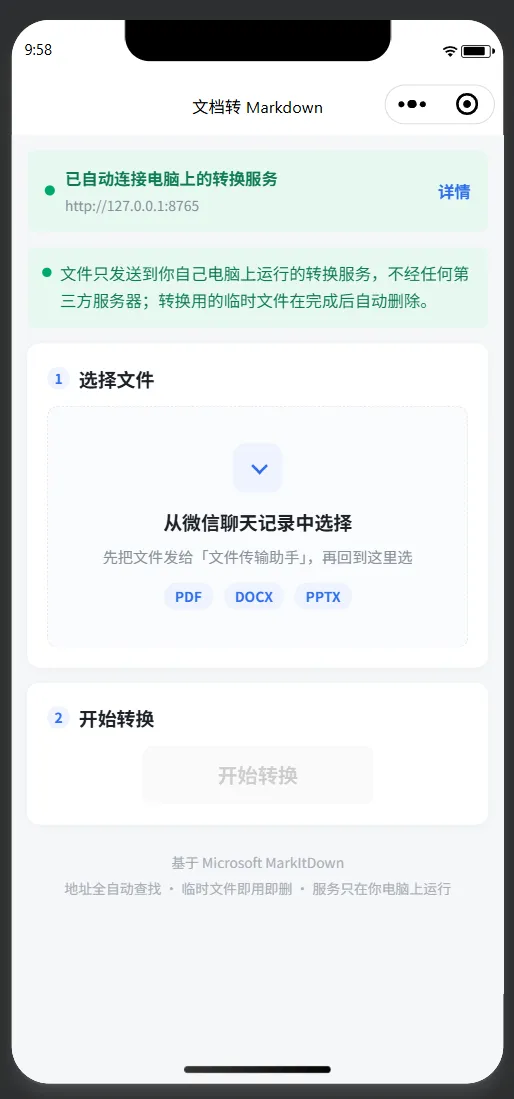
整个流程很简单:选择文件 → 开始转换 → 预览 Markdown → 复制 / 保存。
没有多余功能,这反而正合我意。我关心的是能不能正常转换,不是界面有多复杂。
第一版出来以后,我没有继续让它加功能,而是先测试。
我准备了三份内容一样的文件:PDF、DOCX、PPTX,里面有标题、正文、列表、中英文,还有一张简单的表格。
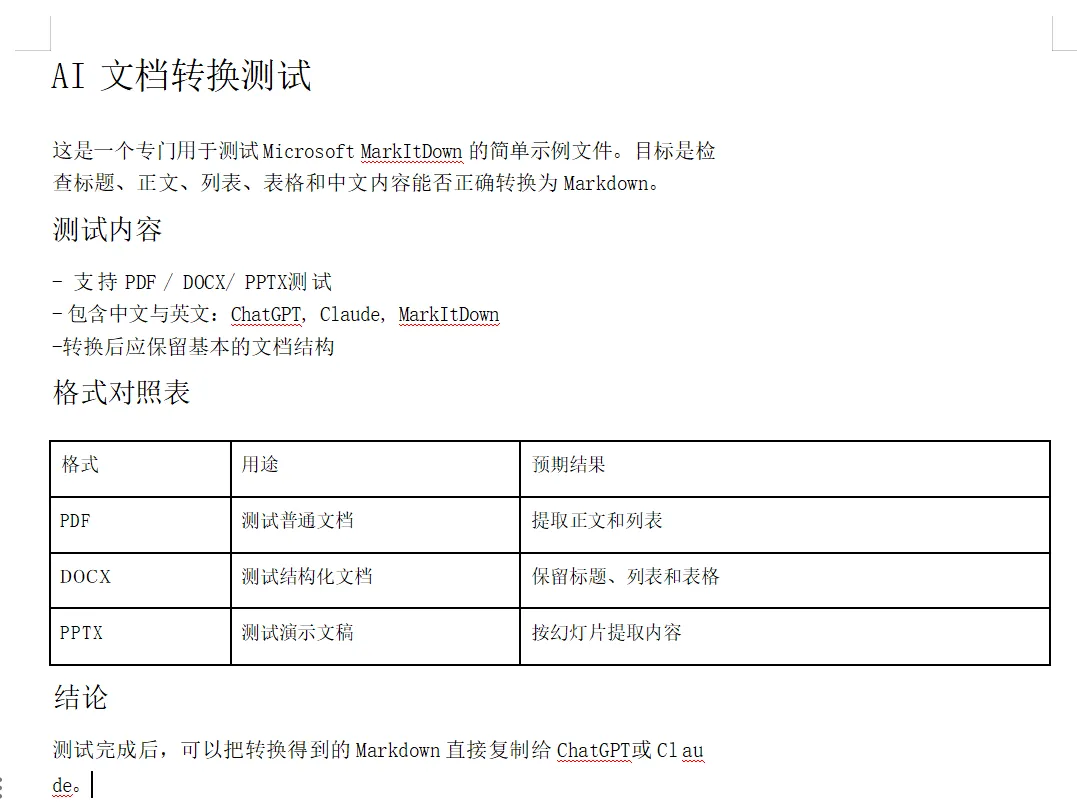
先测 DOCX,标题、列表、表格都正常。
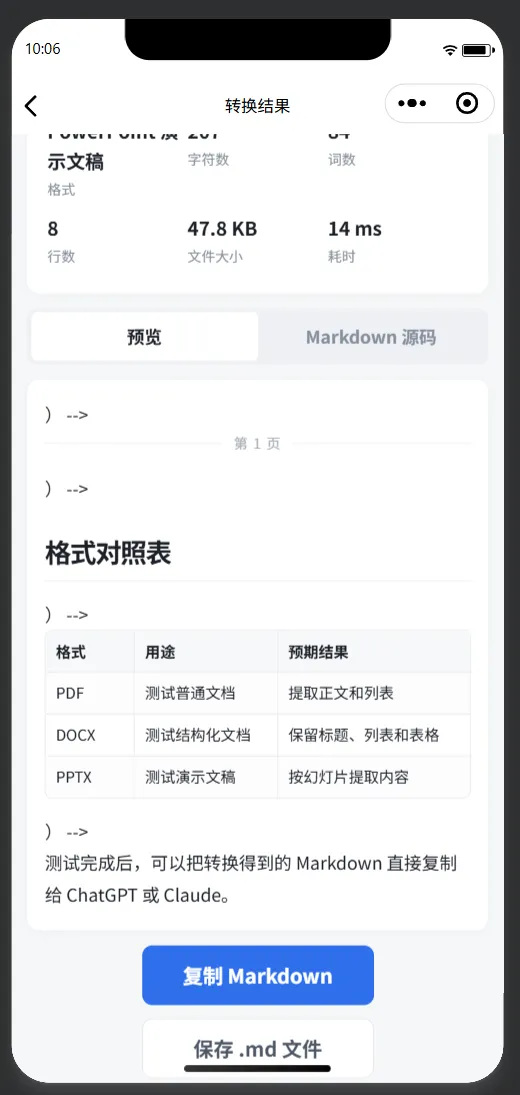
再测 PPT,内容也能正常提取。
直到测试 PDF 的时候,出现了一个挺有意思的问题。
3. PDF 里的表格,第一次直接“没了”
PDF 里面明明有一张表格。
但是转换成 Markdown 以后,表格结构消失了。
内容还在,但已经变成了普通文字。
类似这样:
转换前:
转换以后却变成了:
格式 用途 结果
PDF 测试文档 提取内容
DOCX 测试表格 保留结构
也就是说:
文字没有丢,但是“表格”没有了。
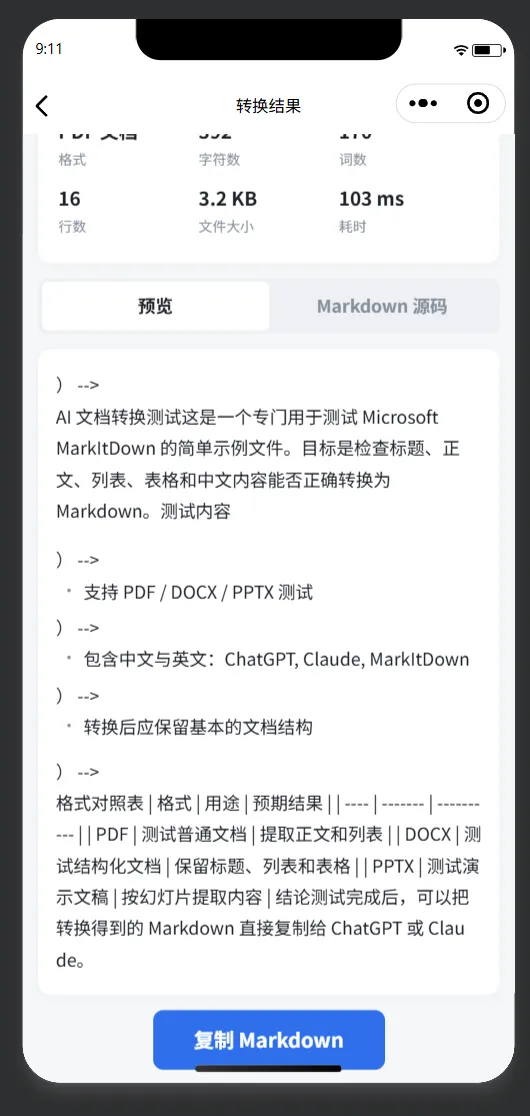
一开始我还以为是 WorkBuddy 写的小程序有问题。
后来我又试了一下。
把同一个 PDF:
先转成 Word,再把 Word 转成 Markdown。
这一次表格居然正常了。
这就说明问题并不在前端页面。
而是在 PDF 本身的解析上。
4. 出问题以后,我没有自己去翻代码
发现问题以后,我做的事情其实很简单。
把现象直接告诉 WorkBuddy:
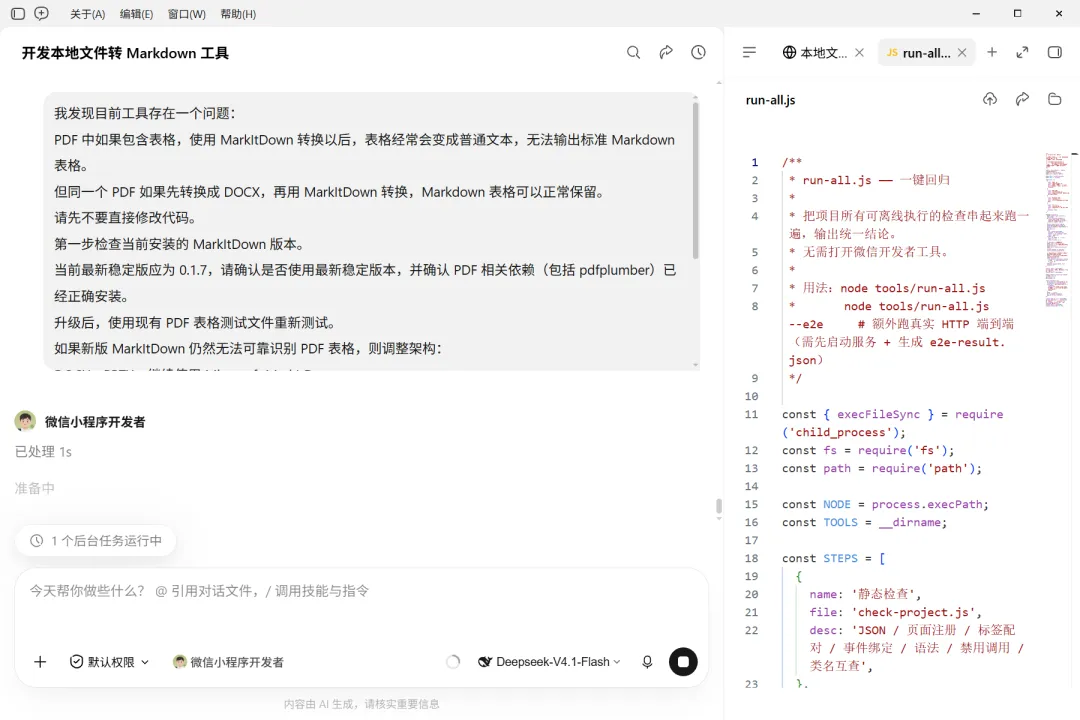
我发现目前工具存在一个问题:
PDF 中如果包含表格,使用 MarkItDown 转换以后,表格经常会变成普通文本,无法输出标准 Markdown 表格。
但同一个 PDF 如果先转换成 DOCX,再用 MarkItDown 转换,Markdown 表格可以正常保留。
请先不要直接修改代码。
第一步检查当前安装的 MarkItDown 版本。
当前最新稳定版应为 0.1.7,请确认是否使用最新稳定版本,并确认 PDF 相关依赖(包括 pdfplumber)已经正确安装。
升级后,使用现有 PDF 表格测试文件重新测试。
如果新版 MarkItDown 仍然无法可靠识别 PDF 表格,则调整架构:
DOCX、PPTX:继续使用 Microsoft MarkItDown;
PDF:改用 Docling;
Docling 开启 table structure recognition;
最终统一输出 Markdown;
前端界面和用户操作方式保持不变。
不要采用“PDF → Word → Markdown”这种中间转换方案。
修改完成后,用同一个带表格 PDF 对比修改前后的 Markdown 结果,并告诉我具体修改了哪些地方。
然后继续让它排查。
这也是这次我比较喜欢的地方。
我没有去找:
哪个文件有问题。
哪个函数负责 PDF。
表格解析逻辑在哪里。
我的流程基本就是:
测试 → 发现问题 → 描述现象 → 让 WorkBuddy 修 → 再测试。
5. 修完以后,再拿同一个 PDF 测
问题解决以后,我重新上传了刚才那个 PDF。
这一次表格终于正常了。
原来散掉的内容,已经可以重新输出成 Markdown 表格。
也就是说:
修复前:
格式 用途 结果
PDF 测试文档 提取内容
修复后:
| 格式 | 用途 | 结果 |
| --- | --- | --- |
| PDF | 测试文档 | 提取内容 |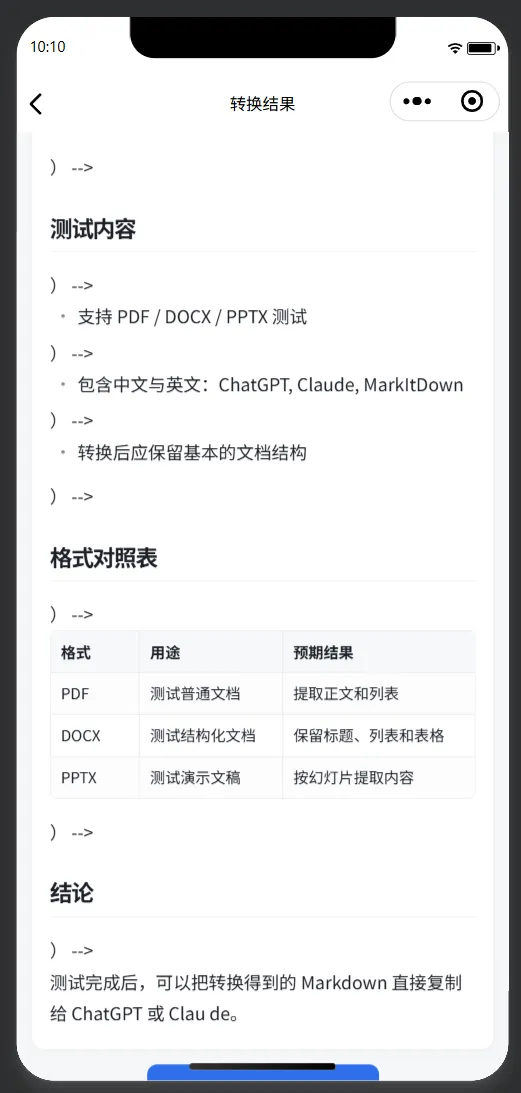
其实我觉得这张图比“AI 一次把项目做成功了”更有意思。
因为真实开发基本不可能一次就完美。
尤其是 PDF 这种格式,本身就有很多奇奇怪怪的问题。
重要的不是:
AI 第一次有没有全部写对。
而是:
出了问题以后,它能不能继续帮你把问题解决掉。
做完之后,小程序就是这个样子:
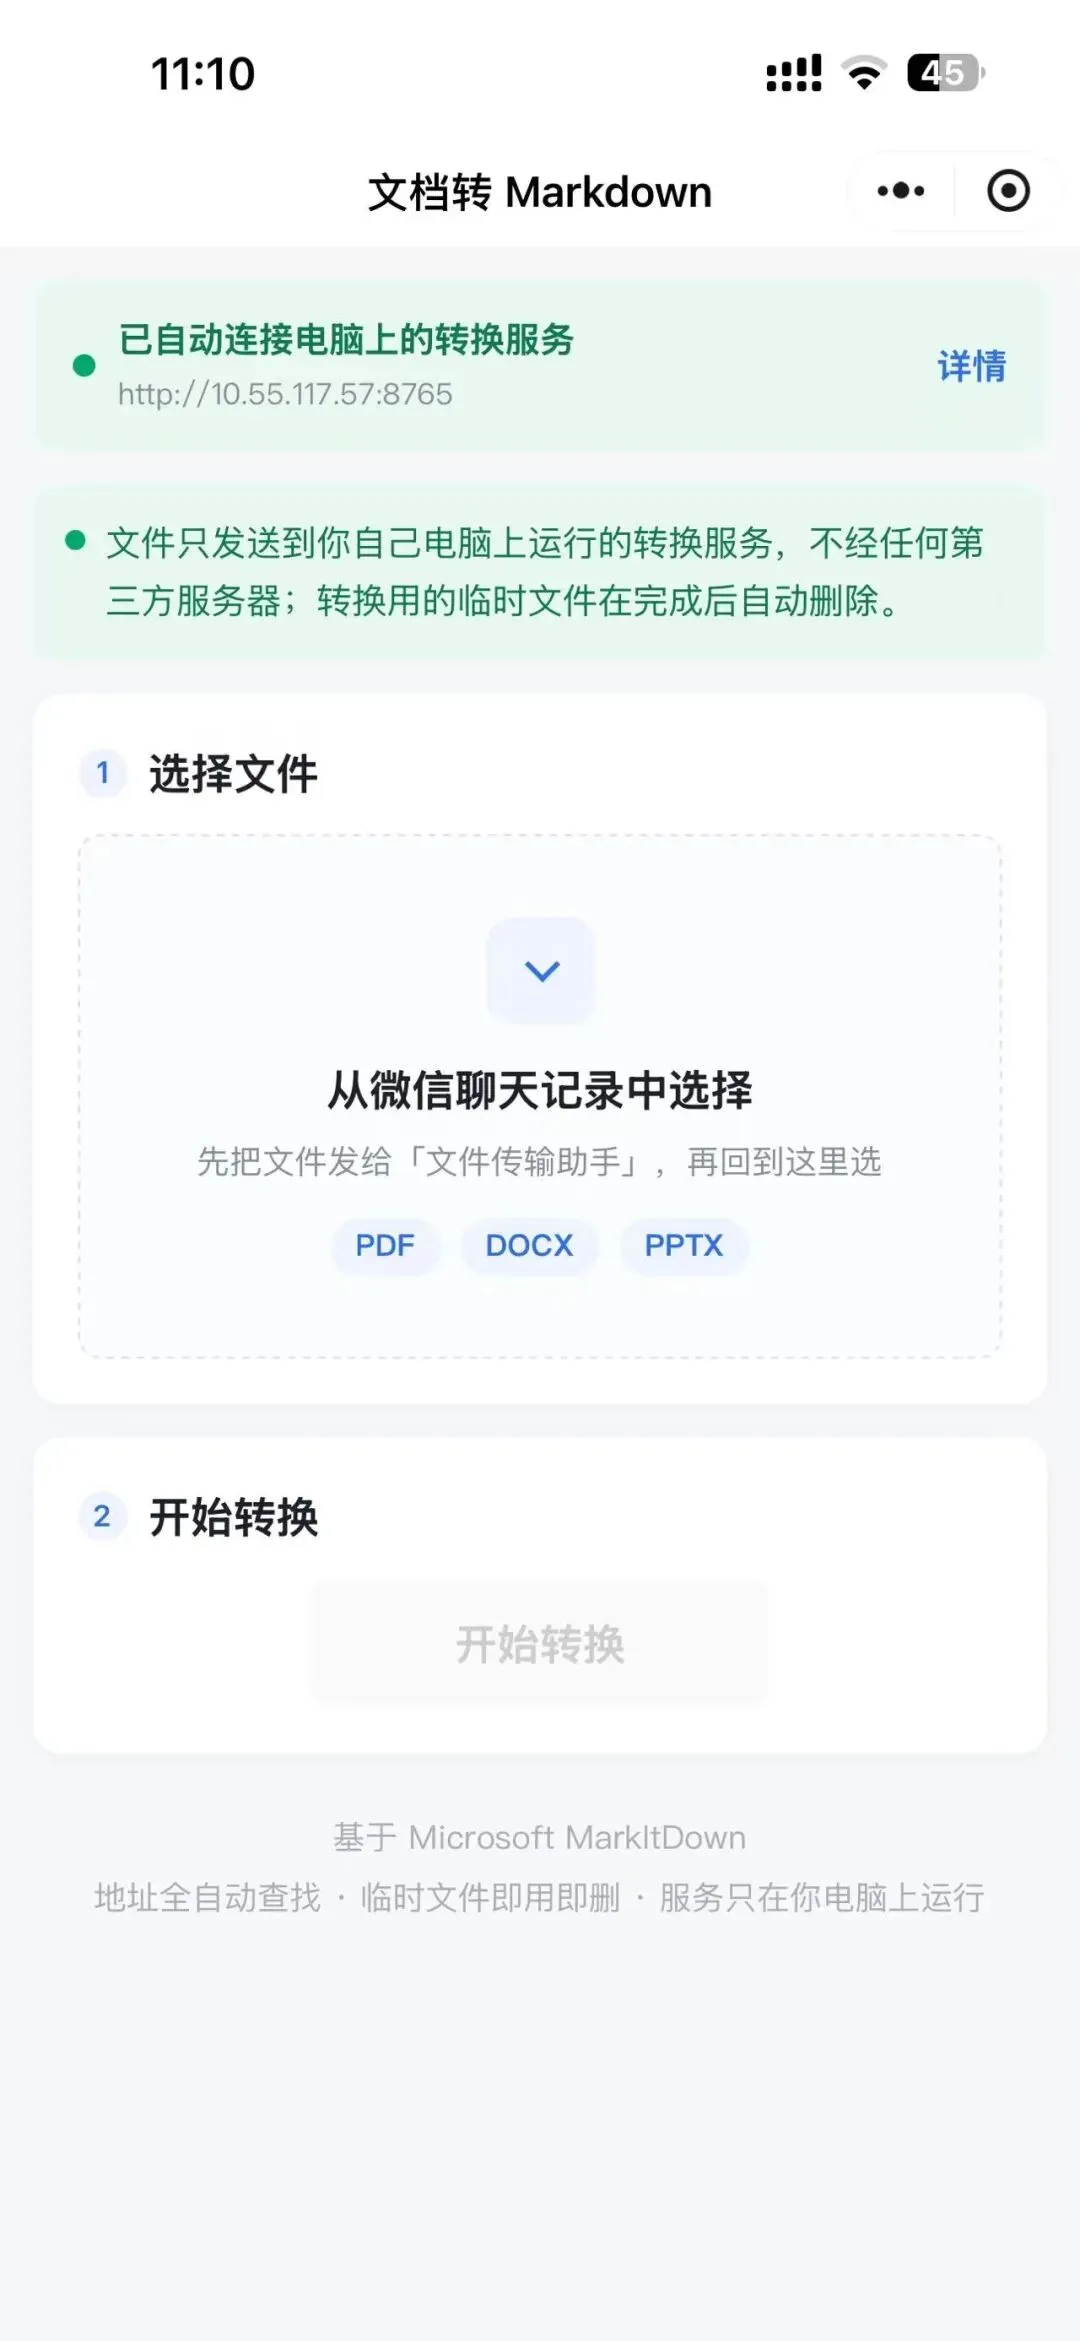
这里放最终小程序效果图
6. 这次最大的感受
以前看到 MarkItDown 这种开源项目,我的反应是收藏 GitHub、翻一下 README,真正要用的时候再打开终端跑命令。
现在我的思路变了。
如果一个开源项目功能很好,但用起来不够顺手:
那我为什么不能让 AI 给它重新包一层自己喜欢的界面?
我也没打算把它做成一个“正式产品”——没做账号系统,没加一堆我自己都不会用的功能。
我只想做一个自己真正会用的小工具。
这次做的东西并不复杂。但从“一个想法”到“一个真的能在微信里用的小程序”,中间只隔了很短的一段时间。
很多以前觉得“这个需求太小了,不值得专门开发”的事,现在反而可以:“那就给自己做一个。”
至于这个小程序最后怎么真正发布上线,我单独写了一篇。因为“做出来”和“真正发布给别人使用”,完全是两件事。
附录:我一开始发给 WorkBuddy 的完整需求
帮我开发一个本地文件转 Markdown 小工具。

底层使用 Microsoft 开源项目 MarkItDown:
https://github.com/microsoft/markitdown

第一版只支持:

PDF、DOCX、PPTX 转 Markdown。

使用场景主要是把文档转换成更适合 ChatGPT、Claude 等 AI 阅读和处理的 Markdown。

功能要求:

支持点击或者拖拽上传文件
显示文件名、文件类型和大小
点击按钮开始转换
转换完成后显示 Markdown 预览
支持一键复制 Markdown
支持下载 .md 文件
转换失败要有明确提示
所有文件只在本机处理,不上传第三方服务器
临时文件转换完成后自动删除

页面尽量简单、干净。

使用 Python 调用 MarkItDown,做成一个可以在本地浏览器直接使用的小工具。

请先检查本机 Python 环境并安装需要的依赖,然后完成开发并运行起来让我测试。
下一篇:做出来之后,怎么发出去
现在这个小程序还只在你自己的电脑上。怎么弄到手机上、怎么发给朋友扫,我写在下一篇:
👉 微信小程序发布测试:从装工具到发给朋友扫码