ARTICLE · 1017619
结构化文档不能只切块:VikingRAG 如何让 RAG 像人一样查目录、补证据
这篇论文关注 RAG 的一个常见误区:把文档切成 chunk 后,结构就被当作噪声丢掉了。VikingRAG 把文档目录、章节路径、局部阅读和证据充分性判断做成系统能力,在准确率和 token 成本之间取得更好的平衡。
1. 现实问题:文档不是一堆 chunk
很多企业 RAG 的对象并不是短文本,而是年报、教材、政策、合同、技术手册、课程大纲、金融材料等结构化文档。答案往往藏在“某章—某节—某段—某表”的上下文里。普通 RAG 把文档切块后做向量检索,虽然简单,但会丢掉目录、章节、相邻块和路径关系。
如果把完整目录或大量候选 chunk 都塞进上下文,准确率可能上去,但 token 和时延会迅速失控。论文要解决的就是这个矛盾:如何保留结构化文档的导航能力,同时不要让结构上下文吞掉 prompt budget。
R
VikingRAG 的核心不是“检索更多”,而是“像读者一样找证据”:先定位目录,再读局部,不够再扩大搜索。
这让 RAG 从一次 top-k 召回,变成可控的证据缺口驱动过程。
2. 新存储层:结构外置、URI 可寻址、向量只负责入口
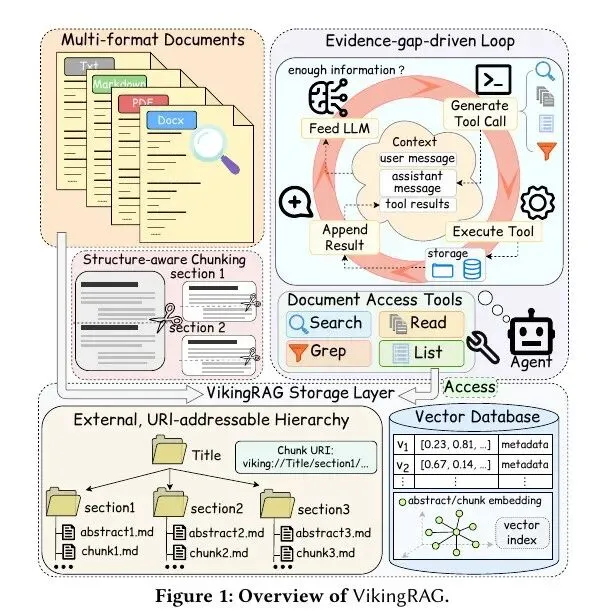
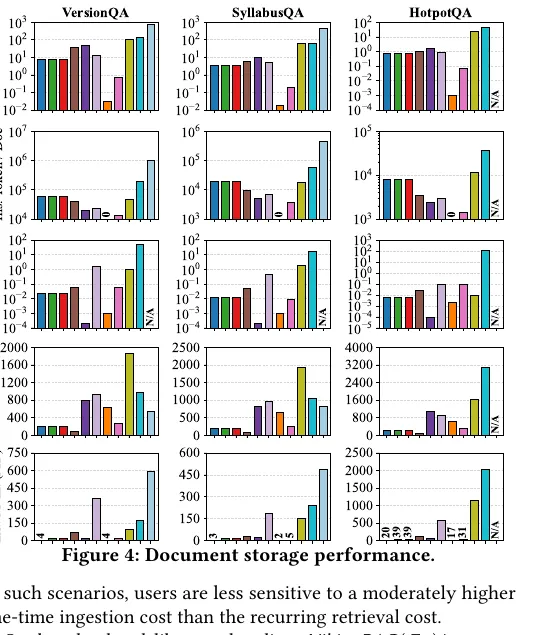
VikingRAG 的第一层创新是 document storage。它不是把所有结构都转成一段长 prompt,也不是只保留 chunk embedding,而是把文档处理成两类对象:一类是可寻址的目录/章节/块文件,另一类是对应的 abstract 和 chunk embedding。
External URI hierarchy
标题、section、abstract、chunk 都有稳定 URI,后续工具调用可以精确访问某个范围。
Structure-aware chunking
chunk 不只是固定长度文本,而是尽量贴合章节边界,保留局部语义完整性。
Vector entry point
向量检索用来找到可能的入口,但不会替代目录遍历和局部读取。
这样做的现实意义是:文档越多、越长,越不能把结构上下文一次性塞进 LLM。结构应留在系统里,通过工具按需访问。
3. 新方法:Evidence-gap-driven multi-round retrieval
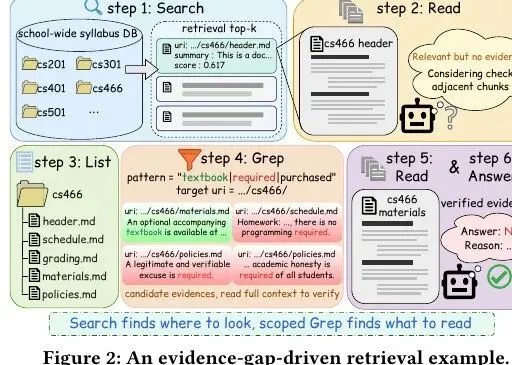
VikingRAG 的第二层创新是检索控制。Agent 每一轮都会拿到当前上下文、已读证据和工具结果,然后判断是否足够回答。如果足够,就生成答案;如果不足,就继续调用 Search、Read、List、Grep。
Search先找入口
根据问题在摘要和 chunk 索引中找候选 URI,不直接吞完整文档。
Read/List沿目录展开
读取相关 chunk,或列出相邻章节,像读者查目录一样缩小范围。
Grep局部关键词定位
在已定位目录内做 scoped lexical search,避免全库扫词。
Judge判断证据缺口
证据充分则停止;不充分才继续多轮检索或升级。
这解决了一个很现实的问题:很多问题第一轮能找到“相关但不充分”的材料。传统 RAG 可能直接回答或继续盲目 top-k,而 VikingRAG 把“缺什么证据”变成下一轮工具调用的依据。
4. Experience edges:把历史检索路径变成可复用导航
如果每个新问题都从头走完整个多轮检索,成本仍然高。VikingRAG-E 因此引入 experience edges:把历史问题中已经验证有用的文档路径、证据位置和检索轨迹沉淀下来。后续相似问题不必重新探索整棵目录,而是可以从历史边指向的证据附近开始。
这与传统知识图谱不同:experience edge 不是离线抽取“实体—关系”,而是从真实 RAG 轨迹中学习“这个问题类型通常会去哪些文档位置取证”。它更接近系统层面的缓存和导航记忆。
VikingRAG-E+ 再往前一步:先尝试轻量的一轮检索,只有证据充分性判断认为不够时,才启用更贵的 agentic multi-round retrieval。这就把高准确率方法变成按需付费,而不是每个问题都付最高成本。
5. 实验结果:准确率、token、延迟三者一起看
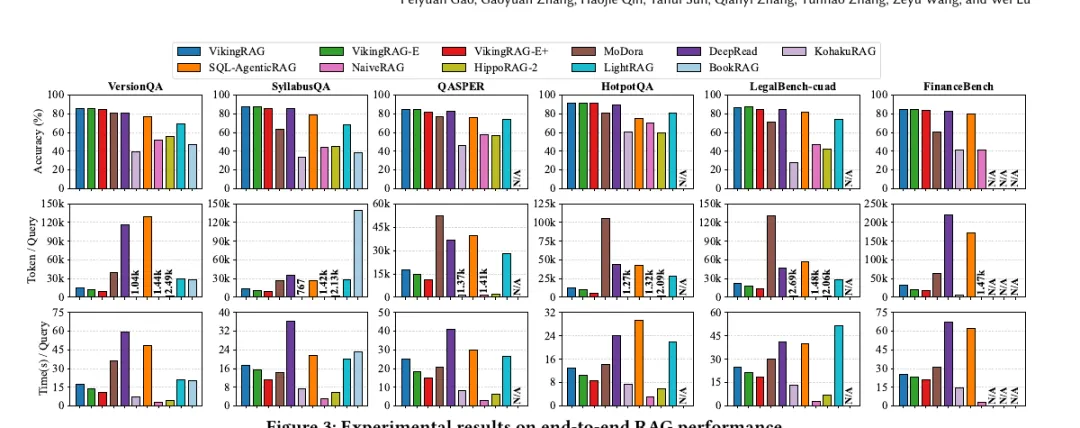
11.6–51.9%VikingRAG 达到强基线准确率时所需 token 比例
67.3–88.1%VikingRAG-E 相对 VikingRAG 的 token 消耗
5.1–32.5%VikingRAG-E+ 相对 VikingRAG 的 token 消耗
73.1–89.8%VikingRAG-E+ 相对 VikingRAG 的延迟比例
论文在 VersionQA、SyllabusQA、QASPER、HotpotQA、LegalBench-cuad、FinanceBench 等任务上比较了 NaiveRAG、SQL-AgenticRAG、MoDora、DeepRead、KohakuRAG、HippoRAG-2、LightRAG、BookRAG 等方法。核心结论不是某个任务单点领先,而是 VikingRAG 系列用更少 token 保持了接近或达到最强方法的准确率。
参数实验也说明系统有 trade-off:返回 chunk 数 K 太小会漏证据,太大又增加 token;chunk 上限 L 太小会碎片化证据,太大又带入无关内容;轮次预算 B 太小准确率低,太大成本升高。VikingRAG 的工程重点正是把这些权衡显式化。
6. 适用边界与工程启发
适合什么场景?
文档天然有层级:书、手册、财报、规章、网页、课程材料。 答案需要多处证据拼接,而不是单 chunk 直接命中。 token 成本敏感,不能每次都长上下文暴力读取。
要小心什么?
结构抽取质量会影响后续目录导航。 证据充分性判断如果误判,会造成过早回答或过度检索。 经验边适合重复查询分布;如果问题分布剧烈变化,收益会下降。
一句话总结:结构化文档 RAG 的核心竞争力,不是向量库召回多少 chunk,而是能否把“找证据”做成可控、可复用、可停止的过程。