ARTICLE · 1018721
poll 源码分析(四):sys_ppoll() 入口函数
上一篇走完了内核态的 syscall 分发流程:CPU 从异常向量表跳到 el0_sync,分诊到 el0_svc,然后查表拿到 sys_ppoll 函数的地址,最后通过 blr x16 跳了过去。
我们还顺手拆解了 SYSCALL_DEFINE5 这个宏,发现 sys_ppoll 只是 SyS_ppoll 的别名,而 SyS_ppoll 调用的才是 fs/select.c 里那对大括号包着的函数体 SYSC_ppoll。
这一篇就进入这对大括号,看看 ppoll 系统调用的入口函数到底干了什么。
本文基于 Linux 4.4.126 版本的源码。阅读本文需要各位道友有一些 Linux 信号相关的背景知识。
另外先说明一下,sys_ppoll() 中间调用的 do_sys_poll() 才是真正处理 poll 语义的函数,这个函数值得单独写一篇来分析。本文只聚焦在 do_sys_poll() 的前后:入口函数怎么处理超时和信号掩码,以及被信号打断之后怎么收尾。
1. 总览
老规矩,先把本文要分析的代码调用链列出来:
sys_ppoll()poll_select_set_timeout()sigdelsetmask()sigprocmask()ret = do_sys_poll()if (ret == -EINTR)set_restore_sigmask()else if (sigmask)sigprocmask()poll_select_copy_remaining()
再把函数体完整贴出来,代码在 fs/select.c:
SYSCALL_DEFINE5(ppoll, struct pollfd __user *, ufds, unsigned int, nfds,struct timespec __user *, tsp, const sigset_t __user *, sigmask,size_t, sigsetsize){sigset_t ksigmask, sigsaved;struct timespec ts, end_time, *to = NULL;int ret;if (tsp) {if (copy_from_user(&ts, tsp, sizeof(ts)))return -EFAULT;to = &end_time;if (poll_select_set_timeout(to, ts.tv_sec, ts.tv_nsec))return -EINVAL;}if (sigmask) {/* XXX: Don't preclude handling different sized sigset_t's. */if (sigsetsize != sizeof(sigset_t))return -EINVAL;if (copy_from_user(&ksigmask, sigmask, sizeof(ksigmask)))return -EFAULT;sigdelsetmask(&ksigmask, sigmask(SIGKILL)|sigmask(SIGSTOP));sigprocmask(SIG_SETMASK, &ksigmask, &sigsaved);}ret = do_sys_poll(ufds, nfds, to);/* We can restart this syscall, usually */if (ret == -EINTR) {/** Don't restore the signal mask yet. Let do_signal() deliver* the signal on the way back to userspace, before the signal* mask is restored.*/if (sigmask) {memcpy(¤t->saved_sigmask, &sigsaved,sizeof(sigsaved));set_restore_sigmask();}ret = -ERESTARTNOHAND;} else if (sigmask)sigprocmask(SIG_SETMASK, &sigsaved, NULL);ret = poll_select_copy_remaining(&end_time, tsp, 0, ret);return ret;}
看着挺唬人,但拆开来分析后发现特简单。整个函数是很典型的三段式结构:
准备(第 9 - 27 行):处理两个可选参数,超时时间和信号掩码。这部分对应后文第 3/4 两小节的内容。
干活(第 29 行):调 do_sys_poll(),睡眠等待,直到有事件就绪、超时、或者被信号打断。对应第 5 节,不展开。
收尾(第 31 - 49 行):恢复信号掩码,把剩余时间写回用户态,并修正返回值。对应第 6/7/8 三节。
2. 函数参数和局部变量
2.1 五个参数
上一篇分析过,经过 SYSCALL_DEFINE5 展开,五个参数在 SyS_ppoll 那一层是五个 long,在 SYSC_ppoll 这一层又被强转回了真实类型。它们依次来自 x0 到 x4 五个寄存器,也就是用户态 glibc 执行 svc 之前装进去的值。
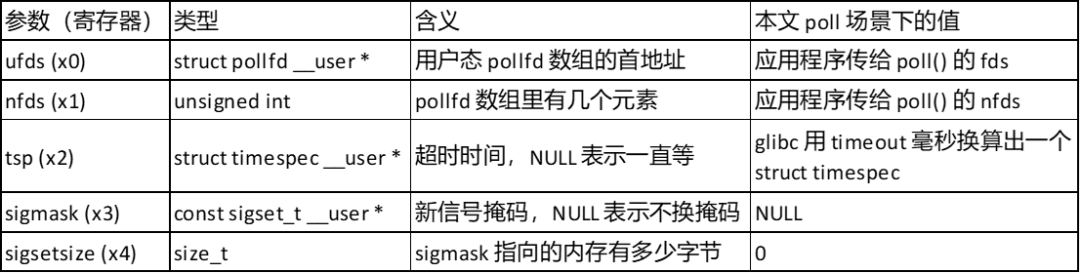
在我们的 poll 场景里,sigmask 一定是 NULL,函数体里所有 if (sigmask) 的分支都不会走。但本文还是会把这些分支完整分析一遍,因为它们才是 ppoll 相比 poll 多出来的那个 "p"。
参数类型里反复出现了 __user,它定义在 include/linux/compiler.h:
#ifdef __CHECKER__# define __user __attribute__((noderef, address_space(1)))...#else# define __user...#endif
这个宏只有在用 sparse 做静态检查时(__CHECKER__ 有定义)才有内容,正常编译时为空,对生成的代码没有任何影响。
它的作用是给指针添加属性,表示这个指针指向的是用户空间的内存(address_space(1)),而且不允许直接解引用(noderef)。如果有人写了 ts = *tsp 这种代码,sparse 就会报错。
为什么不允许直接解引用呢?
因为用户空间传进来的指针是不可信的。如果是恶意攻击者传了一个非法地址,而内核又不检查就直接使用,那轻则造成安全漏洞,重则系统崩溃。所以,内核访问用户态内存必须走专门的接口,比如后文的 copy_from_user()。
2.2 局部变量
第 5 - 7 行定义了六个局部变量:
sigset_t ksigmask, sigsaved;struct timespec ts, end_time, *to = NULL;int ret;
sigset_t
这里出现的 sigset_t 是内核里表示信号集合的类型,定义在 include/uapi/asm-generic/signal.h:
#define _NSIG 64#define _NSIG_BPW __BITS_PER_LONG#define _NSIG_WORDS (_NSIG / _NSIG_BPW)typedef struct {unsigned long sig[_NSIG_WORDS];} sigset_t;
它本质上是一个位图,第 n 个 bit 为 1 就表示第 n + 1 号信号在集合里。
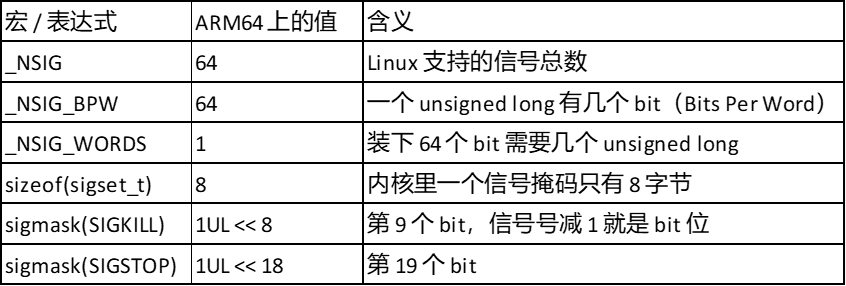
ARM64 上 unsigned long 是 64 位,所以 _NSIG_WORDS 是 1,整个 sigset_t 就是一个 8 字节的 unsigned long。
表中的 sigmask(sig) 宏,算出来的就是第 sig 号信号在这个位图里对应的那个 bit。
ARM64 上的所有信号(1-31)定义在 include/uapi/asm-generic/signal.h 中,摘取几个常见的如下:
#define SIGHUP 1#define SIGINT 2...#define SIGABRT 6...#define SIGKILL 9#define SIGUSR1 10#define SIGSEGV 11...#define SIGTERM 15...#define SIGSTOP 19...#define SIGUNUSED 31
struct timespec
这个结构体定义在 include/uapi/linux/time.h:
struct timespec {__kernel_time_t tv_sec; /* seconds */long tv_nsec; /* nanoseconds */};
__kernel_time_t 本质上也是 long 类型,所以结构体只有两个 long 类型的成员,分别用来记录秒数和纳秒数。
函数参数和局部变量里都出现了 sigset_t 和 struct timespec 这两个类型。可以这么说,sys_ppoll() 函数里除了调用 do_sys_poll() 这一行外,其余代码都是为了处理这两个部分:信号和时间。
3. 第一步:超时处理
第 9 - 16 行:
if (tsp) {if (copy_from_user(&ts, tsp, sizeof(ts)))return -EFAULT;to = &end_time;if (poll_select_set_timeout(to, ts.tv_sec, ts.tv_nsec))return -EINVAL;}
第 9 行先判断 tsp 是不是 NULL。是 NULL 就整段跳过,那么 to 将保持为 NULL。
不是 NULL 的话,做两件事:先把用户态的 timespec 拷进内核(第 10 - 11 行),然后把这个相对超时换算成绝对到期时刻(第 13 - 15 行)。
3.1 copy_from_user()
前面 2.1 节说过,用户指针不可信。具体来说有三个问题:
1. tsp 可能指向一个还没有映射的地址。内核直接访问会触发缺页异常,而内核态的缺页异常如果不能被妥善处理,就是一次 oops。
2. tsp 可能指向内核地址。如果放任不管,用户程序就可以借内核之手读写内核内存,这是经典的安全漏洞之一。
3. 就算地址合法,用户态的内存页也可能刚好被置换出去了,访问时会产生缺页异常。这种情况是正常的,内核必须能从这个异常里恢复过来,把页换回来后继续拷贝。
copy_from_user() 就是为了解决这几个问题。它可以把用户空间的内存安全地拷贝到内核空间。
copy_from_user() 的具体实现一两句话说不完,这里就不展开了。
3.2 poll_select_set_timeout()
第 13 - 15 行:
to = &end_time;if (poll_select_set_timeout(to, ts.tv_sec, ts.tv_nsec))return -EINVAL;
to 指向 end_time,然后调用 poll_select_set_timeout() 把结果填进去。
这个函数也在 fs/select.c,连注释一起贴出来:
/*** poll_select_set_timeout - helper function to setup the timeout value* @to: pointer to timespec variable for the final timeout* @sec: seconds (from user space)* @nsec: nanoseconds (from user space)** Note, we do not use a timespec for the user space value here, That* way we can use the function for timeval and compat interfaces as well.** Returns -EINVAL if sec/nsec are not normalized. Otherwise 0.*/int poll_select_set_timeout(struct timespec *to, long sec, long nsec){struct timespec ts = {.tv_sec = sec, .tv_nsec = nsec};if (!timespec_valid(&ts))return -EINVAL;/* Optimize for the zero timeout value here */if (!sec && !nsec) {to->tv_sec = to->tv_nsec = 0;} else {ktime_get_ts(to);*to = timespec_add_safe(*to, ts);}return 0;}
注释里有个信息值得注意。
用户空间传过来的时间参数拆成两个 long 而不是直接用 timespec 的原因是:select() 用的是 struct timeval,poll 则用的是 struct timespec,拆开传之后,这一个函数就能同时给它俩用了。
函数名的前缀 poll_select 也暗示它是给 poll 和 select 两个路径共用的。
函数体可以拆成三步。
第一步:合法性检查
if (!timespec_valid(&ts))return -EINVAL;
timespec_valid() 定义在 include/linux/time.h:
staticinlinebooltimespec_valid(conststruct timespec *ts){/* Dates before 1970 are bogus */if (ts->tv_sec < 0)return false;/* Can't have more nanoseconds then a second */if ((unsigned long)ts->tv_nsec >= NSEC_PER_SEC)return false;return true;}
两条规则:秒不能为负,纳秒则必须在 0 到 999999999 之间。否则就是一个非法的 timespec。
第 2 个 if 的写法有个小技巧。tv_nsec 是有符号的 long,代码却先把它转成 unsigned long 再和 NSEC_PER_SEC 比较。这样一来,负的纳秒值转成无符号后会变成一个非常大的数,自然就大于等于 NSEC_PER_SEC 了。
一次比较同时拦截了负数和正数越界两种情况,省掉一个分支判断。
第二步:零超时的快速路径
if (!sec && !nsec) {to->tv_sec = to->tv_nsec = 0;}
用户传 {0, 0},对应的 poll 语义就是不等待,轮询一遍 fd 就返回,不管有没有就绪的文件。这种情况下不需要读时钟,直接把 to 也填成 {0, 0} 就行。后面 do_sys_poll() 和 poll_select_copy_remaining() 都会专门识别这个值。
第三步:相对时间换成绝对时间
} else {ktime_get_ts(to);*to = timespec_add_safe(*to, ts);}
这是本函数的核心。用户传进来的是相对时间(从现在起等多久),这两行把它转换成绝对时间(等到哪个时刻为止):先获取当前时间,再把用户的 ts 加上去。
先看 ktime_get_ts()。
它读的是 CLOCK_MONOTONIC 单调时钟,从系统启动开始单调递增,不会因为管理员改系统时间、或者 NTP 校时而跳变。
超时这种事只关心时间流逝了多少,用单调时钟是唯一正确的选择。如果用墙上时钟,用户改一下日期,poll 就可能提前超时,或者永远不超时。
它定义在 include/linux/timekeeping.h,有两个版本,由 BITS_PER_LONG 选择:
#if BITS_PER_LONG == 64staticinlinevoidktime_get_ts(struct timespec *ts){ktime_get_ts64(ts);}#elsestaticinlinevoidktime_get_ts(struct timespec *ts){struct timespec64 ts64;ktime_get_ts64(&ts64);*ts = timespec64_to_timespec(ts64);}#endif
ARM64 走前者。64 位平台上 timespec64 就是 timespec 的别名,include/linux/time64.h 里有如下定义:
#define timespec64 timespec所以 ts 可以直接传给 ktime_get_ts64()。这套 timespec64 的机制是为了解决 32 位平台 2038 年问题引入的,64 位平台上不受影响。
ktime_get_ts64() 本身涉及 timekeeper 和 seqcount,不是本文重点,就不展开了。
总之,调用 ktime_get_ts() 后 to 里面保存的就是当前的单调时钟。假设系统刚好运行了一天一夜 24 小时,那么单调时钟就是 24 x 3600 = 86400 秒,纳秒为 0。即
to->tv_sec = 86400;to->tv_nsec = 0;
再看 timespec_add_safe()。
它定义在 kernel/time/time.c:
/** Add two timespec values and do a safety check for overflow.* It's assumed that both values are valid (>= 0)*/struct timespec timespec_add_safe(conststruct timespec lhs,const struct timespec rhs){struct timespec res;set_normalized_timespec(&res, lhs.tv_sec + rhs.tv_sec,lhs.tv_nsec + rhs.tv_nsec);if (res.tv_sec < lhs.tv_sec || res.tv_sec < rhs.tv_sec)res.tv_sec = TIME_T_MAX;return res;}
函数把两个传进来的 timespec 相加,并处理进位问题,然后检查时间是否有溢出。
set_normalized_timespec() 负责秒和纳秒的分别相加,纳秒超过一秒就往秒进位。
if 语句检查相加后的秒是否溢出。两个非负数相加,结果比任何一个加数还小,只可能是溢出了,这时限制到 TIME_T_MAX(64 位上是 2^63 - 1)。函数名里的 safe 指的就是这个。
为什么要转成绝对时间?
因为 do_sys_poll() 里的等待并不是一觉睡到底。它是一个循环:睡下去,被唤醒,检查所有 fd,没有就绪就继续睡。中间可能被无关的唤醒打断很多次。
如果一直拿着相对时间,那每次重新睡下去之前都得算一次还剩多少时间,还得小心累积误差。换成绝对到期时刻之后,不管中间醒来几次,判断标准始终是同一个:现在到了那个时刻没有。
另外,后面第 7 节要把剩余时间写回用户态,也需要一个固定的到期时刻来做减法。
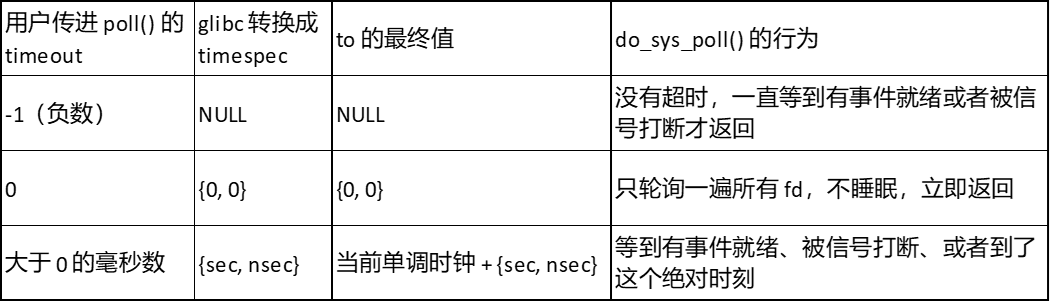
用户空间传过来的 tsp,以及对应的 to,可能的取值总结如下:
4. 第二步:信号掩码处理
第 18 - 27 行:
if (sigmask) {/* XXX: Don't preclude handling different sized sigset_t's. */if (sigsetsize != sizeof(sigset_t))return -EINVAL;if (copy_from_user(&ksigmask, sigmask, sizeof(ksigmask)))return -EFAULT;sigdelsetmask(&ksigmask, sigmask(SIGKILL)|sigmask(SIGSTOP));sigprocmask(SIG_SETMASK, &ksigmask, &sigsaved);}
在开始逐行分析之前,请先思考一个问题:poll 为什么需要一个带信号掩码的版本?
4.1 ppoll 为什么要带信号掩码
答案很简单:为了解决 poll 无法解决的问题。
那以前的 poll 无法解决什么问题呢?
考虑这样一个需求:用户在调用 poll() 等待就绪的 fd 时,又希望某个信号(比如 SIGCHLD、SIGUSR1 等)能把 poll() 打断,好及时去处理别的事。如果不打断的话,poll() 可能会睡很久,而和信号相关的那件事就迟迟得不到处理,很有可能会影响用户体验。
信号处理有个特点:如果一个信号被屏蔽了,它到来之后不会被立即处理,而是挂起(pending),等到屏蔽解除后才处理。
所以针对上面那个需求,用户程序通常会在进入 poll() 之前解除信号屏蔽,poll() 返回后再屏蔽回去,保证只有调用 poll() 的这段时间会被信号打断。
典型代码如下:
sigprocmask(SIG_UNBLOCK, &sigs, NULL); // 1. 放开信号ret = poll(fds, nfds, -1); // 2. 等待sigprocmask(SIG_BLOCK, &sigs, NULL); // 3. 屏蔽回去
sigprocmask() 用来修改当前线程的信号集掩码,也就是前文说到的 sigset_t 结构体。这个函数后文会详细分析。
为了方便理解,我们假设解除屏蔽的信号是 SIGUSR1。SIGUSR1 是 Linux 里专门留给用户程序自己定义用途的一个信号。作为示例,我们假设收到 SIGUSR1 后信号处理函数(handler)只是简单地打印一行日志。
乍一看,上面的代码好像也没啥毛病。但问题在于第 1 步和第 2 步之间有个窗口。
如果信号恰好在这个窗口里到来,handler 会立刻执行,然后程序继续往下调用 poll()。由于信号已经被处理了,而如果这个信号又恰好是接下来很长一段时间内接收到的唯一一个信号,那 poll() 就不会被打断,从而一直睡下去,程序看起来就像"丢"了一个信号。
这个窗口很小,但只要程序跑得够久,迟早会撞上。
ppoll 的出现就是为了解决这个问题:把新的信号掩码作为参数传给内核,由内核在同一次系统调用里完成"换掩码、睡眠、换回来"三个动作。用户态看到的效果是这三步是"原子"的,于是"窗口"就不存在了。
pselect6 也是同样的道理,它是 select 的加信号掩码版本。
明白了动机,下面的代码就好理解了。
4.2 准备工作
第 20 - 21 行:
if (sigsetsize != sizeof(sigset_t))return -EINVAL;
前面 2.2 节说过,内核的 sigset_t 是 8 字节。用户传的 sigsetsize 必须正好是 8,否则 -EINVAL。
为什么要让用户传这个大小?
这是因为 glibc 的 sigset_t 是 128 字节,内核的是 8 字节,两边不一样。而且内核将来可能扩展信号数量,sigset_t 就会变大。让用户显式传大小,内核就能知道用户态是按哪个版本编译的,为将来的兼容留了余地。
第 19 行那句 XXX 注释说的就是这个意思:不要把不同大小的 sigset_t 的可能性堵死。不过直到今天,内核也只支持 8 字节这一种。
第 22 - 23 行:
if (copy_from_user(&ksigmask, sigmask, sizeof(ksigmask)))return -EFAULT;
把用户态的 8 字节信号掩码拷贝进内核栈上的局部变量 ksigmask。
4.3 剔除 SIGKILL 和 SIGSTOP
第 25 行:
sigdelsetmask(&ksigmask, sigmask(SIGKILL)|sigmask(SIGSTOP));sigdelsetmask() 定义在 include/linux/signal.h:
staticinlinevoidsigdelsetmask(sigset_t *set, unsignedlong mask){set->sig[0] &= ~mask;}
从信号集合里清掉 mask 指定的那些 bit。sigmask(SIGKILL) 是 1UL << 8,sigmask(SIGSTOP) 是 1UL << 18,所以 ~mask 就是 0xFFFF FFFF FFFB FEFF。
SIGKILL 和 SIGSTOP 是 Linux 上两个不能被屏蔽、不能被捕获、不能被忽略的信号,这保证了管理员永远能杀掉或者停住一个进程。
内核必须要处理好各种可能的情况。如果用户真的传了这两个信号,而内核又不处理,那这个用户进程就像一匹脱缰的野马,再也不能被杀掉或停止了。
4.4 更新信号掩码
第 26 行:
sigprocmask(SIG_SETMASK, &ksigmask, &sigsaved);三个参数分别对应:怎么改(SIG_SETMASK,整个替换),改成什么(ksigmask),旧值存哪(sigsaved)。
这个函数在 kernel/signal.c:
/** This is also useful for kernel threads that want to temporarily* (or permanently) block certain signals.** NOTE! Unlike the user-mode sys_sigprocmask(), the kernel* interface happily blocks "unblockable" signals like SIGKILL* and friends.*/intsigprocmask(int how, sigset_t *set, sigset_t *oldset){struct task_struct *tsk = current;sigset_t newset;/* Lockless, only current can change ->blocked, never from irq */if (oldset)*oldset = tsk->blocked;switch (how) {case SIG_BLOCK:sigorsets(&newset, &tsk->blocked, set);break;case SIG_UNBLOCK:sigandnsets(&newset, &tsk->blocked, set);break;case SIG_SETMASK:newset = *set;break;default:return -EINVAL;}__set_current_blocked(&newset);return 0;}
注意注释。这是内核版的 sigprocmask() 实现,是给内核自己用的,调用者传什么就屏蔽什么,包括 SIGKILL 等 unblockable 的信号。这也是前面必须先调用 sigdelsetmask() 的原因。
第 11 行:current 是当前线程的 task_struct,它的 blocked 字段就是当前线程的信号掩码。
第 15 - 16 行:把旧的信号掩码备份到 oldset。oldset 是传进来的局部变量 sigsaved。注释说这里不用加锁,因为 blocked 字段只有线程自己会改,中断上下文不会碰它。既然只有自己会改,读自己的值当然不需要锁。
第 18 - 30 行:switch 按 how 的三种取值算出新掩码。
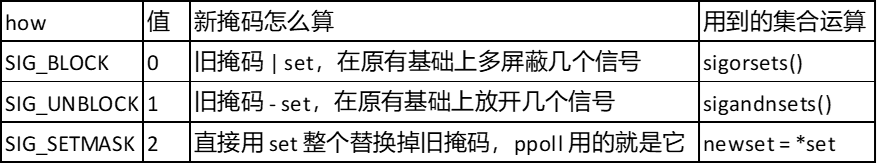
ppoll 传的是 SIG_SETMASK,直接用用户的掩码整个替换。语义就是:在 ppoll 运行期间,信号掩码就是用户给的这个,和之前是什么无关。
根据我们前面的假设,新掩码将只有 SIGUSR1 这一个 bit 位是 1。其余所有普通的信号都将被屏蔽。
第 32 行:调用 __set_current_blocked() 将 blocked 字段更新成新的掩码。
这个函数也在 kernel/signal.c:
void __set_current_blocked(const sigset_t *newset){struct task_struct *tsk = current;spin_lock_irq(&tsk->sighand->siglock);__set_task_blocked(tsk, newset);spin_unlock_irq(&tsk->sighand->siglock);}
读的时候不用锁,写的时候必须得拿 siglock 了。因为写 blocked 会影响别的线程和中断上下文的判断(比如这个信号能不能发给这个线程),必须在锁的保护下和其它信号状态保持一致。spin_lock_irq 是关中断的自旋锁版本,因为中断上下文也可能会访问临界区的资源。
锁里面是 __set_task_blocked():
static void __set_task_blocked(struct task_struct *tsk, const sigset_t *newset){if (signal_pending(tsk) && !thread_group_empty(tsk)) {sigset_t newblocked;/* A set of now blocked but previously unblocked signals. */sigandnsets(&newblocked, newset, ¤t->blocked);retarget_shared_pending(tsk, &newblocked);}tsk->blocked = *newset;recalc_sigpending();}
第 9 行是真正的赋值,完成 blocked 字段的更新。更新前后各有一件事要做。
前:retarget_shared_pending()。
这处理的是多线程进程的一个细节。发给整个进程的信号(比如 SIGINT)挂在进程共享的 shared_pending 队列里,进程里任何一个没屏蔽它的线程都可以处理。
如果当前线程本来是候选人之一,现在换掩码把这个信号屏蔽了,那就得看看有没有别的线程能接手,有的话就让它去处理。如果能接手的这个线程处于睡眠状态,那还得把它唤醒。如果没有一个线程能接手,那这个信号会一直挂着,直到某个线程解除该信号屏蔽。
条件里 thread_group_empty() 判断进程是不是只有一个线程。单线程进程没有这样的烦恼,直接跳过。
后:recalc_sigpending()。
根据新的信号掩码,重新计算 TIF_SIGPENDING 标志位。如果现在有任何一个未屏蔽的信号处于挂起状态,就置该标志位;否则清掉之。
至此,准备阶段结束。此刻的状态是:to 指向绝对到期时刻或者为 NULL;如果用户传了掩码,当前线程的掩码已经换成了用户的,旧掩码存在栈上的 sigsaved 局部变量里。
4.5 再探窗口丢信号问题
处理信号掩码的代码分析完了,但好像还是看不出来 ppoll 是如何把窗口丢信号问题给解决的。
前面 4.1 节里只是稍微解释了下这个丢信号的问题,这里我们彻底来搞清楚来龙去脉。
在开始分析之前,先要捋清一些概念。
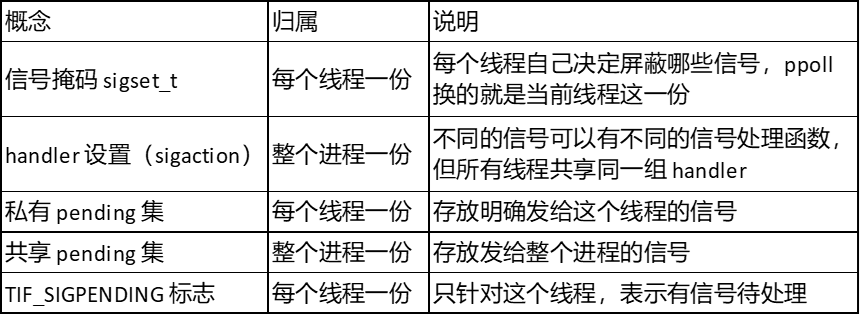
有必要解释下表中的两个 pending 集。
线程定向的信号:明确发给某个线程。来源包括 pthread_kill、tgkill,以及由该线程自己的执行所引起的同步信号,比如它自己触发的 SIGSEGV、SIGFPE。这类信号进入目标线程的私有挂起集合,只能由这个线程处理,别的线程不会替它处理。
进程定向的信号:发给整个进程。来源包括 kill 命令和 kill 系统调用、终端上的 Ctrl+C、子进程退出产生的 SIGCHLD、定时器到期的 SIGALRM 等。这类信号进入进程共享的挂起集合,由内核在进程的所有线程里挑一个没有屏蔽该信号的线程来处理,只处理一次。挑选规则是主线程优先,主线程屏蔽了就在其它线程里找。如果所有线程都屏蔽了它,它就留在共享挂起集合里,直到某个线程解除屏蔽。
上车坐稳扶好,老司机要开车了。
两个角色
信号接收方:调用 ppoll 的线程,也就是当前线程。 信号发送方:向当前线程发送信号的一方,可以是同进程的另一个线程,或者另一个进程,或者内核线程(比如定时器到期)。
两个约定
信号只发给当前线程,不考虑发给整个进程的情况。 发送方运行在另一个 CPU 上,和当前线程是并发的。同一个 CPU 上的情况(比如中断里发信号)道理相通,这里不单独讨论。
三个事实
发送方发信号时,先把信号记入当前线程的挂起集合,然后检查当前线程的信号掩码。如果该信号没有被屏蔽,发送方会给当前线程设置 TIF_SIGPENDING 标志,然后尝试唤醒它。如果该信号被屏蔽,发送方只是记入挂起集合,不设标志,也不唤醒。 信号的实际处理,也就是执行 handler,只发生在当前线程从内核返回用户态的那一刻。线程运行在内核态期间,信号只能处于挂起状态。 一个线程在内核里进入可中断睡眠之前,会检查 TIF_SIGPENDING 标志。标志已设置就不会真正睡过去,会很快回到调用处继续执行后面的代码。
用户态老办法为什么会丢信号
老办法是先调 sigprocmask 放开信号,再调 poll,这是两次独立的系统调用。
第一次调用结束返回用户态时,根据事实 2,如果此时信号送达,handler 就在这里执行了。随后第二次调用进入 poll,此时信号已经处理完毕,挂起集合里没有它,标志也没有设置,poll 检查不到任何东西,于是睡下。
当前线程本来想通过这个信号被叫醒,但信号在它睡下之前就已经被消耗掉了。完美地错过了彼此。
只要换掩码和睡眠是两次系统调用,第一次返回用户态时信号就一定有机会在调用 poll 之前被处理,所以这个问题在用户态无法解决。
ppoll 的做法
ppoll 把换掩码和睡眠放在同一次系统调用里。根据事实 2,从进入 ppoll 到 do_sys_poll 睡下,当前线程一直在内核里,中间不存在返回用户态的时刻,因此信号不可能被提前处理,只能停留在挂起状态。
剩下的问题是:处于挂起状态的信号,能否保证在当前线程睡下之前被它检测到,然后放弃睡眠转而去处理该信号;或者是,当前线程睡下后,收到了信号,发送方能否成功将其唤醒,让它起来处理信号。
注意,用户的需求始终是:当收到用户感兴趣的信号时,poll 要能被及时打断,从而用户可以去处理其它事情。
所以 ppoll 必须要保证:信号任何时候到来,最终都要能中断 poll 的执行,即使线程已经睡下了。
先看一下当前线程的代码流程:
main...poll()... user space-------------------------------------... kernel spacesys_ppoll()...sigprocmask()...__set_current_blocked()spin_lock_irq();__set_task_blocked();...tsk->blocked = *newset;recalc_sigpending();spin_unlock_irq();do_sys_poll()...do_poll()...for (;;) {...if (!count) {if (signal_pending(current))count = -EINTR;}...poll_schedule_timeout()...schedule()...}......
这里只列出了和当前讨论的问题有关的代码。说明一下几个重要节点:
第 12 - 17 行:自旋锁保护的临界区,在这里完成了信号掩码和 TIF_SIGPENDING 标志位的更新。4.4 节刚分析过这部分。
第 24 - 27 行:如果一个 fd 都没有就绪(count == 0),那就检查是否有挂起的信号。如果有,则返回 -EINTR。INTR 就是 interrupt 的缩写,表示 poll 调用被信号中断了。
第 29 行:能跑到这里,说明既没有就绪的 fd,也没有挂起的信号,那就只能睡下了。最终会调用 schedule() 主动让出 CPU。
信号可能在上面流程的任意时刻到来,我们分段来拆解。还是以 SIGUSR1 为例来说明。
情况一:信号在线程还运行在用户空间的时候发出
此时,接收方(当前线程)的信号掩码还没有更新,SIGUSR1 是被屏蔽的。于是,发送方只是把信号记入当前线程的挂起集合,不会去设置 TIF_SIGPENDING 标志位。
等到线程运行到第 12 - 17 行的临界区时,recalc_sigpending() 发现新的信号掩码里放开了 SIGUSR1,于是就会重新设置 TIF_SIGPENDING 标志位。
这样,当线程跑到第 24 - 27 行时,发现有挂起的信号,就会返回 -EINTR。signal_pending() 函数本质上就是去检查 TIF_SIGPENDING 标志位。
这个场景相当于 poll 还没睡下去就检测到有信号挂起了,于是返回到用户空间。
情况二:信号在线程陷入内核态但还未跑到第 12 - 17 行的临界区时发出
这个情况对应上面第 6 - 11 行。根据事实 2,线程运行在内核态期间,收到的信号只能处于挂起状态。这个场景下信号掩码也还未更新,所以处理流程和结果与情况一是一样的。
情况三:信号在线程执行临界区时发出
这个情况不可能存在。
发送方发送一个信号的流程大致是:记入挂起集合 -> 检查信号掩码 -> 更新 TIF_SIGPENDING 标志。
这个过程和这里的临界区用的是同一把自旋锁。谁先拿到锁,谁就会先完整执行临界区。也就是说,信号的发送要么发生在这个临界区之前,要么就在之后。
如果是在临界区之前,就相当于情况二;如果是之后,则相当于下面的情况四。
情况四:信号在临界区之后检测挂起信号之前发出
这个情况对应上面第 18 - 23 行。此时新的信号掩码已经生效,TIF_SIGPENDING 标志也已更新。所以,第 25 行的 signal_pending() 必然返回 true,poll 也就自此返回用户空间了,不会走下面的睡眠流程。
情况五:信号在检测挂起信号之后线程睡眠之前发出
这个情况对应上面第 28 - 30 行。这个场景下,信号记入挂起集合,TIF_SIGPENDING 标志也更新。
第 31 行的 schedule() 在把线程调度出去之前,会最后检查一遍 TIF_SIGPENDING 标志:
if (unlikely(signal_pending_state(prev->state, prev))) {prev->state = TASK_RUNNING;
如果 TIF_SIGPENDING 标志置位了,schedule() 就会把 state 改回 TASK_RUNNING,不把当前线程摘出运行队列。这次调度最终也许还是会让出 CPU 给别的线程,但当前线程仍是可运行状态,很快会被调度回来,绝不会长眠不起。
注意上面的流程,schedule() 的调用在 for 循环里,schedule() 返回后线程继续执行,跳回 for 循环,然后再次遇到 signal_pending(),然后 poll 返回。
情况六:信号在线程睡眠后发出
这个场景下,戏份都在发送方。根据事实 1,此时发送方会唤醒睡眠中的当前线程。线程唤醒后又会跳回 for 循环,然后遇到 signal_pending(),最终也成功返回。
小结一下。
我们根据流程,把信号发出时刻的所有可能性都分析了一遍,最终 poll 要么在睡前被拦截返回,要么睡后被唤醒,然后返回。这样完美满足了用户的需求:只要收到了目标信号,poll 都要被中断并返回。
从上面的分析过程,我们可以发现如下几点发挥了巨大的作用:
保护临界区的那把自旋锁 siglock,让换掩码和发信号永远串行化执行。 更新信号掩码后的 recalc_sigpending(),重新决定是否更新 TIF_SIGPENDING 标志位。 调度前对 TIF_SIGPENDING 标志位的二次检查。
这就是全部了吗?
细心的道友可能发现了,在情况五里,我刻意弱化了一个时间窗口,也就是在检查 TIF_SIGPENDING 标志和线程真正被调度出去这之间的时间。
为了更好地理解这个窗口,摘取 __schedule() 的部分代码如下:
static void __sched notrace __schedule(bool preempt){struct task_struct *prev, *next;...smp_mb__before_spinlock();raw_spin_lock_irq(&rq->lock);...if (!preempt && prev->state) {if (unlikely(signal_pending_state(prev->state, prev))) {prev->state = TASK_RUNNING;} else {deactivate_task(rq, prev, DEQUEUE_SLEEP);prev->on_rq = 0;...}...}...next = pick_next_task(rq, prev);...if (likely(prev != next)) {...rq = context_switch(rq, prev, next); /* unlocks the rq */}...}
第 10 行是最后一次检查 TIF_SIGPENDING 标志。第 13 行 deactivate_task() 把当前线程从运行队列上摘下来,第 24 行 context_switch() 真正切换到下一个线程。从第 10 行检查完,到第 24 行切换出去,这期间就是我们说的这个时间窗口。
理论上来说,只要这两步不是机器码层面的原子操作,那这个时间窗口就一直存在,1 ns 的窗口也是窗口。
这个窗口就可能引起问题。
试想一下,如果信号刚好在这个窗口期间发出,由于最后一个 TIF_SIGPENDING 标志的检查已过,此时就算发送方更新了这个标志也于事无补了。而如果发送方又恰好发现当前线程还未真正睡眠,就不去唤醒。之后线程睡下去,可就真的没人唤醒它了。
Linux 每天在数以亿台的设备上运行,这段处理逻辑断不会有问题。那上面说的那个"问题"又是怎么被解决的呢?
要弄清楚这一点,我们得先从睡眠讲起。
两步走的睡眠
前面列出了当前线程大致的代码流程,其中有一个 poll_schedule_timeout() 函数,是用来让自己睡眠下去的。当时只列出了 schedule() 函数,其实它在调用 schedule() 之前还做了一件事:
intpoll_schedule_timeout(struct poll_wqueues *pwq, int state,ktime_t *expires, unsigned long slack){set_current_state(state);...schedule();...__schedule();......}
第 4 行 set_current_state(state) 把当前线程的 state 字段改成 TASK_INTERRUPTIBLE。注意这一步发生在 schedule() 之前,也就是发生在上面 __schedule() 第 10 行 signal_pending_state() 的检查之前。
所以当前线程睡下去,实际上是两步:
1. 先把自己的 state 标记成 TASK_INTERRUPTIBLE。这一步在检查 TIF_SIGPENDING 之前。
2. 然后才把自己从运行队列上摘下来,切换出去。这一步在检查 TIF_SIGPENDING 之后。
那发送方判断当前线程睡了没有,看的是第 1 步还是第 2 步?
看第 1 步。
发送方唤醒接收方的流程里会调用到 signal_wake_up_state(),这个函数定义在 kernel/signal.c:
voidsignal_wake_up_state(struct task_struct *t, unsignedint state){set_tsk_thread_flag(t, TIF_SIGPENDING);if (!wake_up_state(t, state | TASK_INTERRUPTIBLE))kick_process(t);}
第 5 行的 wake_up_state() 定义在 kernel/sched/core.c:
intwake_up_state(struct task_struct *p, unsignedint state){return try_to_wake_up(p, state, 0);}
try_to_wake_up() 也定义在 kernel/sched/core.c:
staticinttry_to_wake_up(struct task_struct *p, unsigned int state, int wake_flags){...smp_mb__before_spinlock();raw_spin_lock_irqsave(&p->pi_lock, flags);if (!(p->state & state))goto out;...smp_rmb();if (p->on_rq && ttwu_remote(p, wake_flags))goto stat;...ttwu_queue(p, cpu);...}
第 7 行读的是 p->state,也就是接收方在 poll_schedule_timeout() 里修改的 state 变量。
注意,第 7 行后面的 state 是函数的第二个参数,追溯到 signal_wake_up_state() 里。它是包含 TASK_INTERRUPTIBLE 标志位的。
也就是说,第 7 行的逻辑是:只要 p->state 包含 TASK_INTERRUPTIBLE,最终的 if 判断就为假,发送方就认为对方在睡,继续往下走唤醒流程;p->state 是 TASK_RUNNING 时才会 goto out 放弃唤醒。
在我们说的那个窗口里,当前线程的 state 早就是 TASK_INTERRUPTIBLE 了,发送方看到的是"接收方已睡眠",一定会去唤醒,不存在"发现它还没睡就不唤醒"这种情况。
所以,就算信号在这个时间窗口内发出,poll 也能最终被中断,因为发送方肯定会去唤醒当前线程。
整个代码分析过程看起来一气呵成,逻辑严丝合缝,但遗憾的是,现实远比代码看上去的样子复杂得多。
现代 CPU 执行一条写指令时,数据会先进入写缓冲,稍后才对其它 CPU 可见,而在此期间后面的读指令是可以提前执行的。也就是说,代码上"先写再读"的顺序,在其它 CPU 眼里可能变成"先读再写"。
这个特点有个专业术语叫乱序执行。由于 CPU 的乱序执行,虽然 set_current_state() 是在窗口之前设置了 state 为 TASK_INTERRUPTIBLE,但并不意味着这个设置对其它 CPU 就立刻可见。
发送方的 CPU 读到的 state 可能并不是最新的包含 TASK_INTERRUPTIBLE 的值,也就是说,发送方的 CPU 和接收方的 CPU 两个视角下的 state 值完全有可能不一样。
如果是这样,try_to_wake_up() 第 7 行的 if 判断就有可能是真,从而直接 goto out 不唤醒接收方。
终于找到一个可能存在的场景满足不了用户的需求了!
很遗憾,Linux 社区的大神们是不可能允许这样的 bug 存在的。而解决这个问题的机制才是真真正正保证这个时间窗口也没有问题的关键。
这个机制就是大名鼎鼎的内存屏障。
本文不打算继续剖析了,感兴趣的道友可以自己研究下这部分代码。
本人对内存屏障的认识还比较皮毛,后面有机会再斗胆聊聊这个话题。
5. 第三步:do_sys_poll()
第 29 行:
ret = do_sys_poll(ufds, nfds, to);真正实现 poll 功能的函数。
这个函数后面会单独分析。这里暂时只需要知道:它可能返回 -EINTR,而且它返回的时候,当前线程的信号掩码还是用户给的那个。
6. 第四步:处理返回值
第 31 - 45 行:
/* We can restart this syscall, usually */if (ret == -EINTR) {/** Don't restore the signal mask yet. Let do_signal() deliver* the signal on the way back to userspace, before the signal* mask is restored.*/if (sigmask) {memcpy(¤t->saved_sigmask, &sigsaved,sizeof(sigsaved));set_restore_sigmask();}ret = -ERESTARTNOHAND;} else if (sigmask)sigprocmask(SIG_SETMASK, &sigsaved, NULL);
按 ret 是否等于 -EINTR 分成两条路。先看简单的那条。
6.1 正常返回
第 44 - 45 行:
} else if (sigmask)sigprocmask(SIG_SETMASK, &sigsaved, NULL);
ret 不是 -EINTR,说明这次等待不是被信号打断的,要么有 fd 就绪了,要么超时了,要么出了别的错。
如果之前换过掩码,现在就把 sigsaved 换回去。第三个参数传 NULL,表示不需要再备份了。
这里可以顺便想一个问题:如果 SIGUSR1 信号恰好在 do_sys_poll() 返回之后、这里的 sigprocmask() 执行之前到来,会怎么样?
答:它会挂起,然后在 ppoll 返回用户态的路上被处理。此时信号掩码还是新的,SIGUSR1 是放开的,所以发送方会把当前进程的 TIF_SIGPENDING 标志置位。等到 ppoll 返回用户态的时候,发现该标志置位,就会去执行 do_signal() 处理信号。
有点懵?没关系,接着往下看。
6.2 被信号打断
ret 等于 -EINTR,说明 do_sys_poll() 是被信号打断返回的。按常理,接下来应该把掩码恢复回去。
但代码没有这么做。注释解释了原因:现在还不能恢复掩码,要让 do_signal() 在返回用户态的路上先把信号送出去,然后再恢复。
为什么现在不能恢复?
关键在于理解信号是如何被送达的。
所谓送达(deliver),是指内核修改用户态的寄存器现场,让线程返回用户态后先去执行 handler。这件事不是在信号到来的那一刻做的,而是在线程返回用户态的路上做的。
上一篇最后提到的 ret_fast_syscall 会检查 TIF_SIGPENDING 标志位,发现置位就走 work_pending 慢路径,调 do_notify_resume(),再调 do_signal(),由它取出信号并送达。这一切都发生在 sys_ppoll() 返回之后。
一个信号要在这个时刻被送达,有两个条件得同时满足。
第一,TIF_SIGPENDING 必须置位,否则 ret_fast_syscall 压根不会跑到 do_signal()。
第二,这个信号在取出的那一刻不能被掩码屏蔽,否则 do_signal() 只会看到一个屏蔽中的挂起信号,不会取出它。
两个条件检查的都是返回用户态那一刻的状态,和信号到来时的状态无关。
现在假设我们偏偏就要在这里就把旧掩码换回去,看看会发生什么。
用户用 ppoll 临时放开了 SIGUSR1,SIGUSR1 到来,把 do_sys_poll() 打断了。此时我们调 sigprocmask() 恢复旧掩码,SIGUSR1 又被屏蔽。
还记得 sigprocmask() 的实现吗?它最后一步 recalc_sigpending() 会按新掩码重新计算,发现 SIGUSR1 已被屏蔽,于是把 TIF_SIGPENDING 清零。
接着 ret_fast_syscall 检查 TIF_SIGPENDING,没有置位,不走 do_signal(),而是直接 kernel_exit 返回用户态。
就算退一步,只恢复掩码不清零 TIF_SIGPENDING 标志位。
第一个条件满足,第二个条件不满足。do_signal() 虽然跑到了,但它并不会取出信号并 deliver。
这就把 ppoll 的语义打破了。用户放开这个信号,就是希望它能在 ppoll 期间被处理。信号确实打断了 ppoll,handler 却没跑,程序逻辑就乱了。
所以正确的顺序必须是:先送达信号,再恢复掩码。而送达发生在 sys_ppoll() 返回之后,所以恢复掩码这件事只能委托给后面的返回路径去做。
怎么委托?
第 38 - 42 行:
if (sigmask) {memcpy(¤t->saved_sigmask, &sigsaved,sizeof(sigsaved));set_restore_sigmask();}
第一步:把栈上的 sigsaved 复制到 current->saved_sigmask。
因为一旦 sys_ppoll() 返回,其栈帧就没了,局部变量 sigsaved 也跟着消失。task_struct 里专门有这么一个字段用来保存它:
struct task_struct {...sigset_t saved_sigmask; /* restored if set_restore_sigmask() was used */...}
看一下注释:如果用了 set_restore_sigmask(),这个字段就会被恢复回去。
这里用 memcpy 而不是直接赋值,只是历史写法,效果一样。
第二步:调用 set_restore_sigmask(),在 include/linux/thread_info.h:
/*** set_restore_sigmask() - make sure saved_sigmask processing gets done** This sets TIF_RESTORE_SIGMASK and ensures that the arch signal code* will run before returning to user mode, to process the flag. For* all callers, TIF_SIGPENDING is already set or it's no harm to set* it. TIF_RESTORE_SIGMASK need not be in the set of bits that the* arch code will notice on return to user mode, in case those bits* are scarce. We set TIF_SIGPENDING here to ensure that the arch* signal code always gets run when TIF_RESTORE_SIGMASK is set.*/staticinlinevoidset_restore_sigmask(void){set_thread_flag(TIF_RESTORE_SIGMASK);WARN_ON(!test_thread_flag(TIF_SIGPENDING));}
它在 thread_info 的 flags 里置上 TIF_RESTORE_SIGMASK 这一位。ARM64 上这一位是 20:
#define TIF_RESTORE_SIGMASK 20上一篇分析 el0_svc 时说过,flags 里装着一组 TIF_xxx 标志,返回用户态的路径靠它们决定要不要做额外的工作。
TIF_RESTORE_SIGMASK 标志的意思就是:返回用户态之前,记得把 saved_sigmask 恢复回去。
注意后面那句 WARN_ON。它要求调这个函数的时候 TIF_SIGPENDING 必须已经置位上了。
为什么有这个要求?
因为 ARM64 返回路径检查的是 _TIF_WORK_MASK 这几位,TIF_RESTORE_SIGMASK 并不在其中:
#define _TIF_WORK_MASK (_TIF_NEED_RESCHED | _TIF_SIGPENDING | \_TIF_NOTIFY_RESUME | _TIF_FOREIGN_FPSTATE)
也就是说,只置 TIF_RESTORE_SIGMASK 这一位,返回路径根本不会注意到它。代码设计上它坐了 TIF_SIGPENDING 的顺风车:有信号挂起,返回路径进 do_signal(),do_signal() 顺带处理它。
set_restore_sigmask() 函数上方的注释说的就是这两个标志位之间的依赖关系。
那 TIF_SIGPENDING 此刻一定是置位的吗?
是的。do_sys_poll() 返回 -EINTR 的前提就是 signal_pending() 为真,也就是 TIF_SIGPENDING 置位了。
返回路径上发生了什么?
如果你对上面关于返回路径流程的理解还是比较懵,或者非常感兴趣,请关注下一篇文章。之后回过头来再读这一节,你一定会豁然开朗。
6.3 -ERESTARTNOHAND
处理完掩码,第 43 行把返回值从 -EINTR 改成了 -ERESTARTNOHAND:
ret = -ERESTARTNOHAND;这是一个用户态永远看不到的错误码。它定义在 include/linux/errno.h,注意不是 uapi 目录:
/** These should never be seen by user programs. To return one of ERESTART** codes, signal_pending() MUST be set. Note that ptrace can observe these* at syscall exit tracing, but they will never be left for the debugged user* process to see.*/#define ERESTARTSYS 512#define ERESTARTNOINTR 513#define ERESTARTNOHAND 514 /* restart if no handler.. */#define ENOIOCTLCMD 515 /* No ioctl command */#define ERESTART_RESTARTBLOCK 516 /* restart by calling sys_restart_syscall */
注释有两点要关注:
1. 这几个错误码用户空间永远看不到。
2. 返回这几个错误码的时候 signal_pending() 必须为真。
第一点没什么好说的,代码逻辑就是这么设计的。
第二点,也就是要求 TIF_SIGPENDING 标志位是置位状态。这也比较好理解,返回路径只有在 TIF_SIGPENDING 置位时才会进 do_signal(),而处理这几个错误码的正是 do_signal()。
这行代码看起来只是一个很简单的返回值修改,但我想你一定会有很多疑问:
1. 为什么要把返回值从 -EINTR 改成 -ERESTARTNOHAND?
2. 那么多 ERESTART 开头的错误码,为什么一定是 ERESTARTNOHAND?
3. 这四个 ERESTART 开头的错误码分别是什么含义?它们有什么区别?
这些问题全部都和 Linux 的信号处理有关。这四个 ERESTARTxxx 错误码需要结合 do_signal() 的代码实现才能更好的理解它们。
这里只先简略介绍一二。RESTART,顾名思义,重启的意思。这里重启的对象并不是整个系统,而是系统调用。也就是说,这几个错误码用来决定是否重新执行一次系统调用。
在下一篇文章里分析 do_signal() 时再来展开逐一回答这几个问题。敬请期待。
7. 第五步:写回剩余超时时间
第 47 行:
ret = poll_select_copy_remaining(&end_time, tsp, 0, ret);函数在 fs/select.c:
staticintpoll_select_copy_remaining(struct timespec *end_time, void __user *p,int timeval, int ret){struct timespec rts;struct timeval rtv;if (!p)return ret;if (current->personality & STICKY_TIMEOUTS)goto sticky;/* No update for zero timeout */if (!end_time->tv_sec && !end_time->tv_nsec)return ret;ktime_get_ts(&rts);rts = timespec_sub(*end_time, rts);if (rts.tv_sec < 0)rts.tv_sec = rts.tv_nsec = 0;if (timeval) {if (sizeof(rtv) > sizeof(rtv.tv_sec) + sizeof(rtv.tv_usec))memset(&rtv, 0, sizeof(rtv));rtv.tv_sec = rts.tv_sec;rtv.tv_usec = rts.tv_nsec / NSEC_PER_USEC;if (!copy_to_user(p, &rtv, sizeof(rtv)))return ret;} else if (!copy_to_user(p, &rts, sizeof(rts)))return ret;/** If an application puts its timeval in read-only memory, we* don't want the Linux-specific update to the timeval to* cause a fault after the select has completed* successfully. However, because we're not updating the* timeval, we can't restart the system call.*/sticky:if (ret == -ERESTARTNOHAND)ret = -EINTR;return ret;}
先看四个参数:
end_time:内核内部算好的绝对到期时刻,先前由 poll_select_set_timeout 把用户的相对超时换算而来。 p:用户态超时结构体的指针,为 NULL 表示用户没给超时。 timeval:p 指向的类型,非 0 为 struct timeval (select),0 为 struct timespec (pselect/ppoll)。上一篇文章提到过类似的设计,用来实现同一个函数可以同时给 select 和 ppoll 调用。 ret:准备返回给上层的值。把前面的返回值传到这个函数,说明这个函数有可能会二次修改。
第 7 - 8 行:用户没传超时,没地方写,直接原样返回。没传超时表示无限等待。
第 10 - 11 行:STICKY_TIMEOUTS personality 位:部分老程序(BSD 兼容)要求内核不要改动它们的超时结构体。此时跳过写回,直接到 sticky 处收尾。
personality 变量涉及 Linux 的进程个性机制,用来调节内核对待该进程的行为风格,主要为兼容其它 UNIX 及老程序。
第 13 - 15 行:用户传的是 {0, 0},没有剩余时间可言,不写回。{0, 0} 表示用户只是希望 poll 非阻塞地轮询一次,不管有没有 fd 就绪都立刻返回。
第 17 行:获取当前时刻。
第 18 行:用绝对到期时刻减去当前时刻,得到剩余时间,用 rts 接收。
第 19 - 20 行:如果算出来的剩余时间为负数,表示已过期,但不能返回负数,而是归零。
第 22 - 30 行:timeval 非零,表明是 select() 在调用当前函数,超时结构体用的是 struct timeval。
memset 是为了防止 struct timeval 在某些平台上有填充字节,把内核栈上的垃圾数据泄露给用户态。
后面的代码则是用 struct timespec 的值来填充 struct timeval,最后写回给用户。
第 31 - 32 行:ppoll 走 else 分支,不需要转换,直接使用 copy_to_user() 把 rts 写回到用户的 tsp 指向的内存。
copy_to_user() 和 copy_from_user() 是一对,方向相反,同样返回没拷贝成功的字节数。返回 0 说明写成功,整个函数原样返回 ret。
第 34 - 40 行:首先,代码走到这里,说明要么 STICKY_TIMEOUTS 命中,要么 copy_to_user() 失败了。两种情况都说明剩余超时时间没更新成功。
再来看注释:
1. 如果应用程序把它的 timeval 放到了一块只读内存里,那么 copy_to_user() 肯定会拷贝失败,但我们也并不想因为这次剩余时间的更新而引起错误,毕竟这只是一个 Linux 特有的附加行为,而且 select/ppoll 已经成功执行完了。
2. 由于我们没能成功更新剩余超时时间,所以我们不能 restart 系统调用了。
第 42 - 45 行:完成了对注释的解读,这几行代码就很好理解了。
6.3 节简单提到过,返回值 -ERESTARTNOHAND 决定了后面的返回用户态路径是否重启系统调用。假设我们要重启,那么当再次调用 ppoll 时,肯定不能传原始的超时时间了,而应该把剩余超时时间作为参数传给第二次调用的 ppoll,否则整个语义上的超时时间就被放大了。
但现在剩余时间更新失败,重启系统调用的依赖条件已经不满足了,所以只能放弃重启。
这里是把返回值又设置回了 -EINTR。进一步思考,既然写回失败,那能不能考虑返回 -EFAULT 报错呢?
答案是不合理。注意,poll/select 这次调用本身已经成功完成了,该等的时间等了,该报的 fd 也报了。把剩余超时时间写回用户只是 Linux 额外做的善意之举,并非调用成败的一部分。仅仅因为这点好意没做成就把整个成功的调用判成失败,不合理。
所以,返回 -EINTR 通知用户本次调用被信号中断,是最合理的选择。
8. 返回
第 49 行:
return ret;这里的 return 是从 SYSC_ppoll() 返回,回到上一篇分析的 SyS_ppoll(),它把 ret 放进 long 类型的返回值原样返回。
SyS_ppoll 和 sys_ppoll 是同一个函数,于是执行流回到 el0_svc 里 blr x16 的下一条指令 b ret_fast_syscall,此刻 x0 里就是这个 ret。
ret_fast_syscall 的第二条指令就是把它存进 pt_regs 的 regs[0]:
ret_fast_syscall:disable_irq // disable interruptsstr x0, [sp, #S_X0] // returned x0...
后面就是返回用户态的流程了。
sys_ppoll() 所有可能的返回值汇总如下:
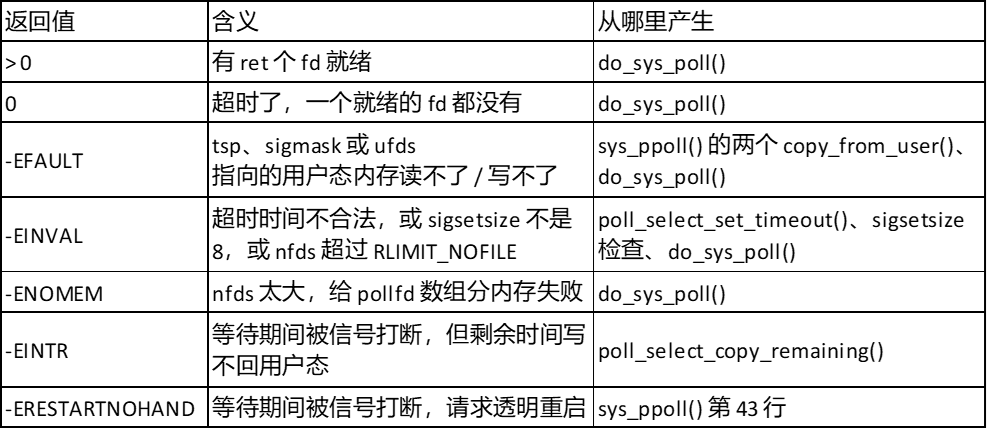
其中 -ERESTARTNOHAND 会在 do_signal() 里被处理掉:要么变成 -EINTR,要么重启系统调用。用户态最终能看到的,只有前六种。
9. compat_sys_ppoll()
上一篇第 6 节提到,32 位程序调用 ppoll 走的是 compat_sys_call_table[336],也就是 compat_sys_ppoll()。
它的实现在 fs/compat.c 里,用 COMPAT_SYSCALL_DEFINE5 定义。函数体和 sys_ppoll() 几乎相同,只在参数类型和拷贝方式上有差别:
COMPAT_SYSCALL_DEFINE5(ppoll, struct pollfd __user *, ufds,unsigned int, nfds, struct compat_timespec __user *, tsp,const compat_sigset_t __user *, sigmask, compat_size_t, sigsetsize){compat_sigset_t ss32;sigset_t ksigmask, sigsaved;struct compat_timespec ts;struct timespec end_time, *to = NULL;int ret;if (tsp) {if (copy_from_user(&ts, tsp, sizeof(ts)))return -EFAULT;to = &end_time;if (poll_select_set_timeout(to, ts.tv_sec, ts.tv_nsec))return -EINVAL;}if (sigmask) {if (sigsetsize != sizeof(compat_sigset_t))return -EINVAL;if (copy_from_user(&ss32, sigmask, sizeof(ss32)))return -EFAULT;sigset_from_compat(&ksigmask, &ss32);sigdelsetmask(&ksigmask, sigmask(SIGKILL)|sigmask(SIGSTOP));sigprocmask(SIG_SETMASK, &ksigmask, &sigsaved);}ret = do_sys_poll(ufds, nfds, to);...}
32 位程序的 struct timespec 是两个 4 字节字段,共 8 字节,和内核 16 字节的布局不一样。所以要先拷贝进 struct compat_timespec(定义在 arch/arm64/include/asm/compat.h),再把两个字段分别传给 poll_select_set_timeout()。
信号掩码同理。先拷贝进 compat_sigset_t,再用 sigset_from_compat() 拼成内核的 sigset_t。两者都是 8 字节,但 compat 版本是两个 32 位的字,内核版本是一个 64 位的字。
在小端机器上两种布局的内存内容恰好一样,但在大端机器上不一样,所以不能偷懒直接按 8 字节拷贝,得把两个 32 位的字显式拼起来。
剩余时间的写回也一样,fs/compat.c 里有一份自己的 poll_select_copy_remaining(),逻辑和第 7 节分析的完全相同,只是最后按 compat_timespec 的 8 字节布局写回。
差异点总结如下:
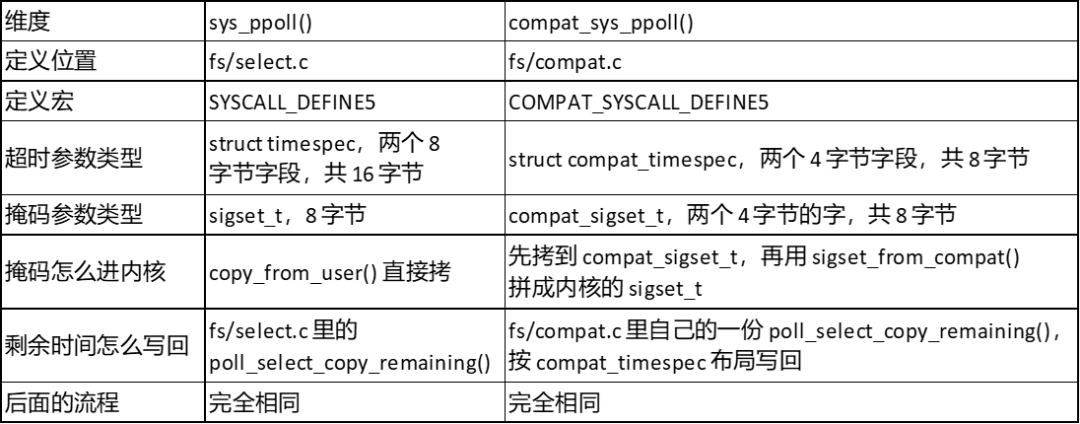
这也解释了上一篇 __SC_COMP 那两个分支的必要性:凡是参数里带有指向 timespec、sigset_t 这类布局随位宽变化的结构体的指针,就需要一个 compat 版本来做转换。
10. 小结
总结一下 sys_ppoll() 的三个阶段:
准备阶段。超时时间一开始就从相对时间换算成单调时钟上的绝对到期时刻,后面所有的等待和剩余时间计算都以它为准。信号掩码的替换是在内核里完成的,recalc_sigpending() 保证了更新掩码之前就挂起的信号也不会被漏掉。
干活阶段。一行代码,后面单独成篇来分析。
收尾阶段。被信号打断时,掩码不能立即恢复,要等返回路径上 do_signal() 把信号送达之后再恢复,否则唤醒 ppoll 的那个信号会因重新屏蔽而无法送达。为此内核在 task_struct 里准备了 saved_sigmask 字段和 TIF_RESTORE_SIGMASK 标志。返回值被换成用户态永远看不到的 -ERESTARTNOHAND,由 do_signal() 决定是透明重启还是变回 -EINTR。而透明重启的先决条件,是剩余超时时间成功写回了用户态。
可以看到,一个五十行的入口函数,真正复杂的不在它自己,而在它和返回路径之间的默契。sys_ppoll() 准备了 saved_sigmask、TIF_RESTORE_SIGMASK、-ERESTARTNOHAND、orig_x0 这几样东西,返回路径上的 do_signal() 在几百行代码之外再把它们一一接住。而这么设计的原因,很重要的一点是为了保证信号能成功送达。分析内核代码时,这种跨越函数边界的约定往往才是最难理解也最迷人的地方。
下一篇我们就来分析系统调用从内核态返回用户态的过程,其中 do_signal() 函数是重点之一。