ARTICLE · 1019796
如何训练 AI 使用工具:谷歌 ToolGrad:把造数据的逻辑反过来
训练 AI 使用工具,一直是 AI Agent 领域的核心难题之一。而谷歌最新发表于 ACL 2026 的研究 ToolGrad,用一个"反直觉"的思路,把这件事的效率和成本都推到了新的量级。
01
PART
先出答案,再出问题
AIToolGrad
要让大语言模型学会调用 API、使用各种工具,首先需要大量的训练数据——也就是"用户提了什么问题、模型如何一步步调用工具解决"的完整记录。
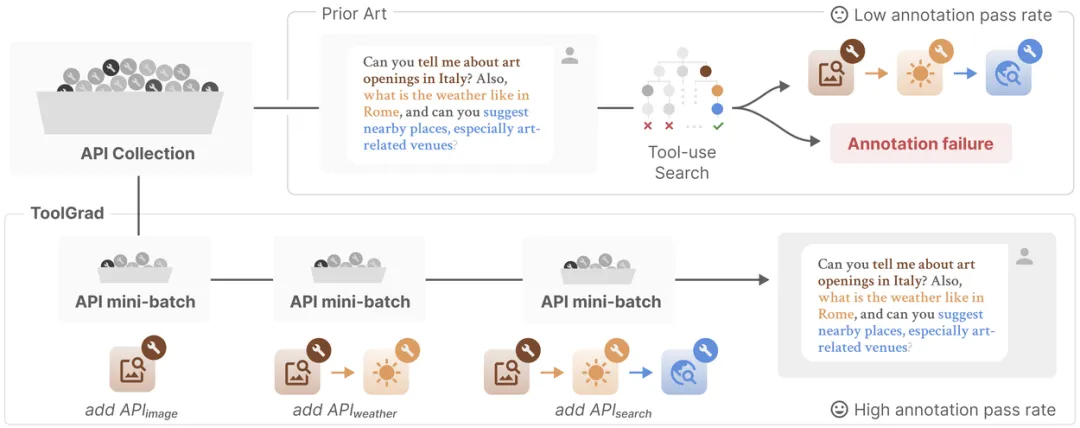
过去业界的主流做法是这样的:先随机从 API 库里抽一批接口,想象出一个用户可能会问的问题,然后用一个 Agent 去"摸索"——通过深度优先搜索,反复试错,找到能解决这个问题的工具调用路径。这个过程本质上是在大海里捞针,成功率低、消耗大、耗时长。
ToolGrad 把这个流程彻底反转:先生成一条有效的工具调用链(也就是答案),再根据这条链去生成对应的用户问题。逻辑很简单——已知答案去出题,远比拿着题去搜答案容易得多。
02
PART
文本梯度的概念?
AIToolGrad
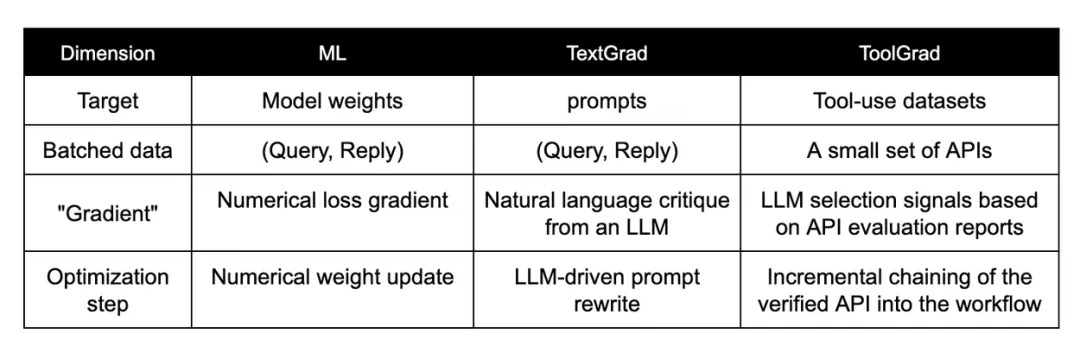
ToolGrad 名字里的"Grad",来自机器学习中的"梯度"概念。传统神经网络通过计算数值损失梯度来更新权重;TextGrad 则将这一思路迁移到提示优化上,用大语言模型生成的自然语言批评意见作为"文本梯度",指导提示词的迭代改进。
ToolGrad 把同样的思路用到了数据集生成上。它不是优化某个固定的提示词,而是用文本梯度来逐步拼出一条完整的、真实可用的 API 调用工作流。
03
PART
四个模块,流水运转
AIToolGrad
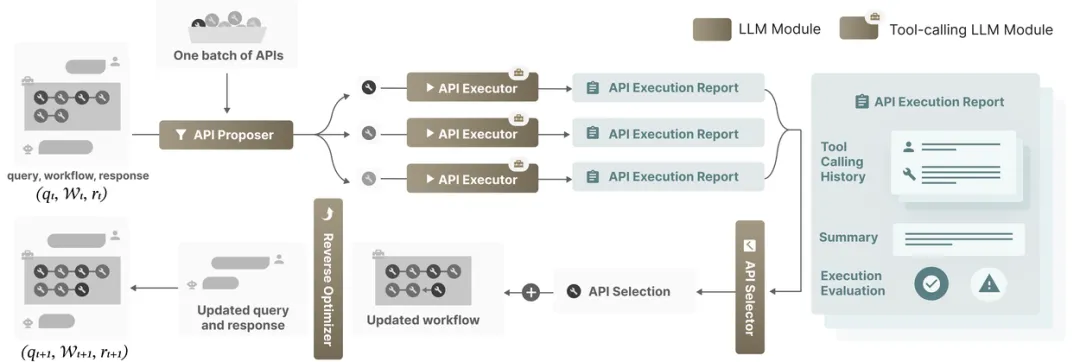
ToolGrad 的核心由四个模块组成,依次负责提议、执行、选择和更新。
首先,API 提议模块从一个大型工具库中筛选出当前步骤最有希望的几个候选接口。然后,API 执行模块并行测试这些候选接口,生成详细的执行报告。接下来,API 选择模块审阅所有报告,选出表现最好的那一个调用,追加到当前工作流中——这个"选出最佳"的反馈本身就是一次文本梯度。最后,大模型更新模块根据新的工具链,同步修订对应的用户问题和 AI 回答。
这四个步骤反复迭代,最终输出一条完整的训练样本:用户问题 + 已验证的工具调用链 + 最终回答。
效率对比:接近100% vs 一路踩坑
实验以 ToolBench 作为 API 数据库(包含 16000 多个真实 API),将 ToolGrad 与旧有的"查询优先"深度优先搜索方案进行对比。结果显示,ToolGrad 能以更低的生成成本,产出更复杂的工具调用数据,且通过率接近 99.8%。传统方法则因为大量搜索尝试失败,通过率远低于此,成本也高出不少。
04
PART
小模型打败大模型
AIToolGrad
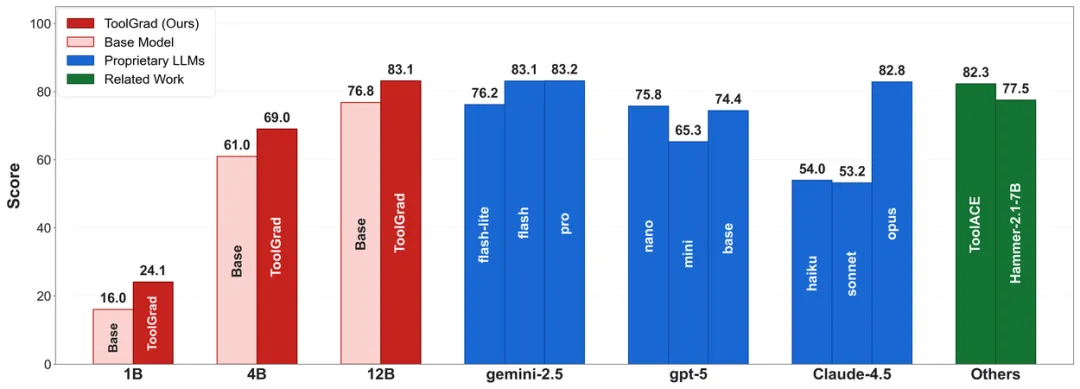
研究团队用 ToolGrad 生成了一个名为 ToolGrad-500 的小规模数据集,对 Gemma-3(1B、4B、12B 三个规格)进行微调,并在 Berkeley 函数调用排行榜(BFCL)上与业界主流模型进行对比。
结果相当亮眼。ToolGrad-12B 在 BFCL 上的得分达到 83.1,与当时最先进的闭源模型高度竞争:gemini-2.5-pro 为 83.2,claude-4.5 Opus 为 82.8,gpt-5 为 74.4。
更有意思的是"自我超越"的现象:ToolGrad-500 数据集本身是用 gemini-2.5-flash-lite 生成的,但在这批数据上微调后的 Gemma-3-12B,最终超越了生成数据的"老师模型"本身。学生超过老师,用的还是老师出的题。
05
PART
意义在哪里?
AIToolGrad
当前 AI Agent 的落地,卡点之一就是"让模型学会正确调用工具"的训练数据太难造、太贵。ToolGrad 提供了一条清晰的新路:不要从问题出发去搜答案,而是先把答案造好,再反过来设计问题。这在逻辑上更自然,在工程上效率更高,在效果上也经过了实验验证。
研究团队指出,未来方向包括将这一框架扩展到更广泛的动态 API 生态,以及探索持续学习和个性化能力,让 Agent 能够随着使用不断进化。