ARTICLE · 1019829
从数据资源到AI能力 鸾宁智能构筑招投标大模型的数据护城河
当行业大模型进入深水区,数据正在成为模型能力持续进化的重要基础
过去几年,人工智能竞争的焦点更多集中在模型:参数规模、推理能力、生成效果,几乎决定了外界对一家A企业的第一印象。
但随着模型能力快速普及,一个更现实的问题正在出现:当大家都能接入大模型之后,行业A《真正的差异化从哪里来?
我们的判断是:模型可以快速迭代,真正难以被短期复制的,是长期积累的行业数据、持续稳定的数据来源,以及数据反哺模型形成的训练闭环。
这也是鸾宁智能近期完成数据知识产权登记、同时持续拓展高质量语料生态合作背后的真正意义。我们不是为了“多拿两张证书",而是在为招投标大模型建立一套可以持续进亻匕的数据基础。
一张证书背后,是自主数据基础能力的建立
近日,鸾宁智能完成“全国各省份各行业公开招投标汇总数据"的数据知识产权登记,并取得对应的数据要素登记凭证。
这两项登记所对应的,并不是对原始公开信息本身的排他性占有,而是企业围绕公开信息进行采集、整理、加工、汇总后形成的数据资源,进一步获得了更加清晰的数据权益登记与资源描述。
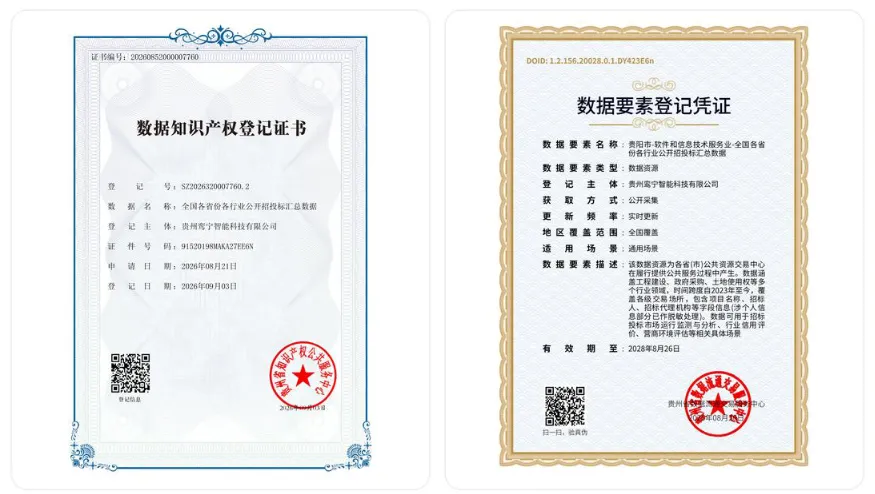
鸾宁智能取得的数据知识产权登记证书及对应数据要素登记凭证
对行业AI来说,自有数据资源的意义,不只是“我有数据”,更重要的是“我有一套能够长期积累、持续更新、不断沉淀行业认知的数据基础"。
更重要的是,鸾宁的数据来源并不只有一条
如果只依赖企业自身积累,数据边界终究有限。真正强的数据能力,需要在自主沉淀之外,持续接入更广泛、更高质量、更加合规可靠的数据生态。
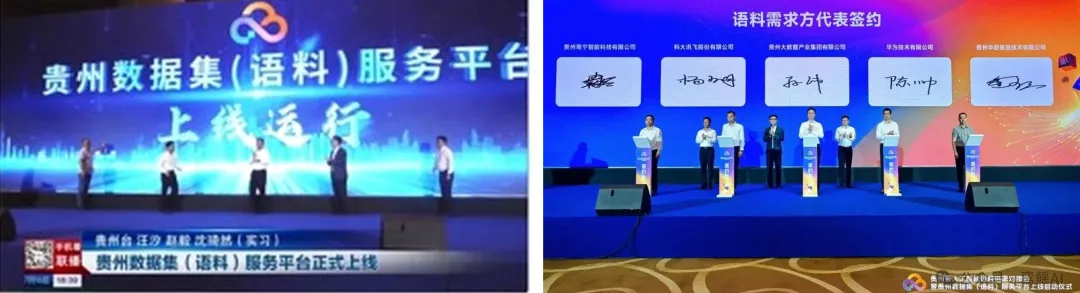
贵州数据集(语料)服务平台上线及人工智能语料供需签约现场
贵州数据集(语料)服务平台由贵州省大数据发展管理局指导、贵州大数据集团建设运营,覆盖语料资源汇聚、数据治理、多模态标注、质量评测、合规审查、交易流通、模型训练与微调、知识库管理、应用孵化与场景对接等全链条能力。平台上线时已汇聚240余家生态伙伴。
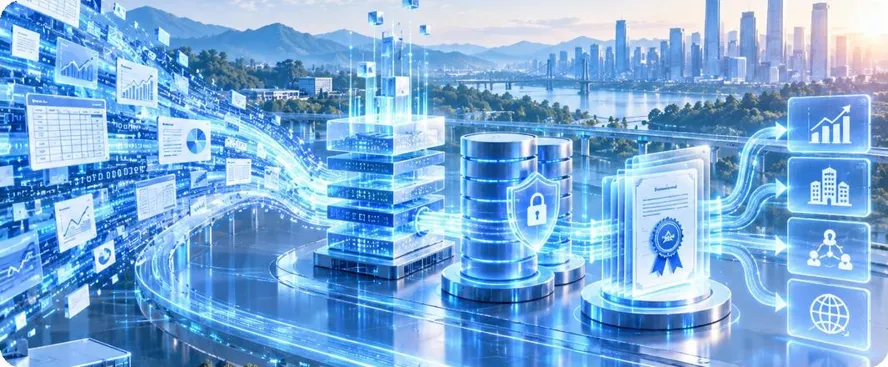
从“有数据”到“用好数据”,关键在于形成可持续的数据资源与价值转化机制
“数据护城河"并不是拥有一份数据文件就能建立起来。真正难以复制的,是一套长期运转的闭环。
第一,自主数据资源持续积累。
围绕公开招投标信息进行长期采集、治理和加工,形成稳定更新的行业数据基础。
第二,生态合作不断拓展高质量数据来源。
依托贵州数据集(语料)服务平台等生态合作,持续接入更丰富的数据与语料资源,降低垂直领域数据获取难、质量不一、合规风险高等问题。
第三,数据真正进入模型训练。
数据不是为了“存起来',而是要进入训练、微调、知识库建设和模型优亻匕过程,让模型对行业规则、业务语言和真实场景形成更氵朵理解。
第四,真实业务再反过来校验模型。
模型在招标、投标、评标等实际场景中不断被使用、验证和纠偏,新的业务反馈继续反哺数据治理与模型迭代。
自有数据沉淀+外部高质量数据生态+持续更新治理+模型训练反馈 +真实行业场景,五者形成闭环,才是行业AI正的数据护城河。
数据、模型与真实场景协同,才能把Al能力真正转化为产业价值
为什么招投标大模型尤其需要这样的数据能力
招投标并不是一个只靠“语言生成"就能解决的场景。它天然具有跨行业、跨区域、长文本、规则密集、专业要求高等特点。不同项目背后,是不同的技术规范、商务条款、评分逻辑、法规要求和企业能力。
如果没有持续、高质量的行业数据支撑,大模型可以“会写,却很难真正“懂业务";可以给出答案,却未必能稳定形成专业、可信的判断。
这也是鸾宁智能为什么要把数据建设放到更底层的位置。围绕招标、投标、评标等场景,我们希望让模型不仅具备通用智能,更逐步形成对行业语言、业务逻辑、历史项目和规则体系的理解。
数据越扎实,模型越能理解行业;场景越真实,模型越能被校验;训练越持续,行业AI业性与可靠性才越有可能形成长期积累。
贵州的“数据优势”,正在转化为AI企业的应用优势
贵州拥有算力、数据和场景等数字产业基础。如今,这些优势正在进一步向高质量数据集建设和人工智能应用转化。贵州数据集(语料)服务平台上承政务与行业高质量数据资源,下接大模型训练及产业应用场景,正是在打通从数据资源到AI应用落地的价值链条。
对于落地贵州“模数工场”的鸾宁智能而言,这种生态意味着:企业不需要孤立地建设一切,而是可以把自身行业理解、自有数据沉淀,与贵州的数据、算力和平台能力结合起来,形成更具持续性的行业AI能力。
AI的下一程,拼的是谁能把数据真正变成能力
今天,大模型能力仍在快速进步。未来企业之间的竞争,可能越来越少地停留在“谁接入了哪个模型",而更多转向谁拥有更高质量的数据基础、谁更理解行业、谁能把数据持续转化为模型能力,并最终把能力稳定交付到真实业务。
从完成数据知识产权登记,到进入贵州高质量语料生态,再到持续推进招投标大模型训练,鸾宁智能正在做的,是把一条更长期的能力链条搭起来。
模型是引擎,数据是燃料,场景是赛道。真正的行业AI护城河,是让三者长期协同、持续进化。
未来,鸾宁智能将继续依托自主数据沉淀与生态合作,持续丰富高质量数据来源,推进模型训练、知识库建设与业务场景融合,让招投标大模型更专业、更可靠、更可信,也让数据真正转化为服务产业的AI生产力。
资料来源:责州数据集(语料)服务平台公开信息、责州日报/人民网/新华财经相关公开报道及责州蛮宁智能登记材料。