ARTICLE · 1020185
vLLM 中的 KV cache 分层卸载:从 GPU 扩展到主机内存、存储与远端节点
长上下文模型和多轮对话会产生大量 KV cache。当加速器内存(例如 GPU HBM)耗尽时,先前计算得到的 KV 数据就会被驱逐。下一个需要这些数据的请求到来时,vLLM 必须从头重新计算。
KV cache 分层卸载会将被驱逐的 KV 数据保存在主机内存、存储和远端节点中。vLLM 可以从较低层级重新加载数据,从而节省计算、降低延迟,并提升集群的有效服务容量。
引入次级层后,KV 数据还可以在节点之间共享,支持缓存容量的水平扩展、从共享存储为新实例进行缓存预热,以及在节点之间传输 KV 数据,用于分离式推理服务或负载均衡。
该框架从 vLLM v0.22 起即可使用,详细配置见使用指南[1]。
以主机内存为中心的设计
核心设计原则是:所有 KV 数据都经过主机内存(CPU DRAM)。
卸载时,KV 数据先从加速器传到主机,再从主机传向文件系统、对象存储或远端节点等次级层。重新加载时,数据流向相反:次级层先将数据提升到主机内存,再加载到加速器。
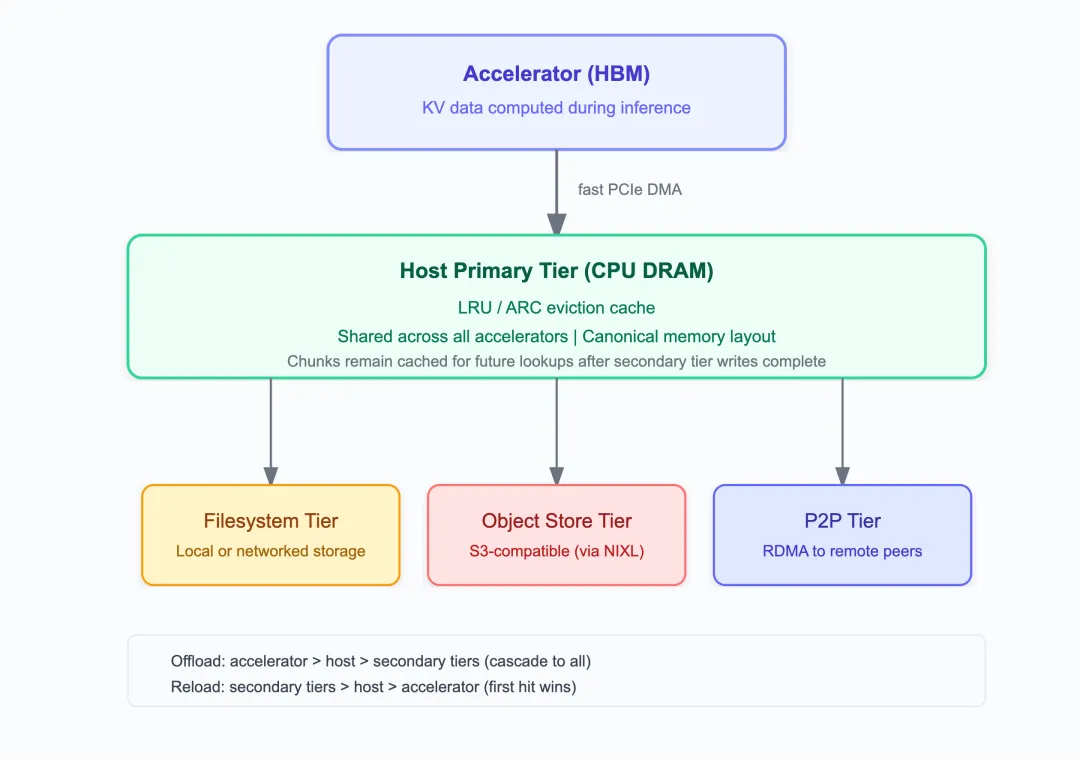
这一设计带来了以下优势。
快速释放加速器内存,按需分配
从加速器到主机的复制是快速的本地 PCIe 传输。复制完成后,加速器内存即可释放,无需等待次级层传输开始。存储写入、网络发送和远端 RDMA 都基于主机上的副本进行,无需再次访问加速器内存。
重新加载时,只有数据在主机内存中就绪后,才会分配加速器内存,无需在等待层间传输时提前预留。两者结合,使加速器内存能够按需分配,仅在实际需要时占用。
合并 I/O
在多加速器配置下(例如 tensor_parallel_size=8),每个设备持有 KV cache 的一个分片。框架会将所有分片汇集到同一块共享主机内存区域。
统一的内存布局
主机内存区域采用统一的标准布局(canonical memory layout):每个页面存储某一层的一个 block,并将各个 TP rank 的所有 KV head 汇集到一块连续区域中。定位任意数据块只需计算偏移量。
固定的主机端布局使节点间能够正确共享数据,即使各节点的 GPU 内存布局不同也不受影响。不同的加速器类型、注意力后端(FlashAttention、FlashInfer、Triton)和并行配置,都会映射到相同的标准表示。
由于这一布局不依赖具体配置,不同配置的节点可以直接共享 KV 数据,无需重新映射或转换格式。对于同一份 KV 数据,TP=2 与 TP=4 的节点会生成相同的主机端数据块。
易于构建的次级层
所有数据都经过主机内存,让次级层更容易开发和运维。次级层在每个 vLLM 实例中以单进程运行,使用标准 CPU 库(POSIX I/O、S3 SDK、RDMA verbs)传输数据,无需访问加速器内存或调用加速器 API。
开发者无需协调多个进程,也无需理解加速器特有的内存布局。
卸载与重新加载的工作流程
操作的基本单位是数据块(chunk),即覆盖一组 token 的固定大小 KV 数据。默认情况下,一个 chunk 对应一个加速器 block。通过配置 blocks_per_chunk,可以使用更大的 chunk,增大主机和次级层的单次 I/O 数据量。
卸载路径
新的 KV 数据块通过异步 DMA 从加速器移到主机。主机复制完成后,加速器内存即可立即释放,无需等待任何次级层传输开始。随后,分层管理器读取主机副本,同时将数据块分发到所有已配置的次级层。
主机主缓存层是一个完整的 LRU/ARC 缓存,而非仅用于中转的缓冲区。数据块会保留在主机内存中,直接响应后续缓存命中。只有主机容量耗尽时,才会驱逐最近最少使用的数据块;即使如此,已接收这些数据块的次级层仍会保留副本。
重新加载路径
调度器首先检查主机缓存。如果数据块就在其中,则立即命中。若主机缓存未命中,则按配置顺序查询次级层,由第一个持有所需数据块的层提供数据。该层异步将数据块提升到主机内存;在此期间,调度器收到 RETRY,并在下一个调度周期重新检查。
同一请求中的不同数据块可以来自不同层。例如,一个数据块来自文件系统,另一个来自远端节点。
次级层
文件系统
文件系统层将每个 KV 数据块作为一个文件,保存到本地或网络存储中。它采用内容寻址命名:相同的 token 序列映射到同一个键,因此匹配的输入会自动共享缓存数据。
当多个 vLLM 实例使用同一个存储挂载点时(例如网络附加存储,或同一节点上的多个实例),它们无需额外配置即可自动共享 KV 数据。
主要特性:
• 非阻塞查询 • 原子写入 • 独立的读写线程池
vllm serve Qwen/Qwen3.6-35B-A3B \ --kv-transfer-config '{ "kv_connector_extra_config": { "spec_name": "TieringOffloadingSpec", "cpu_bytes_to_use": 107374182400, "secondary_tiers": [{"type": "fs", "root_dir": "/mnt/kv-cache"}] } }'对象存储
对象存储层通过 NIXL,将 KV 数据块保存到兼容 S3 的对象存储中,采用与文件系统层相同的内容寻址方式。
它提供了一种成本较低的网络存储选择:每 GB 的成本通常低于高性能文件存储,同时支持多个实例共享访问。
--kv-transfer-config '{ "kv_connector_extra_config": { "spec_name": "TieringOffloadingSpec", "cpu_bytes_to_use": 107374182400, "secondary_tiers": [{ "type": "obj", "bucket": "my-kv-cache", "endpoint_override": "http://minio:9000" }] }}'点对点(P2P)
P2P 层支持通过网络进行跨实例 KV cache 共享。它使用 ZMQ 进行协调,通过 NIXL 使用 RDMA 传输大批量数据。所有传输都在主机内存之间进行,两端均不涉及加速器内存。
P2P 层不负责决定从哪个节点拉取 KV 数据,这是编排层的职责,例如 llm-d[2] 这样的路由器。编排器通过请求中的 kv_transfer_params 驱动跨节点传输。示例和更多细节见使用指南中的编排层协议[3]。
--kv-transfer-config '{ "kv_connector_extra_config": { "spec_name": "TieringOffloadingSpec", "cpu_bytes_to_use": 107374182400, "secondary_tiers": [{"type": "p2p", "host": "10.0.0.1", "port": 5710}] }}'它有两个主要应用场景。
PD 分离
prefill 实例计算 KV 数据块,并将其放入主机缓存层,供其他实例获取。decode 实例通过 RDMA 从 prefill 实例的主机内存中拉取这些数据块。
合并 I/O 将原本按 GPU 分散进行的大量小传输,合并为更少、更大的 RDMA 操作,从而提升网络吞吐。此外,使用 chunked prefill 时,每个完成计算的 prefill chunk 都能立即开始传输,使计算与数据传输重叠,降低 TTFT。
负载均衡
KV 数据块可以从过载的 vLLM 实例传输到仍有可用容量的实例。任意节点都可以从任意对等节点拉取数据块。
关于 llm-d 中的 P2P KV cache 共享,详见相关博客[4]。
混合模型支持
该框架与 vLLM 的混合内存分配器集成,可透明处理组合了全注意力、滑动窗口注意力、MLA、Mamba 等不同层类型的模型。
统一的内存布局将各种 KV 格式规范化为一致的字节缓冲区表示。每个 chunk 在主机上占用固定的字节数,与其中包含哪些层类型无关。
不同层类型会在同样大小的 chunk 中存放不同数量的 token。例如,与全注意力层相比,Mamba 状态层的每个 chunk 覆盖的 token 更多,因此卸载频率更低。
这意味着:
• 滑动窗口层仅重新加载窗口内的 token,无需加载完整历史。 • 状态空间层(Mamba)的状态与注意力 KV 一起卸载和重新加载。
该框架支持 DeepSeek V4、GLM 5.3、Nemotron 3 等先进的混合架构。
可观测性
该框架通过 vLLM 标准的 /metrics 端点暴露 Prometheus 指标:
• 主机缓存利用率:主缓存层当前的填充比例。 • 传输吞吐:加速器与主机之间传输的字节数和耗时。 • 各层延迟:每一层查询和数据传输的耗时。 • 各层命中率:工作负载的数据由哪些层提供。
次级层还可以定义自有指标(counter、histogram、gauge),这些指标会自动注册并暴露,无需修改框架。
KV 事件
随着数据块在各层之间移动,框架会发出结构化的 KV 事件,报告哪些数据块被存入或驱逐、涉及哪个层,以及数据位于本地还是远端。次级层也可以发出自己的事件。
这些事件帮助外部编排系统作出智能路由决策。llm-d 和 NVIDIA Dynamo[5] 等项目利用 KV 事件,将请求路由到最可能命中缓存的实例,相比不感知缓存的调度方式,可获得更高的吞吐和更低的延迟。此外,llm-d 还使用这些事件编排节点之间的 P2P KV 传输。
添加新的次级层
次级层接口十分精简,仅包含四个核心方法:
class SecondaryTierManager(ABC): def lookup(self, key, req_context) -> LookupResult: """Does this tier have a chunk? Returns HIT, MISS, or RETRY.""" def submit_store(self, job_metadata: JobMetadata) -> None: """Start async store from host to this tier.""" def submit_load(self, job_metadata: JobMetadata) -> None: """Start async load from this tier to host.""" def get_finished_jobs(self) -> Iterable[JobResult]: """Poll completed transfers."""每个次级层在构造时,都会获得一个直接指向共享主机内存区域的 memoryview。调用 submit_store() 时,次级层直接从该区域读取 KV 数据;调用 submit_load() 时,则直接向该区域写入数据。整个过程无需中间复制或序列化,次级层直接操作主缓存层的内存。
每个次级层还独立管理自己的驱逐策略。
vllm/v1/kv_offload/tiering/example/ 目录中提供了完整的内存版参考实现[6]。
框架也支持在 vLLM 仓库之外实现次级层:只需在该层的配置中指定 module_path,vLLM 就会加载自定义的 SecondaryTierManager 实现,无需修改 vLLM 本身的代码。
性能:支持更多用户
KV cache 卸载的主要收益,是通过从成本更低的层重新加载 KV 数据,避免代价高昂的重复 prefill。
当并行进行的对话较少时,加速器内存能够容纳全部数据,各种缓存方式都能获得较高吞吐。随着会话池扩大,各层的容量限制逐渐显现。在本文的测试配置下:
• 约 64 个会话以内:HBM 能够容纳工作集,各种缓存方式表现都较好。 • 64–128 个会话:HBM 容量耗尽,不使用卸载时吞吐明显下降。CPU 卸载仍能维持性能。 • 超过 128 个会话:CPU 缓存也被填满。存储卸载仍能保持较高的缓存命中率,Prefill Throughput 达到其他对照方案的两倍以上。 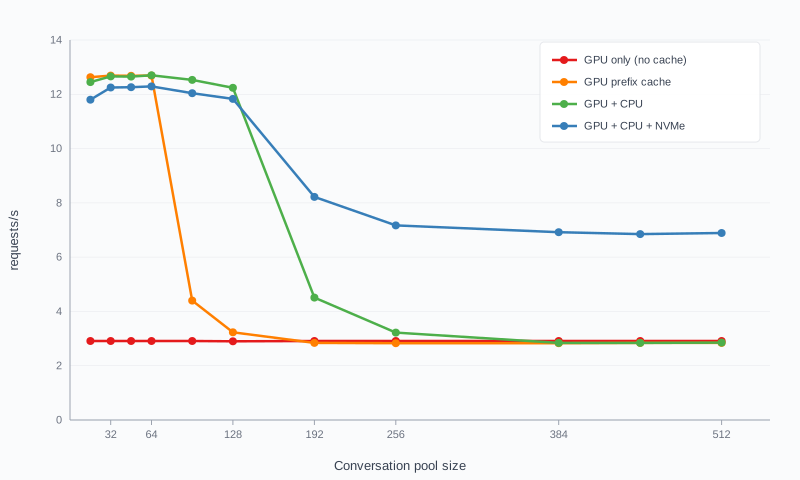
存储的访问延迟高于 CPU 内存,因此无法达到峰值吞吐。但在会话规模扩大后,需要比较的是从存储命中缓存与完整重算的开销,此时存储卸载具有明显优势。
基准测试配置:
• 模型:Qwen/Qwen3.6-35B-A3B,运行于 2× NVIDIA H100(TP=2)。 • 存储层:使用本地 NVMe 的文件系统后端。 • 工作负载:多轮对话,初始提示为 12K token,每轮增加 4K token,共 8 轮。 • 最大请求并发数:64。 • 仅测量 PD 分离配置下的 Prefill Throughput。
完整性能结果与复现脚本见 neuralmagic/fs-offload-experiments[7]。
致谢
感谢 Liran Schour、Chang Guo、Srinivas Krovvidi、Rotem Shavitt、Effi Ofer、Omer Paz、Kfir Toledo 和 Michal Malka 对 KV cache 分层卸载框架设计与实现的贡献,也感谢所有贡献代码、参与评审和提供反馈的社区成员。
参考链接
1. KV 卸载使用指南 — docs.vllm.ai/en/latest/features/kv_offloading_usage/2. llm-d — github.com/llm-d/llm-d3. 编排层协议 — docs.vllm.ai/en/latest/features/kv_offloading_usage/#orchestration-layer-protocol4. llm-d P2P KV cache 共享博客 — llm-d.ai/blog/p2p-kv-cache-sharing-llm-d5. NVIDIA Dynamo — github.com/ai-dynamo/dynamo6. 次级层内存版参考实现 — github.com/vllm-project/vllm/tree/main/vllm/v1/kv_offload/tiering/example7. 性能实验与复现脚本 — github.com/neuralmagic/fs-offload-experiments
vLLM 官方博客
vllm.ai/blog/2026-09-10-tiered-kv-offloading