ARTICLE · 1022245
零代码文档驱动大模型开发---AI办公助手系列-本地知识库让AI跨问答
前几篇,把办公软件从"能转换格式、能编辑 PDF",做到了"AI 能直接动手改文档、填表格",还顺手把简历从写到投做通了。但做得越多,越发现一个绕不开的坎:AI 再能干,它一次也只能"伺候"眼前打开的这一份文档。
电脑里攒了几十上百份文档——周报、合同、会议纪要、项目复盘。想问一句"我上个月那几份周报里,都提到过哪些项目风险?",它会愣住:这问题得翻遍一堆文档才能答,可它眼里只有你正开着的那一份。
这一篇,就是让 AI 从"只看眼前一份",进化到"能翻遍你整台电脑"。
一、项目需求
单文档 AI 的天花板,就是"打开哪份聊哪份"。真正办公的人,问题往往是跨文档的:哪份合同里有这条违约条款?这几个月的销售表里,华东区哪个月最好?
所以要做的是:把本地的 Word、表格、PDF(包括扫描件)变成一座可问答的知识库。你用人话提问,AI 跨文档找答案,并且精确告诉你答案出自哪份文档、哪一段(哪一页、哪一行),点一下直接跳过去。
底线,还是那三条:本地、离线、数据不出本机。文档不上传,把文字变成"向量"这一步在本地算,最后的问答接国内大模型。这条底线,决定了后面几乎每一个技术选择。
二、项目功能
加入知识库:右键任意文档(Word、PDF、表格),点「加入知识库」,填个标签(课程名 / 项目名),本地分块 + 向量化入库。
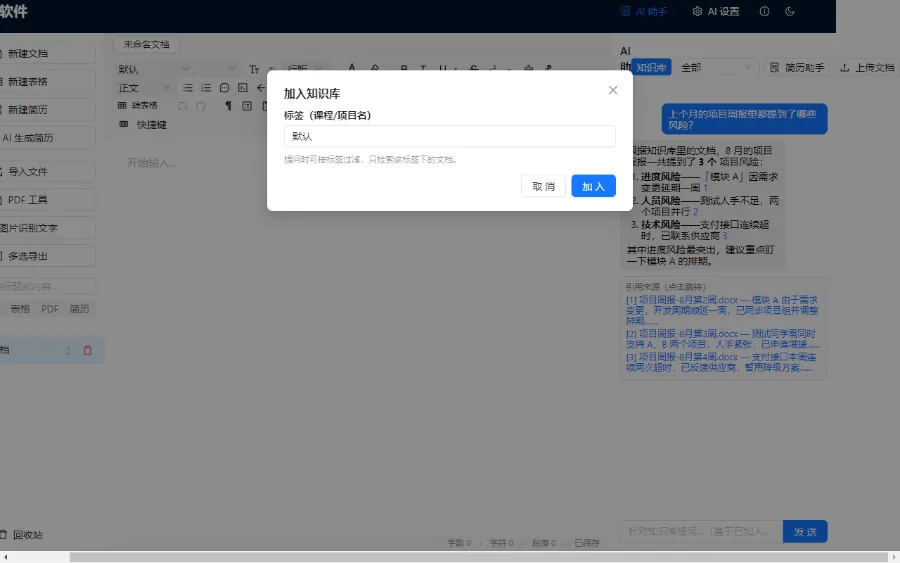
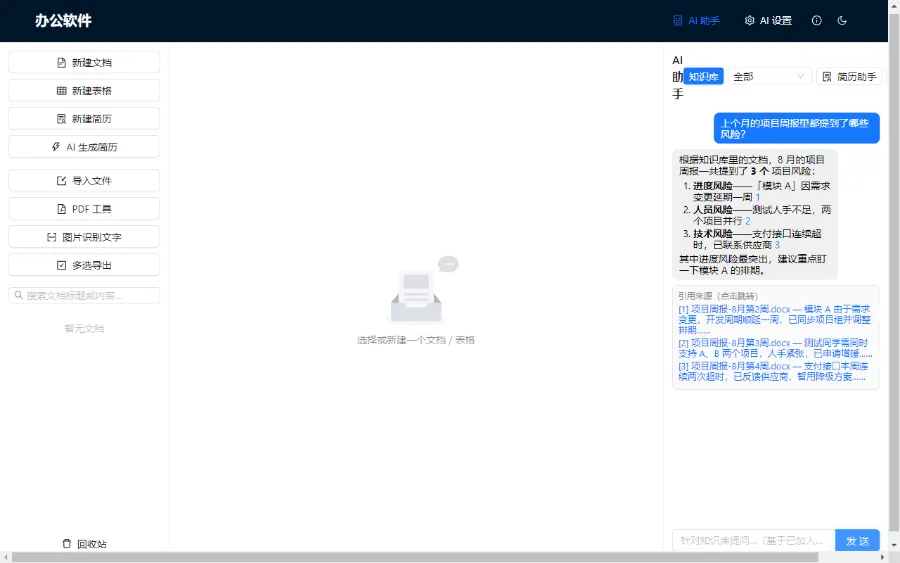
知识库问答:侧栏 AI 面板点「知识库」,切到问答模式,跨文档用人话提问,还能按标签圈定范围。
扫描件进库:没有文字层的图片型 PDF,走本地 OCR 把字认出来,同样能进库。
三、藏在功能背后的思维链
决策一:向量检索,我为什么用"本地小模型 + 笨办法"
知识库问答的套路是"文档切块 → 每块算向量 → 问题算向量 → 找最像的几块喂给大模型"。这里有两个岔路:
一是向量用谁算。云端接口又快又准,但要把文档发出去,违背"数据不出本机"。于是用 onnxruntime 在本地跑一个中文向量小模型(量化后 23MB),跟 OCR 同一个家底,复用不增依赖。
二是向量怎么搜。有专门的向量数据库,但都是原生模块,Electron 打包又要踩坑(OCR 已领教过)。算了笔账:个人本地用,几百几千个分块顶天,拿问题向量逐个算余弦相似度,实测 7 毫秒——根本用不上重型武器。就用这个笨办法,再叠一层 SQLite 全文搜索兜底精确词。
思维沉淀:选型不是越大越全越好,是"够用 + 少踩坑"。本地小模型 + 暴力循环,同时解决"数据不出本机"和"不引入新打包坑"。小规模问题能被笨办法兜住,就别上重型依赖。
决策二:引用溯源,关键不在"能标",在"能跳"
AI 跨文档给答案,最要命的是"不可信"——它从哪找的?是不是瞎编的?不解决这个,知识库问答就是个聊天玩具。
解法是在入库时给每块内容打上"原生坐标":Word 记段落、PDF 记页码、表格记行号。答案里的 [1][2] 渲染成可点链接,点了直接跳过去。
思维沉淀:引用溯源的价值不在"标出来",在"点过去"。跟前几篇"坐标唯一基准"是同一件事——每块内容从进库起就带着它在原文档里的"身份证"。有了它,答案才从"看着像"升级成"可核验"。
决策三:扫描件进库,以及"判空"的坑
扫描件 PDF 是图片,没有文字层,直接提文字是空的,进不了库。解法:提文字是空的→ 判成扫描件 → 逐页渲染 → 本地 OCR 认出字 → 按页存库。 OCR 是之前"扫描 PDF 转 Word"攒的家底,拿来就用。
但踩了个隐蔽的坑:那个 PDF 解析库,即使 PDF 没文字层,也会自动给每页塞"-- 1 of 3 --"这样的页码标记,结果扫描件被误判成"有文字"、跳过 OCR。解法:先把这种自动加的页码过滤掉,再判空。
思维沉淀:"空"要判得干净。判断"到底有没有内容"之前,先确认你依赖的信号干不干净——第三方库的"贴心"默认行为,常常是 bug 的温床。
四、踩坑小记
几条零散但真实的坑:
• 模型路径:打包后模型文件的位置,和开发、测试环境不一样。app.getAppPath()在自动化测试环境会返回一个错误的路径,改用process.cwd()才稳。
• 打包体积:onnxruntime 的 web 版被打进了主进程,白占 20 多 MB。用一个空 shim 顶掉、再在打包配置里排除它,安装包从 339MB 降到 320MB。
• 表格测试快照:手写表格的测试数据,必须带 sheet 的 id 和行列数,否则表格引擎直接报 "No active sheet found"。
• PDF 跳页:跳页逻辑得等 PDF 加载完(页数大于 0)再执行,否则会被提前清掉,跳页失效。
下篇预告
"跨文档"这条线的第一站,走通了。下一步两个方向:一是把现在"标签过滤"的简化版,升级成真正相互隔离的多知识库;二是让 AI"会找"再"会改"——不仅告诉你答案在哪,还能顺手替你把它改掉。