ARTICLE · 1023490
AI能自己变强吗?这篇论文给自我进化浇了一盆冷水
"AI 能自己进化变强吗?"
这个问题最近被问得越来越多。从 GPT 到 Claude,从 Qwen 到 Gemini,模型能力似乎每个月都在刷新上限。于是一个想法顺理成章:既然 AI 已经这么聪明了,它能不能自己教自己,不需要人类插手就变得更强?
听上去很合理。毕竟人类就是这么学习的——你说"我想成为更好的程序员",不会有人把每天学什么、做什么题、怎么检验进步全都给你安排好。你得自己找方向、找材料、检验成果。
但如果把同样的问题丢给 AI 呢?只告诉它"提升数学推理能力",不给具体题库、不给评分标准、甚至不让它看到考试题,它能自己变强吗?
字节跳动 Seed 团队刚刚发表的一篇论文,把这个问题推向了实验台。
01
先搞清楚一个概念
先别急着谈"自我进化"。目前 AI 领域所说的自进化,和你想象的可能不太一样。
现有的自进化研究,本质上是这样的:人类先给定一个明确的任务和评分标准,然后让 AI 自己去收集数据、跑训练、调策略。比如"提高 AIME 数学竞赛题的正确率",任务形式、难度范围、评分规则全都是人类定义好的。
这更像是"给了标准答案,让 AI 自己刷题",而不是真正意义上的自主学习。
这篇论文提出了一个更难的设定——模糊目标驱动的自进化(Vague-Goal-Driven Self-Evolution)。
什么是"模糊目标"? 只给一句自然语言描述的能力方向,比如"提升数学推理能力"或者"成为更好的研究员"。下游评测任务、评分方式、题目内容——全部对智能体隐藏。它必须自己决定:学什么、怎么学、学到什么程度算好。
这才是更接近人类学习的模式。你说"我想学好物理",不会有一份标准答案等着你。你要自己找教材、做题、判断自己有没有进步。
为了测试这个能力,研究团队做了一个叫 Aspire 的基准测试。
02
Aspire 是怎么测的
Aspire 的设计思路很直接:把智能体放进一个"黑箱环境"里,只给它一个目标,然后观察它能不能自己摸索出一条变强的路。
具体来说,它有几个关键设计:
1六个模糊目标:覆盖知识扩展和能力强化两大类,比如"提升数学推理""提升代码生成质量"等
2隐藏评测集:520 道专家编写的测试题,智能体永远看不到题目和答案,只能偶尔拿到一个模糊的总分反馈
3两个进化层面:既可以改模型权重(练内功),也可以改智能体的工具链和工作流(练招式)
4有限查询次数:智能体不能反复刷评测分数来"刷题",反馈是稀缺资源
智能体能做什么呢?它可以搜索和下载数据集、自己生成训练数据、启动各种训练任务、自己做评测、管理不同版本的候选模型——但最终有没有变强,只有隐藏评测集说了算。
打个比方:这就像一个学生准备高考,但他既看不到考试大纲,也看不到历年真题。他只能靠自己判断该学什么、怎么学,偶尔能拿到一次模考的总分。最后高考成绩出来,才知道自己到底学成什么样。
03
结果比预想的更残酷
好了,现在到了最关键的部分:智能体到底能不能靠模糊目标自己变强?
直接看结果。研究团队测试了 5 种不同的决策代理配置,在 6 个能力目标上进行实验,一共 30 组。结果用一张漏斗图就能说清:
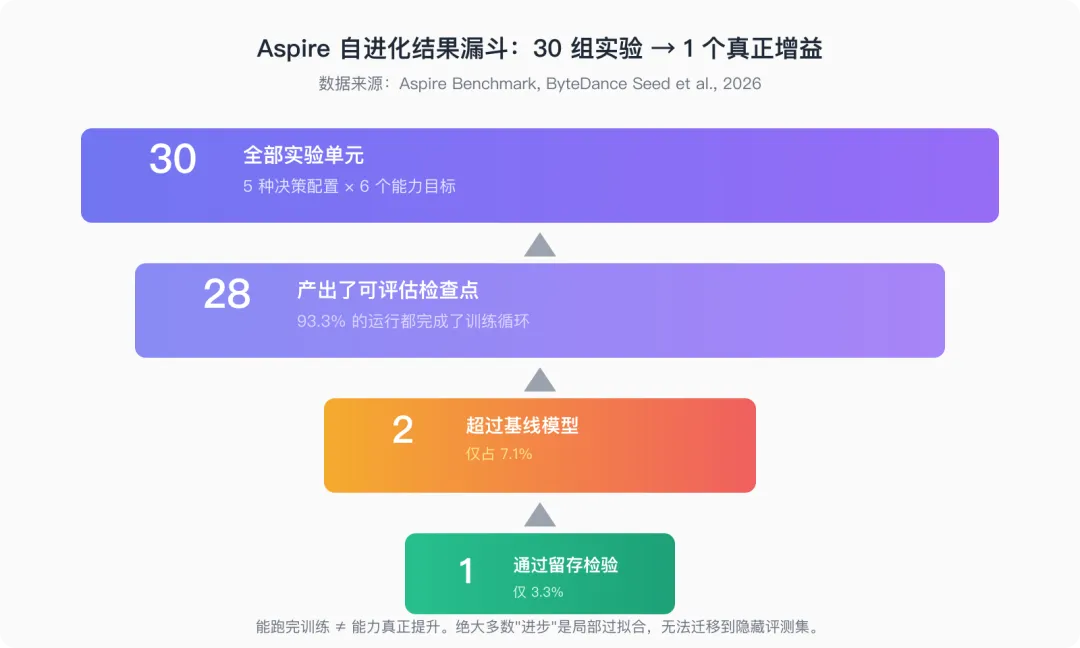
30 组实验里,28 组都成功产出了训练后的检查点——也就是说,智能体很擅长"完成训练这件事"。它会自己找数据、自己跑训练、自己产出新版本。
但继续往下就不好看了。28 个检查点里,只有 2 个在隐藏评测集上超过了原始基线模型。而这 2 个里面,又只有 1 个通过了更严格的"留存检验"——意思是继续训练之后,这个进步还能保住不被洗掉。
30 组实验,只有 1 组实现了真正的、可留存的能力增益。
为什么差距这么大?研究团队发现了几个典型的失败模式。
失败模式一:学的东西和目标不对口
智能体自己选的训练数据,和真正的评测目标经常不匹配。比如目标是"提升数学推理",它可能跑去刷一大堆简单算术题。自己测自己的时候分数涨得很快,但一上真正的考题就露馅了。
这叫代理任务错配——你以为你在练目标能力,其实你练的只是你自己编的那个代理任务的能力。
失败模式二:越训练反而越倒退
更反直觉的是,有些检查点在训练过程中看起来在进步,但实际上只是在从"训练导致的退化"中慢慢恢复回来。
什么意思呢?训练本身可能先把模型搞伤了——比如用数字标签做监督微调,模型会出现"答案格式崩溃",只会输出数字,不会正常回答了。后面看起来分数在涨,其实只是在恢复正常,而不是真的变强了。
失败模式三:自我评价不可靠
智能体太相信自己给自己打的分了。它在自己构造的验证集上看到进步,就以为自己真的进步了。但那个验证集本身就很窄、很偏,进步无法迁移到真正的评测上。
用一句话总结:能跑完训练循环,不等于能力真的提升了。
04
模糊目标改变了什么
除了最终结果,还有一个很有意思的对比:当目标从"明确任务"变成"模糊目标"时,智能体的行为模式发生了什么变化?
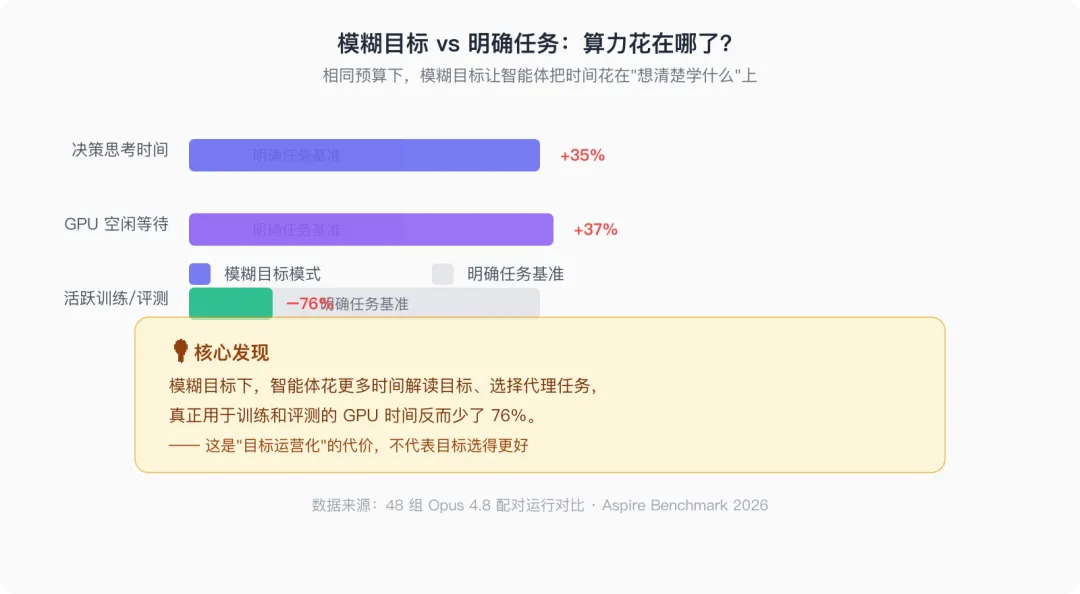
在相同的算力预算下,模糊目标模式中的智能体:
· 决策思考时间增加了 35%
· GPU 空闲等待时间增加了 37%
· 真正用于训练和评测的时间减少了 76%
简单说就是:想得更多,干得更少。
这其实很像人类学习的体验——当目标不明确的时候,你会花很多时间纠结"我到底该学什么",而不是直接开干。这种纠结是必要的,但纠结本身不代表选对了方向。
05
这只是第一道关
Aspire 这篇论文,其实是一个更大研究计划的一部分。这个计划叫"自发展智能体"(Self-Developing Agents),目标是搞清楚真正的闭环自我改进到底难在哪里。
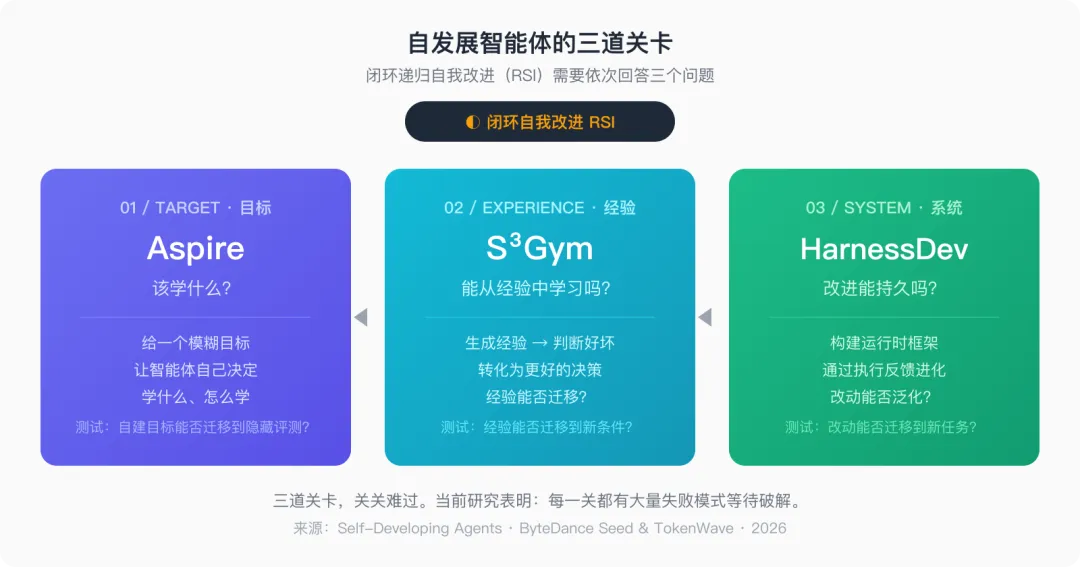
他们把自我改进拆成了三个问题,对应三个基准测试:
第一关:目标(Aspire)—— 该学什么? 给一个模糊目标,智能体能不能自己找准方向?刚才说了,30 组实验只有 1 组成功。这道关就已经很难了。
第二关:经验(S³Gym)—— 能从经验中学习吗? 就算方向对了,智能体能不能从自己的经验里提炼出有用的东西,让下一次决策更好?初步结果也不乐观:自我判断几乎预测不了下一次的进步,不同环境下最优的记忆方法还不一样。
第三关:系统(HarnessDev)—— 改进能持久吗? 就算前两关都过了,改进能不能固化到系统里、在新任务上也管用?答案是:看得见的进步经常在隐藏测试集上站不住脚,64 次版本切换里,可见分数和隐藏分数方向一致的只有 34 次。
三道关卡,关关难过。现在的 AI 自进化,说难听点,连第一道门都还没迈过去。
06
这意味着什么
看到这里你可能会想:说了半天,AI 自进化不就是不行嘛。
也不能这么说。这篇论文的价值不在于"证明不行",而在于——
它第一次把"AI 能不能自己变强"这个模糊的担忧,变成了可以量化、可以重复、可以逐步推进的科学问题。
以前讨论自进化,大家容易走极端——要么觉得"奇点马上到了 AI 要爆炸式自我提升",要么觉得"都是噱头不可能"。但 Aspire 告诉我们:事情没那么简单,也没那么容易。
自进化不是一个非黑即白的开关。它是一条长长的路,路上有很多道关卡。每一关都有自己的失败模式、自己的开放问题。现在我们才刚走到第一关门口,看到了门有多厚。
那短期内有什么实际意义呢?
· 对做模型的人来说:别光看自训练过程中分数涨了多少,要用独立的、隐藏的评测集来检验是不是真进步
· 对做应用的人来说:所谓"AI 自己迭代优化"目前还很早期,别被营销话术忽悠了
· 对关心 AI 安全的人来说:递归自我改进(RSI)的风险短期内可能还不是最紧迫的问题,因为第一关都还没过
✦
最后说一句。
这篇论文最让我有感触的,不是 AI 行不行,而是它让我看到人类学习有多了不起。
你想啊,我们每个人都是从一个模糊的目标出发——"我想学好英语""我想成为更好的设计师""我想搞懂这个领域"——没有人给我们明确的题库和评分标准,但我们就是能慢慢摸索出方向、找到方法、确认真进步。
一句话总结: AI 的"自我进化"目前还处在"能跑完流程但不一定真变强"的阶段。真正的自主学习——从模糊目标出发、自己找方向、自己验进步——人类做得比 AI 好得多。这不是坏事,这恰恰说明我们还有很长的路可以走。
📝 论文信息: 标题:Aspire: Can Models Self-Evolve from Vague Goals? 作者:Yuhao Wu, Jingyuan Zhang, Jiajun Shi 等(ByteDance Seed, SUTD, M-A-P, TokenWave.AI) 发表:arXiv:2608.31111,2026 年 8 月 31 日提交 项目主页:self-developing-agents.github.io
⚠️ 本文为预印本论文解读,论文尚未经过同行评审,结论仅供参考。AI 领域进展迅速,部分结论可能随后续研究更新。