ARTICLE · 1026709
论文推荐 |(西北大学智能软件系统与高效计算研究团队)RDT-MoE:融合冗余削减与混合专家的暴力行为识别方法
杨建锋1 , 于大为 2 , 曹瑞 1
任佳航1 , 王平 1 , 胡琦瑶 3
1.西北大学计算机学院
2.上海华为技术有限公司
3.西北大学电子信息学院


面对暴力行为识别中普遍存在的时空特征冗余与模型泛化不足的双重挑战,文章提出了一种融合稀疏词元选择与混合专家架构的高效识别模型——RDT-MoE。该模型由冗余特征去除模块RDT(redundancy-diminishing token)与参数化混合专家网络(mixture-of-expert,MoE)组成。具体而言,RDT模块基于时空分离注意力机制实现运动特征的解耦,并结合Top-k词元选择策略动态过滤约50%的背景冗余特征,从而显著提升特征表达效率;MoE部分创新性地引入LoRA参数更新策略,采用2阶段训练范式:第1阶段训练RDT模块与编码器以获得LoRA参数,第2阶段以LoRA参数初始化专家网络,并冻结RDT及编码器,仅微调门控与专家组合策略,以增强模型的泛化能力与收敛稳定性。此外,针对现有暴力行为数据集分辨率低、场景单一、样本量不足等问题,构建了一个高分辨率、多视角的暴力行为数据集DVAD(diverse violence action dataset),其数据规模较RWF-2000提升约50%,在场景多样性与应用代表性方面具有显著优势。实验结果表明,RDT-MoE在RWF-2000与DVAD数据集上均优于现有主流方法,在参数量减少约50%的同时,识别准确率分别提升2.00个百分点与2.34个百分点,展现出较高的效率与性能优势。
由于存在时空冗余和现有模型的泛化能力差,视频监控中的暴力行为识别仍然是一项关键但具有挑战性的任务。当前的方法往往难以从杂乱的场景中有效地提取出突出的运动线索,并且无法适应不同的环境。
以Transformer为代表的框架已经在暴力行为识别领域取得了很好的效果,其强大的时空建模能力推动了视频理解模型从卷积结构向自注意力架构的演进。经典方法VideoMAE解决了迁移图像预训练模型的偏执影响,为视频转换器提供了更好的预训练范式。然而现有暴力行为识别研究仍面临3重核心挑战:数据瓶颈、特征冗余与类内交叉相似性,如图1所示。首先,暴力行为涵盖推搡、殴打等多样子类,语义模糊性导致标注标准难以统一,真实场景数据稀缺且分布失衡。其次,视频数据的时序冗余性不仅降低模型训练效率,且干扰关键边缘特征的提取,制约识别精度。最后,单一特征提取器因同时兼顾局部细节与全局上下文的解析需求,往往弱化对判别性线索的聚焦,进而引发跨类别误判。
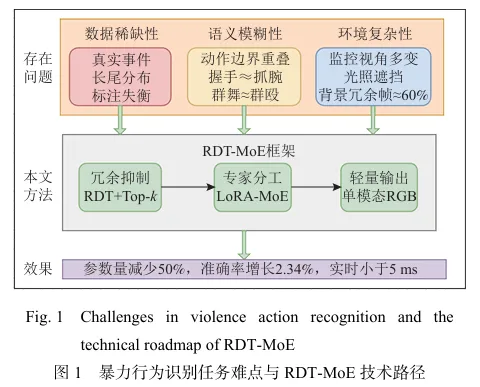
针对上述挑战,现有工作主要从3个方向进行探索:
1)数据增强与弱监督标注。通过时空切片、GAN合成样本等方式扩充数据,并借助半监督或弱监督策略缓解标注稀缺与分布失衡问题。然而,这类方法通常依赖复杂生成模型或额外标注资源,难以适用于大规模监控场景。
2)动态时空注意力与冗余抑制。例如基于自适应词元中止的机制可在一定程度上压缩冗余帧序列和降低计算开销,但此类方法更侧重于“剪枝”与“跳过”,容易忽略动作边缘细节,造成关键信息丢失。
3)多分支网络与对比学习。多路特征提取或对比损失有助于增强跨类别判别能力,缓解语义模糊导致的误判。然而,这些模型通常伴随显著的参数和算力开销,难以兼顾轻量化与实时性需求。
因此,亟需一种既能精确保留重要运动线索又能高效剔除冗余特征,并在低资源条件下保持出色判别性能的统一框架,以更好地应对视频监控中暴力行为识别的3重核心挑战。
针对上述3重挑战,本文提出了一种基于Video-MAE基线并结合冗余感知动态词元模块RDT(redundancy-diminishing token)与混合专家(mixture-of-expert,MoE)网络的统一识别框架,并引入2阶段低秩自适应(LoRA)初始化策略,既能精确保留重要运动线索,又能高效剔除冗余特征,提升暴力行为识别性能。首先,以在Kinetics-400上预训练的VideoMAE作为基线模型,以避免从图像预训练模型迁移所带来的偏差。在此基础上,引入RDT模块,该模块结合分解时空注意力机制与Top-k词元选择策略,剔除冗余特征并保留任务相关的重要信息,显著提升计算效率。随后,在编码器后接入MoE模块,利用其专家多样性进一步增强特征表达能力。针对目标领域数据规模有限的问题,本文提出一种相关任务驱动的2阶段训练策略:第1阶段在融合ViT与RDT的骨干网络上进行训练,并采用LoRA对编码器进行参数高效微调,得到LoRA适配参数;第2阶段冻结编码器与RDT部分,利用前一阶段获得的LoRA参数初始化MoE专家权重,并对该模块进行微调。
本文的主要贡献包括4个方面:
1)构建了一个更具代表性的暴力行为数据集(DVAD)。与现有公开数据集相比,该数据集分辨率更高、规模更大,其采集自监控场景与移动设备真实拍摄的暴力行为视频,同时涵盖多种暴力类型及易混淆的非暴力行为,能够有效提升模型泛化能力,具有较高的实际应用价值。
2)提出RDT,融合时空分离注意力机制与Top-k词元选择策略,可有效识别并剔除视频中的冗余特征,使模型更聚焦于行为相关的重要线索。
3)提出一种结合MoE网络的RDT-MoE混合架构,通过门控网络自适应分配输入至不同专家模型,并对多个专家输出的特征进行加权融合,进一步增强模型表征能力。
4)提出一种基于相关任务驱动的2阶段LoRA参数初始化策略,可在低资源条件下促进专家模型的多样性并提升训练效率,该策略具备较强的迁移性与扩展性,可推广至其他数据稀缺的任务领域。

本文结合MoE网络设计了高效的RDT-MoE模型,不仅显著减少了冗余特征对任务性能的干扰,还有效缓解了单路径模型在捕获判别性特征方面的局限。为进一步提升模型的训练稳定性与专家多样性,本文设计了2阶段的训练策略:第1阶段训练得到LoRA参数,第2阶段利用该参数差异化初始化专家模型,使不同专家具备互补的特征处理能力,并通过冻结主干网络,使优化过程聚焦于门控机制与专家组合策略,从而在保持通用表征能力的同时强化模型对判别性特征的动态选择能力。门控网络采用Top-k稀疏激活策略,根据输入场景特征自适应选择最相关的专家组合并融合输出。综合实验结果表明,所提出的RDT-MoE在暴力行为识别任务中取得了优于现有方法的性能,并展现出良好的泛化性与扩展潜力,可推广至多视角行为分析、公共安全监控等实际应用场景。
杨建锋, 于大为, 曹瑞, 任佳航, 王平, 胡琦瑶. RDT-MoE:融合冗余削减与混合专家的暴力行为识别方法[J]. 计算机研究与发展, 2026, 63(8): 2127-2142. DOI: 10.7544/issn1000-1239.202550743
Yang Jianfeng, Yu Dawei, Cao Rui, Ren Jiahang, Wang Ping, Hu Qiyao. RDT-MoE: Integrating Redundancy Reduction and Mixture-of-Experts for Violence Action Recognition[J]. Journal of Computer Research and Development, 2026, 63(8): 2127-2142. DOI: 10.7544/issn1000-1239.202550743
扫码可获取全文

点个小红心我们一起看
