ARTICLE · 1045837
又一短平快生信模板来了!【网络毒理学+127种机器学习+SHAP】锁定靶点,【分子对接+动力学模拟】验证,2个多月接收属实不错
临床医生做环境暴露相关课题,发文时常被追问两个灵魂拷问:公共数据筛出的一串靶点,为什么优先研究这几个?预测结果有没有患者组织的证据支持?
很多朋友看到这两个问题都会担心这些都需要借实验验证来完成,其实也不用!比如今天云生信畅一发现的这篇文章,刚好就从生信的角度把这两个问题解决了!
这篇来自新乡医学院附院的研究做的是环境污染物TCDD与骨关节炎的分子关联。文章以4套GEO公共数据起步,九成生信只用了两个多月就接收了,周期还是挺短的,适合临床人拿来赶科研任务。一起往下看看人家是怎么解决的吧!
题目:整合机器学习与网络毒理学评估环境污染物TCDD相关骨关节炎风险:一项计算化学信息学研究
亮点
选题上,作者把2,3,7,8-四氯二苯并对二噁英(TCDD)与骨关节炎放在一起研究。既往人群研究曾观察到TCDD暴露与关节炎的关联,但相关性解释不了具体分子过程。而本文则目的则在于把环境暴露线索落到具体的关节疾病问题上,让后续靶点筛选和验证有了明确方向。
思路上,4套GEO芯片数据先做批次校正,差异分析与加权基因共表达网络分析(WGCNA)共同筛出471个骨关节炎相关基因;再与ChEMBL、SwissTargetPrediction和SEA整理的TCDD预测靶点求交,留下43个候选。最关键的升级在这里:本文摒弃了单一算法,而是一次性对比 127 组机器学习算法组合!通过多模型横向比对择优,用SHAP解释候选基因对模型预测的贡献得到5个候选基因,这种多算法组合对比无论是工作量还是结果可靠性对于生信文章来说都是大大的加分项。
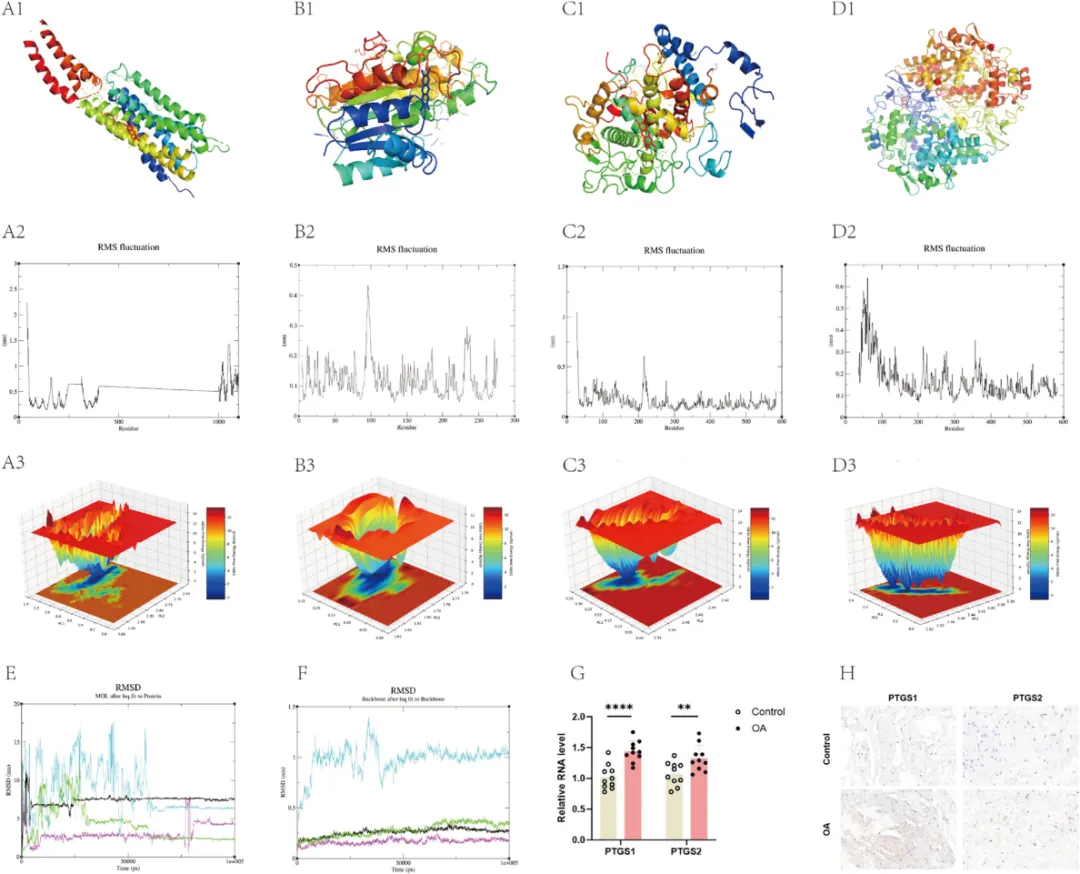
随后免疫分析、分子对接和动力学模拟重点看其中4个蛋白和TCDD的结合能力。最后做PTGS1、PTGS2的人体滑膜qPCR和免疫组化收尾。每一段都在回答上一段留下的问题,篇幅虽长,主线并不散。
如果小伙伴们自己也想尝试一下这个方向但是拿不准思路,菜单栏【转人工】,畅一可以根据大家的idea设计出个性化的方案,再挖掘数据开始做分析,避免走弯路。而且以畅一团队的经验,这些工作量咱们大约1-2个月左右就能完成了。
思路拆解
1. 整合GSE55457、GSE82107、GSE206848和GSE55235共123例样本(骨关节炎69例、对照54例),用ComBat处理批次差异;另留GSE169077和GSE178557做外部验证。
2. 在合并表达数据中找差异基因和疾病相关共表达模块,两路取交集得到471个骨关节炎相关基因。
3. 汇总ChEMBL、SwissTargetPrediction和SEA的TCDD预测靶点,与疾病基因求交,得到43个候选,再分析其相关通路。
4. 比较127种机器学习算法组合,用训练集和两个外部队列评估模型;结合特征选择频率与SHAP解释,缩小候选范围。
5. 根据表达数据估计免疫细胞比例,检查重点基因与免疫细胞的统计关联;再用分子对接和分子动力学模拟考察TCDD与4个蛋白的预测相互作用。
6. 用人体滑膜样本检测PTGS1和PTGS2:qPCR中骨关节炎与对照各10例,另以免疫组化观察蛋白表达。
结果
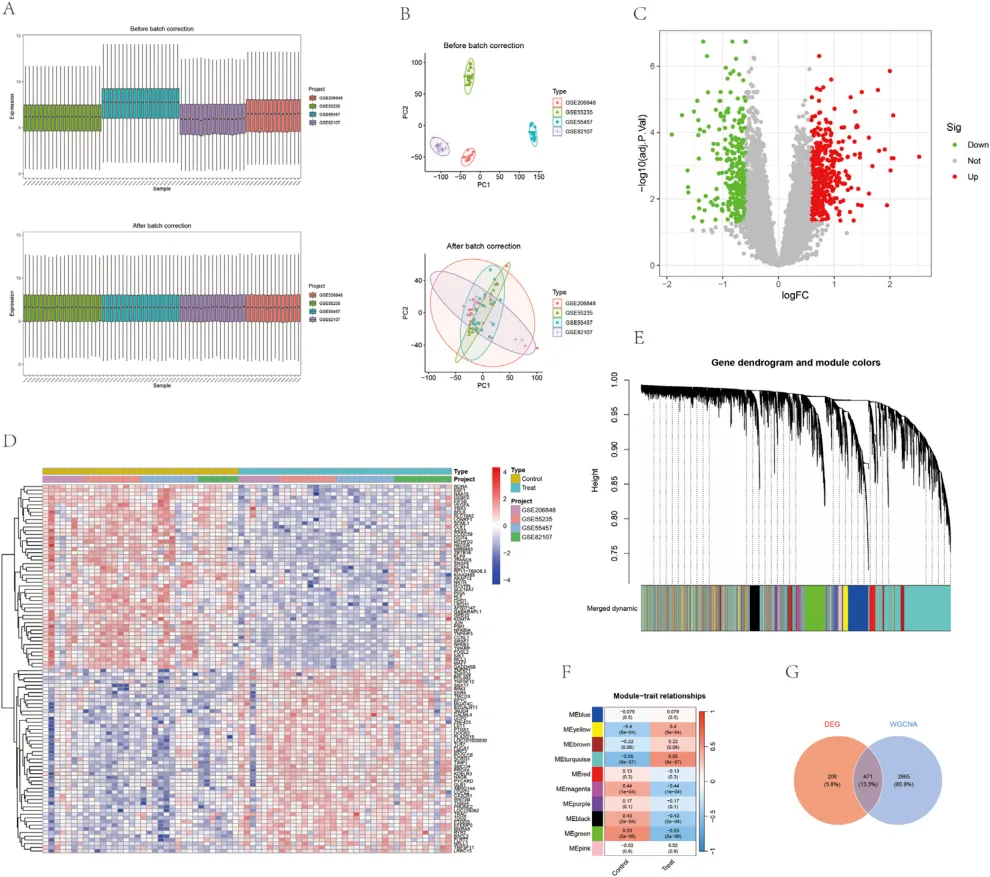
4套芯片合并后,批次校正改善了样本分布。差异分析得到677个基因,与WGCNA疾病相关模块取交后留下471个候选。
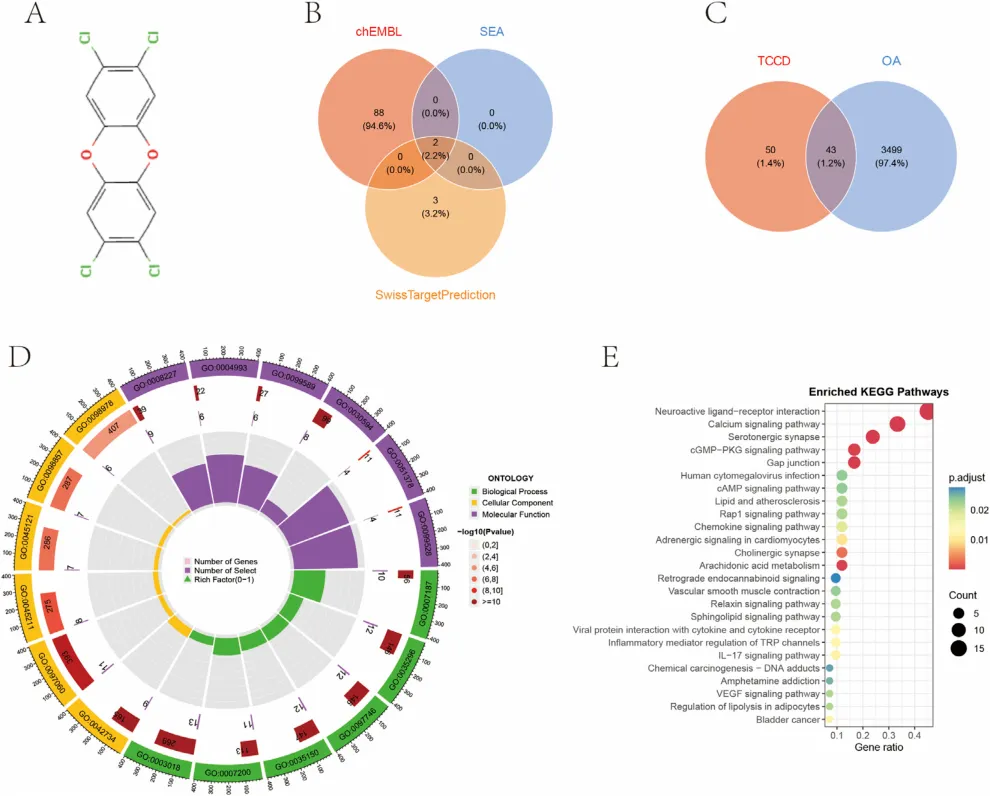
3个数据库汇总出93个去重的TCDD预测靶点,和骨关节炎基因相交得到43个。富集结果涉及炎症、花生四烯酸代谢等过程
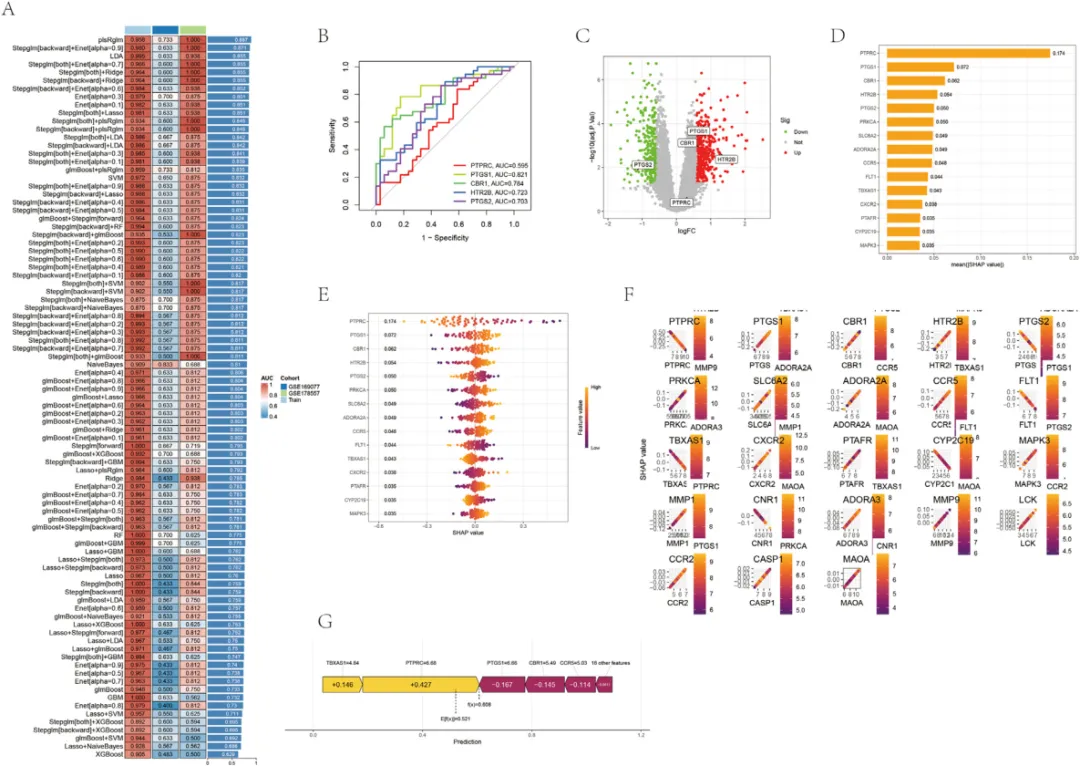
作者比较了127种算法组合,其中89种成功收敛。优选模型提出PTPRC、PTGS1、CBR1、HTR2B和PTGS2共5个候选基因,后续重点讨论其中4个蛋白。单基因ROC里,PTGS1的AUC为0.821,PTPRC为0.595;看结果时也要区分训练集表现与外部验证。
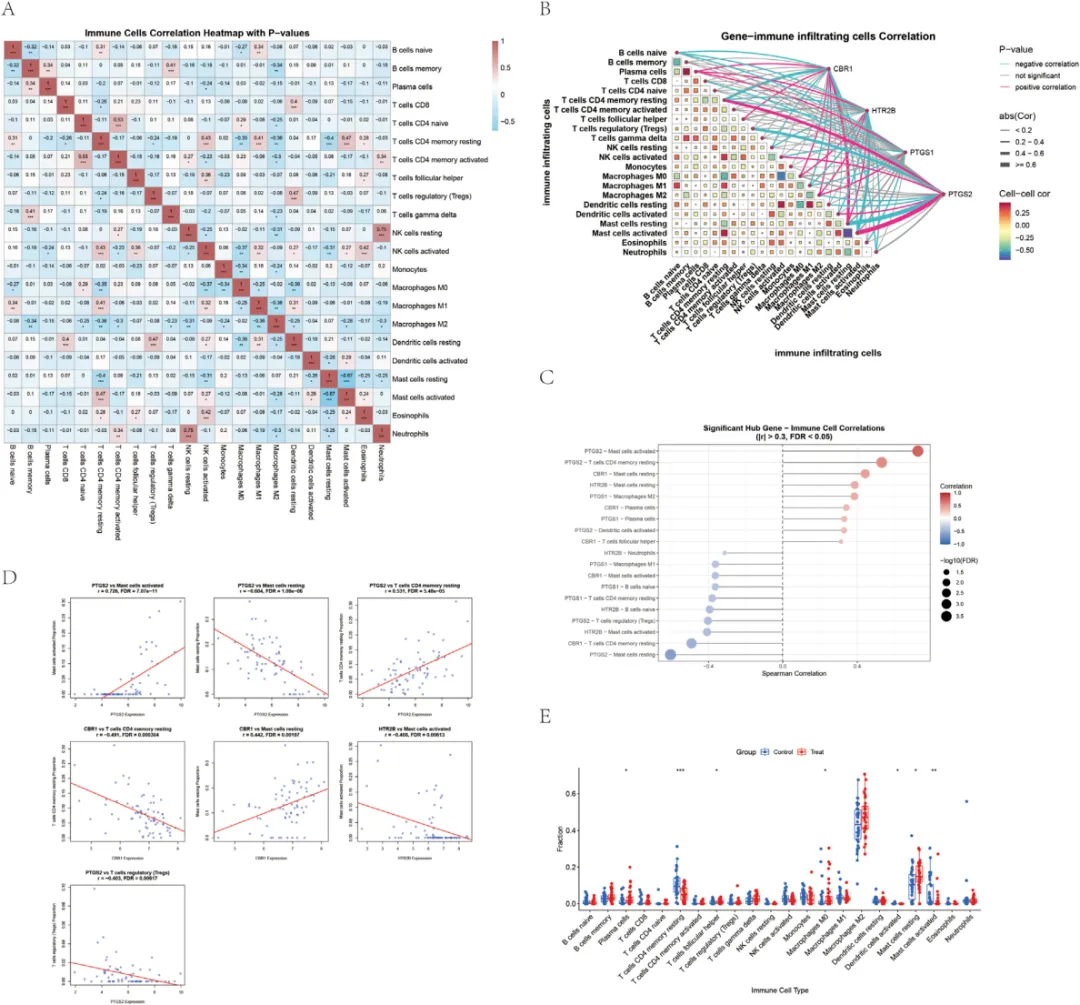
CIBERSORT根据表达谱估计免疫细胞比例,PTGS1、CBR1、HTR2B和PTGS2与部分巨噬细胞、肥大细胞、T细胞亚群呈统计相关。
分子对接中,TCDD与PTGS2、CBR1、PTGS1、HTR2B的预测结合能分别为−8.7、−8.2、−7.8、−6.5 kcal/mol;分子动力学模拟提示预测复合物在模拟条件下保持一定稳定性。研究者还在人体滑膜中检测了PTGS1和PTGS2。
云生信畅一点评
畅一觉得,这篇值得借的是纯生信部分的筛选顺序:先用多队列数据找骨关节炎相关基因,再与 TCDD 预测靶点取交;随后比较 127 种算法组合,用 SHAP 解释候选基因对模型预测的贡献,并在外部队列检验。方法不少,但每一步都有明确任务。
做同类选题,费功夫的往往是开跑前的数据组合:4 套 GEO 芯片能不能合、化合物靶点从哪来、外部队列够不够用。大家要是不想把琐碎的时间耗在这上面,畅一团队能解决啊!从出方案到生信分析再到结果解读,都是咱们的强项,主打一个专业可靠!
此外,大家复现的时候还可以换独立公开队列检验候选基因是否稳定,比较不同模型的筛选结果,再结合免疫浸润或通路分析补充解释。纯生信文章要站得住,关键是让每轮分析回答一个具体问题,并把结论说在数据能够支持的范围内,才能更好的说服审稿人。