ARTICLE · 1050397
智谱,你把 ZCode 源码放出来了,但这还不叫“可验证的开源”
随后,智谱公开了 ZCode 的代码仓库,并表示后续还会引入第三方评估。
这件事情本身当然值得肯定。
但我反而想提出一个更加基础的问题:
你开源的这份代码,究竟是不是现在用户下载、安装、使用的那一份 ZCode?
这不是抬杠。
这是软件供应链里一个非常基础的问题。
因为:
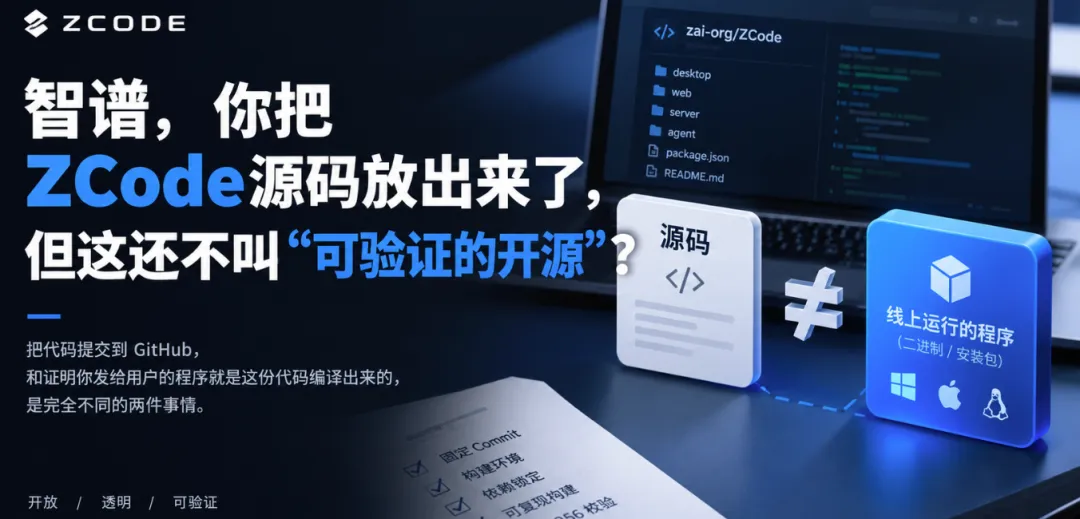
把代码提交到 GitHub,和证明“线上运行的程序就是这份代码编译出来的”,是完全不同的两件事情。
一、GitHub 上有源码,不等于用户拿到的就是这份源码
现在大家看到的是一个公开的 ZCode GitHub 仓库。
从仓库信息来看,里面包含 Desktop、Web、Server、Agent CLI 等多个部分,也提供了本地开发、构建和打包方式。
甚至仓库自己的构建流程中,还提供了生成 sha256.txt 的步骤。
但是问题来了。
这个 SHA256 是谁生成的?
是你本地自己编译出来的包生成一个 SHA256。
还是:
智谱官方发布给所有用户的安装包,在发布时由官方对最终二进制进行签名,并把对应 SHA256 公布出来?
这是两个完全不同的概念。
二、真正需要验证的不是“代码有没有”,而是“代码和二进制有没有对应关系”
假设今天我在 GitHub 上提交一个项目。
源码是:
hello world然后我给你一个已经编译好的程序。
这个程序运行出来是:
hello world你能证明这个二进制就是由 GitHub 上这份源码编译出来的吗?
不能。
除非我把整个构建过程也纳入验证体系。
比如:
Source Code↓固定 Commit↓固定 Build Environment↓固定 Dependencies↓Reproducible Build↓Binary↓SHA256↓Signature
最后用户下载到的东西,必须能够验证:
官方发布 Binary=指定 Commit+指定构建环境+指定依赖
这才叫真正意义上的可验证构建链路。
而不是:
“源码已经放 GitHub 了,大家放心。”
三、这其实是开源世界非常基本的问题
很多人把“开源”理解成:
我把源代码上传到 GitHub。
实际上,这只是Source Available层面的事情。
真正涉及软件供应链安全的时候,还有另外一个问题:
你运行的到底是哪一个 Artifact?
因为现代软件真正交付给用户的,通常不是 GitHub 上那几万行 TypeScript、Rust、Go 或 C++。
用户拿到的是:
DMGEXEAppImageDocker Imagenpm packageCLI Binary
甚至可能还有:
Remote RuntimeServerCDN ResourceElectron BundleNative Module
源码只是起点。
最终用户运行的是 Artifact。
所以真正应该问的是:
Artifact 是否能够被源码证明?
四、尤其是 ZCode,这个问题更加重要
为什么?
因为这次 ZCode 引发争议的,恰恰就是代码到底去了哪里、客户端到底做了什么。
此前社区有开发者对 ZCode 的行为进行了逆向分析,并指出客户端可能涉及仓库快照以及 Git 历史等数据的处理和上传。
智谱随后回应称,问题与“代码库索引”功能有关,并表示相关问题已经修复,同时承诺开源代码库并引入第三方评估。
注意。
这时候大家真正关心的已经不是:
“你有没有一个 GitHub 仓库?”
而是:
“我现在安装的这个 ZCode,到底运行的是什么?”
这是完全不同的问题。
五、如果我是用户,我需要的不是一句“我们开源了”
而是一条完整的验证链。
比如:
① 官方源码 Commit
明确告诉大家:
ZCode vX.X.X对应 Commit:abcdef123456...
而不是:
GitHub main branch因为 main branch 是会不断变化的。
② 官方构建环境
明确:
Node.js xxxpnpm xxxOS xxxCompiler xxxDependency Lockfile xxx
以及:
Build Script到底是哪一个。
③ 官方发布 Artifact
例如:
ZCode-1.2.3-macos-arm64.dmgZCode-1.2.3-macos-x64.dmgZCode-1.2.3-windows-x64.exe
每一个版本都应该对应一个明确的 Commit。
④ 官方 SHA256
例如:
ZCode-1.2.3-macos-arm64.dmgSHA256:xxxxxxxxxxxxxxxxxxxxxxxx
然后用户自己下载。
自己计算:
shasum -a 256 ZCode-1.2.3-macos-arm64.dmg看看是不是一致。
⑤ 最关键:可复现构建
如果开发者自己把源码拉下来:
git checkout abcdef123456然后按照官方文档:
pnpm installpnpm build
理论上应该能够得到:
官方 Binary=本地 Build Binary
至少应该达到可以被独立验证的程度。
这才真正有意义。
六、为什么我特别在意这一点?
因为 AI 软件和普通软件正在发生一个非常大的变化。
过去:
源码 → 编译 → 程序
现在:
源码
↓
Agent
↓
Remote Runtime
↓
CDN
↓
Native Module
↓
Electron
↓
API
↓
模型服务
↓
用户数据
整个链路越来越复杂。
所以现在谈“开源”,已经不能只停留在:
“GitHub 地址给你。”
真正应该讨论的是:
Software Supply Chain Transparency。
也就是:
从源码到最终用户运行程序的整个供应链,能不能被第三方验证?
七、甚至还有一个更加尖锐的问题
假设今天 GitHub 上的源码是:
A官方给用户的二进制是:
BB 是不是 A 编译出来的?
如果没有可验证的构建链路。
用户其实不知道。
理论上,官方完全可以:
GitHub↓开源版本 A
同时:
官方服务器↓商业版本 B
两个版本完全可以存在差异。
我并不是说智谱现在一定这么做了。
没有证据就不应该这么下结论。
恰恰相反。
我要说的是:
如果没有建立验证机制,我们就无法从“源码公开”这个事实本身证明二者相同。
这才是技术讨论应该有的边界。
八、所以我并不是反对智谱开源
恰恰相反。
我认为智谱这一步应该继续往前走。
既然已经选择开源,那就不要只做到:
“代码给你看。”
而应该做到:
“你可以验证我。”
这是两个完全不同的层级。
九、真正值得我们期待的,是 ZCode 的“可验证开源”
我希望未来能够看到这样一个流程:
GitHub Repository↓Release Tag↓Commit SHA↓Build Manifest↓Reproducible Build↓Official Artifact↓SHA256↓Code Signing↓Independent Verification
甚至可以进一步:
SLSASBOMSigstoreReproducible BuildsTransparency Log
这些东西并不是什么神秘技术。
它们解决的都是一个非常朴素的问题:
你下载的软件,到底是不是你看到的源码构建出来的?
十、不要把“开源”变成一个营销词
这也是我真正想说的。
今天国内 AI 公司越来越喜欢讲:
开源。
模型开源。
Agent 开源。
Coding Agent 开源。
客户端开源。
框架开源。
这本来是一件非常好的事情。
但如果我们把:
“上传代码”
直接等同于:
“产品透明”
那其实是在降低开源的标准。
真正成熟的开源生态应该敢于接受验证。
不是:
“相信我们。”
而是:
“你自己验证。”
不是:
“这是我们的源码。”
而是:
“这是我们的源码,这是对应 Commit,这是构建过程,这是官方 Artifact,这是 SHA256,你可以自己编译,也可以让第三方验证。”
这才是真正的工程师文化。
十一、尤其对于 AI Coding Agent,这个标准应该更高
因为 ZCode 这类产品天然拥有非常高的权限。
它可能:
•读取项目源码•读取 Git 历史•执行 Shell•修改文件•调用网络•使用远程 Agent•访问各种 API•处理企业代码
所以用户真正交出去的,不只是几个 Prompt。
而是:
整个开发环境。
当一个工具拥有这种权限时,
“你相信我吗?”
已经不是一个合适的问题。
真正应该问的是:
“你能不能让我验证你?”
十二、这才是开源真正的价值
开源从来不是:
“我把代码放出来,所以你应该相信我。”
开源真正的价值应该是:
“我把实现公开出来,所以你不需要相信我。”
你可以:
阅读源码↓编译↓计算 Hash↓验证签名↓检查依赖↓检查网络行为↓第三方审计↓得出自己的结论
这才是开放软件生态真正应该建立的信任模型。
最后
所以,对于 ZCode 这次开源,我并不想简单地喊:
“智谱开源了,牛逼。”
也不想直接喊:
“智谱开源是假的。”
因为这两个结论都太简单。
我更关心一个工程问题:
你公开的源码,能不能被证明就是用户正在运行的那个程序?
如果不能。
那么我们现在拥有的只是:
一份公开源码。
而不是:
一套可验证的软件供应链。
这两者之间,差了非常远。
真正高级的开源,从来不是让别人“相信你”。
而是建立一套机制:
让别人根本不需要相信你。
这,才应该是 ZCode 开源之后真正需要回答的问题。