ARTICLE · 1076257
58 页 PDF 喂给 AI 怎么问才有用:先切再问三步走,提问模板直接抄
58 页 PDF 喂给 AI 怎么问才有用:先切再问三步走,提问模板直接抄
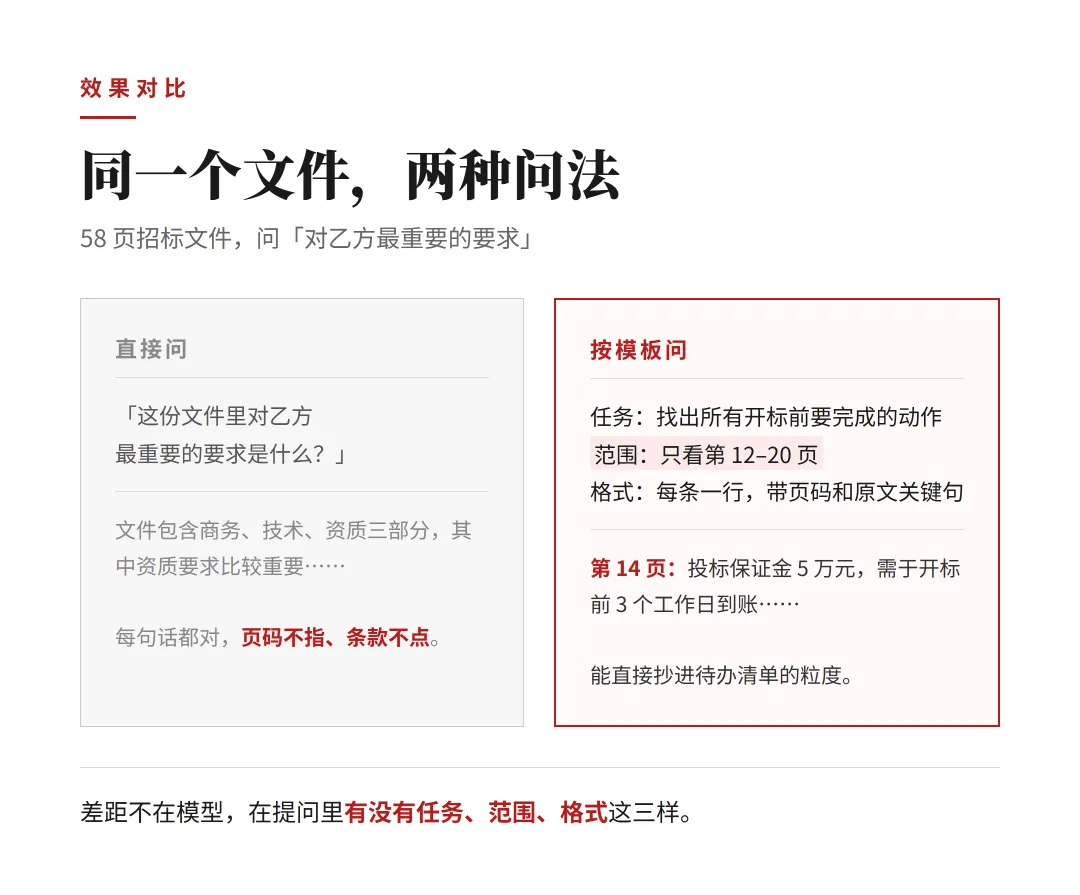
上周处理一份 58 页的招标文件,PDF 直接拖进网页版 Kimi,问:「这份文件里对乙方最重要的要求是什么?」
它回了 400 字,大意是:文件包含商务、技术、资质三部分,其中资质要求比较重要。每句话都对,每句话都没用——页码不指、条款不点、连「资质」具体是哪几条都没说。
以下内容基于网页版 Kimi 和 DeepSeek 实测(2026 年 9 月版本),文件是一份 58 页的 PDF 招标文件。换成合同、年度报表、论文,翻车方式一模一样。
废话是怎么产生的
不是模型不行,是问题里缺东西。
你问「帮我总结一下」,模型只拿到两个信息:一个文件,一个动词。它不知道你是乙方还是甲方、拿这份文件要干什么、总结出来给谁看。它只能退回最安全的答法——把目录扩写一遍。
AI 不是读不懂长文档,是猜不到你要拿它干嘛。所以解法不是换更贵的模型,是把问题补全。分三步。
第一步:别急着问内容,先让它交代结构
先切后问:三步流程
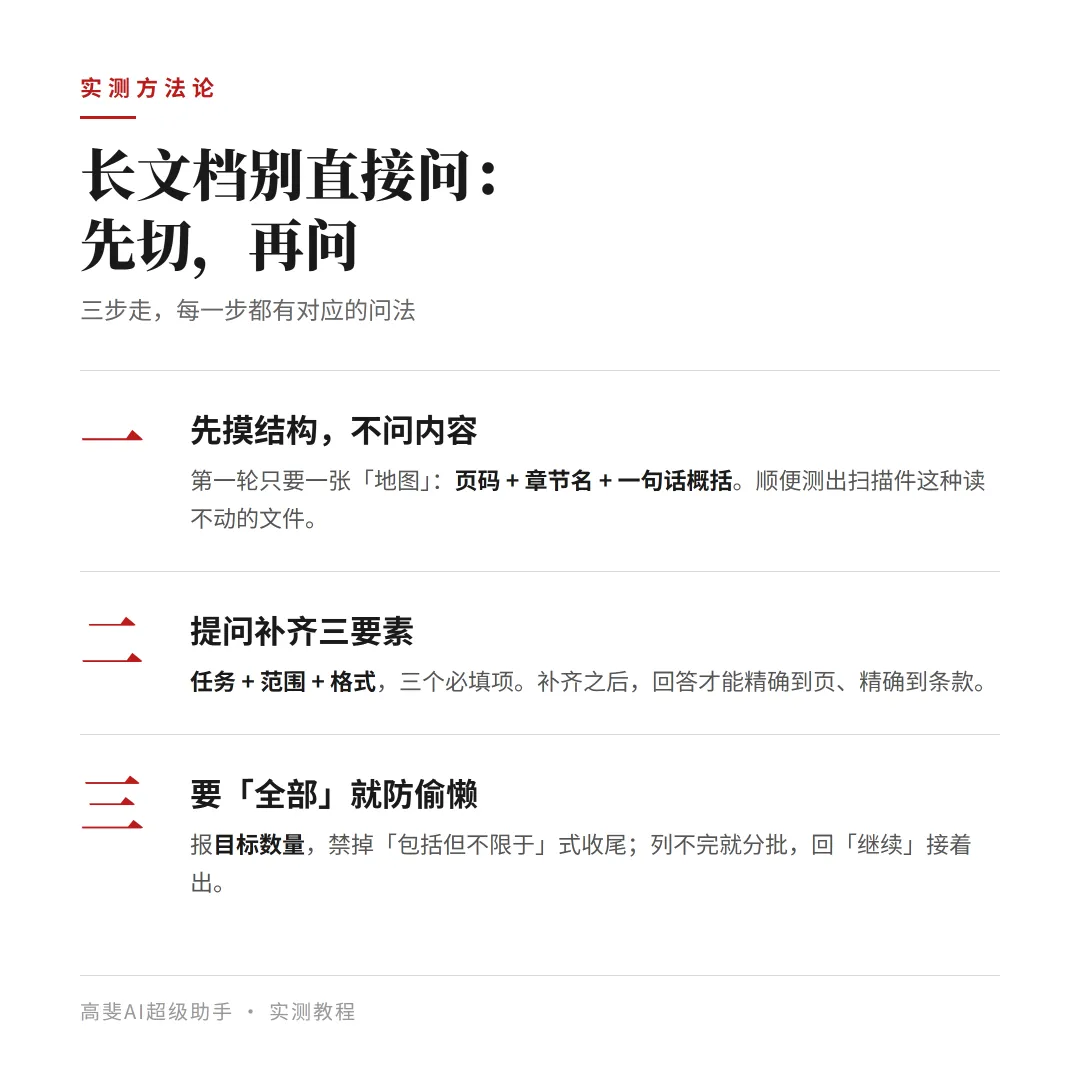
整本喂进去直接问细节,是我踩的第一个坑。改法很土:第一轮只问结构。
可直接复制使用: 我上传的是一份共 58 页的文件。先不要分析内容,只做一件事:按页码范围列出这份文件的章节结构,每一章用一行写清「起始页码 + 章节名 + 这章大概讲什么」。不要展开任何章节的具体内容。
这一轮的产出是一张「地图」:类似「第 1–3 页 投标邀请 / 第 12–20 页 商务条款」的清单。后面所有提问都能精确到页。
顺便还能测出文件 AI 读没读全。要是它连章节都列不利索,多半是扫描件、文字层坏了——先去 OCR 转文字,别浪费时间接着问。
第二步:提问里补齐三样东西
一条合格提问的三个必填项
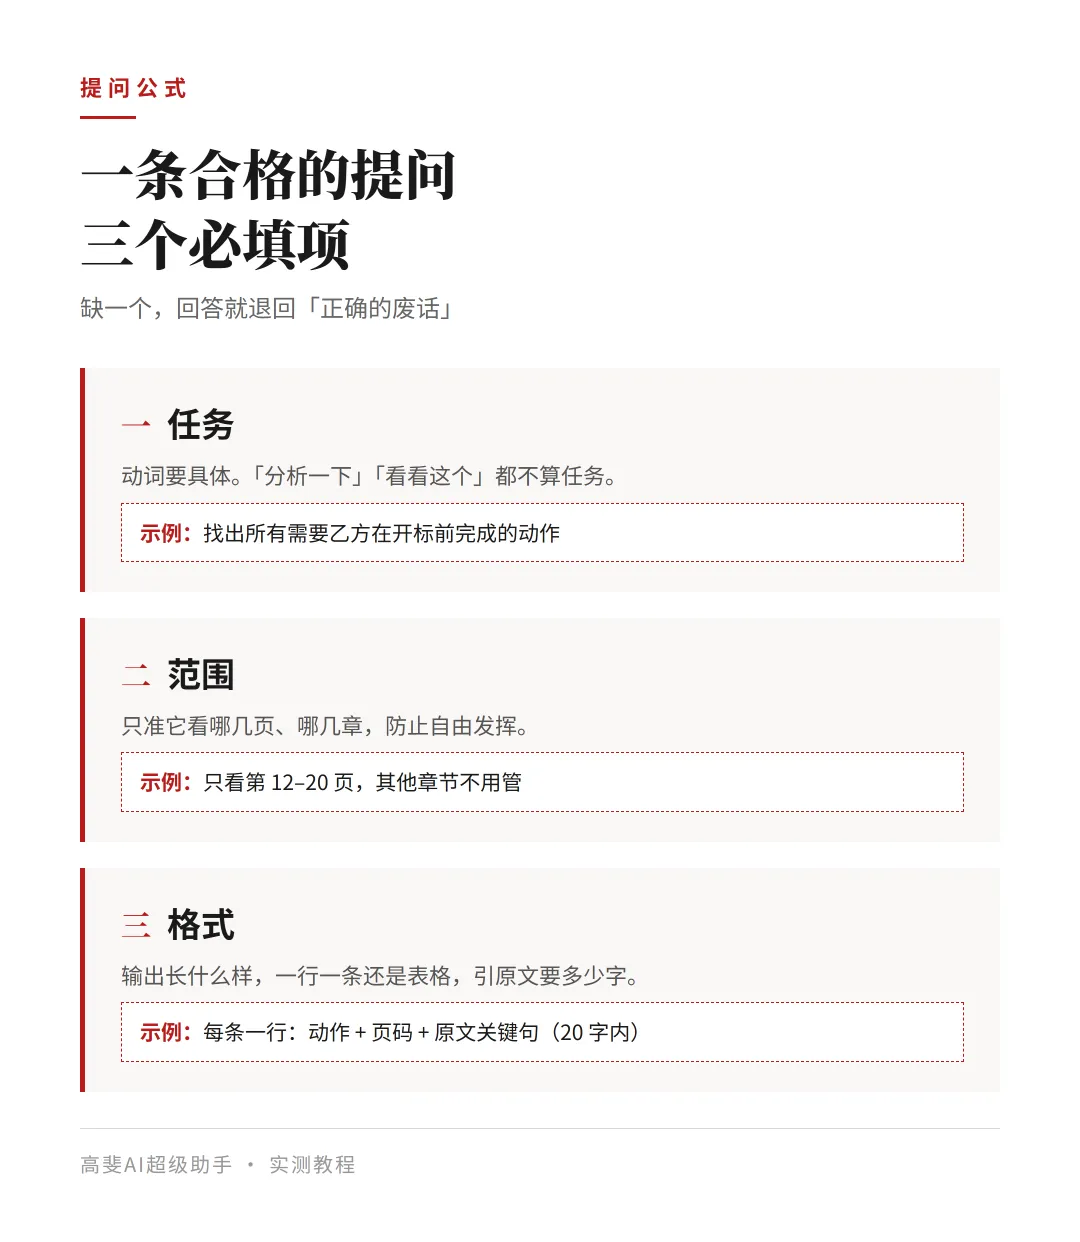
拿到地图再正式提问。一条合格的提问有三个必填项:任务、范围、格式。
可直接复制使用(【】里换成你的情况): 背景:我是投标方,正在准备这份招标文件的应标材料。 任务:从【第 12–20 页】的商务条款里,找出所有需要乙方在开标前完成的动作,比如交保证金、盖章、公证。 范围:只看【第 12–20 页】,其他章节不用管。 格式:每条一行,写「动作 + 对应页码 + 原文关键句(不超过 20 字)」。最后单加一行:有几条你不确定的,标「不确定」并说明原因。
同样一份文件,补上这三样之后,回答从「资质要求比较重要」变成「第 14 页:投标保证金 5 万元,需于开标前 3 个工作日到账」这种能直接抄进待办清单的粒度。
三要素自查,对着补:
任务 · 动词要具体,「分析」「看看」这类不算数 范围 · 只准它看哪几页或哪几章,防它自由发挥 格式 · 输出长什么样:一行一条还是表格,引原文要多少字
第三步:要「全部」,就得防它偷懒
同一个问题,两种问法
第二个坑在这。我让它「列出文件里全部 23 项资质要求」,它列了 9 项,结尾还补了句「以上是文件中的主要内容」。
不是它漏读,是长清单类任务它默认会压缩。对策两条,写进同一条提问:
可直接复制使用: 逐项列出文件中全部资质要求,目标数量是 23 项,每一项都必须带页码。如果实际数量对不上,明确告诉我「实际找到 X 项」并解释差在哪。不许用「包括但不限于」「主要内容如下」这类收尾。
先报目标数量,再禁掉万能收尾话术。数量太大它还是列不完,就让它分批:「先列第 1–10 项,我回复『继续』再列后面的。」
三个常见翻车,对照着修
回答在复述目录 · 原因是没给任务和范围 · 按第二步模板补齐三要素再问 让它列全只给一半 · 原因是长清单默认压缩 · 报目标数量 + 禁「包括但不限于」收尾,还不行就分批 页码对不上或凭空编页码 · 原因是扫描版没文字层 · 回到第一步测结构,列不利索就先 OCR 回答散得没法用 · 原因是没约束格式 · 提问里写死「每条一行 + 带页码 + 引文不超过 20 字」
收尾
这套「先切后问」,前提就三条:文件有文字层、你清楚自己要什么、愿意多打两轮字。有一条不满足先解决那一条,别怪模型。
在课上带学员跑这套流程时,卡住的几乎都不是提示词写不出,而是没先花两分钟摸结构就急着要答案——地图都不看就开车,绕远路是必然的。