ARTICLE · 1087426
别再把涉密文档喂给云端AI了:本地部署MinerU,让数据永不出内网
>_ SYS.INTRO
把数据交给别人的云端,等于把家门钥匙邮寄给陌生人。真正安全的 AI,是让模型进你的内网——而不是让数据飞出去。
就在上月,一份地方政府的处罚通告在技术圈悄悄刷了屏:某单位工作人员小王,为图省事,用一款开源 AI 工具去分析一份内部报告——涉密资料当场外流。最终,单位、主管、直接责任人小王,一个都没跑掉,全部依法受了处分。
指向同一个残酷结论:AI 用得好是效率,用得糙就是泄密。而最容易踩雷的,恰恰是最日常的一个动作——把文件、文稿、数据随手丢给某个云端 AI处理。
那有没有两全的办法?既要让 AI 帮我读文档、做分析,又不想让数据「出门」一步?
[ ANSWER ]
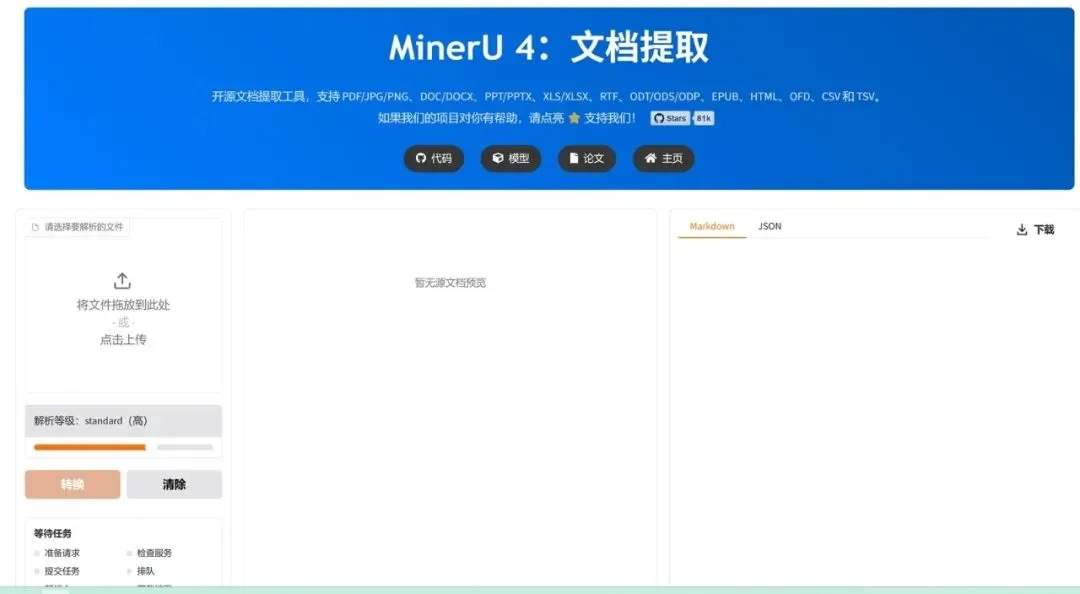
有——本地部署。把解析引擎装进你自己的电脑或内网服务器,数据从进来到出去,全程不过任何第三方的手。今天的主角,就是开源文档解析引擎 MinerU。
[ INDEX ]
[ 01 ]
把文档交给云端 AI = 交底
[ 02 ]
三步把 MinerU 部署进内网
[ 03 ]
让 Agent 读文档的两条安全路线
[ 01 // CASE ]
把文档「交底」,代价有多大?
涉密文件、内部报告、科研数据,被直接输给 AI 写报告、润色——很多 AI 应用会自动存储、云端上传、持续学习,你输入的文字图片可能被后台记录,一旦落到境外机构手里,就是秘密泄露。
用 AI 非法抓取人口、金融、能源等敏感数据,甚至入侵政务、系统窃取技术资料——涉嫌非法获取计算机信息系统数据罪。
借着 AI 换脸、配音伪造官方通知,或批量生成抹黑、煽动的图文——同样可能触碰法律红线。
[ TIP ]
一句话记住红线:无论故意还是过失,只要情节严重,把数据稀里糊涂喂给外部 AI,都可能被依法追责。所以,「数据不出内网」从来不是矫情,而是刚需。
[ 02 // WHY ]
为什么「本地部署」就是解药
解药的名字,叫留在本地。MinerU是上海人工智能实验室 OpenDataLab 团队于 2024 年 7 月 4 日世界人工智能大会(WAIC)科学前沿主论坛上开源的智能数据提取工具,旨在攻克复杂多模态文档处理难题、提升 AI 语料准备效率,并借助 RAG 技术为法律、财务、学术等垂直领域构建新知识引擎。它能把 PDF、扫描件、图片、Office 文档一键变成干净的 Markdown。而它最打动人的一点是:整套解析能力,可以完全跑在你自己的机器上。
数据不经云端,全程可控
文档从上传到解析,只在你自己的服务器里流转,不存在「交底」给第三方的那一步。
模型跑在自己 GPU 上
配合 NVIDIA 显卡,解析推理完全本地化,敏感材料不用上传任何云端 API。
一次构建,到处部署
镜像里打包好全部运行环境,构建一次就能在内网任意机器复用。
[ 03 // DEPLOY ]
三步,把 MinerU 装进你的内网
先看清门槛
这套方案对硬件有基本要求:Linux(推荐 Ubuntu 22.04+,Windows 走 WSL2)、NVIDIA 显卡(驱动支持 CUDA 12.9 / 13.0)、Docker 24.x 及以上,以及 NVIDIA Container Toolkit(提供 GPU 穿透必需)。装好后,先用一行命令确认 Docker 能吃上 GPU:
docker run --rm --gpus all nvidia/cuda:13.0-base-ubuntu22.04 nvidia-smi
git clone https://github.com/opendatalab/MinerU.git
cd MinerU
考虑到国内网络,官方很贴心地把 国内源的 Dockerfile都写好了——直接用 docker/china/Dockerfile,组件下载速度快一大截,构建时还会自动从魔搭社区拉取模型:
docker build --no-cache -t mineru:v4.0.5 -f docker/china/Dockerfile .
这样,所有运行时环境和模型都装进了镜像里,一次构建、到处部署。
同时跑多个模型服务时,要注意规划显存与 GPU 分配,按需启动其中一个或几个 profile:
# 启动可视化前端
docker compose -f docker/compose.yaml --profile webui up -d
# 启动自部署 API
docker compose -f docker/compose.yaml --profile api up -d
# 多服务/多 GPU 编排入口
docker compose -f docker/compose.yaml --profile router up -d
# OpenAI 兼容 VLM 推理服务
docker compose -f docker/compose.yaml --profile openai-server up -d
> 端口与用途速查
启动后记得看日志排障:docker compose config 校验配置、docker compose logs mineru-webui 看服务输出,确认没有异常报错后再往下走。
[ 04 // BRIDGE ]
让 Agent「读懂」文档:两条安全路线
MinerU 本身解析能力很强,但 Agent 自己并不会用——它需要一个「入口」和一种「约定」,才知道遇到文档该去找谁、怎么调。官方为此准备了两条路,通向同一个目的地:数据只进不出。
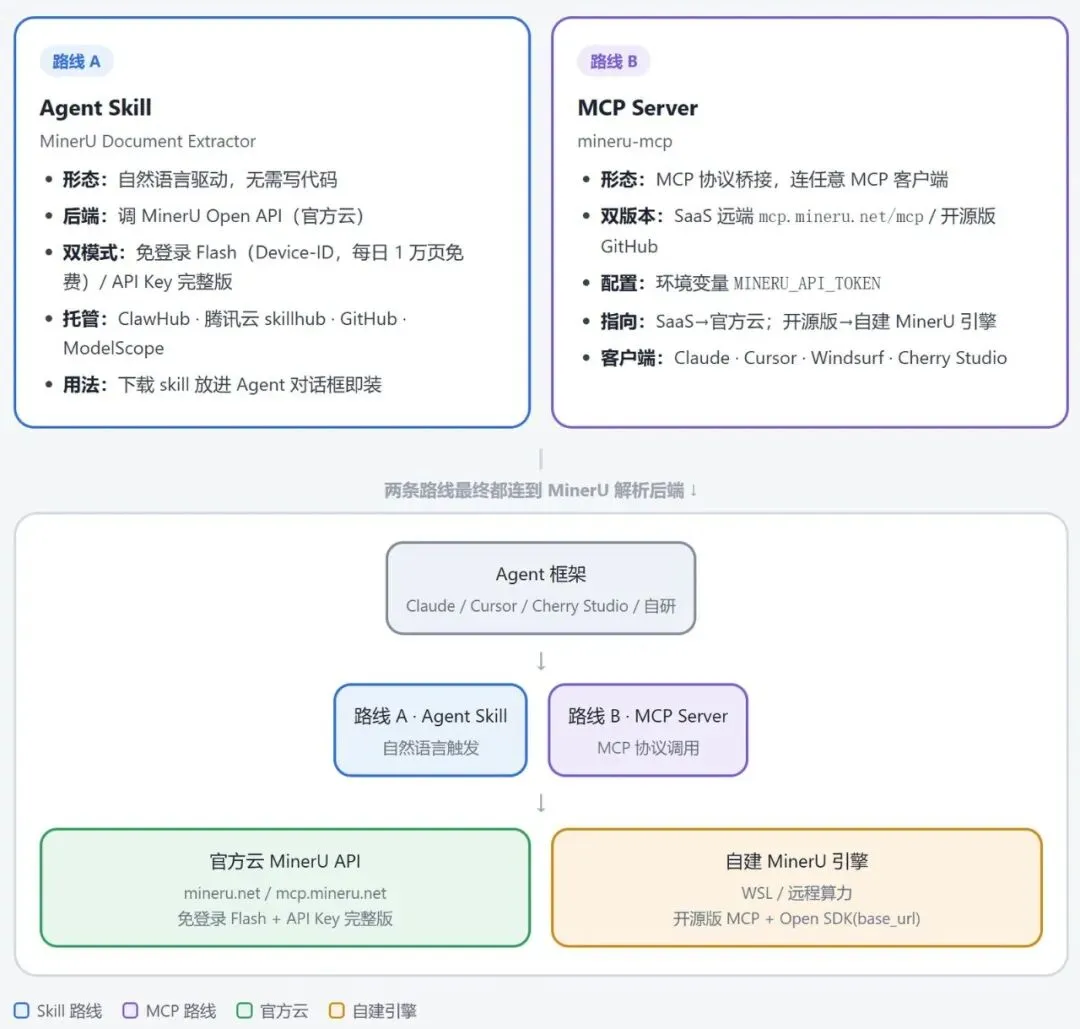
// MinerU 两条 Agent 接入路线架构图
> 路线 A:给 Agent 一本「操作手册」(Skill)
第一条路,像给新助手发了一本图文并茂的《上岗手册》。官方把它叫做 MinerU Document Extractor,是一个纯粹的 Agent Skill。你把它从 ClawHub、腾讯云 skillhub、GitHub 或 ModelScope 下载下来,丢进 Agent 对话框说一句「帮我装上」——不用写一行代码。
这本「手册」教的其实是一句约定:遇到文档,就去调 MinerU 的 Open API。最妙的是,官方还开了个「免登录极速通道」——Agent 只要带上本机生成的设备 ID,每天就能免费解析一万页,开箱即用;等你要复杂表格、公式这类高精度输出时,再填 API Key 切完整版。
这条路线的主基调是轻松、自然语言、零门槛,适合只想「让助手能读文档」的大多数场景。
// Agent Skills 架构图
> 路线 B:架一座「标准桥」(MCP)
第二条路,更像基础设施建设。它不写专用说明书,而是按 MCP(模型上下文协议)这套开放标准,做一座通用桥——mineru-mcp。任何支持 MCP 的客户端(Claude Desktop、Cursor、Windsurf、Cherry Studio……)都能直接走桥,把 MinerU 当标准工具用。
官方文档有句关键的话——「专供开发者在自建 MinerU 引擎时配套使用」。也就是说,当你把 MinerU 装进自己的 WSL 或远程算力服务器时,就该走这座开源桥。不过要注意:这句话 MinerU 官方在 MCP 相关开源代码里其实并没有实现——需要你结合自己的实际需求,定制属于自己的专属 MCP。
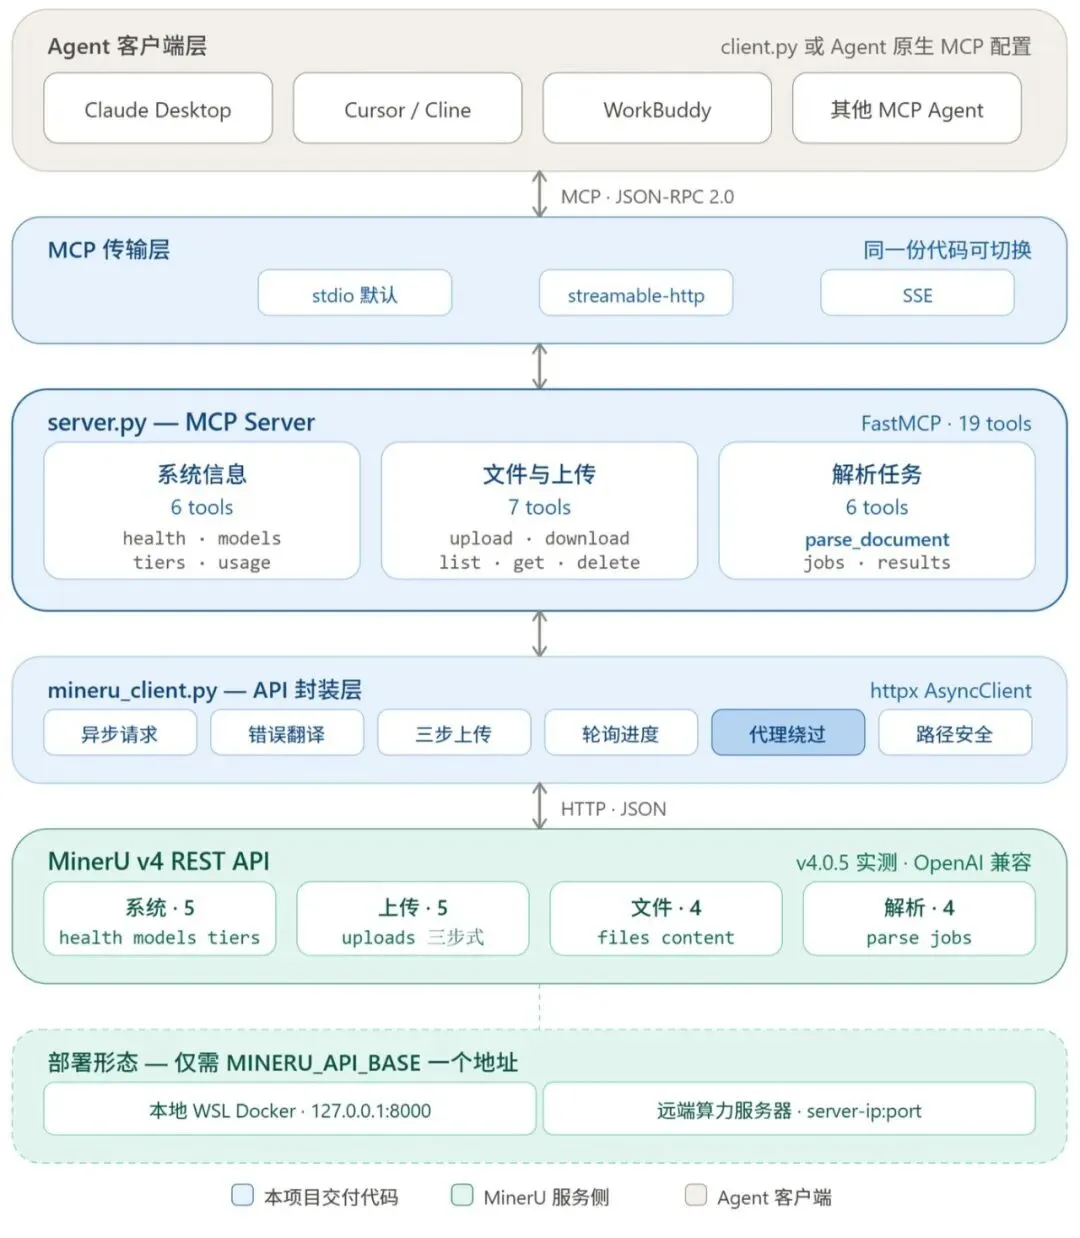
// MinerU v4 MCP 架构图
[ WARN ]
两条路怎么选?要省事、让普通助手秒变文档达人,走 Skill;要把它变成团队级、可持续复用的标准能力,走 MCP。但无论哪条,都先确保 MinerU 是你本地部署、数据留在内网的版本——这才对得起开头那 35 万的教训。
[ END // THE END ]
把 AI 请进门,把数据留在家
>_ QUOTE
「效率和安全从来不是单选题——把模型搬回内网,你的数据就永远是自己的。」
从 9 月那几份罚单回头看,泄密的风险往往不在「用不用 AI」,而在「把数据放到哪一步」。MinerU 这样的开源解析引擎给了我们一个体面的选项:文档解析、模型推理全部留在本地,Agent 的能力照样接入。
今天的部署路径不长——镜像构建、Compose 启动、再挑一条 Skill 或 MCP 的桥接路线。真正难的,是另一半:让「数据不出内网」从口号变成习惯。
>_ SIGNED
我是 顺哥,热衷分享 AI 部署与落地的一手观察与干货,长期关注 AI 工程化与数据安全,热衷分享本地部署与私有化实践。如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。