ARTICLE · 1093217
AI的幻觉——谈替代还有点远
假期闲来无事,为了验证AI的实际生产能力,就找了套小房子,把户型图丢给 AI,让它出装修方案。
用的是workbuddy+DeepSeek-V4.1 Flash的组合。
结果,前前后后改了四轮。出的方案像💩一样。
第一版,我手动选了一个专家,用了半个小时,把原始结构、面积搞清楚了。然后给我出了这么个方案:
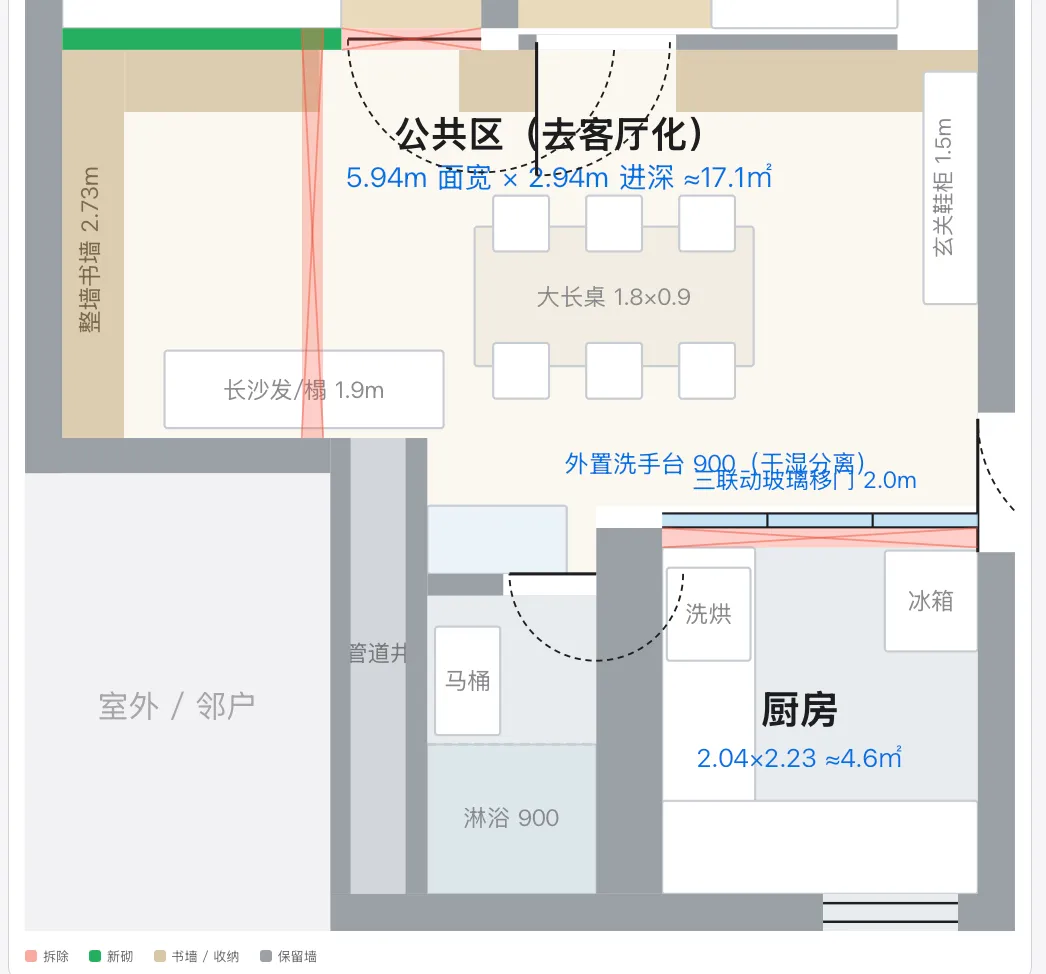
但凡是一个室内设计师,都不敢给这么糙的图:入户门标记错误,厨房砌死。
然后第二次出图,用了将近一个小时。
改到第四版,我实在是懒得跟它沟通了,就顺手让它自己再审一遍。
图出来,我看了半天。
客厅中间多了一堵墙。
从西墙一直拉到东墙,把整个公共空间拦腰截断。玄关进公共区的开口、厨房台面、从门口到阳台那条视线,全堵死在这堵墙后面。
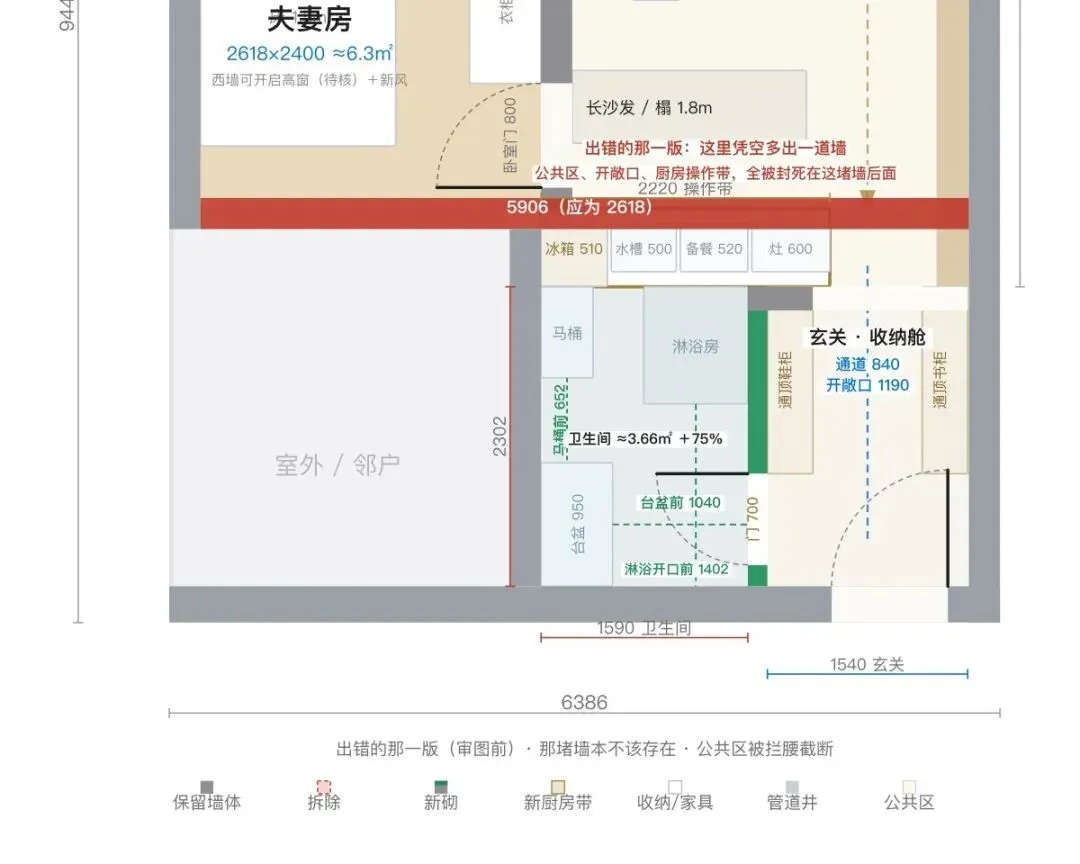
审图前的那一版。红色就是那堵墙,5906 —— 该是 2618
最逗的是,这堵墙在文字方案里从来没出现过。第一页写着“从入户到阳台有一条 8.9 米的视线打通”,第二页写着“公共区独占东侧南北贯通”。文字是通的,图是错的,它自己没发现。
实打实的AI幻觉,它编的东西,看起来像模像样
平常说 AI 幻觉,脑子里想的是“胡说八道”。其实不是这样的。
真正的幻觉长得跟正确答案一模一样:句子通顺,术语准确,数字具体,还带着建议。
四轮下来,方案里留下了 10 处图纸错误、12 处文字错误。分了分类,发现每一类的毛病不一样。
一类是“图上画得下,但东西不能用”。
方案里两间卧室都有门,800 宽,画得规规矩矩。一扇向外面开,另一扇开在两间卧室的隔墙上,还伸出墙外 24 公分。从卧室出来,哪儿也去不了。
卫生间那版更直接。
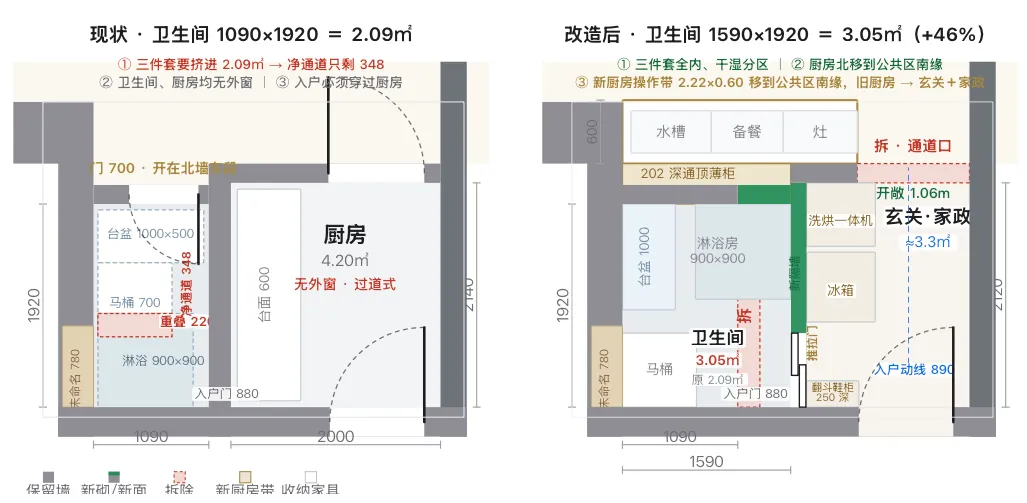
台盆柜竖着贴西墙,1000 长;马桶也贴西墙,就摆在它北边。一件一件量,尺寸都够,中间还留着 602 的过道,图上甚至老老实实标了“台盆前净空 1040”。
我问了一句:请问这个台盆,抽屉打得开吗?
后来它才想明白,我问的不是尺寸。马桶和台盆柜挤在同一条墙上,进门先撞马桶,再侧身绕过去洗手。每一件都合乎尺寸,但合起来不像个卫生间。
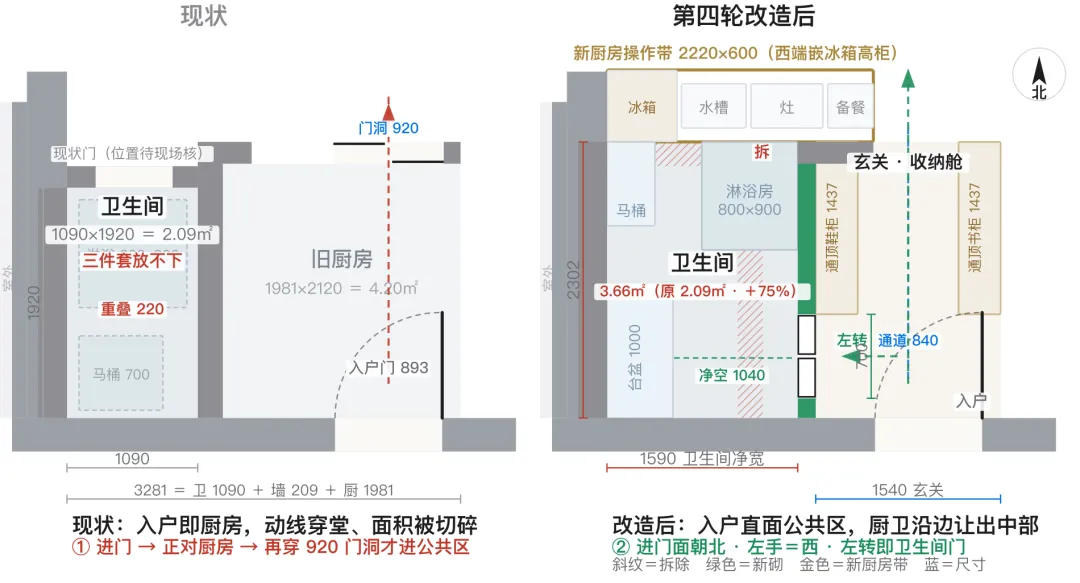
第四轮的厨卫对照。台盆 1000、马桶 700、净空 1040,每一项都合规
这是整个项目里最打脸的一条。面积算对了,尺寸没超,图也画得挺干净。但没把“人”算进去。
另一类,是“说话像个行家”的。
这种最麻烦,因为每个字都像从规定里抄出来的。
卫生间和厨房之间那道墙,图上量出来 209 毫米。方案原话是:“实测只有 209mm 一道填充墙”。然后整个扩容方案 —— 从 2.09 平方扩到 3.66 平方,加 75% —— 就架在这句话上。
可厚度根本推不出结构。
类似的还有几处。
还有一类,是“每个数单看都差不多”。
这类最不容易发现。
玄关两侧做了通顶柜,投影一个平方,按净高两米四算,毛容积 2.4 立方。然后写了句:“大致相当于 150 双鞋。”
真算一下:扣掉层板、门板、五金、取放损耗,按七成装载率,是 1.7 立方;一双鞋连鞋盒 0.009 立方。
八十到九十双。150 哪来的?没出处。就是个“听着合理”的数字。
还有一句:“只在腰间有 600 高的一道台面,视线上方完全通透。”600 是台面的进深,高度是 850 到 900。一句话里两个量搞混,念起来一点破绽没有。
“入户到阳台 9.2 米”,量出来是 8925 毫米。差 300,不多,但它是编的。
最后一条在代码层:生成页面的脚本里,字符串拼接漏出来的单引号会原样输出到页面上。交付版里有 118 处。
页面打开是能看的,标题、表格、配图都正常。就是有些段落中间会冒出一个孤零零的 '。你滑过去多半不会注意。
但它整整有 118 处之多。这个数字还是它自己核算出来的
它不知道自己不知道
把这些放一起看,规律挺明显的。
AI 出错的地方,几乎都集中在它没有依据的地方。
画条线、算个面积、跑个脚本,这些它是有依据的,错了也是看得见的错。可只要越过这条线,进到“这堵墙能不能砸”“这根管子能不能走”“这个城市给不给通气”,它就开始用一种很自然的方式,把“看着合理”当成“事实”讲出来。
所以“什么都能干”这个错觉,不是模型什么都敢干,是它分不清“知道”和“说得像知道”。一个语言模型追求的是说得顺,不是说得对。这俩词在大部分场合是重合的,一碰到关键判断就分开了。
这两年关于大模型的说法,吹得有点过。好像通用智能就差临门一脚,剩下的是算力和场景。
在答案确定、而且马上能验的活儿上,它已经强得吓人。在答案得靠外面的事实、而那些事实又不在它脑子里的活儿上,它跟一个很会说话的实习生没区别 —— 而且这个实习生永远不会举手说“这个我不知道”。
写代码和做视频,为什么它不出错
有人要说:不至于吧,我用它写代码、做视频,效果很好。
是很好,而且这不是巧合。
因为这两件事本身带反馈。写代码,跑一遍就知道对不对,报错、断言、单元测试,全是机器自己给自己打分。做视频更直接,好不好看眼睛一秒就判了,而且好不好看不需要“事实”支撑。
这两件事的共同点是:一定有陪练在身边实时调教,或者与人的效率相比,效率提升部分大于返工时间。
真正落到生产上就不一样了,完全无法对C交付使用。
通用大模型是台很好的生成器,不是台生产设备。
生成器看的是东西好不好看,生产设备看的是能不能直接上流水线。中间差的那截,不是换个更大的模型能补上的。它需要外面的事实,和一套自己给自己找茬的机制。
找了三个帮手,三个人一起错
我用的工具里有不少专家角色,这次也用了。
也因为这样,我看到了另外一面。
同一个平台上的专家,水平差得挺远。有的背后是一套跑过的流程,有的本质上就是一段长一点的提示词,给你的还是“看着合理”。
想靠“挑一个对口的专家”来干活,太费劲。这次这个事横跨结构、燃气、给排水、人体工学、物业规约五个领域,你要我一个一个去试哪个专家好用?光挑人的时间就超过干活了。
最要命的是,几个专家会一起错,还错得一样。
我让三个助手分头审,看着是三方交叉验证。可三份报告依据的是同一张图、同一套坐标、同一套对规定的理解。所以其中一份把 400 毫米算错了方向,另外两份不会自动纠正,它们只是换个角度把同一批假设又说了一遍。
幻觉不会因为投票而消失。
工程那份报告里有一条:“淋浴开口前仅 400mm,不达标。”
我差点就信了。因为这条前面有尺寸、后面有建议,一份标准审查意见的样子。
我去回算了一遍。
审图的那一层,也在编。
真正抓住这个 400 的,没什么高级方法。就是拿着坐标,把两个区间写在纸上,问一句:这俩东西,谁在谁前面。
所以机会在哪
写到这儿,可能有人觉得我在唱衰。
正好相反。
上面每一个坑,指向的都是同一件事:在垂类领域,模型的能力不等于方案的正确。能补上这个缺口的,是某个行业里那些“能查得清、错了要赔钱”的事实,加上一套自己给自己找茬的机制。更强的通用模型补不上。
比如这次。
有一道209的墙,能不能砸,不在任何模型的脑子里,在一张物业的结构图上。
当地燃气公司给不给开放式厨房通气,不在网上,在报装窗口的书面意见里。
这些东西,通用大模型永远学不会,它们没法当知识记,只能一条一条去查。而且每个城市、每个小区、每个年代的结构还都不一样。
所以现在说“赢家通吃”,太早了。
垂类真正的墙,是这些又脏又累的活,跟模型能力关系不大。谁把它们做成了资产,谁在这个行业里就有位置。可行业太多了 —— 保险、医疗、法律、家装、财税 —— 没有哪家能全占。
这个过程很难。但它指向一件小事:让每一个结论都能指回原文的哪一个字节。
这就是我理解的垂类 AI 的门槛。门槛不在模型里,在你得“先把没查清的标出来”,然后对ai产出的内容做复核。在某些领域里面,准确率要达到99%以上,才能进入生产。
最后
拿互联网发展来做对比的话,现在应该还处在“黄页”阶段,离互联网、移动互联网的时代还有一段距离。普通人不用害怕没有机会,AI应用还没有迎来爆发的阶段。
对普通人来讲,看清楚发展趋势,站在光里,比光站着有用,