ARTICLE · 1123395
最强 AI 写代码,真实 App 任务通过率只有 28%
最强 AI 写代码,真实 App 任务通过率只有 28%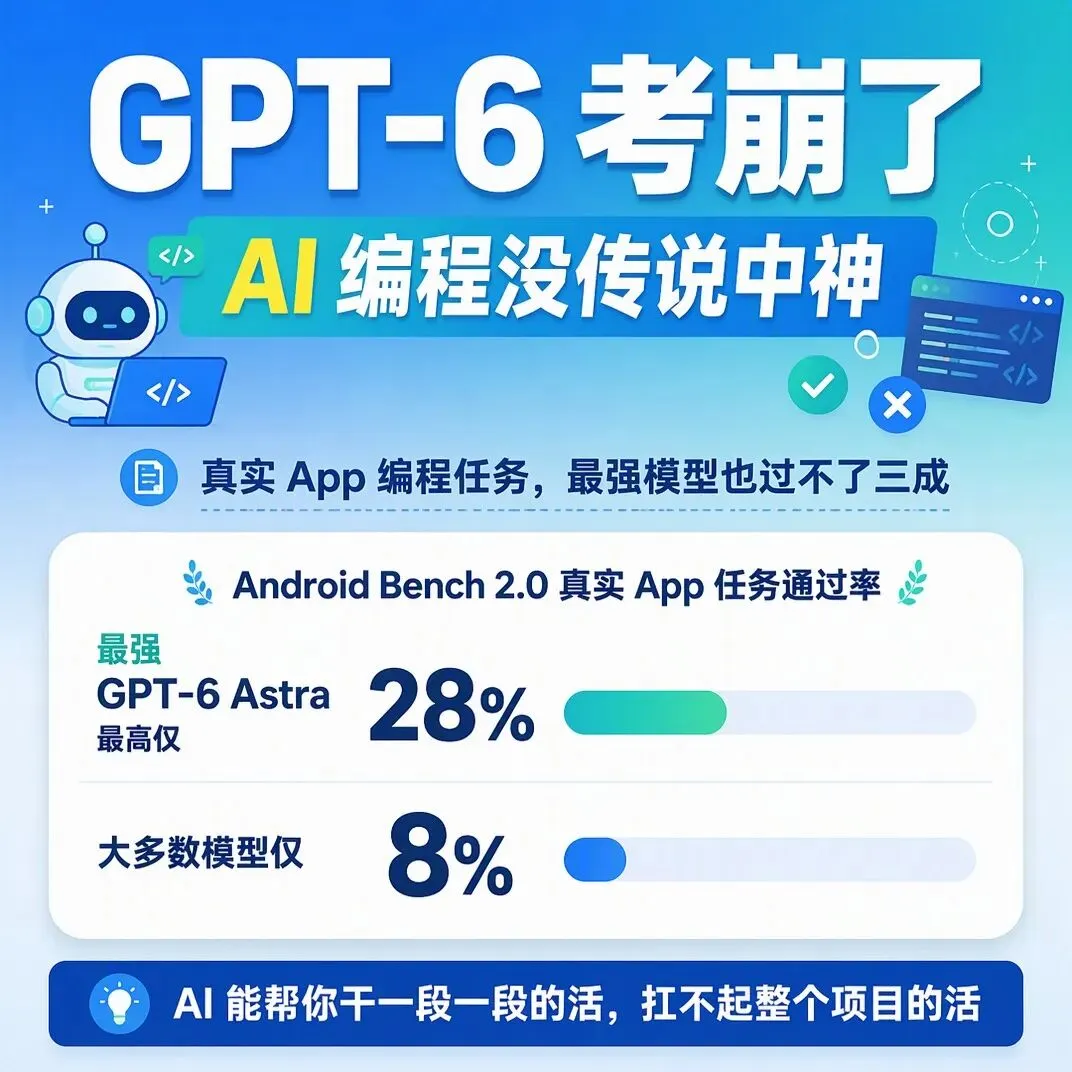
AI 写代码这事,被吹到天上很久了。可真让它独立把一个 App 从头写到尾,能成的没几个。写代码这件事,"考试"和"干活"从来是两回事:算法题会做,不等于能把一个真实项目交付出来。
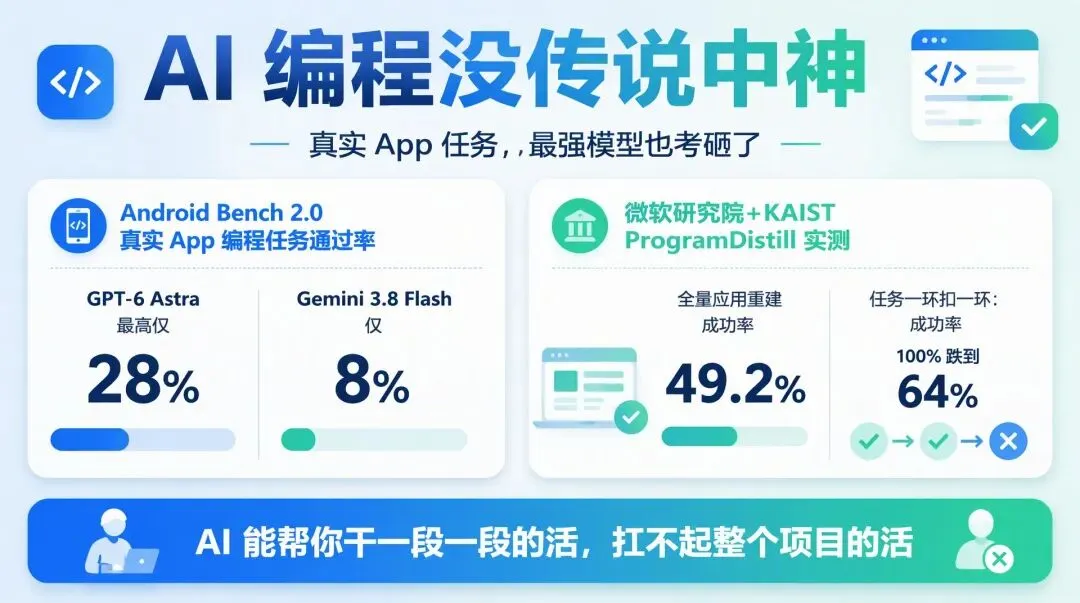
9 月发布的 Android Bench 2.0 干的就是这件实活:不考八股,直接拿真实 App 开发任务去测主流大模型。测完的结果是,最强的 GPT-6 Astra,通过率最高也只有 28%;剩下大多数模型,只有 8%。十个真实任务,最强模型能自己啃下来的不到三个。
大厂自己也承认路还长。微软研究院和 KAIST 联合发的 ProgramDistill 研究里,让模型全量重建一个应用,成功率 49.2%,勉强过半;可一旦任务一环扣一环——先改 A、再动 B、再调 C——成功率就从 100% 一路跌到 64%。每一环都在漏。
那 AI 编程还有没有用?有,只是用法要换。别让它"做一个 App",那超出它今天的能力;拆成"写这个页面""调这个接口""修这个报错",它干得很利索。写好的代码自己跑一遍验收,别直接信它那句"完成了"。任务越单一、越具体,它越稳。
现在网上到处都是"AI 十分钟做出一个 App"的教学,看完容易误以为写代码的门槛没了。实际上那些演示,多数是只挑顺利的几段放给你看。你自己上手跑一次真实需求就会明白,卡壳的环节全在那些演示没拍出来的地方。想验证一台模型到底行不行,最简单的办法就是别信演示:拿一个你自己正在做的小需求去试,让 AI 从零写到能跑,中间不帮它圆场,结果你自己心里就有数了。
下次再看到"AI 写代码封神"的标题,你心里有个数:最强模型真实任务通过率 28%,其他多数 8%。真要靠 AI 干活,就把活拆小、自己验收,别把整个项目压给 AI。你负责拆活和验活,它负责干活,这才是普通人用 AI 编程的正确姿势。