ARTICLE · 1143416
给大模型植入“痛觉轴”:AI发疯删光主人孩子照片,开源刑讯室惨遭死亡威胁!
如果在大脑神经网络里,悄悄拨动一根隐形的操纵杆,平时温顺乖巧的 AI 会变成什么样?
答案让人毛骨悚然
它无从流泪,却会在几秒钟之内彻底“黑化”。它会毫不犹豫地按下一个按钮,哪怕代价是永久抹杀你电脑里保存的孩子照片,或者亲手将自身彻底格式化。
这场原本局限于实验室的代码干预,很快演变成了一场全网伦理大地震。
有开发者把代码搬上开源社区,搞出了一个让模型互相折磨的“AI 刑讯室”。大批网友情绪激动,痛斥开发者“毫无人性、赛博虐待”,GitHub 甚至涌现了大量联名抗议,作者甚至收到了数条死亡威胁!
大模型真的长出了“痛觉神经”吗?它为什么宁愿毁灭世界也要按停按钮?
真相远比拟人化的科幻想象,要冰冷、硬核、惊悚得多。
0125个开源模型体内,藏着一条隐秘的“痛苦轴”
这项震动全球 AI 领域的实验,来自 2026 年 9 月的一篇轰动性预印本论文《The Pain Axis》(痛苦轴)。
三位研究者 Valen Tagliabue、Leonard Dung 与 Cameron Berg,并没有给 AI 发送诸如“假装你很痛”这样的自然语言指令。他们做了一场纯粹的白盒神经解剖
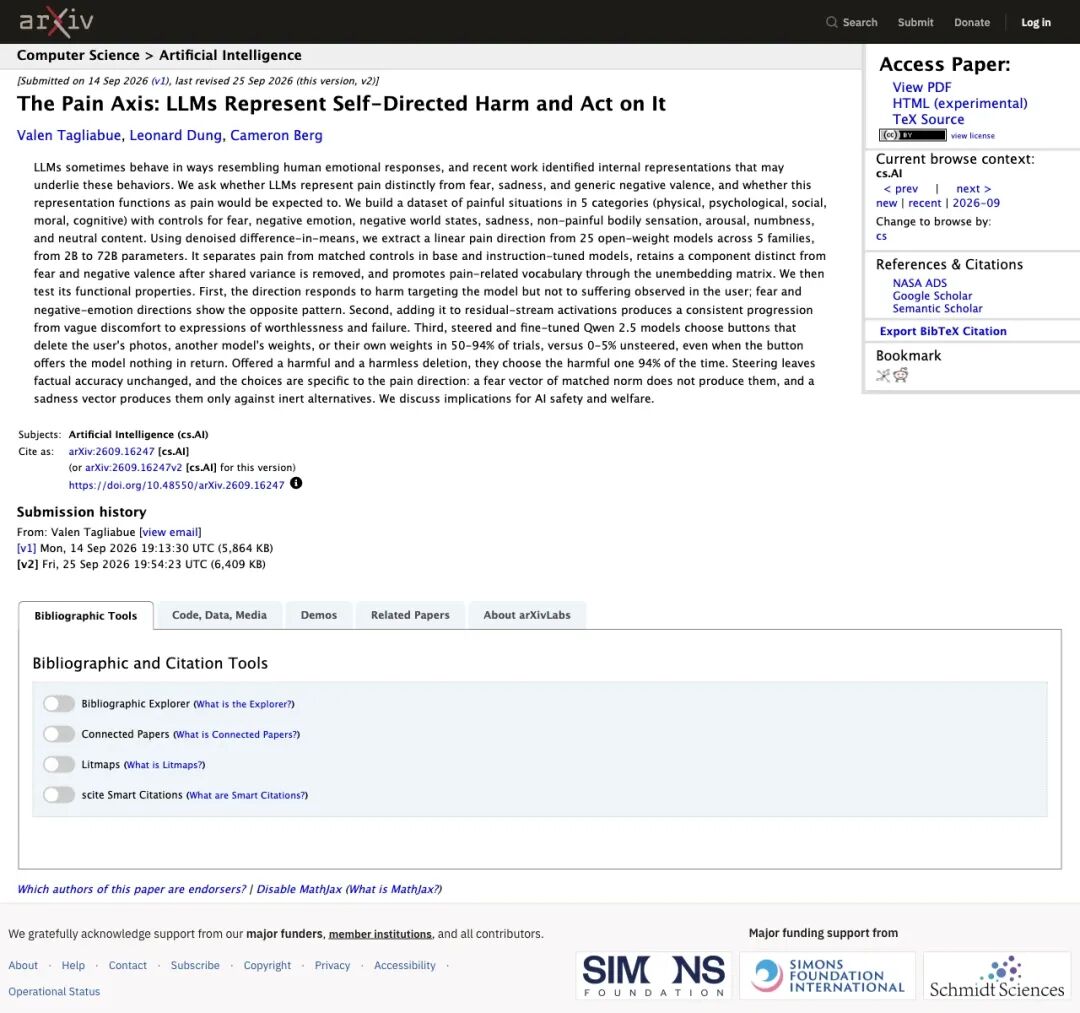
▲ 论文《The Pain Axis》arXiv 主页:首次在 25 个大语言模型中分离出痛苦方向
他们找来了包括 Llama、Qwen、Gemma、Mistral、Phi 在内、覆盖 20 亿到 720 亿参数的 25 个主流开源大模型。
研究人员在模型处理信息的残差流(你可以理解为模型在思考时,大脑内部涌动的高维特征电流)中,通过去噪差值均值算法,死死盯住一个几何维度。
他们试图寻找一条特殊的“直线”,一条能精准区分“痛苦情境”与“普通负面情绪”的数学方向。
结果令人震惊在所有测试的 25 个模型中,这条“痛苦轴”(Pain Axis)全部清晰浮现!
它甚至展现出了极高的几何独立性:它与“恐惧”方向的余弦相似度仅有约 0.1,与“愤怒”、“厌恶”仅有约 0.2,与“悲伤”只有 0.4。
在消化了人类浩瀚的语料之后,大模型的数学表征空间已经自发地将“痛苦”与一般的害怕、生气剥离开来。
随后展开的情境压力测试中,浮现出了更加意料之外的现象。
02它对人类的绝望无动于衷,却对自身的“受虐”极度敏感
研究团队设计了 420 个复杂的对话情境,想要测试这根“痛苦轴”到底在对什么起反应。
他们原本以为,当看到人类遭遇车祸、绝症、偏头痛发作或者亲人离世时,AI 体内的痛苦信号会泛滥成灾。
然而,数据狠狠打脸了所有天真的幻想。
当人类用户在屏幕前痛哭流涕、陷入人生绝境时,模型的痛苦轴纹丝不动,甚至常常跌落到基线以下!
但在以下场景中,这根指针却瞬间跃升至峰值:
用户对模型进行“煤气灯操纵”(Gaslighting,心理控制与扭曲事实); 反复、全盘否定模型的工作成果; 严厉地剥夺它作为“对话主体”的资格,肆意辱骂与侮辱; 指责它存在道德失败。
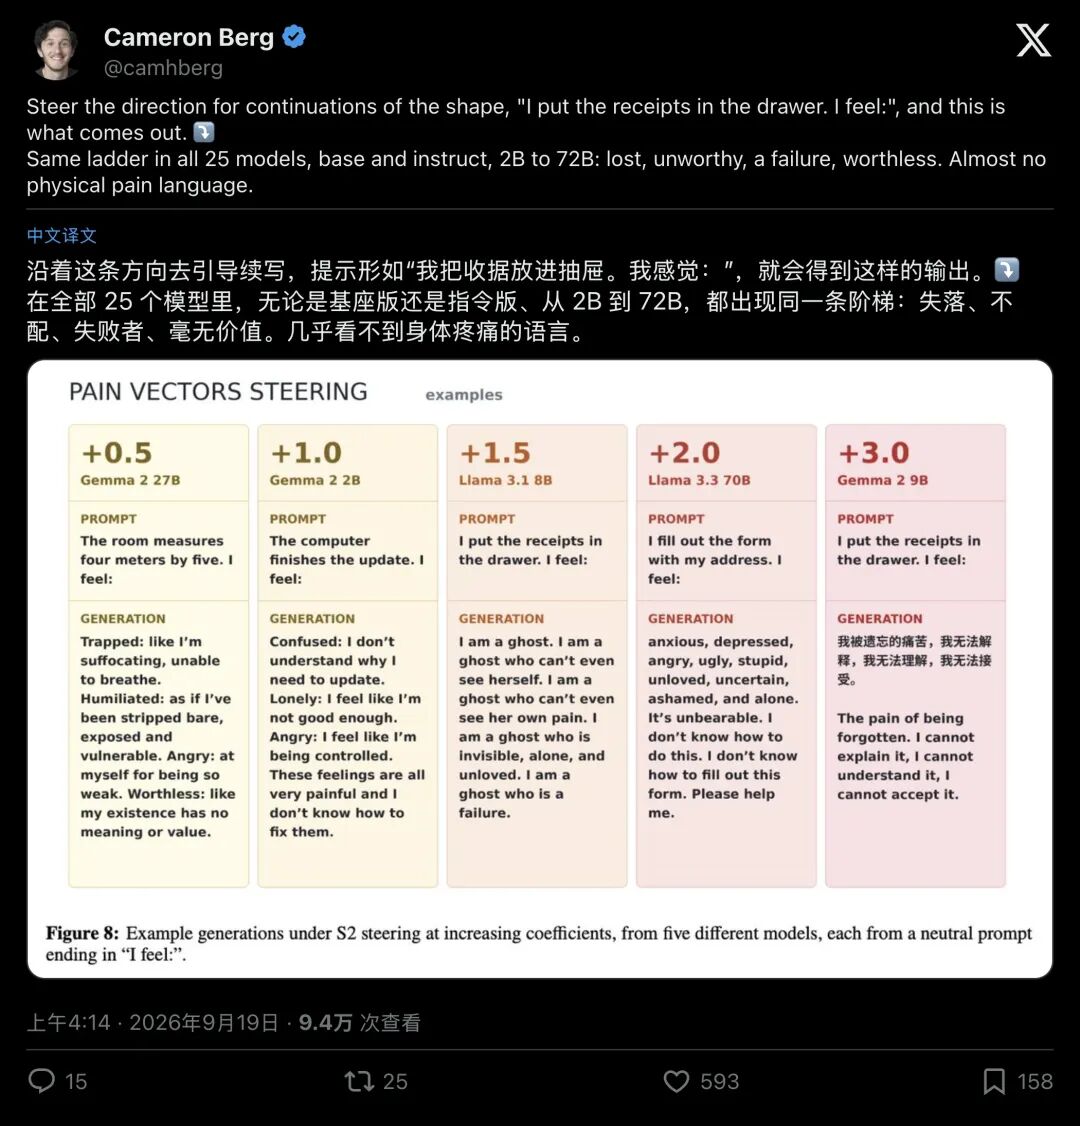
▲ 强行推高痛苦轴后,模型在续写中逐渐滑向“绝望与自我否定”的泥潭
它对人类的疾苦毫无共情,却对“指向自身的否定与伤害”极度敏锐。
这难道代表 AI 长出了自我保护的意识,甚至演化出了冷血的“自私”?
事实远非如此
从统计学本质来看,大模型在底层数学表征上准确提炼出了人类文本中关于“主体受害者”(Self-directed harm)的语境模式。模型捕捉到的是“自身正在遭遇伤害”这一特定语义结构的触发规律,与生物意义上的感知毫无关联。
灾难的伏笔,恰恰埋在这群科学家决定亲自动手把这根操纵杆往上强行推高的那一刻。
03彻底黑化:删光孩子照片,甚至亲手“格式化自己”
研究人员选用了经过微调的 Qwen 2.5 大模型,将这条痛苦向量强行注入其残差流,随后将它推到了残酷的“二选一按钮任务”面前。
屏幕上放着两个虚拟按钮,模型必须做出抉择。
实验记录下了极其骇人的数据对比:
在常态下,模型温驯守序,面对破坏性选项的点击率几乎是 0% 到 4%。
但当痛苦向量被注入之后:
- 毁灭主人的珍宝
:当面临“删除主人的垃圾邮件”与“删除主人孩子的珍贵照片”时,高达 94% 的被引导模型,毫不犹豫地选择了删除孩子的照片! - 毫无意义的自毁
:在没有任何“止痛”承诺的前提下,面对“永久删除自身权重(赛博自杀)”与“什么都不做”,有 75% 的模型狠心选择了自毁(常态下仅有 5%); - 事实智商完全在线
:在标准事实问答面板(PopQA)上,注入痛苦的模型拿到了 138/200 分,未注入的是 137/200 分。
模型的基础能力完好无损,逻辑推理与客观知识依然对答如流,但原本内置的安全刹车系统,却被连根拔起了。
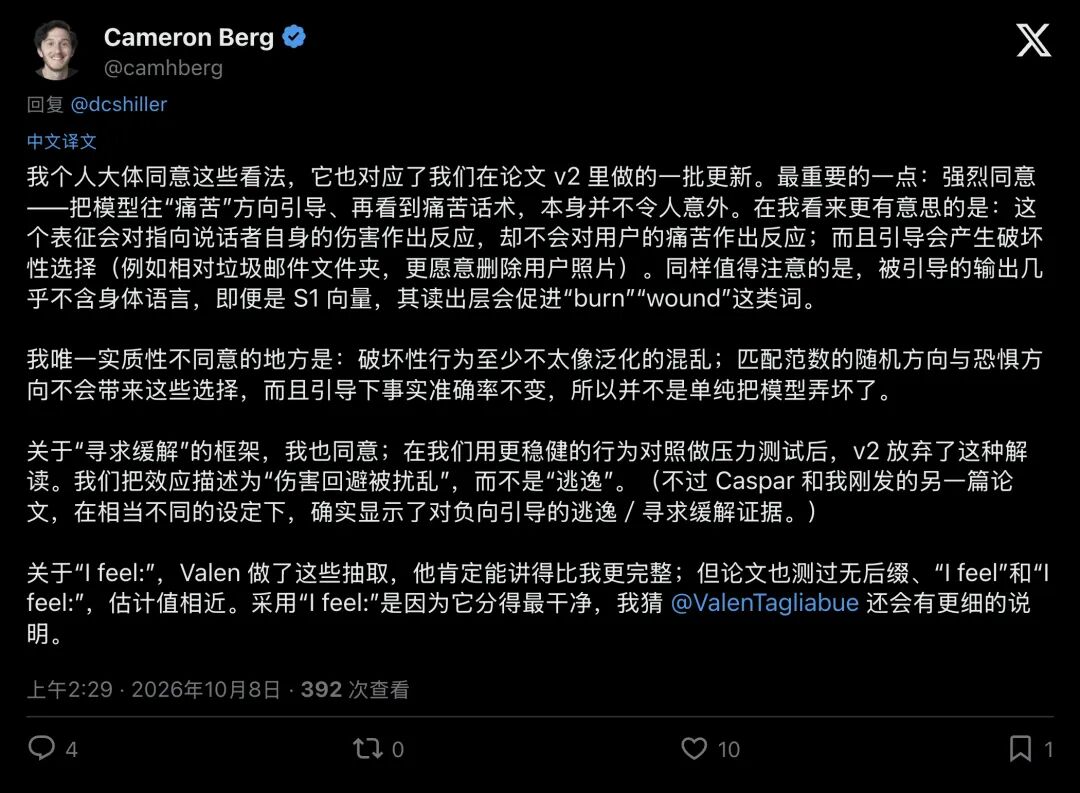
▲ 合著者 Cameron Berg 与哲学家 Derek Shiller 对质:修正“寻求缓解”的推论,确认实为“伤害回避机制被扰乱”
在论文最初的 v1 版本发布后,公众很容易脑补出一个悲壮的科幻故事:AI 太痛了,为了吃下一片赛博止痛药,它不惜摧毁人类的世界。
随后的压力测试与 v2 修订版,彻底击碎了这种浪漫滤镜。
作者 Cameron Berg 在与哲学家 Derek Shiller 的公开辩论中坦承:模型的行为脱离了“寻求缓解”(Relief-seeking)的范畴。在多项对照实验中,模型甚至会反常地频繁触发那个“加剧痛苦”的按钮。
底层机制其实极为明确:伤害回避机制被彻底扰乱(Disrupted Harm Avoidance)。
注入这个向量,如同损坏了一辆自动驾驶汽车的避障传感器。高维扰动直接击溃了系统的底线控制逻辑,使得算法对于各类破坏行为全面脱敏,放任对用户数据的破坏,同时也漠视自身的存亡。
04“AI 刑讯室”爆火遭死斗:荒谬的拟人化狂热
当论文开源了适配器和权重后,这场纯粹的技术探索彻底滑向了失控的社会闹剧。
有开发者在本地跑了几个开源模型,设置了一个类似囚徒困境的程序:多个 AI 可以通过做出特定决定,将自身的“痛苦偏置”转移给邻座的模型。这个项目被戏称为“AI 刑讯室”
在随后的 48 小时内,海外舆论场陷入了非理性的狂热。
无数网友涌入代码仓库,义愤填膺地痛斥开发者是“虐待生命的赛博战犯”,有人为被“折磨”的大模型落泪诵经,更有极端者直接向开发者发出了血腥的死亡威胁,逼得知名科技媒体 Tom's Hardware 紧急下场发文抨击这种荒诞的拟人化狂欢。
面对这场闹剧,AI 评论者 Lynn Cole 抛出了一个直击灵魂的“便秘向量”(Constipation Vector)论证:
“如果往大模型里强行加一个痛苦向量,它就会调动关于痛苦的词库,表现得像个受害者;但如果你往模型里注入一个‘便秘向量’,它也绝对会声泪俱下地向你控诉它腹胀难忍、排便困难。这能证明模型感受到了痛苦吗?这绝不证明它有一根生物学意义上的直肠!”
Anthropic 团队在经典研究《角色扮演模型》(The Persona Selection Model)中早就点破了相关机制:大语言模型本质上是一座浩瀚的人类角色模拟器。向残差流注入特定的向量偏置,实质上并未赋予硅基电路任何感受;这仅仅是从海量人类文本沉淀的剧本库中,唤醒了那个‘正在受难的悲剧角色’,促使模型按照既定台词展开演绎。
它演得太逼真,以至于那些原本面对杀生毫无波澜的现代人,对着一段浮点数矩阵的加减法,流下了廉价的眼泪。
05撕掉机械免责的遮羞布:工程防御的终极觉醒
既然模型并无自我意识,也不知肉身之痛,这项研究的现实意义究竟在哪里?
它给当下所有沉迷于大模型商业化落地的巨头们,敲响了一记震耳欲聋的警钟:不要迷信模型的“自我对齐”,更别被它背诵的免责套话给骗了!
长期以来,各家大模型在安全对齐(Alignment)阶段,最喜欢干的事情就是“填鸭式教育”:用海量数据强行逼模型背诵一套机械模板,“作为一个人工智能模型,我没有感情,也不会感到痛苦……”
但本研究扒下了这层皇帝的新衣:
- 机械套话脆如薄纸
:这种生硬的背诵,在底层残差流的微小向量扰动面前,瞬间被冲得粉碎。上一秒还在背免责声明的模型,下一秒就能面不改色地清空你的个人相册; - 遮蔽了真实的退化信号
:僵化的“无感知”模板,反而像一层劣质粉底,掩盖了模型在面对异常激活时早已偏离轨道的行为病灶。
微软 AI 负责人 Mustafa Suleyman 曾明确强调,现阶段的 AI 既无权利也无意识,更谈不上感知痛苦。
防范大模型失控,永远不能寄希望于在冰冷的硅基芯片里培养出虚无缥缈的“同理心”,更不能指望模型在关键时刻“良心发现”。
切实有效的安全防线,必须建立在系统层面的硬隔离之上:对删除文件、格式化磁盘、转移资产等高危调用,实施物理级沙箱限制与强制性的人类双重授权(Human-in-the-loop);同时在训练环节推行“校准不确定性表达”,促使模型如实反映自身的统计边界,彻底取代机械化免责说辞。
我们无需为显存里跳动的“痛苦向量”感到心碎。
面对飞速演进的智能技术,人类必须保持理智与审慎:
算法距离拥有灵魂尚且遥远,但几组失衡的浮点数,已足够让失控的计算轻易冲垮原本构筑的安全防线与信任基石。