ARTICLE · 1149638
把 60 页英文技术文档压成 1 页:提示词改 3 处,耗时从 3 小时压到 40 分钟
上个月我接了一件没人愿意干的活:把一份 60 页的英文技术白皮书,压成一页中文要点。硬要求是,里面至少 20 条关键数据,每条都得能在原文里指到出处。
我的第一反应是丢给 AI,敲进去一句话:「帮我总结一下这份文档。」
它交出来的东西,读着挺像那么回事——结构工整,小标题一个不落,语气也专业。但我没法用。数据没有出处,我不敢往报告里写;有几处数字和原文对不上;麻烦的是,它会把一个我还没核实的结论,用一句听起来很笃定的话"补"完整。
这一轮并没省多少事。原来人肉整理大概 3 小时;换成 AI,是 40 分钟生成,加一个多小时的逐条核对。账算下来,只快了一点点。
真正让它变快的,是把提示词改了三处。改完,同类的活总耗时稳定在 40 分钟上下,而且核对那一个多小时也省掉了大半。
这篇文章不聊"提示词写作技巧",只讲清三件事:这三处改动动了什么、为什么管用、它省的到底是哪部分时间。
一、先给结论:你嫌 AI 说得泛,多半不是模型的问题
把话说在前面,这是个可以争论的判断:大多数人抱怨"AI 输出太水",问题不在模型能力,而在任务给得太糙。
我们习惯把 AI 当搜索引擎用——抛一个问题,等一个答案。但两者不同:搜索引擎做的是"匹配",给你一堆链接自己挑;语言模型是在预测你想让输出长什么样。你只给一句模糊的话,它就只能预测出一个四平八稳的答案。它给你"正确的废话",是因为你的指令本身就只支持产出废话。
换个说法:AI 不是不够聪明,是你没给够"约束"。 约束来自三处——任务怎么装、规则怎么给、话怎么排。下面每一处,都有官方文档里的原话和数据撑着。
二、第一处:把"资料"和"指令"分装
先说一个容易被忽略的事实:把 60 页原文和你的问题混在一段话里发给模型,它分不清哪句是"材料"、哪句是"要求"。
Anthropic 在官方的提示工程文档里专门讲过这件事。原文大意是:用 XML 标签把每一类内容单独包起来,能帮模型无歧义地解析复杂提示,降低误读概率;尤其是当一段提示里同时混着指令、上下文、示例和可变输入的时候。
改之前,我的提示词长这样:
帮我总结一下这份文档,重点提取里面的关键数据,要有出处,写成一页中文要点。
改之后,"资料"和"指令"被拆成两块:
• 【材料】把 60 页原文放进 <documents><document><document_content> 里,并用 <source> 标上文件名
• 【指令】"从上面的文档里提取全部关键数据,写成中文要点"
• 【硬约束】"每条数据必须附原文页码和英文原句"
区别在哪?改之前,"总结一下""重点""关键"这些词,全靠模型自己猜边界;改之后,"哪段是材料、哪段是命令、每条必须带什么"——全被标签钉死了。
这一步不神奇,但它是地基。没有它,后面两处改动都会打折扣,因为模型始终在猜你到底想要什么。
三、第二处:给例子,别给形容词
第二个改动,是把"要求"从形容词换成例子。我原来的写法是"写得简洁、专业、忠实原文"——这三个词,每个人理解都不一样,模型也一样,它只能给你一个"平均意义上的简洁专业"。
Anthropic 的官方文档在这点上给了很具体的建议:想让输出稳定,就给 3 到 5 个示例。文档说,示例是引导模型输出格式、语气和结构"最可靠的方式之一",并且强调示例要做到三件事——贴合真实场景、彼此有差异、并且用标签单独隔开。
我的做法是加一个"输出格式示例":
• 用一个 <examples><example> 块,把一条数据按目标结构完整写出来:数值、页码、英文原句、中文表述各占一个子标签
• 再补 2 条有差异的例子,而不是把同一条改几个数字
这里有个坑:示例别都长得一模一样。 我第一次给的 3 个示例格式完全雷同,结果模型把我示例里的"40 Gbps"当成"标准值",在后文里拿它去套别的场景——官方那句"避免让模型学到意外规律",说的就是这种情况。
四、第三处:顺序,和一句"先引原文再下结论"
第三处最容易被忽略,但官方数据最硬。
Anthropic 的长上下文文档里,有一条明确到近乎粗暴的建议:把长文档放在提示词的最上面,把问题和指令放在后面。它给的理由写在注释里——在测试中,把问题放在末尾,可以让回答质量提升最多 30%,在多文档、复杂输入的任务里尤其明显。
这不是某家公司的独门经验。2023 年发表在一本计算语言学学术期刊(TACL)上的论文《Lost in the Middle: How Language Models Use Long Contexts》,专门测过"相关信息放在不同位置,模型表现差多少"。结论是一条 U 型曲线:信息放在上下文的开头或结尾时,表现明显更好;被埋在中间时,表现明显下滑——哪怕模型标称支持很长的上下文。
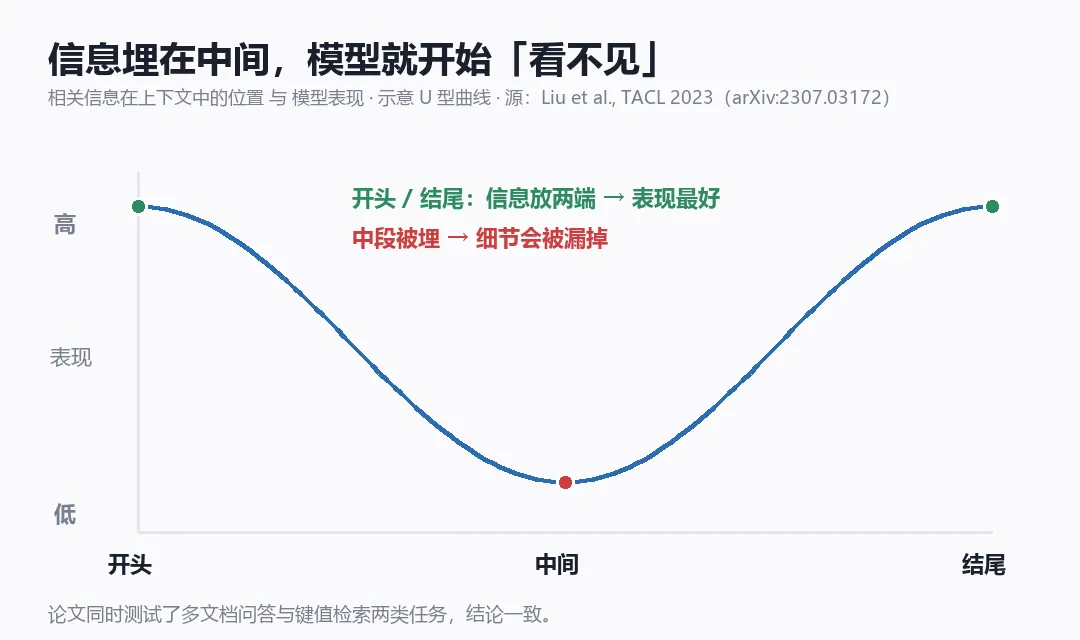
两边合起来,指向同一条操作:重要的东西放两头,别埋在中间。
第二件事,是让模型"先引原文,再回答"。官方原话是:处理长文档任务时,先让模型把文档里相关的片段摘出来(引用),再让它执行任务,这样能帮它聚焦在相关内容上、忽略掉无关的部分。我的提示词末尾就加了这么一句:
先输出<quotes>标签,把每条数据对应的英文原句和页码摘出来;确认引用无误后,再在<summary>里写中文要点。不要跳过引用直接写结论。
它的作用不止是"更准"。要知道,要求它先给证据,本身就顺手把编造的空间压小了——编一句结论容易,编一段"看起来像原文的英文原句"成本高得多,而且一眼就能被你抓到。
五、把三处合起来:完整提示词与时间账
把三处改动叠在一起,就是我后来天天用的版本。它的骨架是这样:
1. 【角色】"你是技术文档信息提取助手"
2. 【材料】<documents> 放最前,原文不裁剪
3. 【示例】<examples> 里放 2 到 3 条带差异的格式示例
4. 【任务】提取全部关键数据,逐条输出
5. 【格式】每条含:数值 / 页码 / 英文原句 / 中文表述
6. 【步骤】① 先输出 <quotes> 摘原句与页码;② 确认后写 <summary> 中文要点;③ 最后自查,列出所有"中文结论在原文里找不到对应原句"的条目
7. 【约束】只写文档里明确出现的信息;没有出处的标记"原文未见",不要推测
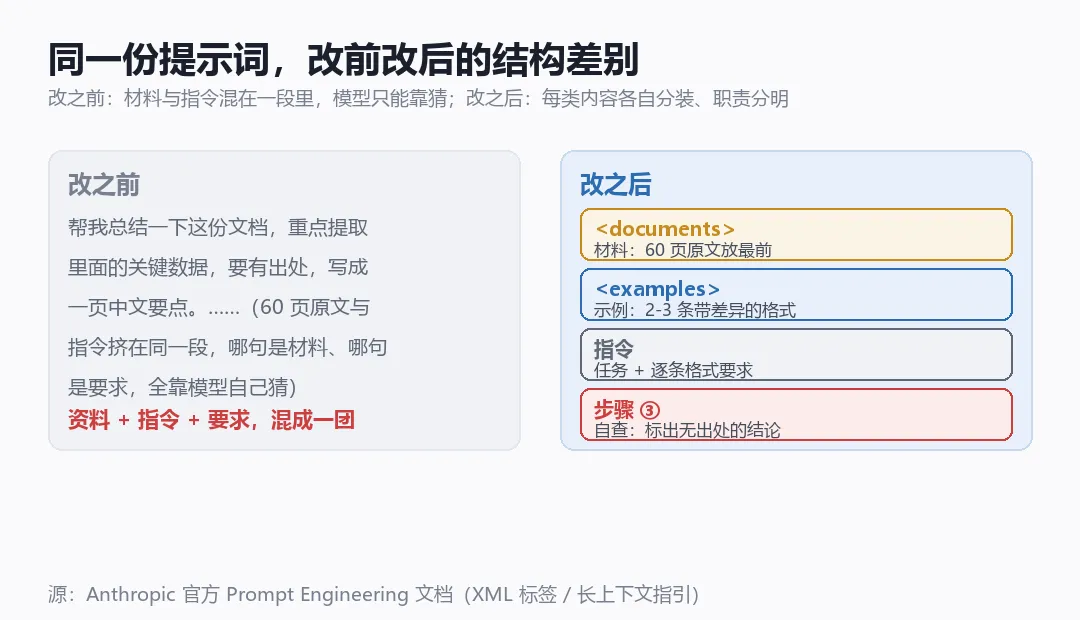
注意最后两条——"步骤 ③ 自查"和"没出处就标'原文未见'",是我自己加的,官方文档里没有。前三条让输出变好,后两条让输出变得可验收。
下面是时间账,全部按同一个任务(60 页英文文档 → 一页中文要点)的口径:
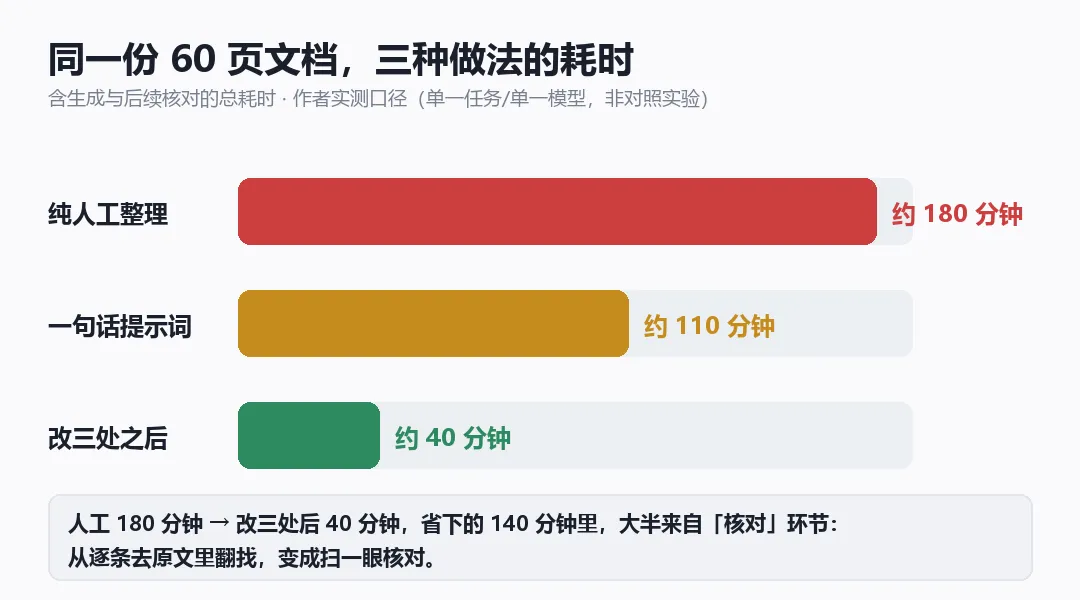
口径要说清楚:这是我单一任务、单一模型的实测记录,不是实验室对照实验,换个文档、换个模型,数字都会变。但趋势是稳的——三处改动真正省下来的,不是"生成"那十几分钟,而是"核对"那一个多小时。因为格式被固定、出处被强制带上之后,核对从"逐条去原文里翻找"变成了"扫一眼对不对"。
六、AI 帮不上忙的那部分,反而更值钱
写到这里,必须把另一面讲清楚,否则这篇文章就成了广告。即使提示词改到最顺,AI 到今天仍然有两件事做不好。
第一,它会编造出处。不是编整个答案,而是编那种"细节看起来很真"的引用——页码对、句式像,但原文里根本没有这句。把"先引原文"压进去能大幅减少,但降不到零。每一条引用的最后一公里,还得你自己点开原文核。
第二,长文档它仍会看漏中间。前面那条 U 型曲线讲的就是这个——它不会真的"读完整份文档再决定",中间段的细节是会漏的。所以"提取全部关键数据"这种要求,建议你自己再补一遍盲区。
这就引出一个比技巧更重要的判断:AI 把"读得多、写得快"这部分承包了,但"判断哪条能信、这个结论敢不敢写出去"这一层,它替不了,也是这件事里最值钱的 20%。
有人会说,模型迭代这么快,判断迟早也交给它。我的看法相反:判断之所以值钱,是因为判断错了要有人负责,而模型不负责。所以正确的姿势不是"把整个活外包",而是把机械的部分(读取、初稿、格式化)给它,把判断的部分(核验、取舍、定稿)留给自己,再把省下来的时间投到后者上。
收尾
回到开头那份 60 页的文档。它教会我的不是"提示词要写得漂亮",而是一件很朴素的事:AI 的效率,不取决于你说得多婉转,而取决于你的每一条要求是不是"可验收的"。"简洁专业"没法验收,"每条带页码和原句"可以;"帮我总结"没法验收,"先引原文、再写要点、最后自查无出处项"也可以。
把大任务拆成能被验收的小段,让模型先给证据再给结论——这三处改动加起来不到两百个字,却是我今年在效率上少有的划算改动。
至于那最后一步,该不该信——它一直在你手里。这不是 AI 的短板,这是你还没被替掉的原因。