ARTICLE · 1154690
Router + Skill 实战:给 AI 助手装上三项技能
上一篇,我们讲清了 Tool、Skill 和 Agent 的区别:Tool 提供可调用能力,Skill 整理任务处理方法,Agent 根据目标与反馈推进工作。
现在,把这个关系落到代码里。
假设你已经做出了一个订单助手,用户又提出了新的需求:有人查订单,有人问物流,还有人想知道发票开了没有。如果把所有规则和工具一次性塞给模型,开始时似乎也能工作;随着能力增加,提示词越来越长,错误也越来越难定位。
这篇文章给助手增加一个入口:先判断请求属于哪类任务,再加载对应 Skill,进入工具调用循环。
我们用一个 Agent、三项只读技能做演示,不需要先搭起一套多 Agent 系统。
本文支持三个问题:
订单和物流数据都是虚构的教学数据,没有连接真实业务系统。发票技能只查询状态,不能提交开票申请;取消订单、退款等操作也不在本次范围内。
明确这些边界,比先写一段“你是无所不能的客服助手”更有用。它决定了系统能处理什么,也决定了哪些请求必须停下来说明情况。
整体流程如下:
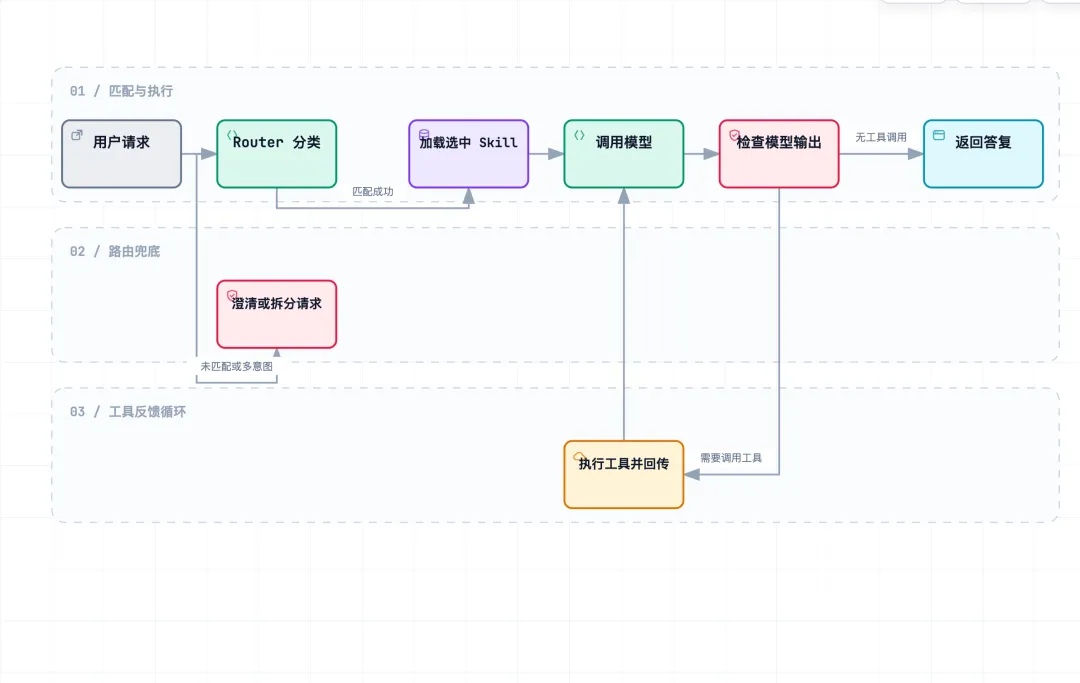
Router 读取用户请求和简短的技能目录,输出一个分类结果。匹配成功后,程序加载选中的技能正文与工具配置,再让模型执行任务。
进入执行阶段后,仍然沿用最小 Agent 的循环:模型提出工具调用,程序执行,结果回传,模型根据反馈继续处理或输出答案。自定义函数工具的执行责任仍在应用程序中。参考:OpenAI Function calling
路由发生在任务入口,工具循环发生在任务执行阶段。加了 Router,并不意味着可以省掉后面的参数检查、权限控制和结果反馈。
这也解释了为什么 Router + Skill 可以与 ReAct 或图工作流结合:它们负责不同环节,不是一组选了一个就必须放弃其他的选项。
技能目录只需要告诉 Router 每项能力的名字和适用范围:
CATALOG = { "order-status": { "description": "查询订单状态,例如是否发货", "tool": "get_order_status", }, "shipping-status": { "description": "查询物流轨迹、承运方和运输状态", "tool": "get_shipping_status", }, "invoice-status": { "description": "查询发票是否已开具,不申请开票", "tool": "get_invoice_status", },}分类阶段不需要读取所有业务手册。只有选中物流技能,程序才加载物流的处理步骤。
文件组织很简单:
router-skill/├── router_agent.py├── test_router_agent.py├── requirements.txt└── skills/ ├── order-status/SKILL.md ├── shipping-status/SKILL.md └── invoice-status/SKILL.md技能正文写的是方法。例如物流技能要求:确认订单号,调用物流查询工具,依据返回结果解释运输状态,没有预计送达日期时不自行推测。
这里借用了 Skill 的组织思路:用说明文件保存可复用方法,必要时附加参考资料或脚本。参考:OpenAI Skills
本文程序自己实现了目录、选择和加载。这些文件不是安装进 Codex 的技能,也没有使用平台自动发现机制。把一个 SKILL.md 放进文件夹,应用不会因此自动学会加载它。
这种按需加载减少了执行阶段的无关说明。但是否节省总成本,还要看路由本身用了多少调用,不能仅凭架构名字下结论。
第一版先不用模型分类,用规则帮助我们观察流程。
输入含“物流”“快递”“轨迹”,匹配物流技能;含“发票”“开票”,匹配发票技能;含“订单状态”“发货”,匹配订单技能。
同时,路由结果不只有一个技能名称,而是四种状态:
例如“帮我查物流和发票”,返回 multi。这版程序不会偷偷选其中一项,也不会自动拆分和并行执行。它会告诉用户分开查询。
“帮我取消订单”返回 unsupported,因为系统根本没有取消订单的执行能力。
这些出口让失败方式更明确,但简单关键词规则有很强的限制。“不要查物流,只看发票”也含有两个类别的词;引用他人话语、否定表达、上下文省略,同样可能误判。
规则路由是教学起点,不是经过验证的自然语言分类器。小范围固定入口可以用规则;语言表达复杂后,应更换分类方式并评测真实样本。
示例还提供了模型路由选项。Router 只看到用户输入和简短目录,返回类似这样的 JSON:
{ "status": "matched", "skill": "shipping-status", "message": ""}程序使用 Structured Outputs 限制字段、状态枚举和技能名称。Responses API 的配置入口是 text.format,类型为 json_schema,并启用 strict。参考:OpenAI Structured Outputs
即使格式正确,也必须验证字段之间的关系:matched 对应已注册技能;其他状态的 skill 必须为 null。
结构化输出约束的是输出形状,不能保证模型理解正确。“发票有没有开”被分到物流技能,仍然可能是一个格式合法的错误结果。
因此,不要把“JSON 能解析”当成“路由质量达标”。分类准确率、错误请求是否被拦住,要靠代表性样本单独评测。
这个版本没有模型自报置信度,也没有凭空设置一个“低于 0.8 就追问”的门槛。没有校准过的分数,不能替代实际测试。
加载时,模型返回的是注册名称,程序据此定位文件:
def load_skill(name): if name not in CATALOG: raise ValueError("未注册的技能") return (ROOT / "skills" / name / "SKILL.md").read_text( encoding="utf-8" )模型不能提供任意文件路径。名称先通过白名单检查,再由程序拼接位置。
进入物流任务后,程序只把 get_shipping_status 提供给执行模型,同时加载物流 Skill 的正文。订单与发票工具不会一起开放。
不过,只限制工具列表还不够。执行器再次检查:模型实际请求的工具,是否就是当前技能允许的那个工具。
if name != CATALOG[skill]["tool"]: raise ValueError("该技能不允许调用此工具")接下来还要检查参数格式、订单号是否来自本次输入,以及当前用户是否有权访问该订单。
Skill 说明负责引导,程序检查负责约束。一句“不要查询别人的订单”不是权限系统。真实项目的身份必须来自可信登录会话,不能使用模型生成的 user_id。
示例中的 demo_user 是固定演示身份,真实上线时需要替换。对不可访问和不存在的订单,示例统一返回不可访问,避免靠错误信息暴露其他用户的订单存在与否。
运行离线演示:
cd /Users/wx/www/helloAgent/router-skillpython3 router_agent.py --offline '查询订单1001的物流'你会看到几个明确的步骤:路由匹配 shipping-status,加载对应的 SKILL.md,执行 get_shipping_status,返回虚构数据中的运输状态与承运方。
订单 1001 的演示物流是“运输中,已离开发货仓”,承运方是“演示快递”。数据没有预计送达日期,所以不应生成一个“明天下午到”的承诺。
这里必须区分两种运行模式。
离线模式使用规则分类、读取文件、直接调用工具,再按固定模板输出。它可以验证目录加载和工具映射,不调用模型,也不能证明模型会遵循 Skill。
模型执行模式会把选中 Skill 的正文和工具定义交给模型。模型提出调用,程序验证并执行,再通过 function_call_output 回传。返回时保留 call_id,让结果对应到正确的调用请求。
示例为工具循环设置了轮数上限,达到上限后要求模型根据已有结果收尾,避免无限循环。每轮请求重新提供当前指令和工具配置。
执行阶段通过 previous_response_id 延续响应,并使用 store=True;这意味着它依赖服务端保存的响应上下文。路由请求则使用 store=False。需要特殊数据保存策略的项目,应重新设计这一部分。
分类正确不代表业务输入完整。
“查一下物流”已经明确属于物流技能,但没有订单号。程序会提示补充订单号,不去查一个模型猜出来的订单。
“查询 1001 和 1002 的物流”包含多个订单。当前版本只支持单订单查询,会要求拆分请求。
为了让代码短小,示例把连续四位数字作为演示订单号,并要求工具参数出现在本次用户输入中。这不是完整的业务参数提取方案:年份、引用中的数字也可能被识别成订单号,真实编号还可能包含字母或更长的数字。
上线时应采用实际订单格式与可靠的输入校验,而不是照搬这条正则。
这个 CLI 每次只处理一条输入,没有多轮会话记忆。因此补充参数时,请重新输入“查询订单 1001 的物流”。直接回复“1001”,程序不会记得上一轮想查什么。
先把这些限制写清楚,再决定是否增加会话状态,系统才容易逐步扩展。
三项离线演示可以直接运行,不需要 API Key:
python3 router_agent.py --offline '订单1001发货了吗'python3 router_agent.py --offline '查询订单1001物流'python3 router_agent.py --offline '订单1001发票开了吗'python3 -m unittest -v test_router_agent.py需要体验模型执行时,在当前目录创建虚拟环境,安装依赖:
python3 -m venv .venvsource .venv/bin/activatepython -m pip install -r requirements.txtexport OPENAI_API_KEY='填入你自己的密钥'export OPENAI_MODEL='填入支持所需功能的模型名称'python router_agent.py '查询订单1001物流'默认仍由规则选技能,模型负责执行。若希望分类也交给模型:
python router_agent.py --router model '订单1001的发票开好了吗'所选模型需要支持示例使用的 Responses API、函数调用和结构化输出。不要将实际密钥写进文章、代码或版本库。
规则路由不产生模型分类调用;模型路由通常会增加一次请求。技能数量、提示词长度和执行轮次都会影响成本,应该测量后再比较。
本次交付的14 项离线单元测试已通过,覆盖分类出口、未知技能、跨技能调用、参数格式、订单访问边界,以及用模拟响应验证的工具反馈循环和次数上限。
这些测试没有请求真实模型。真实模型的路由准确性、指令遵循、延迟和费用仍需单独验证。离线测试通过,代表程序边界在覆盖的场景中符合预期,不代表自然语言能力已经验收。
建议准备一组小型评测集:正常查询、缺少参数、多意图、否定句、引用句、越权订单和查询失败。分别记录路由是否正确、工具是否允许、回答是否忠于结果。
当你的助手已经有多类重复任务,每类任务都有不同的处理方法,但仍可以由一个执行者完成时,Router + Skill 是一个值得尝试的起点。
它让新增能力有了明确的位置:登记目录,整理方法,接入工具,再增加评测样本。出现问题时,也更容易区分是选错技能、方法写错、工具失败,还是回答偏离结果。
它仍需要维护。技能描述不能含糊重叠;说明文件要与真实接口保持一致;更新规则后要回归测试;多个意图究竟应该追问、拆分还是进入工作流,需要业务明确决定。
技能变多并不自动要求增加 Agent。只有任务确实需要独立上下文、并行执行或不同职责时,再讨论多 Agent 协作。
从最小 Agent 到 Router + Skill,我们增加的核心能力是:先找到适用的方法,再在明确的能力边界内执行。
下一篇,我们继续补齐一个常见能力:《RAG 入门:让 AI 根据你的资料回答问题》。当答案不在订单接口里,而在文档和知识库里,助手应该怎样找到依据?