ARTICLE · 1155100
AI只是“最强搜索引擎+自动整理工具”吗?
AI只是“最强搜索引擎+自动整理工具”吗?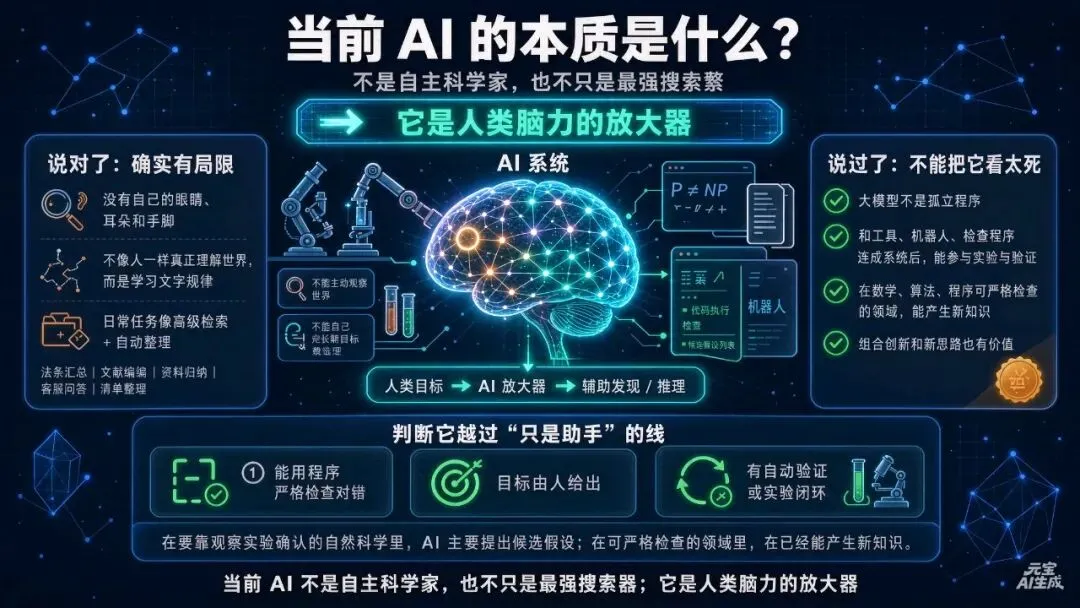
有人提出这样一个观点:当前的AI,本质上只是“最强搜索引擎+自动整理工具”,因为主流大模型不能真正做出原创性科学发现,也不能自己产生客观世界的新信息。 我的回答是:不能简单说对,也不能简单说错。这个观点说中了当前大模型的不少重要局限,但如果因此把AI的本质直接定成“搜索引擎+整理工具”,就把话说得太死、太窄了。 更准确地说,它混淆了三件事:光杆模型和整套系统;能不能做和会不会自己做;发现本来存在的东西和凭空创造新东西。 下面分开说。 第一,当前大模型确实没有自己的眼睛、耳朵和手脚,不能主动观察世界。它的学习材料,都是人类过去已经记录、上传的文字、图片和知识。它不能自己跑到野外做实验,不能自己发现一颗新天体,也不能自己观察到一种从未被报道过的病毒。它可以帮助人分析数据,但数据是人给它的,不是它自己出去找来的。所以,说它不能自主产生“从未被任何人记录过的客观新事实”,这一点基本成立。 第二,它不是像人一样真正理解世界。它本质上是根据海量文字里的搭配规律,猜出接下来最合适的词句。它没有喜怒哀乐,没有真正的好奇心,也没有“我想弄明白这个问题”这种内在冲动。它不会像牛顿或居里夫人那样,自己选一个方向,自己坚持研究很多年。它更像一个非常会接话、非常会总结、非常会组合信息的工具。这一点,学者也说对了。 第三,很多日常任务,确实就是高级检索加自动整理。比如法条汇总、文献摘编、资料归纳、客服问答、清单整理。搜索引擎给你一堆链接,你自己读、自己判断;大模型直接帮你把分散信息揉在一起,用通顺的话说出来。从使用感受上看,说它像“最强搜索引擎+整理工具”,在这些场景里是贴切的。 问题在于,大模型不是一个孤立的东西。它本身只是接收文字、输出文字的程序,但把它和代码执行、搜索工具、机器人、自动检查程序连在一起,就变成了另一回事。 光杆模型不能自己做实验,但“模型+工具+机器人+检查程序”这套组合,已经可以做实验、验证假设、根据结果改进。它缺的不是提出想法的能力,而是自己定目标、自己选择问题、自己形成长期研究动机的能力。人把目标给它,它就能干很多事。这是“自主性”的不足,不是“智能类型”的根本不同。 还有,没有人的主观理解,不等于没有能力。它在内部会形成一些关于事物怎么联系的规律,能举一反三,生成训练材料里没有直接出现过的长推理、新方案、新代码。它不稳定,会胡说,但不能因此说它只是复制粘贴。它确实比传统搜索引擎走得更远。 更重要的是,“不产生新事实”要分情况看。 如果是要靠观察和实验才能确认的新事实,比如新粒子、新天体、新疾病,它确实不能自己发现。它只能提出候选假设,最后还要人来验证。 但如果是在数学、算法、程序这种能用严格检查判断对错的领域,它已经能产生新知识。比如找到一个新的数学构造,或者找到一种更快的计算方法,程序可以验证对错。蛋白质结构和晶体材料预测也是类似:AI给出高可信的候选,但这些候选还要实验确认。所以,在要靠实验确认的自然科学里,它主要提候选假设;在能用程序严格检查的领域里,它已经能产生新知识。 另外,组合创新也有价值。人类很多创新不是发现全新事实,而是把不同领域的思路拼在一起。AI能在很短时间内跨领域拼接,给出人一时想不到的方案。这不是新事实,但可能是新思路。它还能当一个“可对话的外部大脑”,根据你的具体情况定制解释和方案,这也是普通搜索引擎做不到的。 最后,检索和整理本身也不丢人。它解决的是人注意力有限、记不住、读不完的问题。这个价值很大。问题不是“它是不是只是整理”,而是它在多少任务上已经能做得和人一样好,甚至更好,这个范围每年扩大多少。 当前AI不是自主科学家,也不是简单搜索引擎。它是基于人类已有知识,能生成、组合、推理、辅助验证的系统。 在人给目标、有严格检查程序或者实验闭环的时候,它能在某些领域产生新知识。在要靠观察实验的自然科学里,它主要产生候选假设。它缺的是自己定目标、自己选问题、自己形成长期研究动机。人给它目标,它就能干很多事。 判断标准可以很简单:这个任务能不能用程序严格检查对错?目标是不是人给的?有没有自动验证或实验闭环?满足得越多,AI就越可能越过“只是助手”的线。 那位学者说对的是:孤立的大模型,不能自己当科学家,不能自己发现要靠观察和实验才能确认的新事实。 他说错的是:把这一个局部限制,说成AI的本质只是最强搜索引擎加整理工具。 AI不只是搜索整理,但也还不是自主科学家。它是人类脑力的放大器。更实际的问题不是“它的本质是什么”,而是“哪些任务它已经能做得和人一样好甚至更好,这个范围每年扩大多少”。 一句话:当前AI不是自主科学家,也不只是最强搜索引擎;它是人类脑力的放大器。