ARTICLE · 1185252
AI基础 | Flash Attention
今天来看一个新的基础内容:Flash Attention。
Flash Attention 计算的注意力机制与 Transformer 已经使用的注意力机制完全相同,但其速度更快、内存占用更少。它没有改变数学原理,也没有改变运算结果。它仅仅改变了注意力机制在 GPU 上的计算方式,从而使其运行速度飞快,内存开销大幅下降。
简单来说:Flash Attention = 相同的注意力机制,在 GPU 上采用更聪明的计算方式。
标准注意力矩阵计算很慢?
因为 Q x K 和token序列长度直接相关,对于100000个Token的输入,注意力矩阵就是 100000 x 100000 = 100亿个条目。即内存空间随着 Token数量进行 平方级增长。
实际情况下,这个巨大的N x N矩阵 被GPU内存完整访问了 整整四次。
(1)GPU计算完N x N写入内存
(2)从GPU内存读取来算softmax
(3)将softmax存到GPU内存
(4)读出来和V相乘
(5)得到小得多的矩阵写入GPU内存
可以看到,同一个庞大的矩阵在内存中被反复来回搬运。GPU 的计算并不慢,它的计算核心速度极快——它们大部分时间其实都花在了等待从慢速内存中传输数据上。
GPU内存的实际工作原理
GPU有两种类型的内存。
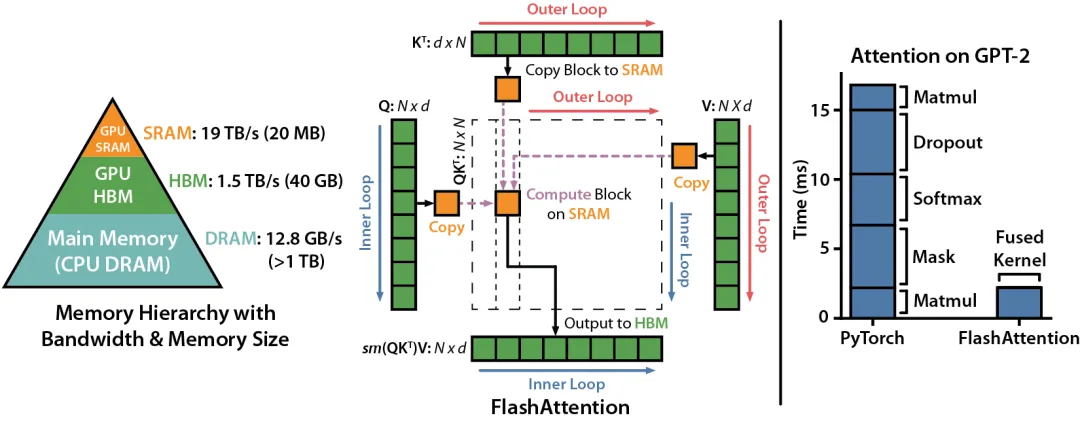
(1)HBM 高带宽内存 High Bandwidth MemoryGPU 上容量大但较慢的内存。它可以容纳几十 GB 的数据,但与 GPU 的计算速度相比,从 HBM 读取和写入数据的速度较慢。
(2)SRAM 静态随机存取内存,Static RAM容量小但速度极快的片上内存。从 SRAM 读取数据的速度大约是从 HBM 读取的 10 到 20 倍,但它一次只能容纳几百 KB 的数据。
要点:GPU 的计算速度很快,但在 HBM 和 SRAM 之间移动数据很慢。如果我们不断在 HBM 和 SRAM 之间搬运巨大的注意力矩阵,就会把大部分时间浪费在数据搬运上,而不是实际的数学计算上。
性能瓶颈:标准注意力机制会将完整的 N x N 注意力矩阵写入 HBM
Flash Attention 就是来处理这个瓶颈的。
Flash Attention背后的原理
核心理念:用SRAM来计算注意力,并且不把完整N x N矩阵写入HBM,这样就不用来回倒腾了。
实际操作:每次只处理一小块,完全在高速的 SRAM 内部完成计算,只把最终结果写回 HBM。
这么做的挑战:
(1)如何将工作拆解为小区块?(分块 Tiling)(2)当我们一次只能看到一个区块时,如何计算 softmax?(在线 softmax Online softmax)
Tiling分块
分块说的是将大型矩阵运算 拆解成 较小的、块大小的计算。
Flash Attn 将 Q、K、V切分成小块(比如256个Token一块),然后将Q区块和K区块加载到SRAM,算部分的注意力得分,并把得分和匹配的V区块相乘。
这里有一个bug:softmax是需要查看 整行数据才能正确计算。
标准的softmax分两步:先找这行的最大值;对于每个元素,计算与最大值的差的指数值作为分子,分母是所以分子的求和。
所以如何才能在 看不到完整行的时候,找到最大值和总和?
在线softmax
在线softmax是一个巧思,允许分段来计算softmax:每次新区块来,更新当前的最大值和总和,使得最终的结果与标准softmax完全相同。
(1)维护一个到目前为止的所有得分的 运行最大值 running_max
(2)维护一个到目前为止见过的exp(score - running_max)的运行总和 running sum
(3)维护一个到目前为止见过的加权V的运行输出 running output
(4)当一个具有更高最大值的新区块来,重新缩放之前的运行总和 和 运行输出,以匹配新的最大值
之所以能支持上述优化,是因为exp的相乘等同于exp的指数相加。
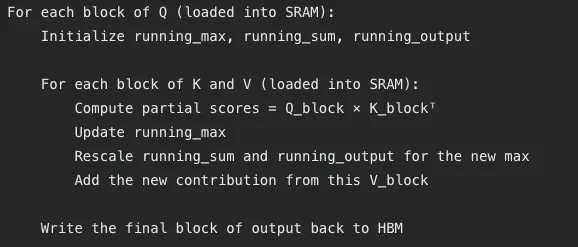
可以看出,N x N矩阵不用写入HBM,只有小的Q、K、V区块在HBM、SRAM中移动,最终的输出被写回。
反向传播
反向传播通常需要前向传播中计算出的注意力矩阵。在Flash Attn的设计中,在这个阶段,会在SRAM中重新计算注意力得分。具体而言:
(1)在前向传播期间,它为每一行保存了少量的 softmax 统计信息(仅运行最大值和运行总和),这只需要 O(N) 的额外内存。
(2)在反向传播中,它使用这些保存的统计信息以及 Q、K 和 V,在SRAM 内部快速重建注意力得分,而无需将巨型矩阵写回 HBM。
为什么用这些保存的信息就可以计算梯度了,这个是由softmax的数学特性决定的。
Flash Attention2
核心思想不变:分块并避免在 HBM 中存储完整的注意力矩阵。
通过3种方式重新组织计算,进一步减少浪费。
(1)更少的非矩阵乘法操作。非矩阵乘法指的是 FA1当中每当一个新的 K, V 块到达时,运行输出进行的重新缩放这个操作。
(2)跨序列更好的并行化。
(3)每个工作线程内更好的工作拆分。
Flash Attention 2 的速度大约是 Flash Attention 1 的 2 倍,而且输出的数学结果完全相同。
Flash Attention3
相同的核心思想、专门为英伟达Hopper架构(比如H100、H200)的GPU设计。采用异步复制的技巧,利用H100的张量内存加速器,使得GPU几乎不需要等待,一直可以计算。
总结
Flash Attn因为它的优势已经成了LLM的默认选择。
(1)速度快:对于长序列,速度通常比标准注意力快2-4倍;序列越长、加速越明显
(2)内存占用少:从O(N^2)到O(N),能支持更长序列的训练和推理
(3)结果完全相同:没有质量损失
(4)支持超长上下文
(5)可直接替换:计算层面的优化、不涉及模型架构和训练本身