ARTICLE · 1185262
AI量化交易|31 多因子选股:从 IC 评价到机器学习,科学地选出该买什么
前面几篇,海龟、缠论、网格教的都是「怎么交易」。但你会发现,无论哪个策略,效果都高度依赖选什么标的:海龟在趋势股上生猛、缠论在活跃股上信号多、网格在震荡股上收租。
那问题来了:怎么从全市场几千只股票和基金里,科学地选出值得交易的品种? 答案就是多因子选股。
一、因子:能预测未来收益的指标
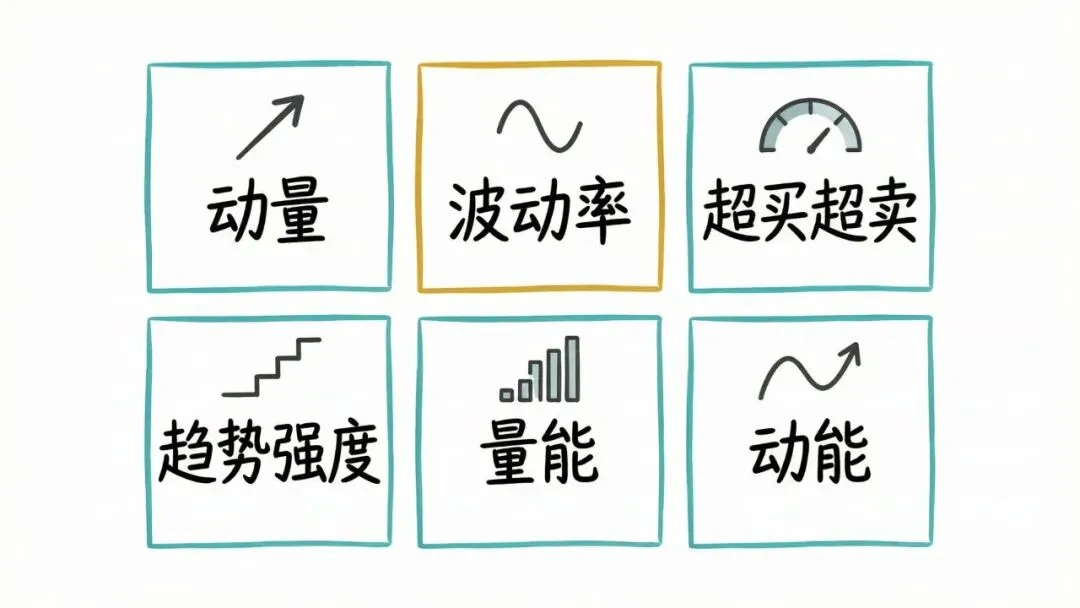
因子(Factor)= 能预测未来收益的指标。多因子选股 = 综合多个因子信息,选出最优股票组合。
常见的因子类型有六类,都能用 TA-Lib 算:
有了因子,下一个问题是:我算出一个因子,怎么知道它能不能预测未来收益? 两种方法:IC 分析和分层回测。
二、IC:因子好坏的「金标准」
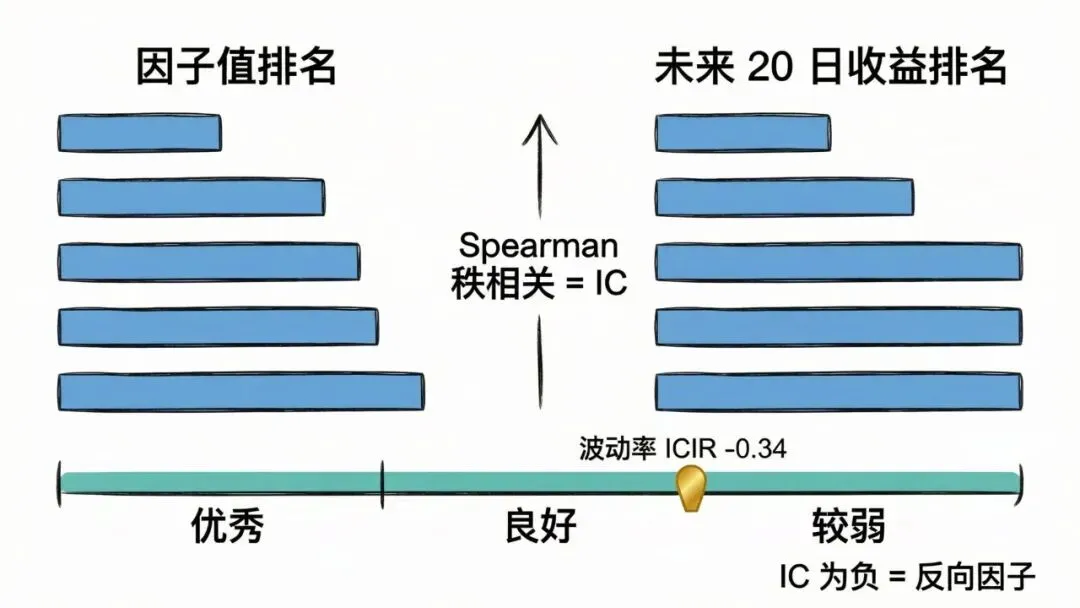
IC = 因子值与未来收益的 Spearman 秩相关系数。 每期(月末)计算一次:截面上所有股票的因子值排名,和同一批股票未来 20 日收益排名,算两组排名的 Spearman 相关系数,就是当期 IC。
四个关键指标:
为什么用 Spearman 排名相关而不是 Pearson?因为我们关心的是因子值排名高的股票,未来收益排名也高。 Spearman 只看排名顺序,不受极端值影响,更适合金融数据。
在正式看结果前,先交代一个数据细节。我们的数据池是从行情表里拉的全部标的,里面除了 A 股股票,还混进了 ETF 等基金(所以 159xxx、510xxx 开头的 ETF 也会出现在名单里)。严格说,下面这 6000 多只、以及后面的 6852、6870,都是「标的」而不是「股票」,其中纯 A 股股票大约 5000 多只。下文统一用「标的」来称呼。
对全市场 6974 只标的(2024-2025)做 IC 分析:
波动率因子的 IC 为负(-0.07),ICIR = -0.34,这意味着:波动率越高,未来收益越低,低波动股票表现更好。 这就是 A 股著名的「低波动异象」:低波动股票长期跑赢高波动股票,那些长期走得不显山不露水的股票,长期收益反而可观。
三、分层回测:IC 看不到的非线性
分层回测是把因子值从小到大分成 5 组(Q1 到 Q5),每月末重新分组,计算各组平均收益。如果 Q5 - Q1 价差显著,说明因子有区分能力。
波动率因子的 5 分位回测:
有意思的是,收益最高的不是 Q1(最低波动),而是 Q4(较高波动),这和 IC 分析矛盾吗?
不矛盾。 IC 是线性相关,分层回测是非线性的。波动率和收益是倒 U 型关系:适度波动最好,极高和极低都不好。Q5(极高波动)包含很多问题股,拉低了平均收益。
这提醒我们:股票里的很多规律不是简单的线性关系,有时要做二次构造才能把规律呈现出来。分层回测能帮我们看得更细。
四、多因子打分:8 个因子加权求和
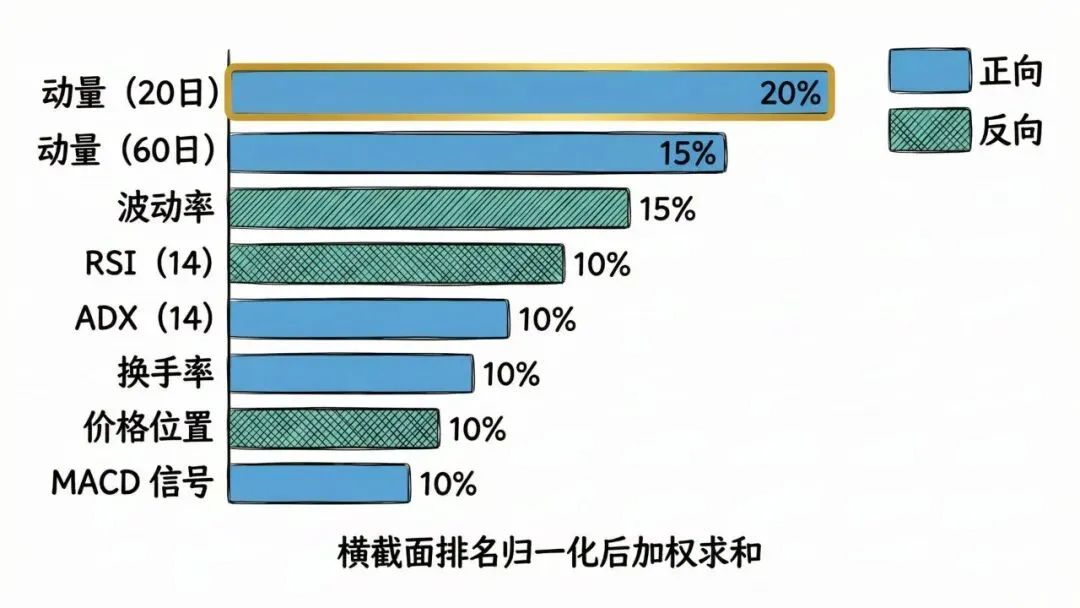
单个因子的预测能力有限(ICIR 大多 < 0.5),所以要多因子组合。我们设计一个 8 因子打分体系:
打分流程:
def score_stocks(factor_df): for fname, cfg in FACTOR_CONFIG.items(): # 1. 横截面排名归一化 (0~1) rank = factor_df[fname].rank(pct=True) # 2. 反向因子翻转 if cfg['direction'] < 0: rank = 1 - rank # 3. 按权重加权求和 factor_df['score'] += rank * cfg['weight'] return factor_df.sort_values('score', ascending=False)月度调仓流程是:每月末对全市场算 8 个因子 → 横截面排名打分 → 选出 Top-N → 持有到下月末,再重新计算、重新打分、调仓。这就像基金经理的换仓:等权配置,每个标的分到相同资金比例。
回测(2024-2025,6974 只标的):
怎么选?Top-5 收益最高(19.25%),但 Top-10 的夏普更高(0.56 对 0.49)。Top-5 集中度高、弹性大,但单个标的的影响太大、回撤 22%;Top-10 适度分散,收益和风险平衡,回撤仅 12%;Top-20 过度分散,因子效果被稀释。结论:Top-10 是最佳平衡点。
五、小市值轮动:A 股长期有效的异象
A 股有个长期有效的规律:小市值股票组的长期收益 > 大市值股票组。 这就是 Fama-French 三因子模型里的市值因子 SMB(Small Minus Big)。
三因子模型是:市场因子(MKT,大盘涨跌)、市值因子(SMB,小盘减大盘)、价值因子(HML,低 PE 减高 PE)。在 A 股,市值因子长期有效但近年减弱,价值因子阶段性有效。
纯小市值策略很简单:每月末按市值排序,选最小的 N 只,持有到下月末。这里要说明一句:日线行情表里没有现成的市值字段,回测里用的是「收盘价 × 20 日平均成交量」作为相对市值的代理指标(真实生产中应该用财务表里的总市值或流通市值),所以它排序的是「相对市值」,不是绝对市值。
增强版多两步:先选市值最小的 50 只做候选池,过滤掉 20 日动量 < -20% 的暴跌股和波动率 > 5% 的极端波动股,再按「市值排名 + 正动量 + 低波动」打分选 Top-N。
def rank_enhanced(all_data, calc_date, top_n=20, pool_size=50): # 第一步:市值排名选候选池 candidates = sort_by_market_cap()[:pool_size] # 第二步:过滤垃圾股 for code in candidates: if momentum_20d < -20: continue # 排除暴跌股 if volatility > 0.05: continue # 排除极端波动 # 第三步:综合打分 score = cap_rank * 0.5 + momentum * 0.3 + low_vol * 0.2回测(2024-2025,Top-10):纯小市值收益 15.93%、回撤 2.47%;增强版收益 10.07%、回撤 1.68%。
纯小市值收益更高,增强版的价值在哪?看回撤:增强版只有 1.68%。 纯小市值可能选到 ST 股、退市风险股,甚至选到正在暴跌的股票(越跌市值越小,越容易被选中),没有过滤等于什么都买。增强版用动量过滤止血、波动率过滤避雷。
另一个有意思的对比:小市值策略里 Top-20 收益反而最高(12.96%),和多因子打分(Top-5 最高)正好相反。因为小市值效应是群体性的,不是个股性的:多因子打分选的是「个股质量最好的前 N 只」,越集中越好;小市值轮动选的是一群小票,越分散效应越稳定。
到这里我们有了三种选股方法,放到一起对比:
六、因子选股 + 中枢网格:两条线合一
现在有两条线:网格线(怎么交易)和选股线(交易什么)。能不能融合?用因子选出适合做网格的标的,再在上面做中枢网格。
什么标的适合做网格?关键特征:
网格适配因子的配置和多因子打分不同,方向和权重为网格优化:
为什么 ADX 权重最高(30%)?因为它是趋势/震荡最直接的判断:ADX < 20 震荡市是网格天堂,20~40 趋势形成中风险增大,> 40 强趋势网格必死。
RSI 和动量的处理很特别:不是越低越好,而是越接近中性越好。所以在多因子选股里 RSI 低是「超卖反弹机会」(反向因子),在网格选股里 RSI = 50 意味着多空平衡(中性因子)。同一个指标,在不同策略目标下,方向可以完全不同。
def score_for_grid(factor_df): for fname, cfg in GRID_FACTOR_CONFIG.items(): if cfg['direction'] == 0: # 特殊因子:距离中性值越近越好 if fname == 'rsi_14': dist = (result[fname] - 50).abs() # RSI距离50 rank = 1 - dist.rank(pct=True) # 越近得分越高 elif fname == 'momentum_20d': dist = result[fname].abs() # 动量绝对值 rank = 1 - dist.rank(pct=True) # 越小得分越高融合流程:全市场 → 网格适配因子打分 → Top-N → chan.py 分析 → 有中枢就做中枢网格,没中枢就跳过。
对 6852 只标的打分,排名第一的 301617.SZ 得分 0.9305,ADX = 11.1(远低于 20,典型震荡)、RSI = 51.2(几乎正好 50,多空完美平衡)、动量 +0.76%(接近 0,没有方向)。这就是网格策略的理想猎物。
Top-5 中枢网格回测组合平均收益 +1.36%、最大回撤仅 2.64%,风险控制优秀。但要看清:得分第一的不一定收益最好,排名第五的 603001.SH 收益最高(+10.41%),因为因子打分是事前预测,回测收益是事后结果;得分第二的 301013.SZ 反而亏了,因为虽然因子显示震荡,实际却走出 +219% 的大趋势,网格踏空了。这再次验证:网格不适合趋势股。
七、ML 增强多因子:让数据学习最优因子组合
8 因子打分用的是人工定权重:动量 20%、波动率 15%……这些权重最优吗?不一定。人工权重凭经验拍脑袋、不同市场环境下最优权重可能不同、还忽略了因子之间的交互关系(高动量 + 低波动可能比单因子更有效)。
ML 的优势,就是让模型从数据中学习最优的因子组合方式。
特征工程用了 13 维,其中 ML 独有的是两个交互特征:
FEATURE_NAMES = [ # 动量系列 (4个) 'momentum_5d', 'momentum_10d', 'momentum_20d', 'momentum_60d', # 波动/趋势 (3个) 'volatility', 'rsi_14', 'adx_14', # 动能/量能 (3个) 'macd_hist', 'obv_slope', 'vol_ratio', # 价格位置 (1个) 'price_position', # 交互特征 (2个) ← ML独有 'mom_vol_cross', # 动量 * 波动率 'adx_rsi_cross', # ADX * (RSI-50)]为什么要交互特征?因为因子之间的组合效应可能比单因子更强:高动量 + 低波动是稳定上涨的好趋势,高动量 + 高波动是暴涨暴跌的陷阱,高 ADX + RSI>50 是确定性上涨。交互特征让模型直接看到这些组合关系。
训练用 Walk-Forward 滚动:每月用过去 12 个月数据训练 LightGBM,预测当月所有股票的未来 20 日收益,选预测值最高的 Top-10。为什么不用全部历史?避免未来信息泄露:如果用全部数据训练再回头测,等于拿答案做题。Walk-Forward 保证训练数据永远在预测时点之前,且模型定期更新适应市场变化。
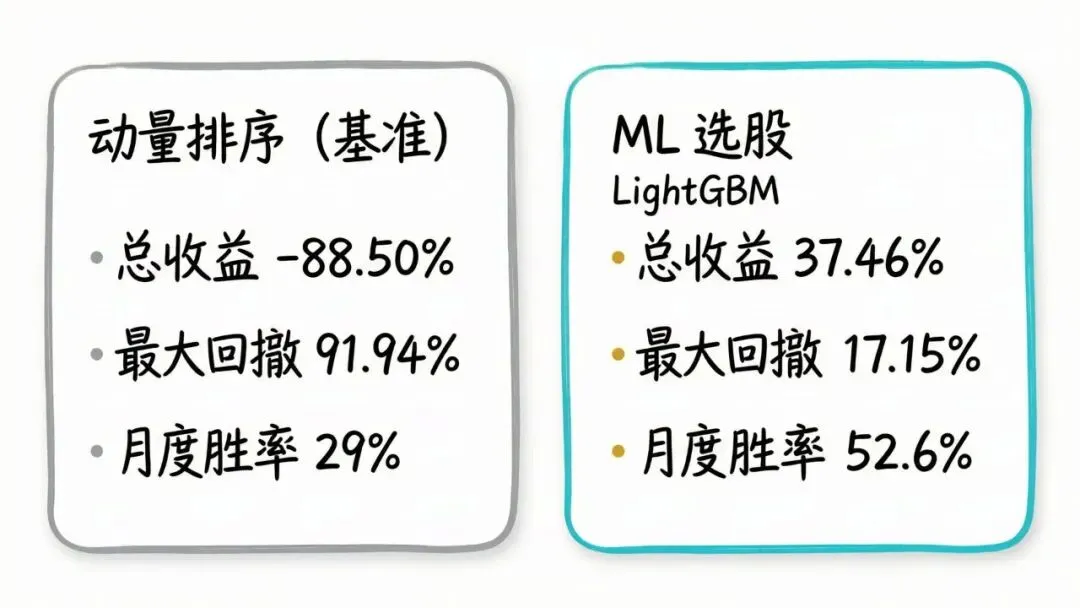
model = lgb.LGBMRegressor( n_estimators=100, # 100棵树 max_depth=5, # 最大深度5 (防过拟合) learning_rate=0.05, subsample=0.8, # 每棵树用80%样本 colsample_bytree=0.8, # 每棵树用80%特征 min_child_samples=10, # 叶节点最少10个样本)回测结果(198118 条样本,31 个月,6870 只标的):
动量排序亏了 88%,ML 选股赚了 37%,差距巨大。原因在于:动量排序只看 20 日动量最高的 10 只,本质是追涨杀跌,某些月份大涨时动量最高的股票已到顶部,下个月回落暴跌,反复追高被套。而 ML 综合 13 个特征,能发现「高动量 + 低波动」才是好组合、「高动量 + 高波动」是陷阱。
特征重要性里,波动率排第一、60 日动量排第二、价格位置第三、动量×波动率交互排第五。对比三个 ML 策略:
共同点是波动率/ATR 在所有 ML 策略里都重要(波动率是市场本质特征之一);差异是缠论 ML 独有的中枢高度(结构信息是缠论核心价值)、多因子 ML 的动量×波动率交互(因子组合比单因子更有信息量)。
ML 选股也有风险点要盯住:过拟合(限制深度、subsample、滚动验证)、未来泄露(Walk-Forward 严格时间分割)、因子失效(多因子分散、定期重训)、数据质量(清洗、极端值过滤)、交易成本(月度调仓控制换手)。
八、完整体系:把选股和交易串起来
到这里,我们搭起了一个完整的量化投资体系:
• 选股层:多因子打分 + 小市值轮动 + ML 增强; • 择时层:缠论中枢(震荡)+ 海龟突破(趋势)+ 网格(区间); • 风控层:ATR 仓位管理 + 中枢止损(ZG/ZD)+ 网格出界停止; • 增强层:LightGBM 信号过滤 + 特征工程 + Walk-Forward 验证。
三种策略,三种市场观,覆盖三种市场状态:
• 海龟的哲学:市场有惯性,涨了还会涨; • 缠论的哲学:市场有结构,结构决定买卖点; • 网格的哲学:市场会震荡,震荡就有差价。
所以市场环境不同,策略选择也不同:震荡市单标的用中枢网格,震荡市多标的用因子选股+网格,趋势市用海龟/缠论三买,不确定就用混合策略,追求 alpha 就上 ML 选股。
从海龟到缠论到网格再到多因子,这一整套走下来,核心其实只有一句话:把投资从凭感觉变成有规则,从拍脑袋变成数据驱动。 而多因子选股加中枢网格的最大价值,不是预测市场会涨还是跌,而是科学地选出值得交易的品种,在震荡区间内机械收租,用出中枢即停的纪律守住本金。
至此,AI 量化交易的「世界观」和「方法论」都讲透了。下一篇开始,我们会把选股、择时、风控、增强这套体系,交给真正的 AI 同事去跑起来。
关注 + 在看,别掉队。