ARTICLE · 1192239
WeTextProcessing 源码架构
1. 总览
WeTextProcessing 提供两个方向的文本处理:
TN(Text Normalization):书面形式 → 口语形式,例如
2.5平方电线→二点五平方电线。用于 TTS 前端。ITN(Inverse Text Normalization):口语形式 → 书面形式,例如
二点五平方电线→2.5平方电线。用于 ASR 后处理。
两个方向各支持中文(zh)、英文(en)、日文(ja),共 6 条 pipeline。系统分成两个阶段:
构图期:Python 代码用 Pynini 把规则描述成 FST,组装成一张 tagger 图和一张 verbalizer 图,写入缓存。
推理期:Python(
Processor)或 C++ runtime 加载这两张图,对输入文本做 FST 复合和最短路径搜索。
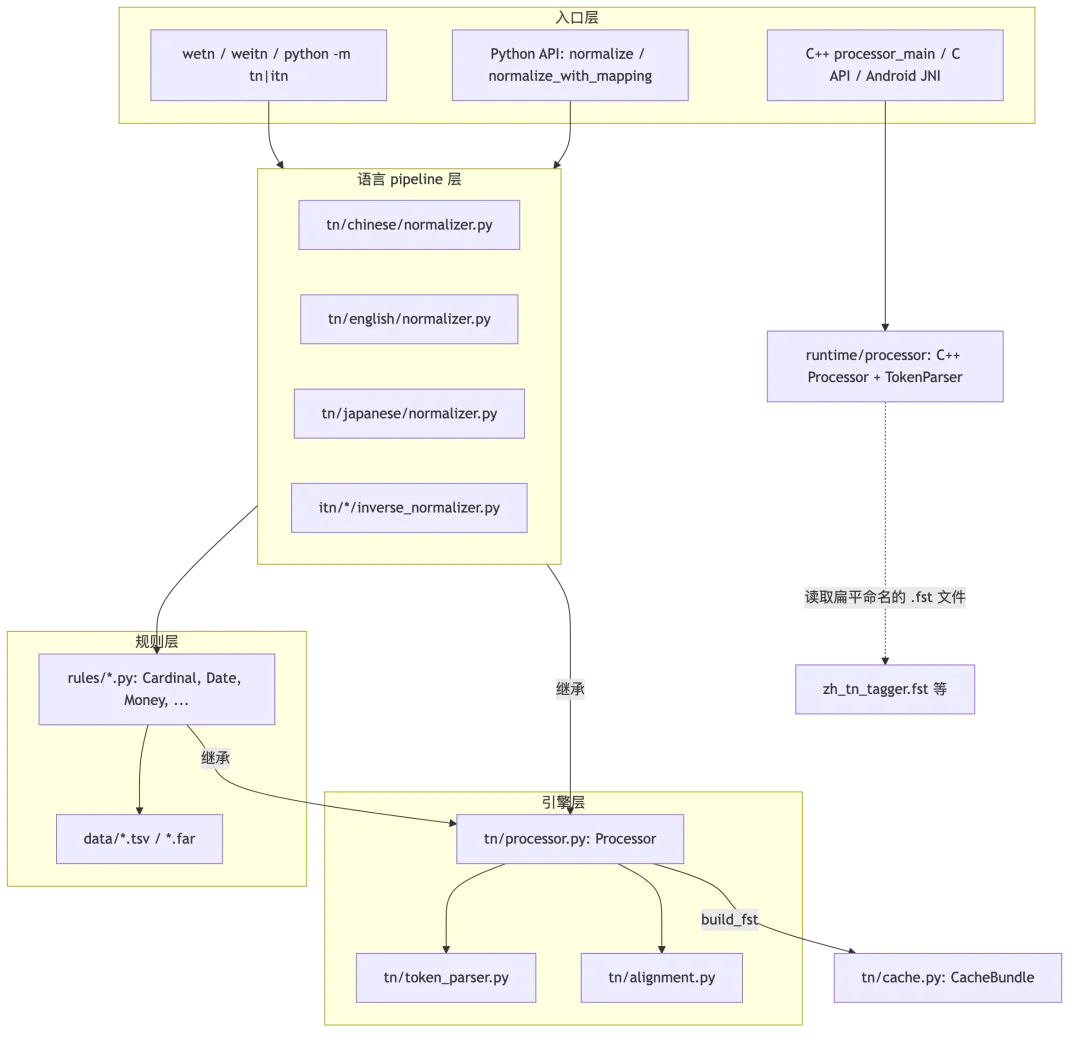
图中虚线表示 C++ runtime 需要扁平命名的 .fst 文件,而当前 Python 缓存产出的是哈希目录里的 tagger.fst,两者之间没有现成的转换工具
2. 仓库模块地图
路径 | 职责 |
|---|---|
| 引擎基类 |
| 中间串(wire format)的解析、重排与序列化 |
| 在一条 WFST 路径上追踪 token 的输入区间和输出区间 |
| 内容寻址的图缓存 |
| TN/ITN 共用的命令行实现 |
| 入口,分别调用 |
| 数据文件路径与词表加载工具; |
| 语言 pipeline: |
| C++ |
| 命令行工具 |
| JNI 绑定和 Android 示例应用 |
| 日志、命令行参数、UTF-8 字符串工具;OpenFst、glog、gflags、gtest 的 CMake 依赖 |
| 4 个 CI workflow |
itn 包没有自己的引擎,所有 ITN pipeline 和规则都继承 tn.processor.Processor。
3. 核心抽象
3.1 Processor:所有 pipeline 和规则的基类
每个规则类(如 Cardinal)和每个顶层 pipeline(如 Normalizer)都是 Processor 的子类。规则类负责产出自己的 tagger 和 verbalizer 两张子图;顶层 pipeline 负责把规则组装起来并调用 build_fst。
基类提供的能力分四组:
FST 积木:
__init__中定义的VCHAR、SIGMA、CHAR、DELETE_SPACE、INSERT_SPACE等常用图。规则工具:
build_rule(封装cdrewrite上下文重写)、add_tokens/delete_tokens(加上或剥掉name{...}外壳)。字段编解码:
tag_field、verbalize_field、input_projection、apply_input_processor。装配与推理:
tagger_union、verbalizer_union、build_fst、tag、verbalize、normalize、normalize_with_mapping。
3.2 字段编解码:tagger 只保存原始值
这是当前架构最核心的约定:
@staticmethod
definput_projection(graph):
# ...(docstring 省略)...
projected=graph.copy().project("input")
returnprojected.optimize()
deftag_field(self,name,graph):
"""Tags a weighted raw field using the quoted-field wire encoding."""
serialized=self.input_projection(graph)@self.CHAR.star
returninsert(f'{name}: "')+serialized+insert('"')
defverbalize_field(self,name,graph=None,leading_space=False):
"""Decodes a quoted raw field, then applies its semantic transducer."""
decoded=self.SIGMAifgraphisNoneelseself.SIGMA@graph
prefix=(" "ifleading_spaceelse"")+f'{name}: "'
returndelete(prefix)+decoded+delete('"')
每个规则先构造一张「书面形式 → 规范形式」的语义图,例如
Cardinal.cardinal负责把2.5转成二点五。tag_field对语义图做project("input"),只保留输入侧,再用CHAR转义引号和反斜杠。所以 tagger 输出的是cardinal{value:"2.5"},值是原始文本。verbalize_field(或手写的等价逻辑)在 verbalizer 中把原始值解码,再喂给同一张语义图完成转换。
这样设计的原因是:tagger 输出的每个字段都能精确对应回原文,normalize_with_mapping 才能沿着真实的 WFST 路径给出原文区间到结果区间的映射,而不必退化成文本 diff。
需要在匹配前规范化输入时(例如日文的全角转半角),规则通过 apply_input_processor 把预处理图复合进语义图。input_projection 取到的仍是预处理之前的原始输入,因此这个约定依然成立。
3.3 RuleSpec:一份清单生成两张图
@dataclass(frozen=True)
classRuleSpec:
"""One pipeline rule and its top-level classifier weight."""
rule:object
tagger_weight:Optional[float]=None
verbalize:bool=True
@staticmethod
deftagger_union(rule_specs):
"""Builds the classifier union from one ordered rule inventory."""
taggers=[add_weight(spec.rule.tagger,spec.tagger_weight)forspecinrule_specsifspec.tagger_weightisnotNone]
ifnottaggers:
raiseValueError("rule inventory must contain at least one tagger")
returnunion(*taggers).optimize()
@staticmethod
defverbalizer_union(rule_specs):
"""Builds the verbalizer union from the same rule inventory."""
verbalizers=[spec.rule.verbalizerforspecinrule_specsifspec.verbalize]
ifnotverbalizers:
raiseValueError("rule inventory must contain at least one verbalizer")
returnunion(*verbalizers).optimize()
有
tagger_weight的规则参与 tagger 并集,权重越小越优先。tagger_weight=None的规则只进 verbalizer。典型例子是Range:它不单独参与分类,而是作为range_tagger嵌在Date/Time的 tagger 里,但它产出的range{...}token 需要顶层 verbalizer 认识。verbalize=False用于「只分类、不需要顶层 verbalizer」的规则。
tagger 和 verbalizer 从同一份清单生成,可以避免新规则只被加到其中一边。
4. 中间格式(wire format)
tagger 和 verbalizer 之间传递的是一段纯文本:
name{key:"value"key2:"value2"}name2{value:"..."}
相关约定:
转义:值里的
"和\必须转义。tagger 侧由CHAR处理,TokenParser侧由escape_value处理。字段顺序:tagger 产出的字段顺序可能和口语顺序不同,由
TokenParser按 schema 重排。schema 归属:每条 pipeline 在自己的文件里定义
TOKEN_ORDERS,通过Processor(...,token_orders=TOKEN_ORDERS)传入。tn/token_parser.py里的TN_ORDERS/ITN_ORDERS/EN_TN_ORDERS只是直接实例化单个规则时的后备默认值。重排规则:schema 中列出的字段按 schema 顺序输出,schema 没有列出的字段追加在后面;若 token 带
preserve_order:"true",则保持原顺序。
defstring(self,orders):
output=self.name+" {"
order=self.order
ifself.nameinorders.keys():
if"preserve_order"notinself.members.keys()orself.members["preserve_order"]!="true":
canonical_order=orders[self.name]
extra_fields=[keyforkeyinself.orderifkeynotincanonical_order]
order=canonical_order+extra_fields
forkeyinorder:
ifkeynotinself.members.keys():
continue
output+=' {}: "{}"'.format(key,escape_value(self.members[key]))
returnoutput+" }"
TokenParser 是手写的递归下降解析器。格式错误时抛出 TokenParseError,例如重复字段、未闭合的引号或花括号。reorder_with_spans 在重排的同时记录每个 token 在新文本中的区间,供对齐子系统使用。
5. 各语言 pipeline 的装配
6 条 pipeline 都遵循同一模式:实例化规则 → 声明 RuleSpec 清单 → tagger_union / verbalizer_union → 拼接后处理 → build_fst。差别主要在输入预处理、token 之间的拼接方式和后处理:
pipeline | 文件 | 输入预处理 | token 拼接 | 后处理 |
|---|---|---|---|---|
zh TN |
| 无 |
|
|
zh ITN |
| 无 |
|
|
en TN |
| 无 | 标点 + 空格分隔的 token 序列 | 无独立后处理,verbalizer 自己处理空格 |
en ITN |
| 无 | 标点 + 空格分隔的 token 序列 | 无独立后处理 |
ja TN |
|
|
|
|
ja ITN |
|
|
| 无 |
补充说明:
zh TN:没有独立的预处理阶段,繁转简放在
PostProcessor里,因为规则契约要求 tagger 保留原始输入。权重从date(1.02) 到char(100);Range只参与 verbalizer。zh ITN:独有
LicensePlate(车牌)和TrainNumber(车次),权重都是 1.0。构造参数enable_standalone_number/enable_0_to_9/enable_million会传给Cardinal等规则。en TN / en ITN:英文需要保留词与词之间的空格,所以没有用
.star,而是显式写出「标点* + 分类 token + 标点*」,token 之间以空格或标点分隔。英文 TN 的 verbalizer 只在分类 token 后插入空格,标点 token 自带空格信息。ja TN:
transliterate=True时额外加入Transliteration规则(权重 1.04)。ja ITN:除了常规
Cardinal,还构造了一个enable_million=True的Cardinal,专门给Fraction使用。
各 pipeline 传给 build_fst 的 cache_config(例如 zh TN 的 6 个布尔开关)会进入缓存 key,所以不同参数组合各自对应一个缓存。
6. 推理数据流
6.1 单条路径:tag → verbalize
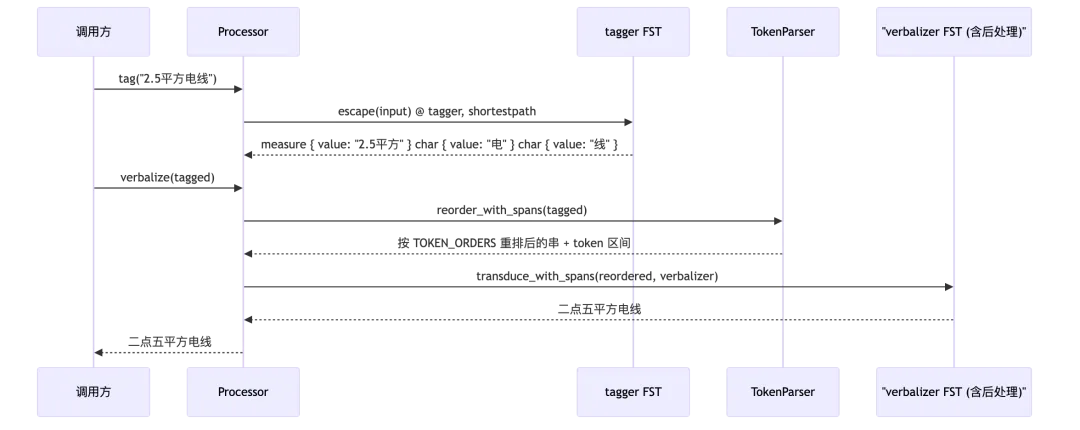
命令行和 C++ processor_main 都是这样分两步调用的,并分别打印两步的结果。
6.2 normalize:联合 n-best 搜索
normalize 不是简单的 verbalize(tag(x))。它在 tagger 和 verbalizer 两级上联合排序候选(_normalization_candidates):
_UniqueOutputPathStream把 tagger 的输出路径按权重从小到大懒加载,每次需要更多候选时把nshortest翻倍,并对输出去重。每取出一个 tagged 候选,就为它建一个 verbalizer 路径流。
候选按下面的权重放进最小堆:
@property
defweight(self):
returnself.tagger_weight+self.verbalizer_weight-self.best_verbalizer_weight
减去该 tagged 串的最优 verbalizer 权重后,跨 tagged 串的比较只看 tagger 权重,同一 tagged 串内部的多种口语形式仍保留相对代价。这样,尚未展开的 tagged 候选的 tagger 权重就是一个精确下界,可以安全地决定何时展开下一个候选。
按输出文本去重,直到凑够
nbest个。
nbest=1 返回字符串,nbest>1 返回列表。
6.3 normalize_with_mapping
先用 6.2 得到候选,再对每个候选用对齐子系统求出每个 token 的输入区间和输出区间,封装成 NormalizationResult。
7. 对齐子系统(tn/alignment.py)
目标:对于每个 tagged token,给出它在原文中的区间和在结果中的区间。实现完全基于 WFST 路径,没有文本 diff 兜底。
输出侧:
transduce_with_spans(重排后的串,verbalizer,token区间,output_text)先把输入约束为该串(如果给了output_text,输出也约束为它),再取唯一最短路径,然后逐条弧线扫描:消耗了某个 token 输入区间内字节的弧线,其输出就归这个 token;token 边界处的空白输出不归任何 token;被整体删除的 token 得到一个零宽区间。输入侧:
trace_input_spans(原文,tagged串,tagger,token区间)构造accep(原文)@tagger@accep(tagged),沿唯一路径反向确定每个 token 消耗了原文的哪些字节。路径必须是线性的(
_linear_arcs遇到分叉或环会抛AlignmentError);内部按 UTF-8 字节计算,最后换算回 Unicode 字符偏移(左闭右开)。如果路径把一个码点切开,同样会抛错。
结果结构:
NormalizationMapping:kind(equal/replace/delete)、token_type、输入和输出的起止偏移与文本。NormalizationResult:input_text、output_text、mappings,并提供as_dict()。
默认不返回 equal(原文和结果相同)的映射,include_identity=True 时才返回。
8. 缓存子系统(tn/cache.py)
8.1 缓存 key 与目录布局
config_identity={
"config":cache_config,
"ordertype":ordertype,
"prefix":prefix,
}
self.config_digest=_hash_bytes(_canonical_json(config_identity))
bundle_identity={
"builder":self.builder,
"config_digest":self.config_digest,
"source_fingerprint":source_fingerprint,
}
self.bundle_digest=_hash_bytes(_canonical_json(bundle_identity))
self.parent=self.cache_root/prefix/self.config_digest
self.path=self.parent/self.bundle_digest
self.lock_path=self.parent/".{}.lock".format(self.bundle_digest)
source_fingerprint(production_source_fingerprint):对tn/、itn/下所有.py/.tsv/.far的内容做 SHA-256,排除test/、__pycache__和_version.py。改任何规则或词表,key 都会变。builder(_builder_identity):缓存格式版本、Python 版本与实现、pynini 版本、字节序。cache_config:pipeline 的构造参数。
目录布局:
<cache_root>/<prefix>/<config_digest>/<bundle_digest>/
tagger.fst
verbalizer.fst
manifest.json# 记录身份信息,以及两个 .fst 文件的大小和 sha256
cache_root 的取值:
| 行为 |
|---|---|
|
|
| 只在内存中构图,不读也不写缓存 |
路径 | 作为缓存根目录 |
wheel 包不再附带预编译的 .fst 文件(pyproject.toml 的 package-data 只包含 .tsv / .far),因此首次使用时会在本机构图。
8.2 build_fst 的流程
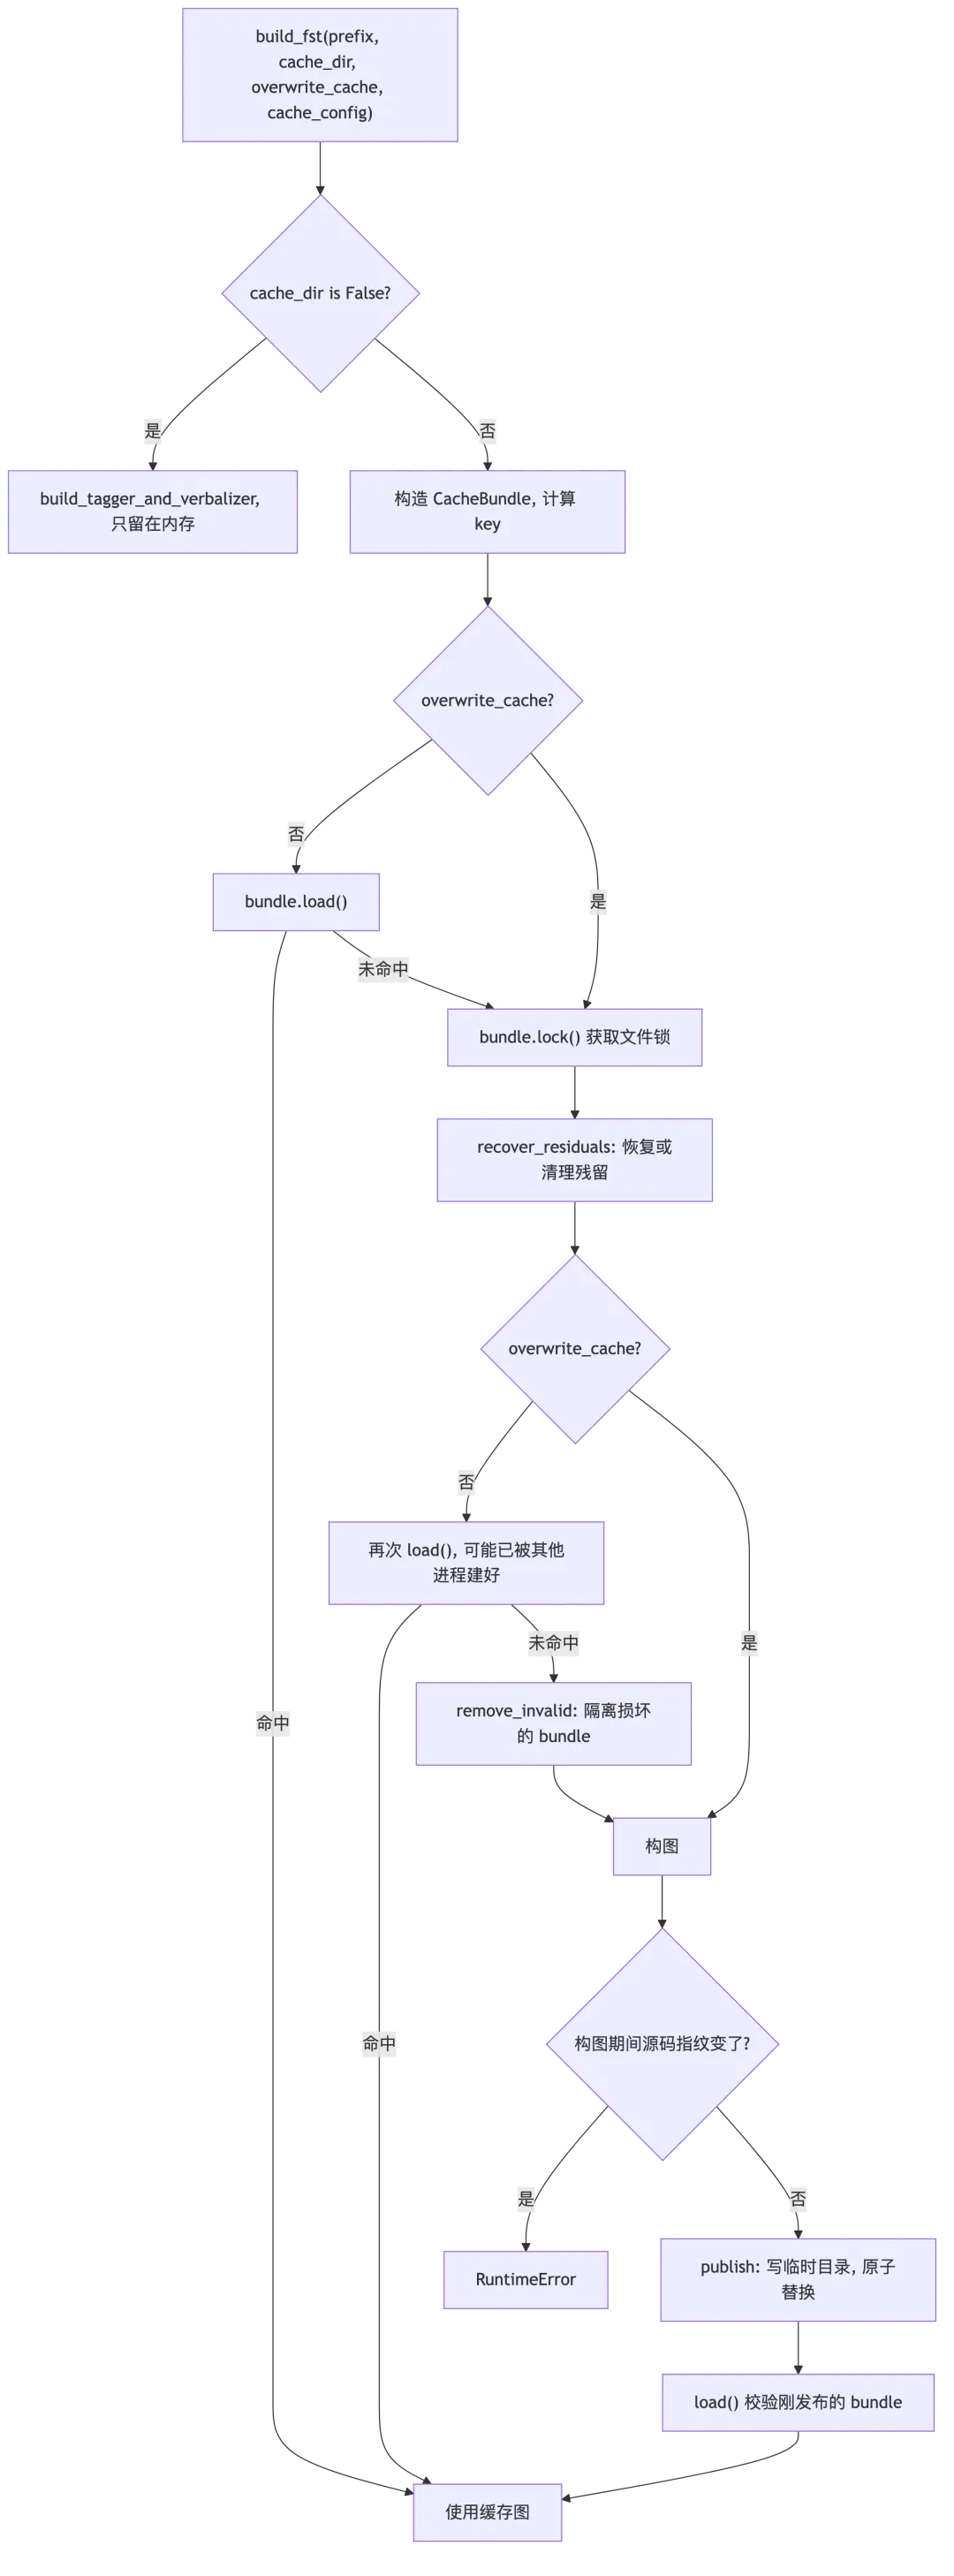
可靠性相关的设计:
加锁:POSIX 用
flock,Windows 用msvcrt.locking。默认超时 10 分钟,可用环境变量WETEXTPROCESSING_CACHE_LOCK_TIMEOUT调整。锁文件里记录持有者的主机名和时间,超时时会报出来。原子发布:先写到
.<digest>.tmp-*临时目录并 fsync,再用os.replace换到正式路径。旧 bundle 先挪到.previous-*,发布失败时可以恢复。完整性校验:
load()要求目录里恰好有 3 个文件,manifest 中的身份信息全部匹配,且.fst的大小和 sha256 与 manifest 一致;任一不符都视为未命中。路径安全:拒绝符号链接、Windows junction 和特殊文件;所有子路径都必须位于缓存根目录之下。
因为 key 包含源码指纹,修改规则后直接重新运行就会构建新的 bundle。overwrite_cache=True 只是在同一个 key 已有缓存时强制重建。
9. 命令行入口(tn/cli.py)
入口关系:
pyproject.toml中wetn=tn.main:main、weitn=itn.main:main。python-mtn/python-mitn经由__main__.py调用同一个main。两个
main都只是tn.cli.run("tn")/run("itn")。
run 的工作方式:
_selected_language先只解析--language,然后create_parser(direction,language)只注册该语言、该方向支持的参数。例如 zh TN 有--remove-erhua,ja TN 有--transliterate。布尔参数同时支持
--flag、--no-flag和旧的--flagTrue|False写法。create_processor按需导入并构造对应的 pipeline。输入来源三选一:
--text、--file、标准输入。每行只去掉行尾换行符,其他空格原样保留。每行输入输出两行:
def_process_line(processor,text,stdout):
tagged=processor.tag(text)
print(tagged,file=stdout)
print(processor.verbalize(tagged),file=stdout)
注意命令行走的是 tag + verbalize 两步,不是 normalize 的联合搜索。
10. C++ runtime
C++ 侧只做推理,不构图。依赖 OpenFst、glog、gflags(通过 runtime/cmake/*.cmake 用 FetchContent 拉取),使用 C++20 标准。
wetext::Processor(runtime/processor/wetext_processor.cc):构造时读入 tagger 和 verbalizer 两个.fst,并根据 tagger 路径中是否包含zh_tn_、zh_itn_、en_tn_、en_itn_、ja_tn_、ja_itn_来决定ParseType,都不包含时LOG(FATAL):
if(tagger_path.find("zh_tn_")!=tagger_path.npos){
parse_type_=ParseType::kZH_TN;
}elseif(tagger_path.find("zh_itn_")!=tagger_path.npos){
parse_type_=ParseType::kZH_ITN;
}elseif(tagger_path.find("en_tn_")!=tagger_path.npos){
parse_type_=ParseType::kEN_TN;
}elseif(tagger_path.find("en_itn_")!=tagger_path.npos){
parse_type_=ParseType::kEN_ITN;
}elseif(tagger_path.find("ja_tn_")!=tagger_path.npos){
parse_type_=ParseType::kJA_TN;
}elseif(tagger_path.find("ja_itn_")!=tagger_path.npos){
parse_type_=ParseType::kJA_ITN;
}else{
LOG(FATAL)<<"Invalid fst prefix, prefix should contain"
<<" either \"_tn_\" or \"_itn_\".";
}
Tag 是「编译输入串 → Compose → ShortestPath」;Verbalize 先用 TokenParser 重排,再过 verbalizer;Normalize 等于 Verbalize(Tag(input))。
wetext::TokenParser(runtime/processor/wetext_token_parser.cc):PythonTokenParser的 C++ 移植,按 UTF-8 字符解析。schema 在源码里写死:ZH_TN_ORDERS、JA_TN_ORDERS、EN_TN_ORDERS,三种 ITN 共用ITN_ORDERS。C API(
runtime/processor/wetext_processor_c_api.h):wetext_create_processor/wetext_destroy_processor,wetext_tag/wetext_verbalize/wetext_normalize。返回的字符串在堆上分配,调用方必须用wetext_free_string释放。processor_main(runtime/bin/processor_main.cc):参数为--tagger、--verbalizer、--text、--file,对每行输出 tag 和 verbalize 两行结果,与 Python 命令行一致。