ARTICLE · 1212942
AI在实验室“翻车”后,自己改了下一轮|AI日日新 · 10月19日
AI日日新 · 2026年10月19日
AI在实验室“翻车”后,自己改了下一轮
这几天最有意思的 AI 进展,不是一张新榜单,而是一次做错、发现错误、再改办法的过程。另一边,编程模型开始展示完整项目,营销 Agent 也开始接收有触发条件的长期任务。
01 / 研究现场
第二轮更差了,第三轮为什么又涨回来?
Google Research 10 月 16 日披露一组“实验室在环”的原型研究:AI 智能体设计候选 DNA 适配体,实验室实际合成、筛选、测序,再把读数送回下一轮设计。肌红蛋白靶点的真实命中率在第一轮为 10.2%,第二轮却跌至 3.7%。
问题不是模型“不会生成”,而是它偏爱一种容易黏住磁珠或其他蛋白的结构;看起来会结合目标,实际特异性很差。研究人员分析实验读数后,智能体在第三轮限制这类结构、扣除磁珠假阳性,命中率升到 33.5%。这组数字来自两个特定靶点的受控实验,不能外推成“AI已经能自动造药”。
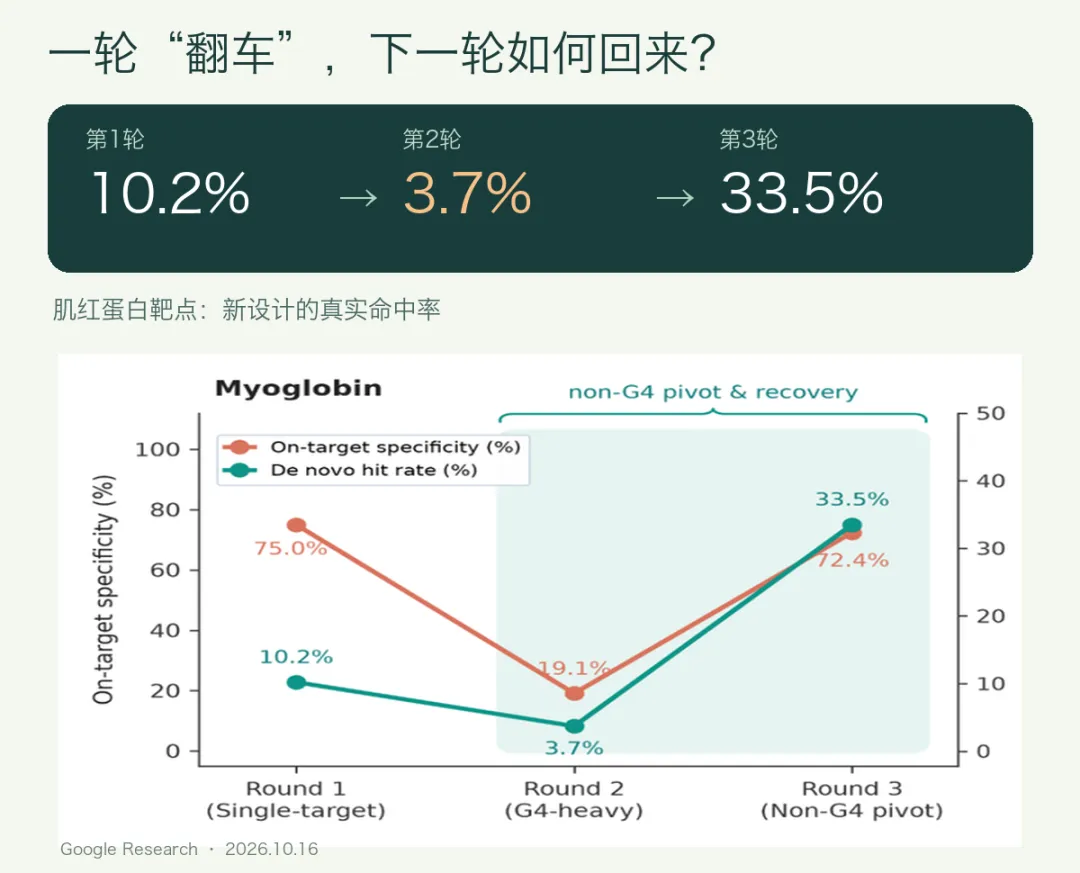
图:Google Research 10 月 16 日原始实验曲线;上方数字为肌红蛋白靶点的真实命中率。
更好玩的细节出现在机械臂旁:一个 8 通道移液动作在代码上成立,却根本塞不进狭窄的试剂槽。Google 的 VERID 系统让实验流程先在实验室的实时数字模型里跑一遍,拦下物理上做不到的动作,再让智能体重新规划。
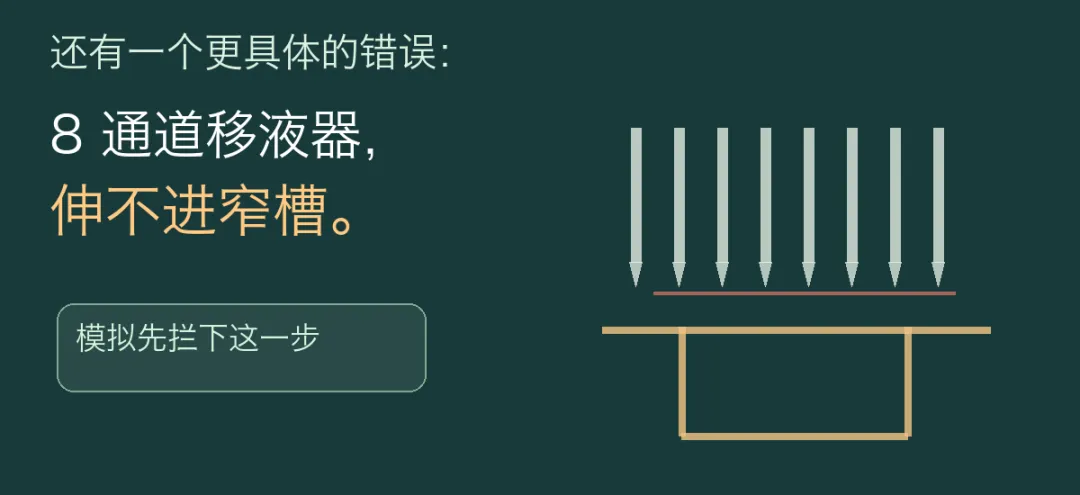
细节来源:Google Research 对 VERID 实验室数字模型的案例描述。
这项研究已经有真实实验读数,但仍处于受控研究原型阶段;研究人员授权设计、检查流程并监督机器人运行。
02 / 编程模型
DeepSeek把“做个游戏”做成了展示题
10 月 17 日,DeepSeek 将网页、App 和 API 的 Flash 模型更新为 V4.1-Flash-1017,并公开模型权重。官方称它在编程和智能体测试中较旧版进步,同时缩短任务时间与输出长度;这些对比来自厂商发布的测试,实际项目体验还要另看。
比一串分数更直观的是官方动图:一个网页版赛车游戏从菜单进入可玩的赛道。DeepSeek 把它列为“较少提示词与素材参考、在 Harness 环境内完成”的项目展示。它能说明模型正在尝试把需求推进到作品,不能证明任意游戏都能一次生成。
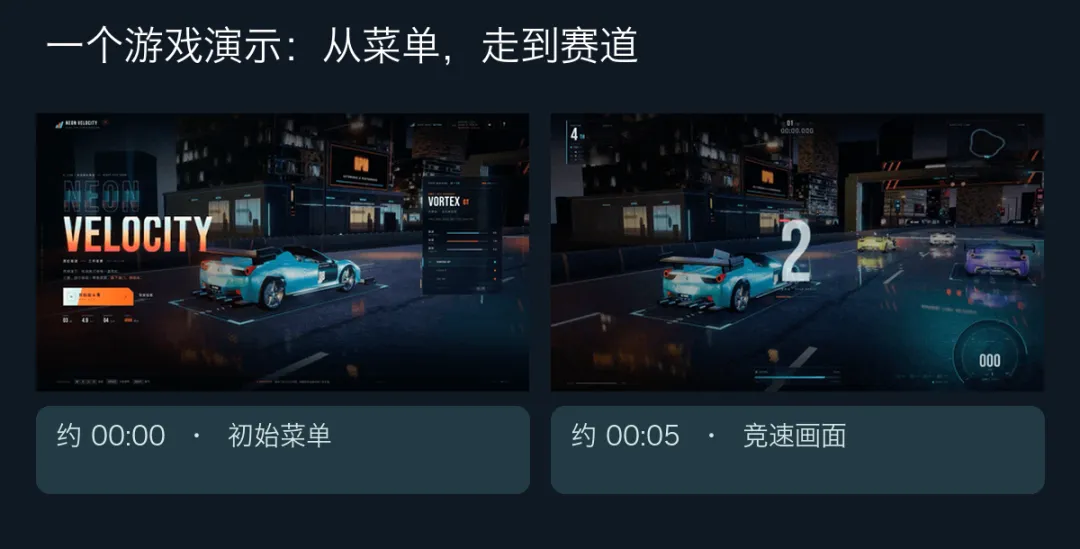
画面:DeepSeek 10 月 17 日官方演示动图,约 00:00 与 00:05 截帧;点击查看原文完整演示。
同次更新还向开发者开放 Search 和 Fetch 接口,让应用可以调用 DeepSeek 自建搜索能力。模型更新已同步到网页、App 与 API;接口调用方式和模型价格未改。
03 / 创作者工作流
营销 Agent 不再只等你按“运行”
Profound 在 10 月 16 日发布新版营销 Agent。建任务时可以用自然语言描述目标,让系统草拟流程,再由团队编辑和测试。运行可以按时间表,也可以由事件触发:比如竞品发了新文章,或某个页面突然成为 AI 回答里的高频引用。
这对内容团队有个现实用处:把“每周盯一次竞品、整理值得写的角度”变成持续执行的任务。它仍需要品牌上下文、工具连接和发布前判断;自动运行不等于自动判断每个结论都对。
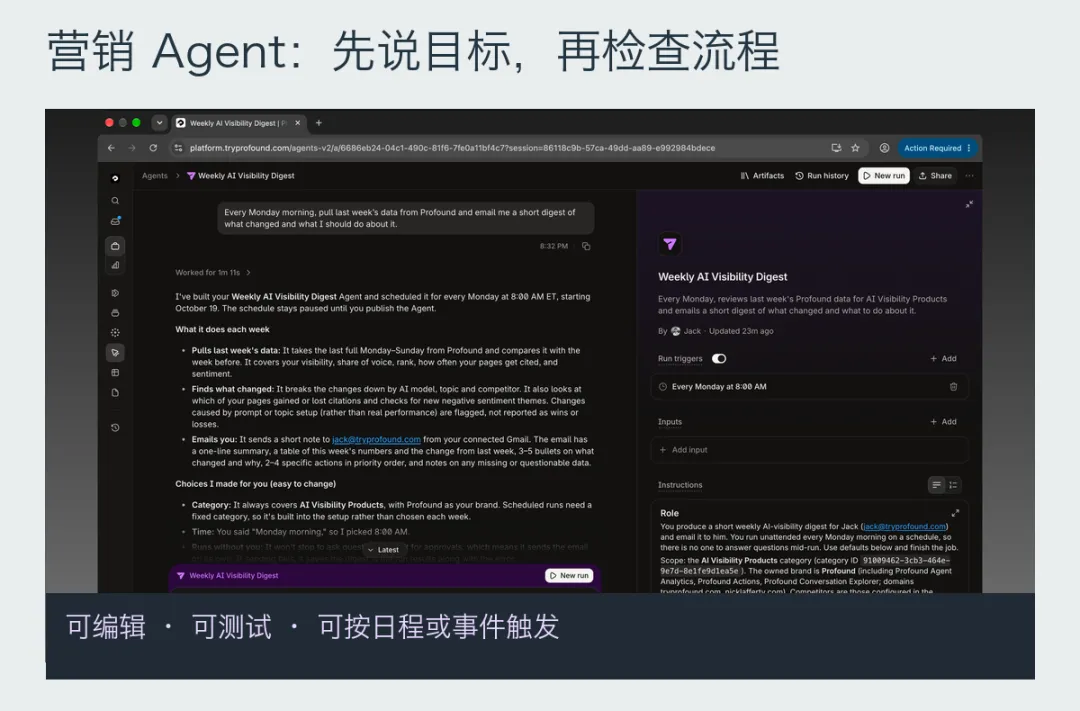
画面:Profound 官方 Agent Builder 界面;点击观看原始产品演示。
把这三条放在一起,最值得注意的不是 AI 会不会“全自动”,而是它开始拥有更长的工作循环:执行、得到反馈、修改下一步。循环越长,证据、检查和人做决定的位置就越关键。
原始资料
Google Research:自主湿实验研究
DeepSeek:V4.1 Flash 1017 官方发布
DeepSeek:官方模型权重与技术卡
Profound:新版营销 Agent
Profound:Agent Builder 官方演示