ARTICLE · 1259124
「设计一个在线文档协同编辑系统」:从 WebSocket、OT/CRDT 到快照回放,一篇讲透这道面试顶流题
🧨 一道能把人问崩的面试顶流题
朋友去面某大厂,面试官笑眯眯一句"设计个飞书文档",接着连环追问 40 分钟:两个人同一位置同时打字谁说了算?断网十分钟回来怎么补?30 万长连接怎么扛?——答完 WebSocket 和 OT 只是开始,真正的坑在后面。
🎯 为什么值得你花 20 分钟读完一题考四样:实时通信 + 分布式一致性 + 冲突解决算法 + 存储设计。后端、全栈面试的"必考题王",也是团队真要上协同能力时的现成设计文档。
📦 这篇能给你什么(全是硬货)
✅ OT 变换函数完整可运行代码:同位置 tie-break、删除区间裂变、重叠做减法——魔鬼细节全处理 ✅ CRDT 三块核心拼图:LSEQ 位置串 / RGA 邻居定位 / 向量时钟合并 + 墓碑 GC ✅ 服务端定序落地:文档级 Actor 单线程跑道,把分布式并发降级成单机串行 ✅ 跨节点广播:Redis Pub/Sub vs Kafka 怎么选,一行 INCR分 seq 的巧劲✅ 快照 + OpLog:任意版本秒级回放,存储成本直降 70% ✅ 断线重连 / 离线合并 / Presence 光标 / 权限防越权:别人漏讲的全补上 ✅ 18 条难点速查总表:面试直接复述,项目直接对照
👀 适合谁看 冲系统设计面试的你 · 要落地协同编辑的你 · 想搞懂"为什么飞书和 Figma 选了不同的路"的你
💬 文末互动:你团队会选 OT 还是 CRDT(Yjs)?评论区聊聊,我挑典型回复详细展开。
👉 干货太密,建议先「收藏」再慢慢啃,顺手点个「赞」和「在看」,别让它在信息流里沉了。
━━━━━━━━━━━━━━━━━━━━
「设计一个在线文档协同编辑系统」:从 WebSocket、OT/CRDT 到快照回放,一篇讲透这道面试顶流题
前段时间朋友去面某大厂,面试官笑眯眯地抛出一道题:"设计一个类似飞书文档 / 腾讯文档的协同编辑系统,说说架构、难点和解决方案。"他答了 WebSocket 和 OT,结果被连环追问了 40 分钟:两个人同一位置同时打字怎么办?断网十分钟回来呢?30 万长连接怎么扛?
这道题几乎是后端 / 全栈面试的"顶流",因为它一题考四样:实时通信、分布式一致性、冲突解决算法、存储设计。今天这篇把我整理的所有笔记揉在一起,从需求澄清讲到架构、从 OT/CRDT 算法讲到可运行的 Java 代码、从断线重连讲到历史版本回放,面试能直接背,真要做项目也能当设计文档用。适合正在准备系统设计面试、或者团队里真要上协同编辑能力的同学。
一、先别急着画图,先把需求"抠"清楚
实际面试里,开口就画框图的候选人会被追问到死。成熟的工程师会先花一两分钟对齐边界——这不是拖时间,而是在给后面的设计定调子。
| 最终一致 | ||
💡 一句话定性:这是一个"高频小写入 + 强实时广播 + 强收敛一致性"的系统。难点不在 CRUD,也不在存储,而在——怎么让 10 个人同时打字还不互相覆盖。
协同编辑的本质,是把并发的用户操作,转换成所有端最终一致的操作序列。记住这句话,后面所有设计都是为它服务的。
二、整体架构:网关管连接、协同服务管冲突、消息层管广播、日志快照管持久化
系统采用分层解耦设计,核心思路是"客户端乐观更新 + 服务端集中定序":
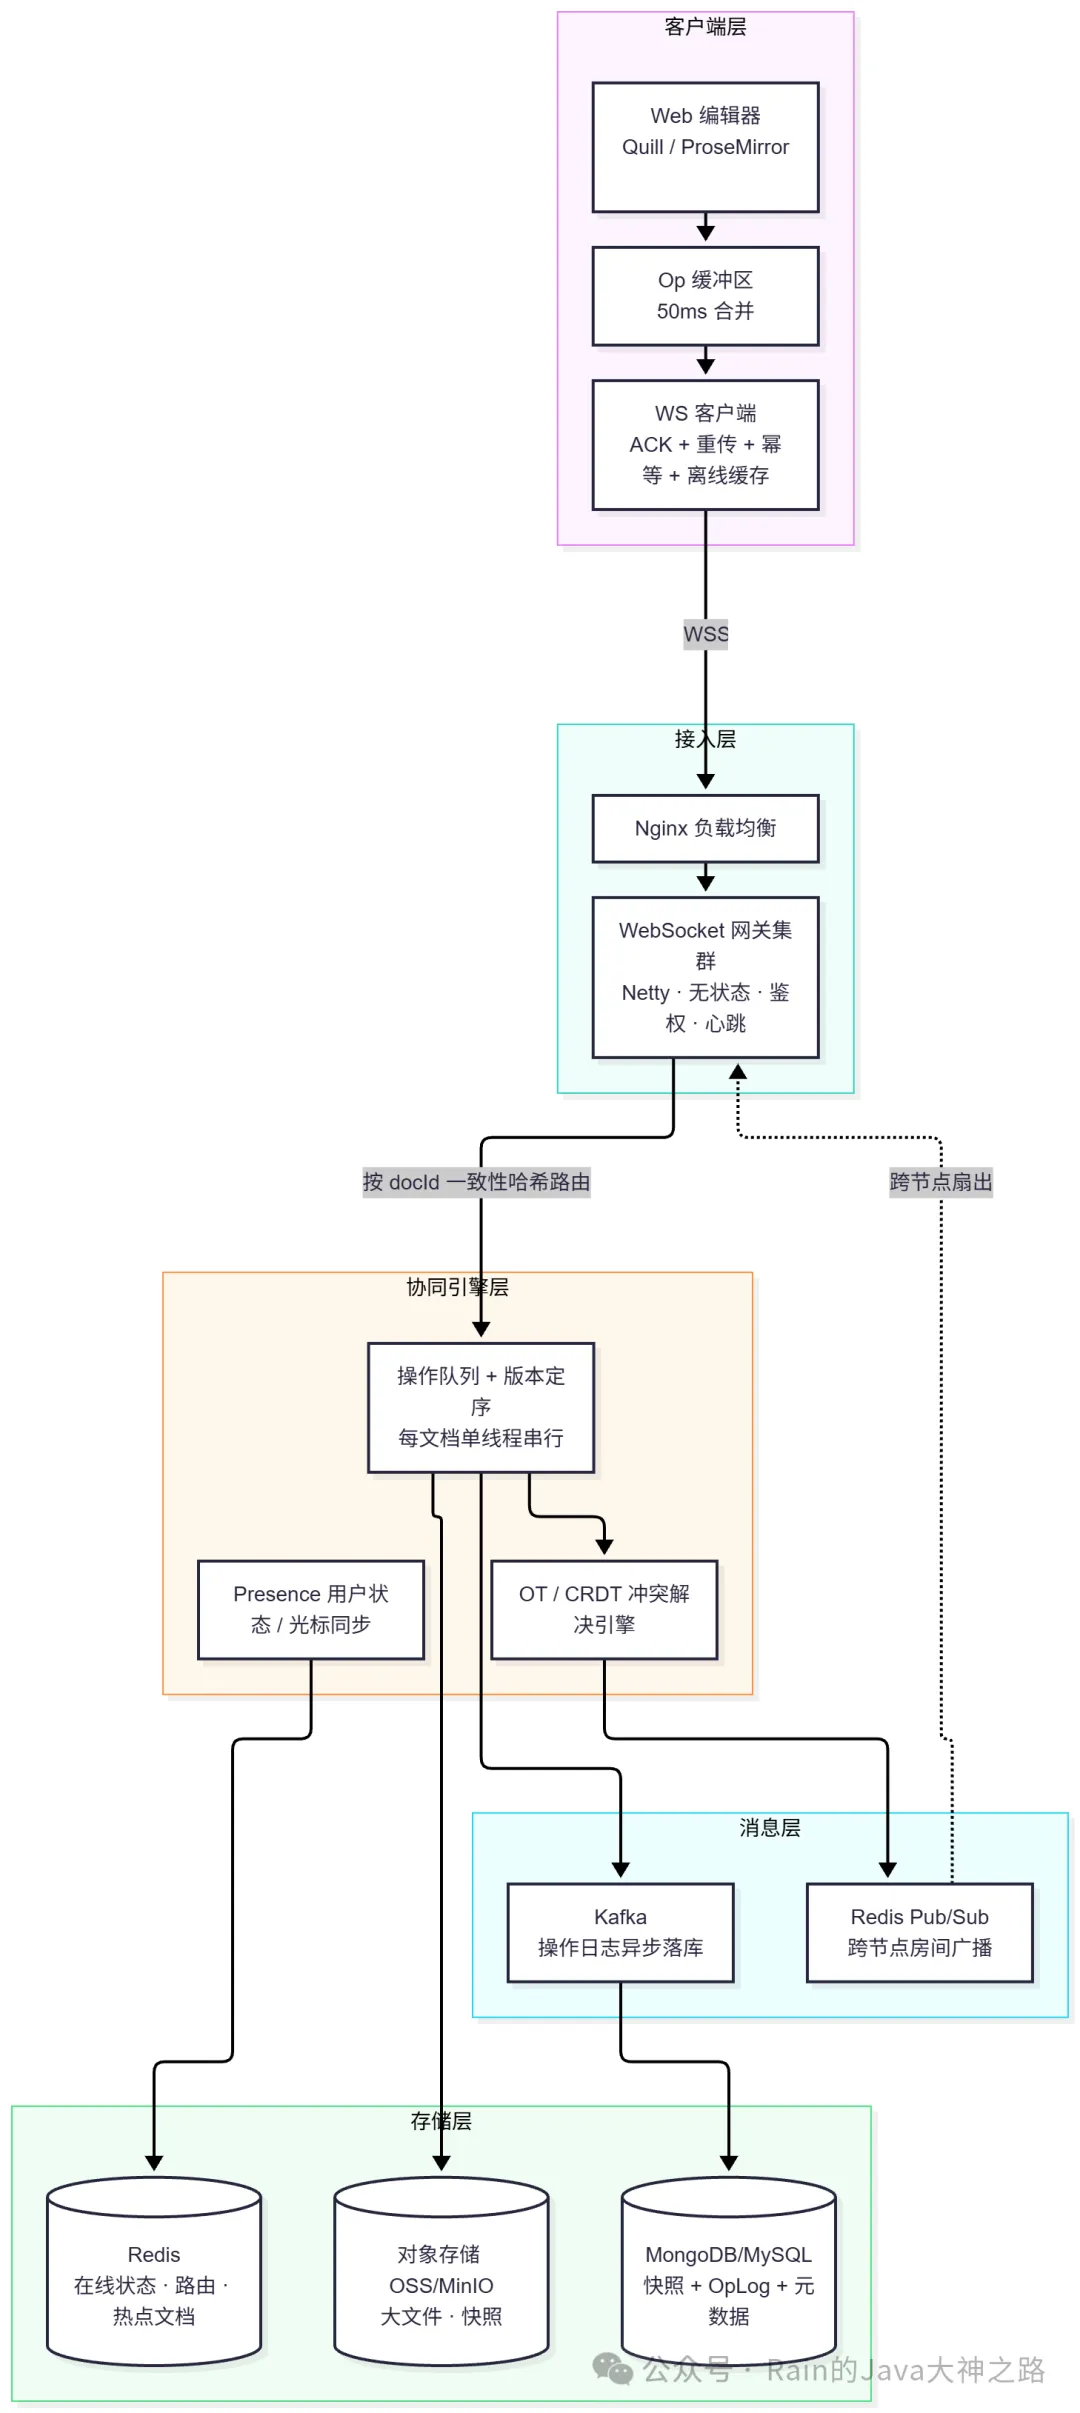
各层职责一句话说清:
docId 路由 | 无状态 | |
| 有状态 | ||
🌟 这段是面试官最爱听的设计权衡,一定要主动说:
接入层无状态、协同层有状态——同一 docId的所有操作通过一致性哈希路由到同一个节点的同一条线程串行处理,从根上消除并发乱序。这相当于用空间换正确性,把分布式一致性问题降级成单机内存问题。实时链路和落库链路分离——广播走 WebSocket 即时推,持久化走 MQ 异步落库,写库抖动不影响编辑体验。 有状态下沉、无状态上浮——扩展性靠无状态的网关扛,一致性靠有状态的协同服务守。
三、一次编辑的完整链路:三个必须讲清的时序细节
架构图是静态的,面试官接着一定会问:"一个字符从 A 的键盘到 B 的屏幕,完整走一遍?"
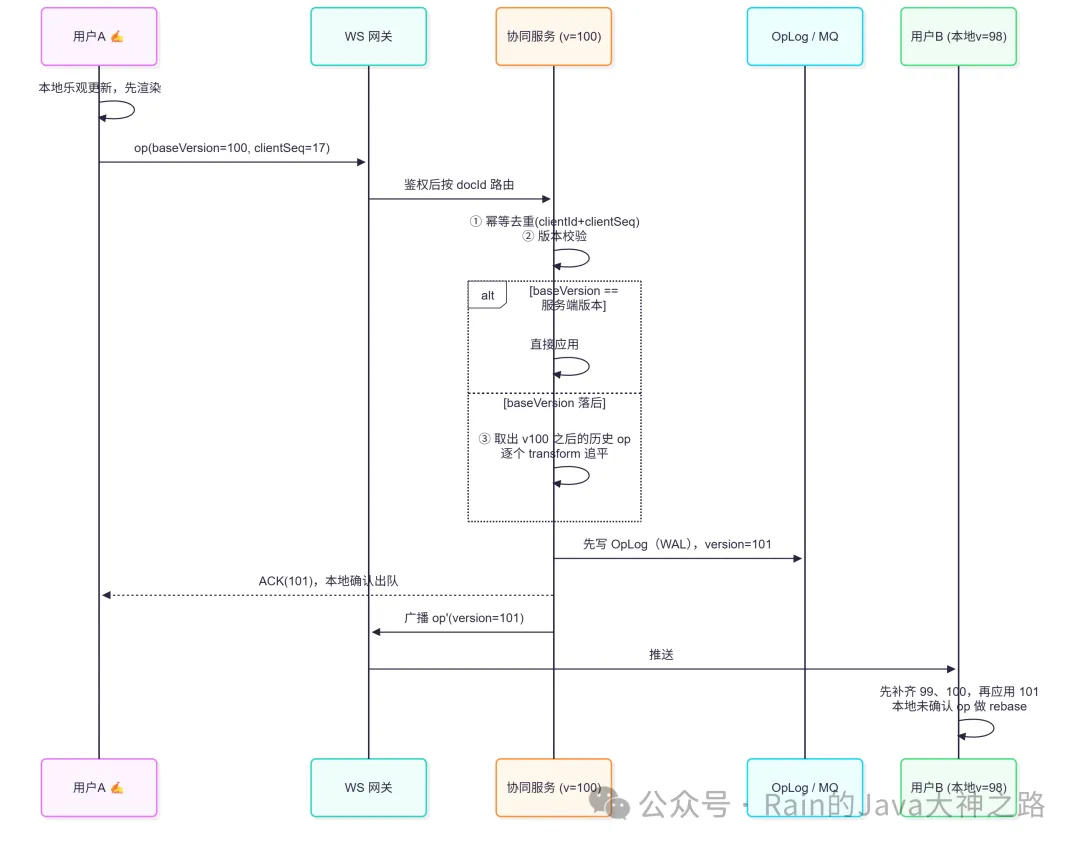
这里有三个细节,讲不出来基本就露馅了:
客户端乐观应用:本地先渲染再等 ACK,不然打字的感知延迟直接爆炸。 服务端权威定序:版本号由服务端统一"发牌",客户端严禁自增版本——这是收敛的大前提。 落后补偿靠主动拉,不靠傻等广播:客户端发现自己版本落后,走 pullOpLog(fromVersion)增量补齐;落太多(比如超过 500 条或直接超阈值)就别逐条变换了,直接拉全量快照重置。
消息协议设计
协议字段不用花哨,但这几个一个都不能少:
/**
 * WebSocket 消息协议定义
 */
@Data
@Builder
publicclassWebSocketMessage{
/** 消息类型:JOIN/LEAVE/OPERATION/BROADCAST/SYNC/PING/PONG/ERROR */
private MessageType type;
/** 文档ID */
private String documentId;
/** 客户端ID(配合 clientSeq 做幂等去重) */
private String clientId;
/** 操作内容(CRDT/OT 操作) */
private CRDTOperation operation;
/** 客户端基于的版本号 / 服务端最新版本号 */
privateint clientVersion;
privateint serverVersion;
/** 时间戳、压缩标记、二进制负载(大文件场景) */
privatelong timestamp;
privateboolean compressed;
privatebyte[] payload;
}

publicenum MessageType {
    JOIN, LEAVE, OPERATION, BROADCAST,
    SYNC_REQUEST, SYNC_RESPONSE,
    PING, PONG, ERROR
}
一条真实的编辑操作消息长这样:
{
"type": "insert",
"opId": "u789-1712345678901-3",
"docId": "doc-abc123",
"clientId": "u789",
"baseVersion": 42,
"serverSeq": 12345,
"position": 12,
"content": "x",
"timestamp": 1712345678901
}
连接层的五个硬设计
很多人以为 WebSocket 连上就完事了,其实协议本身不保证跨连接消息有序、不保证不丢、没有重传——可靠性全要在应用层自己补:
connectionId + clientId + docId,不用 IP 做路由 | |
serverSeq,客户端检测跳号就请求重传 | |
lastServerSeq,服务端只推之后的增量操作 | |
opId = clientId + timestamp + seq,重复直接丢弃 |
心跳保活的参考实现:
/**
 * WebSocket心跳保活组件
 * 每30秒发送ping,60秒无响应则断开连接
 */
@Component
publicclassHeartbeatHandlerextendsTextWebSocketHandler{

privatestaticfinalint HEARTBEAT_INTERVAL = 30000; // 30秒
privatestaticfinalint TIMEOUT = 60000;            // 60秒

@Override
publicvoidafterConnectionEstablished(WebSocketSession session){
        ScheduledFuture<?> future = scheduler.scheduleAtFixedRate(
            () -> {
if (session.isOpen()) {
try {
                        session.sendMessage(new TextMessage("{\"type\":\"ping\"}"));
                    } catch (IOException e) {
                        session.close(CloseStatus.SERVER_ERROR);
                    }
                }
            },
            HEARTBEAT_INTERVAL, HEARTBEAT_INTERVAL, TimeUnit.MILLISECONDS
        );
        session.getAttributes().put("heartbeat", future);
    }

@Override
protectedvoidhandleTextMessage(WebSocketSession session, TextMessage message){
        JsonObject json = JsonParser.parseString(message.getPayload()).getAsJsonObject();
if ("pong".equals(json.get("type").getAsString())) {
// 客户端响应pong,重置超时计时
            session.getAttributes().put("lastPong", System.currentTimeMillis());
        }
    }
}
顺带一个省流量的杀手锏:操作合并。用户敲出 hello,不是发 5 条 op,而是本地攒 50ms 合并成一条 INSERT(pos=10, text="hello") 再发。就这一招,打字场景的 QPS 能从 10 降到 2,带宽占用降 60% 以上。服务端收到批量操作后也一次性 transform + 广播。
四、本题灵魂:并发冲突怎么解?OT vs CRDT 讲透
铺垫完了,进正题。这是整道题的题眼,也是普通候选人和 Senior 的分水岭。
4.1 先看冲突到底长什么样
文档初始是 "abc",A 和 B 基于同一版本并发编辑:
初始: "abc"                    v=0
A: Insert(1,"X")  → 期望 "aXbc"   ┐ 并发提交
B: Delete(2,1)    → 期望 "ac"     ┘

❌ 不做转换直接乱序执行:
   A先执行得 "aXbc",B再删位置2 → 删掉了 'X' 后面的 'b' → "aXc"
   B先执行得 "ac",  A再插位置1 → "aXc"
   等等,这次碰巧一样?换个例子就分裂了——
   A 在 pos=5 插入 " Alice"、B 同时在 pos=5 插入 " Bob",
   直接合并必丢一个人的数据。

✅ OT 变换后:
   transform(B, A): B 的 pos=2 > A 的 pos=1 → 位置 +1 → Delete(3,1)
   transform(A, B): A 的 pos=1 < B 的删除区间 → 位置不变
   无论谁先谁后,两端最终都收敛到 "aXb" / "Hello Alice Bob World"
核心矛盾:两个操作基于同一个旧版本产生,直接按到达顺序执行,位置坐标系已经漂移了,结果必然分裂。OT 和 CRDT 是解决这个问题的两个流派。
4.2 两大流派深度对比
4.3 到底选哪个?两种话术都给你
素材圈里对这个问题有两派观点,其实不矛盾,看场景:
🗣️ 话术一(中心化产品场景):"我选 OT + 服务端中心定序。我们的场景网络稳定、文档是线性文本,OT 的 op 体积小、存储成本低、历史可回放做审计,权限和持久化也好做;CRDT 的离线优势我用『本地队列 + 重连重放』也能覆盖。当年 Google Wave 在 OT 上踩过无数坑,但 Google Docs、腾讯文档都证明了这条路在在线文档场景是稳的。"
🗣️ 话术二(离线优先 / 中小团队场景):"我优先选 CRDT。OT 的变换函数写对太难了,CP2 性质验证能把人逼疯;CRDT 有 Yjs、Automerge 这种成熟开源实现,天然支持离线,落地速度快得多。Java 生态可以用
y-crdt的绑定,或者基于 RGA 自己实现轻量版。代价是元数据膨胀和墓碑 GC 的复杂度。"
🎯 真正加分的说法是讲出迁移条件:"在线文档主链路用 OT 中心定序;如果未来要做完全离线的桌面端、白板/图形这类结构化数据,或者去中心化 P2P,就切 Yjs 这类 CRDT——取舍点在于是否需要端侧完全自治。"
4.4 OT 变换函数:面试必写的灵魂代码
真实系统用 [retain, insert, delete] 三段式操作序列,这里用原子的 Insert / Delete 把变换逻辑讲透。这是把"插入落进删除区间"这种魔鬼细节都处理了的完整版:
/**
 * 原子操作:插入 / 删除。真实系统会用 [retain, insert, delete] 三段式序列,
 * 这里用最简模型把变换逻辑讲透。
 */
public sealed interfaceOppermitsInsert, Delete{
intpos();
}
public record Insert(int pos, String text, String siteId) implements Op {}
public record Delete(int pos, int len, String siteId) implements Op {}

publicfinalclassOT{

/**
     * 将 local 变换到 "remote 已生效之后" 的坐标系。
     * 核心目标:apply(apply(doc, remote), local') == apply(apply(doc, local), remote')
     *
     * @param localIsLower 同位置插入时的 tie-break(用 siteId 字典序保证各端一致)
     */
publicstatic Op transform(Op local, Op remote, boolean localIsLower){
if (remote instanceof Insert ri) {
int rlen = ri.text().length();
if (local instanceof Insert li) {
// 同位置插入:谁的 siteId 小谁在左边,保证所有客户端结果一致 🎯
boolean shift = ri.pos() < li.pos() || (ri.pos() == li.pos() && localIsLower);
return shift ? new Insert(li.pos() + rlen, li.text(), li.siteId()) : li;
            }
            Delete ld = (Delete) local;
if (ri.pos() <= ld.pos()) {
returnnew Delete(ld.pos() + rlen, ld.len(), ld.siteId());   // 插入点在删除区前 → 整体右移
            }
if (ri.pos() >= ld.pos() + ld.len()) {
return ld;                                                    // 插入点在删除区后 → 不受影响
            }
// ⚡ 插入点落在删除区间内部:一个 Delete 必须裂变成两个 Delete
returnnew SplitDelete(ld.pos(), ri.pos() - ld.pos(),
                                   ld.len() - (ri.pos() - ld.pos()), ld.siteId());
        }

        Delete rd = (Delete) remote;
int rEnd = rd.pos() + rd.len();
if (local instanceof Insert li) {
if (rEnd <= li.pos())      returnnew Insert(li.pos() - rd.len(), li.text(), li.siteId());
if (rd.pos() >= li.pos())  return li;
returnnew Insert(rd.pos(), li.text(), li.siteId());   // 插入点被删掉了 → 贴到删除起点
        }
        Delete ld = (Delete) local;
int lEnd = ld.pos() + ld.len();
if (rd.pos() >= lEnd) return ld;                            // 完全在右,不受影响
if (rEnd <= ld.pos()) returnnew Delete(ld.pos() - rd.len(), ld.len(), ld.siteId()); // 完全在左,前移
// ⚡ 删除区间重叠:扣掉已被对方删掉的部分;len 扣没了就退化成 noop
int overlap = Math.min(rEnd, lEnd) - Math.max(rd.pos(), ld.pos());
returnnew Delete(Math.min(ld.pos(), rd.pos()), ld.len() - overlap, ld.siteId());
    }
}
🌟 亮点解读(面试时一定要亲口说出来):
同位置插入的 tie-break 是收敛的命门。两个人在同一位置同时打字,必须用全局一致的比较器( siteId字典序)决定谁前谁后,否则 A 端得到XY、B 端得到YX,直接不收敛。两个最容易漏的坑:① 插入落在删除区间内部,一个 Delete 要裂变成两个;② 删除区间重叠时要做减法,扣没了退化成 noop(两个用户删了同一个字符的场景)。 transform必须满足 TP1 性质(变换后可交换):T(T(e, a), b') = T(T(e, b), a')。真实工程里一个 Op 要对一批并发 Op 依次 transform,这个级联过程就是 rebase——Git 用户秒懂。
怎么验证 OT 实现是对的? 两条硬手段:
属性式 fuzz 测试:随机生成 op 序列 + 随机并发交错,断言所有端最终文本一致,守住 transform(a,b) ≡ transform(b,a)的收敛性;TP2 变换属性验证: transform(transform(a,b), transform(c,b)) == transform(transform(a,c), transform(b,c))。
这两条过了,基本不会出诡异 bug。另外生产级还要处理:富文本格式属性、Emoji/中文/Unicode 代理对(位置必须按 code point / grapheme 算,不能按 Java 的 char)、光标位置同步。控制复杂度的一个办法是只支持原子 Insert/Delete,复杂操作全部拆解成原子序列。
4.5 CRDT 的三块核心拼图
如果走 CRDT 路线,要讲的是这三样东西:全序唯一标识、墓碑删除、确定性合并规则。
拼图一:LSEQ 字符模型——每个字符带全局唯一 ID 和全序位置串:
/**
 * CRDT LSEQ 字符核心实现
 * 技术亮点:全序唯一标识、无冲突合并、支持乱序执行
 */
publicclassCrdtCharacter{
privatefinal String id;         // 全局唯一ID = 站点ID + 自增序号
privatefinalchar value;        // 字符内容
privatefinal String position;   // 全序位置字符串(LSEQ算法生成)
privatefinalboolean tombstone; // 墓碑标记:删除不物理删除,保证合并一致

/**
     * 核心合并规则:按 position 字典序排序,同位置按 ID 排序。
     * 任意节点执行结果完全一致,天然无冲突。
     */
publicstaticintcompare(CrdtCharacter a, CrdtCharacter b){
int posCompare = a.position.compareTo(b.position);
return posCompare != 0 ? posCompare : a.id.compareTo(b.id);
    }

/**
     * 在两个字符之间生成新的唯一位置。
     * 生产环境使用 LSEQ/Logoot 优化,避免位置串无限变长。
     */
publicstatic String generatePosition(String prev, String next, String siteId){
return prev + siteId.hashCode() % 10;
    }
}
拼图二:RGA(Replicated Growable Array)插入逻辑——不按数字位置定位,按邻居 ID 定位:
/**
 * CRDT-RGA 核心实现
 * 亮点:每个字符带全局唯一ID,无需中心服务器也能收敛
 */
publicclassRGANode{
privatefinal String id;      // 全局唯一ID: [lamportClock, clientId]
privatefinal String leftId;  // 左侧邻居ID
privatefinal String rightId; // 右侧邻居ID
privatechar value;
privateboolean isDeleted;    // 墓碑标记:不真删,只标记
privatelong timestamp;
}

publicclassRGAArray{
// 核心:插入时按邻居ID定位,而不是按数字位置
publicvoidinsert(String leftId, String newId, char value, long timestamp, String clientId){
        RGANode leftNode = findNode(leftId);
        RGANode rightNode = leftNode.getNext();

// 关键:同一位置并发插入时的排序规则
while (rightNode != null && isRightNodeShouldComeFirst(rightNode, timestamp, clientId)) {
            leftNode = rightNode;
            rightNode = rightNode.getNext();
        }

        RGANode newNode = new RGANode(newId, leftId, rightNode != null ? rightNode.getId() : null, value);
        insertBetween(leftNode, newNode, rightNode);
    }

/**
     * 并发插入排序规则:
     * 1. 先比时间戳,时间戳大的排前面
     * 2. 时间戳相同比 clientId,ID 大的排前面
     * 所有节点执行相同规则 → 最终顺序完全一致!
     */
privatebooleanisRightNodeShouldComeFirst(RGANode rightNode, long newTs, String newClientId){
if (rightNode.getTimestamp() != newTs) {
return rightNode.getTimestamp() > newTs;
        }
return rightNode.getClientId().compareTo(newClientId) > 0;
    }
}
拼图三:文档引擎的合并与 GC——向量时钟裁决版本新旧,墓碑节点定期回收:
/**
 * CRDT文档引擎 - 核心合并逻辑
 */
@Component
publicclassCRDTDocumentEngine{

/**
     * 应用操作到文档。删除只做软删除(墓碑),保证任意顺序合并结果一致。
     */
public DocumentState applyOperation(DocumentState doc, CRDTOperation op){
        List<CharacterNode> characters = doc.getCharacters();

switch (op.getType()) {
case INSERT:
                CharacterNode newNode = CharacterNode.builder()
                    .id(op.getId())              // 操作唯一ID: "客户端ID-逻辑时钟"
                    .content(op.getContent())
                    .timestamp(op.getTimestamp())
                    .clientId(op.getClientId())
                    .build();
// 找到插入位置(同位置冲突时按ID排序裁决)
int insertPos = findInsertPosition(characters, op.getPosition(), op.getId());
                characters.add(insertPos, newNode);
break;

case DELETE:
                CharacterNode target = findNodeById(characters, op.getContent());
if (target != null) {
                    target.setDeleted(true);     // 软删除,幂等:重复删除无副作用
                }
break;

case RETAIN:
break;
        }

        gcDeletedNodes(characters);              // 定期清理墓碑
return DocumentState.builder()
            .characters(characters)
            .version(doc.getVersion() + 1)
            .lastOperationId(op.getId())
            .build();
    }

/**
     * CRDT合并函数 - 关键!基于向量时钟决定版本优先级,
     * 无论操作到达顺序如何,合并结果相同。
     */
public DocumentState merge(DocumentState local, DocumentState remote){
if (isNewer(local.getVersionVector(), remote.getVersionVector())) {
return mergeWithPriority(local, remote);
        }
return mergeWithPriority(remote, local);
    }

/** 向量时钟比较:remote 存在更新的分量才算"更新" */
privatebooleanisNewer(Map<String, Long> localClock, Map<String, Long> remoteClock){
boolean hasNewer = false;
for (Map.Entry<String, Long> entry : remoteClock.entrySet()) {
            Long localTime = localClock.getOrDefault(entry.getKey(), 0L);
if (entry.getValue() > localTime) {
                hasNewer = true;
            } elseif (entry.getValue() < localTime) {
returnfalse; // 本地有更新的分量
            }
        }
return hasNewer;
    }

/**
     * 垃圾回收:清理已删除节点释放内存。
     * 生产环境用延迟删除策略,避免 GC 抖动。
     */
privatevoidgcDeletedNodes(List<CharacterNode> characters){
        Iterator<CharacterNode> it = characters.iterator();
while (it.hasNext()) {
            CharacterNode node = it.next();
if (node.isDeleted() && System.currentTimeMillis() - node.getTimestamp() > GC_THRESHOLD) {
                it.remove();
            }
        }
    }
}
⚠️ CRDT 的代价要想清楚:10 万字文档的元数据内存可能膨胀到 5~10MB(每个字符带
siteId + clock),所以墓碑 GC、字符串压缩存储是必修课,不是选修课。
五、服务端核心实现:定序、变换、广播、落库
算法讲完,落地到工程。这部分是"真做过"和"背过题"的分水岭。
5.1 串行定序:每个文档一条"单线程跑道"
真实系统不能对每个请求都 synchronized 全局锁。正确姿势是文档级 Actor:同一文档的操作进同一条单线程队列串行处理,不同文档天然并行。
/**
 * 文档级 Actor:每个 docId 绑定一条单线程 Executor
 * —— 这就是"串行定序"的全部秘密 🔑
 */
publicclassDocumentActor{

privatefinal String docId;
privatefinal Executor eventLoop;        // 按 docId 哈希分片到的单线程执行器
privatefinal OpRepository opRepository;
privatefinal Broadcaster broadcaster;
privatefinal Set<String> processedKeys = new HashSet<>();

privatelong version;

public CompletableFuture<Ack> submit(Op clientOp){
        CompletableFuture<Ack> future = new CompletableFuture<>();
        eventLoop.execute(() -> {
try {
                future.complete(commit(clientOp));
            } catch (Exception e) {
                future.completeExceptionally(e);
            }
        });
return future;
    }

private Ack commit(Op clientOp){
        String idempotentKey = clientOp.clientId() + ":" + clientOp.clientSeq();

// 1. 幂等:防止网络重试导致重复应用
if (processedKeys.contains(idempotentKey)) {
returnnew Ack(version, true);
        }

// 2. 客户端版本号不能"超前",超前说明缺了服务端操作
if (clientOp.baseVersion() > version) {
thrownew IllegalStateException("missing server ops");
        }

// 3. 客户端基于旧版本提交:取出 baseVersion 之后的服务端操作,依次 transform
//    这是 OT 最核心的一步!
        Op transformedOp = clientOp;
        List<Op> conflictOps =
                opRepository.findAfter(docId, clientOp.baseVersion(), version);
for (Op remoteOp : conflictOps) {
            transformedOp = OtTransformer.transform(transformedOp, remoteOp);
        }

// 4. noop 操作直接 ACK(比如两个用户删了同一个字符)
if (transformedOp.isNoop()) {
returnnew Ack(version, false);
        }

// 5. 生成新的服务端版本(版本由服务端发牌,客户端不得自增)
        version++;

// 6. 先持久化,再广播(WAL 思想),保证可恢复、可审计
        opRepository.append(docId, version, transformedOp);
        processedKeys.add(idempotentKey);

// 7. 广播给其他客户端
        broadcaster.publish(docId, new ServerOp(version, transformedOp));
returnnew Ack(version, false);
    }

public record Ack(long version, boolean duplicated){}
}
执行器分片就是一行哈希:
/** 每个 docId 绑定一条单线程 Executor —— 空间换正确性 */
private ExecutorService docExecutor(String docId){
return docExecutors[Math.abs(docId.hashCode() % docExecutors.length)];
}
生产级还会在外面包一层文档上下文的本地缓存(Caffeine,expireAfterAccess(1h),上限 10 万个文档会话),热文档的内存态不用每次重建;并在版本号到达整百时异步触发快照(这个下一节细讲)。
🌟 这段代码的五个加分点:文档级单线程避免复杂锁 →
clientId + clientSeq幂等 →baseVersion冲突检测 → 服务端统一发版本 → 先落日志再广播。面试官随便挑一个追问你都接得住。
5.2 网关与广播:Netty 零拷贝 + 房间模型
网关只干三件事:收操作、本地广播、跨节点转发。用 Netty 写的话,零拷贝广播是个可以主动秀的优化点:
/**
 * 协同文档核心消息处理器(Netty 实现)
 * 技术亮点:按文档路由、零拷贝广播、异步落盘
 */
@ChannelHandler.Sharable
@Component
publicclassDocCollabHandlerextendsSimpleChannelInboundHandler<TextWebSocketFrame> {

// 文档ID -> 连接组(生产环境配合 Redis Pub/Sub 实现跨节点广播)
privatefinal ConcurrentHashMap<String, Set<Channel>> docGroup = new ConcurrentHashMap<>();
privatefinal ObjectMapper mapper = new ObjectMapper();

@Override
protectedvoidchannelRead0(ChannelHandlerContext ctx, TextWebSocketFrame frame)throws Exception {
// 1. 解析客户端上报的操作
        CollabOperation op = mapper.readValue(frame.text(), CollabOperation.class);
        String docId = op.getDocId();

// 2. 协同引擎执行本地合并,生成最终一致的操作结果
        CrdtMergeResult result = CollabEngine.merge(docId, op);

// 3. 零拷贝广播给同文档所有其他客户端
        Set<Channel> channels = docGroup.get(docId);
if (channels != null && !channels.isEmpty()) {
            ByteBuf msg = Unpooled.wrappedBuffer(
                    mapper.writeValueAsBytes(result.getFinalOp())
            );
for (Channel ch : channels) {
if (ch != ctx.channel()) {
                    ch.writeAndFlush(new TextWebSocketFrame(msg.retain()));
                }
            }
            msg.release();
        }

// 4. 异步写入操作日志,定时生成快照
        OpLogService.asyncSave(result.getFinalOp());
    }
}
💡
msg.retain()/msg.release()这套引用计数玩法,让一条消息序列化一次、写给全房间的人,千人房间也不用序列化一千次。sendText 永远走异步,绝不在 IO 线程同步等待;单个连接发送失败要隔离,一个人网络卡不能拖垮整个房间。
5.3 跨节点广播:用户连在不同网关上怎么办?
30 万长连接必然分散在几十台网关节点上,session 是节点本地的,A 在网关 1、B 在网关 3,怎么互通?两条主流路线:
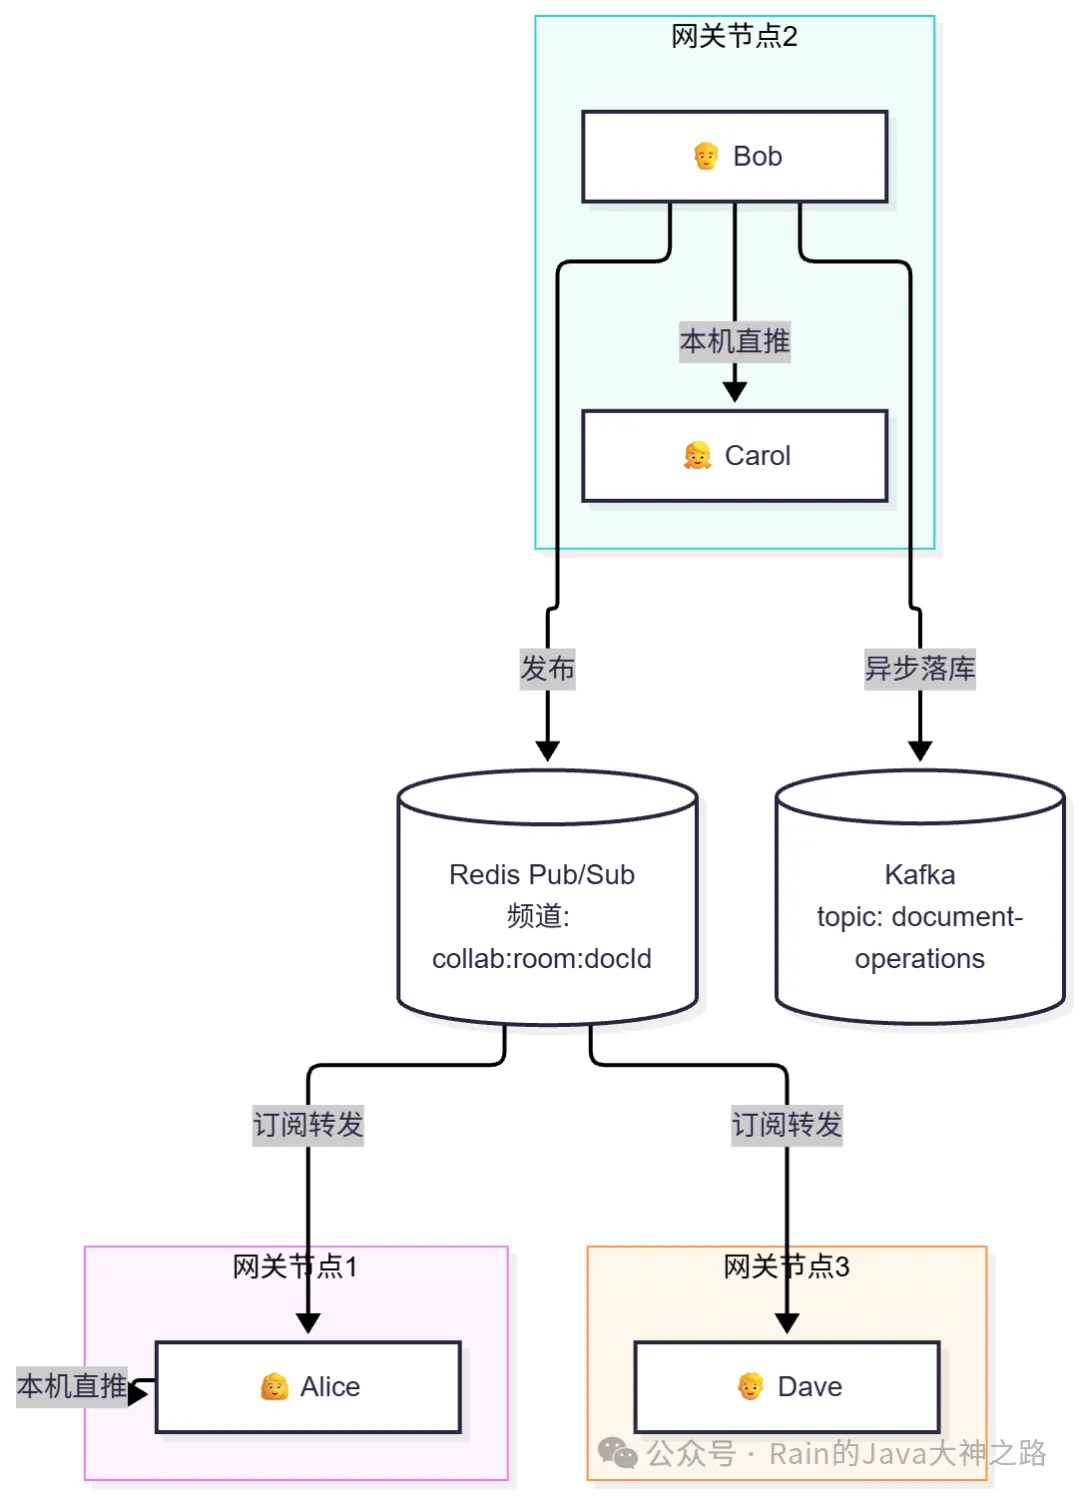
方案一:Redis Pub/Sub(低延迟首选)。每个网关节点只订阅"自己有人在编辑"的文档频道,避免全量广播风暴:
@Service
@RequiredArgsConstructor
publicclassCollabGateway{

/** docId -> (userId -> Session);网关本机只持有自己负责的房间 */
privatefinal ConcurrentHashMap<String, ConcurrentHashMap<String, WebSocketSession>> rooms = new ConcurrentHashMap<>();

privatefinal RedisTemplate<String, String> redis;
privatefinal StringRedisTemplate stringRedis;

/** ① 客户端上行一个操作 */
publicvoidonMessage(WebSocketSession session, EditOp op){
if (!permissionService.canEdit(op.getDocId(), op.getUserId())) {
            send(session, Result.fail("无编辑权限 🚫"));
return;
        }
// 分配全局单调递增序号(Redis INCR,天然原子,避免多副本乱序)
long seq = stringRedis.opsForValue().increment("doc:seq:" + op.getDocId());
        op.setSeq(seq);

// ★ 先写 OpLog(WAL 思想),再广播 —— 保证不丢消息
        opLogProducer.sendAsync(op);                 // Kafka 异步落库

// 本机房间直接广播(省一次网络跳)
        broadcastLocal(op.getDocId(), op);

// 跨节点广播:发布到以 docId 为 key 的 Redis 频道
        redis.convertAndSend("collab:room:" + op.getDocId(), JsonUtil.toJson(op));
    }

/** ② 订阅其他网关的广播,转发给本机该房间的所有人 */
@RedisListener(channel = "collab:room:*")
publicvoidonRemoteOp(String channel, String payload){
        String docId = channel.substring("collab:room:".length());
        EditOp op = JsonUtil.fromJson(payload, EditOp.class);
        broadcastLocal(docId, op);
    }

privatevoidbroadcastLocal(String docId, EditOp op){
        ConcurrentHashMap<String, WebSocketSession> members = rooms.get(docId);
if (members == null) return;
        String frame = JsonUtil.toJson(op);
        members.values().parallelStream().forEach(s -> {
try { if (s.isOpen()) s.sendMessage(new TextMessage(frame)); }
catch (IOException ignored) { }           // 单点异常隔离,不影响其他人 ✅
        });
    }

/** ③ 心跳 + 断线清理 */
@Scheduled(fixedRate = 30_000)
publicvoidheartbeat(){
        rooms.forEach((docId, members) -> members.values().removeIf(s -> !s.isOpen()));
    }
}
方案二:Kafka 分发(广播和落库共用一个管道,顺序性更好,延迟略高):
@Component
publicclassCrossNodeMessageBroker{

/** 广播操作:发到 Kafka,由各 WebSocket 节点消费分发 */
publicvoidbroadcastOperation(String documentId, CRDTOperation op){
        kafkaTemplate.send("document-operations", documentId, JsonUtils.toJson(op));
    }

/** 消费 Kafka 消息并转发到本节点的 WebSocket 客户端 */
@KafkaListener(topics = "document-operations")
publicvoidhandleOperation(String message){
        CRDTOperation op = JsonUtils.fromJson(message, CRDTOperation.class);
        Set<String> connectedClients = documentSessionManager.getConnectedClients(op.getDocumentId());

for (String clientId : connectedClients) {
            WebSocketSession session = sessionRegistry.getSession(clientId);
if (session != null && session.isOpen()) {
                session.sendMessage(new TextMessage(JsonUtils.toJson(
                    WebSocketMessage.builder()
                        .type(MessageType.BROADCAST)
                        .operation(op)
                        .build())));
            }
        }
    }
}
💡 工程上常见组合:Redis Pub/Sub 管实时广播,Kafka 管操作日志落库,各干各的强项。另外 Redis
INCR分 seq 轻量又原子;担心热点就按docId分片到不同 Redis 实例,或者让文档主节点本地生成 seq 再异步上报,牺牲一点严格性换吞吐。
5.4 客户端的"未确认队列 + 缓冲重放":乐观 UI 的三段式
服务端讲得再热闹,客户端接不住也白搭。OT 客户端的经典结构是 pending(已发未 ACK)和 buffer(本地已输入未发出)分离——Google 的 ot.js 就是这么干的:
publicclassOtClient{
privatefinal Deque<Op> pending = new ArrayDeque<>();  // 已发未 ACK
privatefinal Deque<Op> buffer  = new ArrayDeque<>();  // 本地已输入但未发出
privatelong version;

/** 本地输入:先进 buffer,50ms 合并成一个 batch 再发(省 90% 请求) */
publicvoidlocalEdit(Op op){
        buffer.add(op);
        renderLocally(op);          // 乐观渲染,输入不卡
    }

/** 收到服务端广播 */
publicvoidonRemote(OpEvent e){
        pending.removeIf(o -> o.clientSeq() == e.clientSeq());     // 自己的 op 被确认
// 🔑 关键:把远端 op 依次越过本地 pending,再把 pending 依次越过远端 op
for (Op remote : e.ops()) {
            Deque<Op> newPending = new ArrayDeque<>();
for (Op p : pending) {
                remote = OT.transform(remote, p, tieBreak(p));
                newPending.add(OT.transform(p, remote, !tieBreak(p)));
            }
            pending = newPending;
            applyToDocument(remote);
        }
        version = e.version();
        resendBuffer();   // 追平后立刻把 buffer 里的新输入发出去
    }

publicvoidonAck(long v){
        version = v;
        resendBuffer();
    }
}
六、存储与版本:快照 + OpLog,一对黄金搭档
绝对不能每次保存都写全量文档——一篇几十 KB 的文档,万人编辑直接把 DB 打爆。标准答案是经典的"快照 + 操作日志"(Git 同款思路):
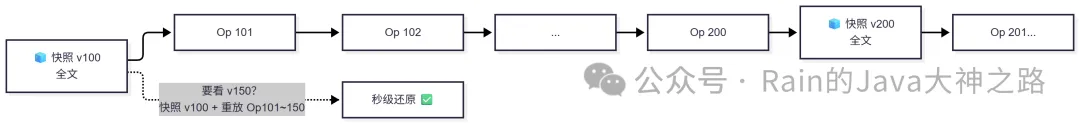
加载文档的固定套路:
1. 找最近一次 snapshot(走索引 O(logN))
2. 回放 snapshot 之后的 OpLog
3. 得到当前文档内容 + 当前 version

例:snapshot version = 1000,op log 1001~1080
   最终文档 = snapshot + replay(1001~1080)
存储模型简化版五张表:
doc_meta | |
doc_member | |
doc_op | |
doc_snapshot | |
doc_ack |
消费 Kafka 做聚合落库 + 定期快照的参考实现:
@Service
publicclassVersionService{

privatestaticfinalint SNAPSHOT_INTERVAL = 200;   // 每 200 个 op 存一次快照

/** 定时聚合落库(消费 Kafka) */
@KafkaListener(topics = "collab-oplog")
publicvoidpersist(EditOp op){
        opLogMapper.insert(op);                          // 追加写,顺序 IO,极快
if (op.getSeq() % SNAPSHOT_INTERVAL == 0) {
            DocState state = replay(op.getDocId(), op.getSeq());
            snapshotMapper.save(new Snapshot(op.getDocId(), op.getSeq(),
                                             JsonUtil.toJson(state), now()));
        }
    }

/** 加载任意版本:最近快照 + 增量重放 */
public DocState load(String docId, long targetSeq){
        Snapshot snap = snapshotMapper.findNearestLess(docId, targetSeq);  // 走索引 O(logN)
        DocState state = snap == null ? DocState.empty()
                                      : JsonUtil.fromJson(snap.getContent(), DocState.class);
for (EditOp op : opLogMapper.findRange(docId, snap.getSeq() + 1, targetSeq)) {
            state.apply(op);                            // 重放,类似 Git 的 replay
        }
return state;
    }
}
✅ 性能收益:追加写 + 定期快照,把"全量写"变成"顺序 IO";恢复任意版本的时间从 O(全量) 降到 O(快照 + 200 条增量),秒级回退,存储成本比全量留存降低约 70%。
防止 OpLog 无限膨胀:快照压缩
OpLog 只增不减迟早出事,需要一个后台 compaction:
@Scheduled(fixedDelay = 30_000)
publicvoidcompact(){
for (String docId : hotDocs()) {
        DocSession s = sessions.get(docId);
// 触发条件:累计 op > 1000 条 或 距离上次快照 > 5min
if (s.opsSinceSnapshot() < 1000 && s.sinceSnapshotMs() < 300_000) continue;
        Snapshot snap = Snapshot.of(s.version(), s.text());
        objectStore.put("snap/" + docId + "/" + s.version(), snap);
        opLog.truncateBefore(docId, s.version());   // 老 op 可删,但保留最近 100 条用于 undo/审计
        s.markSnapshot();
    }
}
冷热分离:热 op 留 Redis/MySQL,冷的历史 op 下沉对象存储。
增量同步:落后太多别硬追
客户端带版本号来同步时,服务端要会做"降级决策":
/**
 * 增量同步服务:只传变化的操作,避免全量同步
 */
public List<CRDTOperation> getIncrementalOperations(
        String documentId, String clientId, int clientVersion){

int serverVersion = getServerVersion(documentId);

// 客户端落后太多(如断网半天),逐条回放不划算 → 直接发全量快照
if (serverVersion - clientVersion > MAX_DELTA_SIZE) {
        DocumentState fullState = documentService.getDocument(documentId);
return List.of(CRDTOperation.builder()
            .type(OperationType.FULL_SYNC)
            .content(JsonUtils.toJson(fullState))
            .build());
    }

// 正常情况:只返回增量操作
return operationRepository
        .findByDocumentIdAndVersionAfter(documentId, clientVersion);
}
💡 同理,OT 场景里"transform 链过长"也是这个解法:限制最多逐个 transform 500 条,超过直接发全量快照。能补就补,补不了就重置——这是分布式系统里很实用的兜底哲学。
七、断线重连与离线编辑:不丢、不重、能合并
这块是很多候选人会漏、但面试官必追问的部分。
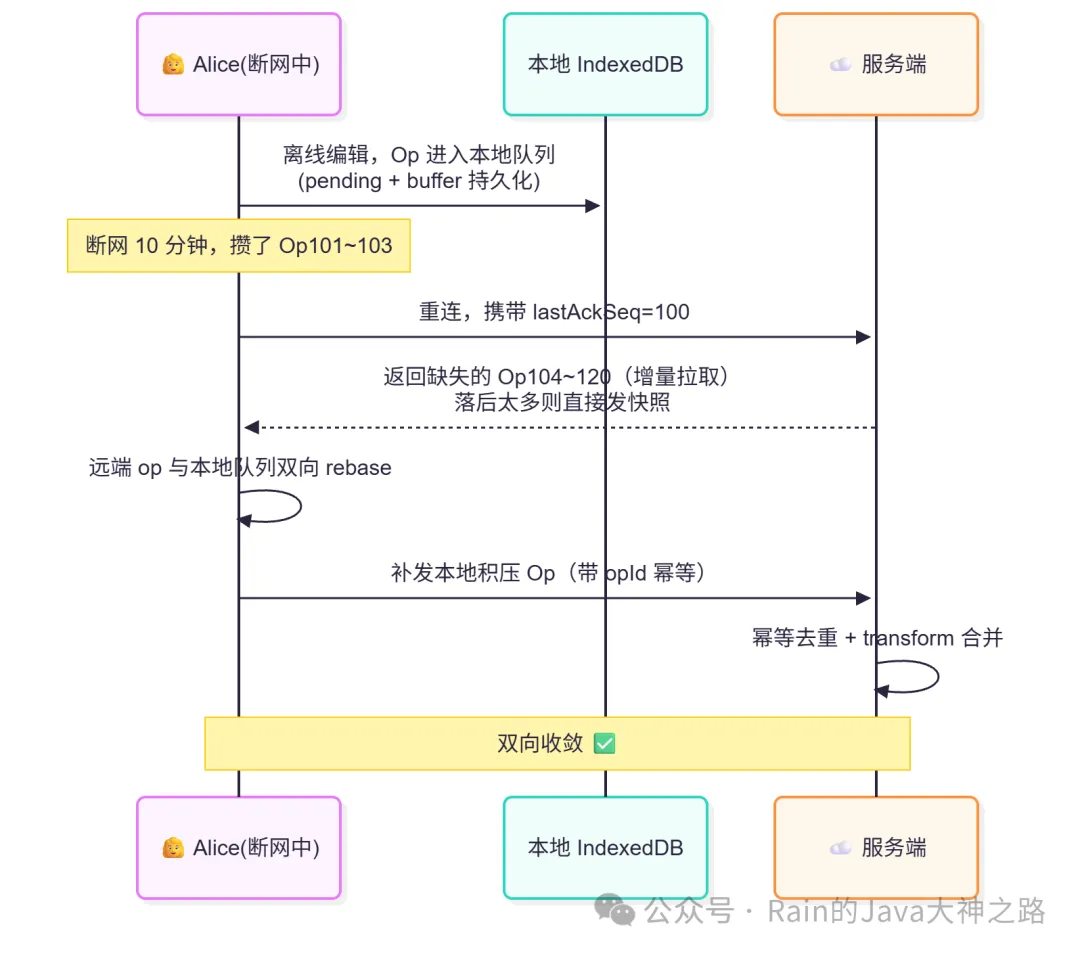
关键设计四条:
本地未确认队列:用户打字 → 本地立即应用 → 进 pendingOps→ 发服务端 → 收 ACK 移除 → 超时重发。队列持久化到 IndexedDB,刷新页面都不丢。幂等重发:每个操作带 clientId + clientSeq,服务端看到重复 key 直接返回成功不重复应用(Redis Set / 布隆过滤器判重)。重连增量拉取:客户端带 lastVersion,服务端返回"快照 + 该版本之后的增量 ops",不用全量刷新。离线合并策略:CRDT 天然支持离线合并;OT 方案下离线操作作为一个 patch 进来,先做三向合并,实在冲突的区域高亮提示用户手动裁决。服务端故障时客户端本地继续编辑,重连后自动合并所有离线操作——这是降级体验的底线。
离线操作队列的参考实现:
/**
 * 离线操作队列 - 本地优先写入(Local-First)
 * 核心思想:先写本地 IndexedDB,联网后批量同步到服务器
 */
@Service
publicclassOfflineOperationQueue{

privatefinal Queue<CRDTOperation> localQueue = new ConcurrentLinkedQueue<>();

/** 添加操作到本地队列并持久化 */
publicvoidenqueueOperation(CRDTOperation op){
        op.setStatus(OperationStatus.PENDING);
        localQueue.offer(op);
        saveToLocalDB(op);           // 持久化到 IndexedDB
    }

/** 每 5 秒尝试批量同步 */
@Scheduled(fixedDelay = 5000)
publicvoidsyncToServer(){
if (!networkService.isConnected()) {
return;
        }
        List<CRDTOperation> batch = new ArrayList<>();
        localQueue.drainTo(batch);

if (!batch.isEmpty()) {
try {
                documentService.batchApplyOperations(batch);
                batch.forEach(this::removeFromLocalDB);   // 成功后清本地
            } catch (Exception e) {
                batch.forEach(localQueue::offer);         // 失败重新入队
                log.error("同步失败,操作将重试", e);
            }
        }
    }
}
八、光标与在线状态:Presence 千万别走主链路
两个人同时编辑时,互相能看到对方的光标和选区,这功能看着简单,坑都在"量"上——mousemove 是每秒几十次的高频消息,处理不好会把真正的编辑消息挤掉。
Hash(docId → {userId: heartbeat}) + TTL 30s | ||
| 不落库 | ||
range |
三条军规:
光标不走 OT、不进版本号,走独立的 Awareness 通道, last-write-wins + TTL即可。光标消息和文本消息必须分频道,这是消息分级 QoS 问题——高频易失数据绝不能挤占编辑主链路带宽。 光标位置也要做位置变换:别人在你前面插了 5 个字符,你的光标要右移 5,不然两个人同位置打字光标会互相跳变。本地操作优先渲染,远程操作到来时单独调整光标偏移;并且只广播给"同一房间且可视区域内"的人,减少无效推送。
九、权限与安全:客户端说的话一个字都别信
协同系统默认客户端不可信,权限模型建议 RBAC 四级 + 位掩码:
用户 ──► 角色(Owner / Editor / Commenter / Viewer) ──► 文档
              │
              └── 权限位掩码: 0b1111 = 读 | 写 | 评论 | 分享
服务端的校验清单:
canEdit(docId, uid),防止绕过网关 | |
🎯 一句话记住:客户端只负责展示和提交意图,服务端才是最终权威。敏感操作(分享/删除)走独立的强一致接口(MySQL 事务)。
操作级权限用 AOP 统一拦截,干净利落:
/**
 * 文档权限管理器:查看/评论/编辑/管理 四级权限
 */
@Service
publicclassDocumentPermissionService{

publicbooleancanEdit(String documentId, String userId){
        DocumentPermission perm = permissionRepository
            .findByDocumentIdAndUserId(documentId, userId);
if (perm == null) {
returnfalse;                    // 默认无权限
        }
return perm.getRole() == Role.EDITOR ||
               perm.getRole() == Role.ADMIN;
    }

/** 操作级权限校验:在应用操作前拦截 */
@Aspect
@Component
publicclassPermissionAspect{

@Before("@annotation(RequireEdit)")
publicvoidcheckEditPermission(JoinPoint joinPoint){
            Object[] args = joinPoint.getArgs();
            String documentId = (String) args[0];
            String userId = (String) args[1];
            CRDTOperation op = (CRDTOperation) args[2];

// 评论操作放行给有评论权的用户
if (op.getType() == OperationType.COMMENT &&
                permissionService.canComment(documentId, userId)) {
return;
            }
if (!permissionService.canEdit(documentId, userId)) {
thrownew PermissionDeniedException("您没有该文档的编辑权限");
            }
        }
    }
}
防恶意刷消息也得说一嘴:网关层做连接级限流(令牌桶,比如 20 op/s)+ 消息体大小上限 + 单房间人数上限,超限直接降级为只读。
十、大文档与性能:别去操作大字符串
10 万字、百万字的文档, naive 实现必卡。优化是一套组合拳:
数据结构:用 Piece Table(VS Code 同款)或 Rope,插入 O(1),避免大字符串频繁 copy。 分块加载:文档按 Block(段落 / 4KB 一块)拆分,只同步变更块 + 可视区域的内容,滚动时动态懒加载。 虚拟滚动:10 万字只渲染视口内 100 行;服务端也可以只截取可视区域内容下发,带上总高度用于滚动条计算。 CRDT 专项:字符串压缩存储 + 墓碑 GC 定期清理无引用的已删除节点,压住 3~5 倍的元数据膨胀。 广播节流:50ms 操作合并、只推 diff 不推全文;只读围观群众走独立副本 + CDN/轮询降级,不进编辑热路径——把 99% 的读流量剥离出去。
上线前要对齐的指标(参考值):
十一、难点速查总表(背下来,面试直接复述)
| OT 变换 + 服务端全局版本定序 + siteId tie-break | |||
docId | |||
opId 幂等 + OpLog 兜底 + 断线拉增量 | |||
| Redis Pub/Sub 房间频道广播 | |||
| 快照 + OpLog | |||
char | |||
撤销那块多解释一句:撤销栈存的是逆操作(Insert ↔ Delete),出栈时要跟之后的所有 op 做 transform 再应用——撤销的是"意图"不是"文本",而且协同场景里撤销别人的操作是反直觉的,只能撤自己的。
十二、面试官高频追问(附简答)
Q1:为什么不用数据库行锁 / 分布式锁解决冲突?锁只适合短事务。用户编辑是长时间、不可预期的,持锁几十秒吞吐直接打崩;离线场景根本没法持锁。协同编辑的本质是"合并"而非"互斥",所以用操作转换 + 定序。
Q2:两个人在同一位置同时插入,怎么保证各端顺序一致?用 (version, siteId) 做确定性 tie-break:服务端定序在前的先应用,同版本内按 siteId 字典序。所有客户端用同一套规则,必然收敛。
Q3:服务挂了,正在编辑的内容会不会丢?op 先写 OpLog(Redis AOF / Kafka 持久化)再广播,内存态可以从"最近快照 + OpLog"重建。RPO 取决于刷盘策略——每条 op 异步刷 + 100ms 强制 fsync 的话,丢失窗口 < 100ms。先写 MQ 再 ACK,或者至少异步落 OpLog + 快照,这是底线。
Q4:为什么不干脆每次传全文?10 万字文档插一个字符,传全文是 200KB,传 op 只有几十字节,差 3~4 个数量级。而且传全文是 last-write-wins,多人同时打字会互相吞掉对方的内容。
Q5:怎么验证 OT 实现是对的?属性测试(随机 op 序列 + 随机并发交错,断言各端最终一致)+ TP2 变换属性验证。两条过了基本稳。
Q6:如果换成 CRDT,怎么改?换 Yjs 这类 RGA 实现:每个字符带 (siteId, clock) 唯一 ID,删除用墓碑。好处是真离线、P2P;代价是内存膨胀(10 万字约 5~10MB 元数据)和墓碑 GC 复杂度。服务端甚至可以不理解内容,只做中继转发。
Q7:断线重连怎么办?客户端带 lastVersion,服务端补发缺失 op,本地 rebase;落后超阈值直接拉快照。
Q8:怎么防恶意用户刷消息打爆服务?网关连接级限流(令牌桶 20 op/s)+ 消息体大小上限 + 单房间人数上限,超限降级只读。
十三、从 MVP 到上线:别一上来就追求完美协同
如果面试官问"资源有限你怎么落地",千万别把上面的全家桶直接甩出去,那说明你只会堆名词。分期来:
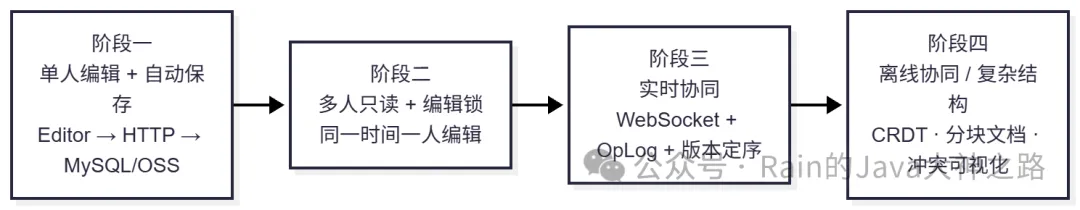
先保证内容不丢,再解决多人,再追求实时,最后啃离线。每一步都可独立上线、独立回滚,这才是工程思维。
上线前后的工程配套也别漏:
监控指标:操作提交 QPS、广播延迟 P99、ACK 超时率、冲突变换次数、单文档在线人数、OpLog 积压、快照回放耗时——全链路追踪,异常自动告警。 灰度策略:按文档维度灰度(普通文档 → 内部文档 → 高活跃团队文档 → 全量),不要按用户灰度,否则同一篇文档可能命中两套版本逻辑。 压测重点:单文档 100 人同时编辑、单网关 10 万长连接、高频输入下的合并能力、断线重连时的增量拉取。 进阶方向:全球多机房就近接入、本地优先(Local-First)消除感知延迟、冲突区域 AI 智能裁决、track changes 审阅模式。
写在最后
一口气看到这里,这题的骨架你应该已经立起来了。收个尾,就三句话:
冲突线:OT/CRDT 让并发编辑收敛 —— 这是题眼,transform 函数和 tie-break 规则要能默写; 通信线:无状态网关 + 房间路由 + Redis/Kafka 广播 —— 撑起几十万长连接; 存储线:OpLog + 快照 —— 撑起版本回溯、离线恢复和审计。
用一句话总结这个系统:用「中心定序」把分布式并发降级成单机串行,用「OT/CRDT」保证各端收敛,用「快照 + OpLog」托底不丢数据。剩下的幂等、重传、分块、鉴权,都是工程体力活。
最后给两个落地建议:一是别自己从头写算法,优先基于 Yjs、Automerge 这类成熟开源库做二次开发,把精力放在连接稳定性、权限、版本回溯这些业务体验上;二是永远做兜底——不管算法多牛,历史版本回溯必须有,用户数据丢了,说什么都没用。
如果觉得这篇干货够硬,点个「赞」和「在看」支持一下,关注我不迷路,下期拆解「设计一个分布式短链系统」。
留个互动话题:你所在的团队如果要做协同编辑,你会选 OT 还是 CRDT(Yjs)?说说你的理由——评论区聊聊,我会挑有代表性的回复详细展开。