ARTICLE · 1270707
几百页 PDF 喂给 AI 总消化不良?百度刚开源的无限 OCR,3600 页一次读完,5 步上手
几百页 PDF 喂给 AI 总消化不良?百度刚开源的无限 OCR,3600 页一次读完,5 步上手在单位管档案的朋友前两天跟我诉苦:一份三百多页的招标文件想让 AI 帮忙核对条款,结果文档太长,只能切成七八段分次喂,切完发现第 3 页的资格要求和第 217 页的评分办法对不上号,一张跨页的大表格被拦腰截成两半,AI 自己都说不清哪列对哪列。你有没有遇过这种事? 10 月 27 日,百度把这个问题正面拆了一次:发布并开源文心 Unlimited OCR 2。官方实测它能一次性解析完《哈利·波特》全系列 7 部、超过 3600 页;在专门考百页级超长文档的 MarathonDocBench 基准上拿到 77.1 分,而它公开榜单上的竞品,最高的一个也只有 33.7 分,其余全部不到 30 分——这不是领先,是断层。 (概念示意图:一座深色木质图书馆里,一摞几百页厚的精装书被一条发光的传送带缓缓吸进一台圆润的米色机器,机器另一头整齐吐出一叠排列有序的索引卡片,一条荧光橙的细丝带从书脊一路连到最上面那张卡片,旁边立着一盏复古绿色台灯;画面采用复古图书馆卡片目录风格,牛皮纸米黄、墨绿、深棕与荧光橙点缀,质感细腻,图为 AI 生成的概念演示,不是软件截图) 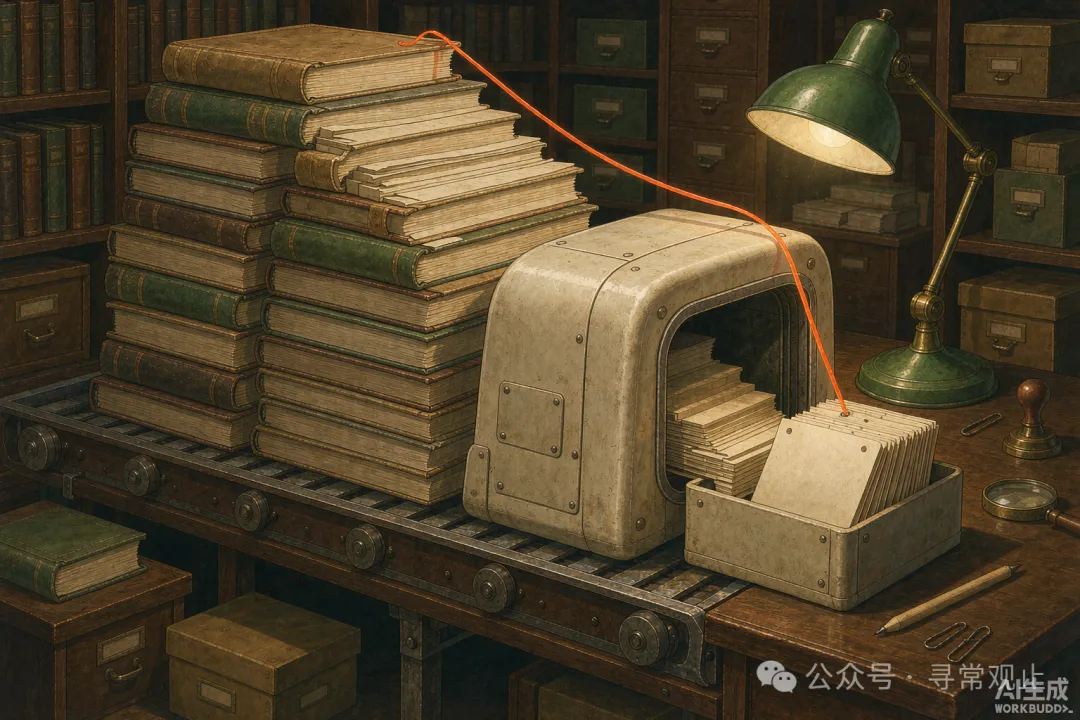
先说难在哪。一份几百页的 PDF 转成图像喂给模型,视觉数据量随页数暴涨,注意力计算还要平方级增长——上下文窗口装不下,就只能切块拼接,而跨页表格、被页码截断的段落,恰恰是在拼接这一步丢掉的。所以官方榜单的百页级那一档,一众通用旗舰集体塌方,这不是它们不努力,是路子本身走不通。 再看它怎么破。核心是一个叫 SR-SWA(稀疏参考滑动窗口注意力)的新架构,灵感来自人抄书的习惯:你抄书时专注当前页,只在需要核对前文时才回看几眼,不会每写一个字就把整本书翻一遍。模型分两步走——先用「页面门控」决定该翻到哪几页,再从中挑出得分最高的关键区域精读。整套计算被压缩到一个固定大小的工作参考集(512 个 token 量级),于是每一步解码的速度和显存占用,几乎不随文档变厚而变差。官方口径:百页场景下单步解码比传统全量方案快 7 倍。 
这一关的完成标准:你能用一句话给别人讲明白——它不是把窗口做大,而是把「每一步要看多少」固定住。 云上开箱即用的入口在百度智能云的「文档解析」服务,已经同步接入 Unlimited OCR 最新模型。按下面的路径走: 这一关的完成标准:你登录进了控制台,找到「文档解析」这一项,并且亲眼看到自己的免费额度。 在文档解析的在线体验页,点上传按钮,选一份你自己手头的几十页 PDF——服务支持 doc、pdf、图片、xlsx 等 20 多种格式。上传后提交解析任务,页数越多等待越久,几十页通常等一小会儿。 第一次上手建议选一份结构丰富的:有目录、有表格、最好有一张跨页的大表,这样才能看出它和普通 OCR 的差距。 这一关的完成标准:任务状态变成解析完成,页面上能看到输出结果。 普通 OCR 给你一大坨字。这里给的是结构化文件:标题分级、段落、表格、图片位置各归各位,输出是 Markdown 这类大模型友好的格式,每块内容还带页码和坐标,可以溯源到原文档的某一页某一块。 重点检查两处:一是跨页表格是不是被合并成了完整的一张(它端到端识别表格在下一页的延续关系,不靠事后拼接规则);二是被页码截断的段落是不是语义连贯、不丢字不重复。官方口径里,标题层级单项 90.1 分,而竞品最高只有 46.8——因为标题层级是全文档级的结构知识,拼页方案天生残缺。 
这一关的完成标准:你在输出里找到至少一张跨页表格,确认它是完整的一张,而不是上下两截。 解析不是终点,结构化的 Markdown 才是给 AI 用的上好原料。把结果整个复制,粘给任意一个 AI 对话框(豆包、Kimi、DeepSeek 都行),下面两个模板直接抄: 
这一关的完成标准:AI 的回答能准确引用到文档后半部分的内容和页码——那就说明结构没有在解析这一步丢失。 如果你不满足于云服务:代码和权重已全部开源,GitHub 仓库是 baidu/Unlimited-OCR,权重同步放在 Hugging Face(baidu/Unlimited-OCR-2)和 ModelScope(PaddlePaddle/Unlimited-OCR-2),MIT 协议,可商用。核心用法三行就能发起一次多页解析: 诚实提醒:官方测试环境是单张 A800-80GB 数据中心显卡;模型是 3B 级别(模型卡标注 3.3B),家用显卡能不能跑通官方没有给结论,自媒体说的「几张消费级显卡轻松跑」不要轻信,以你自己实测为准。普通读者建议就用云上的免费额度,没必要折腾。 
这一关的完成标准:你能说出三条路的区别——在线体验(零门槛)、云 API(要写点代码)、本地部署(要 GPU),并且选定了自己的那条。 坑一:把「文档解析」和「普通 OCR」混为一谈。 云上其实有几条模型通道(标准版、PaddleOCR-VL、Unlimited-OCR)。几十页的日常文档走标准版更快更省额度;几百页的超长文档,才轮到 Unlimited 这条能力线出手,选错通道白花额度。 坑二:拿模糊拍照件去测。 官方跑分是印刷体为主的基准,扫描质量差、手写混排这些极端格式的效果官方没有披露。先拿一页试水,可以再批量。 坑三:敏感文档直接传云。 合同、财报、人事材料先想清楚敏感度。介意的话,等私有化部署,或者只传脱敏版——上传到任何云服务前,这一步都值得多想三秒。 坑四:不看额度就开跑。 200 页用完按页计费,几百页的大部头跑一次就是几十页的量。批量任务前,先在控制台看一眼余额和价格页。
一句话总结:过去 AI 读长文档像把一本书撕碎了喂,现在多了一个 3B 级、MIT 开源、连基准一起送出来的专用模型,几百页的招标书、年报、卷宗可以一口气变成结构干净的文件。对做知识库、搞 RAG、天天和投标文件打交道的人来说,这可能是今年最实惠的开源礼物之一。 11 月 12 日百度世界大会还会进一步展示它的落地场景,可以持续留意。 留个问题给你:你手里最长的一份 PDF 是多少页?拿去试一次,回评论区报个页数和大概用时,我看看谁的「最厚的一本」能夺冠。
说明:本篇信息整理自新华网、南方+、百度千帆官方公众号以及 GitHub、Hugging Face 官方模型卡(2026 年 10 月 27 日发布),多来源交叉核对。先交代三条边界:①榜单分数是百度官方公布的口径,评测脚本虽已开源可复现,但竞品如何被调用对结果影响不小,第三方复现还需时间;②模型权重 MIT 协议免费开源、可商用,但在线体验的云服务只有注册赠送的 200 页免费额度,用完按页计费(促销价约 0.05 元一页,以控制台价格页为准);③「任意页数」说的是解析能力,你手里扫描件的质量、表格密度会直接影响实际效果,以你实测为准。
先弄清楚:百页文档到底难在哪,它又是怎么破的
第一步:注册百度智能云,把 200 页免费额度领到手
浏览器打开 cloud.baidu.com/product/OCR/doc_parser.html,点「立即使用」,用手机号或百度账号注册登录,个人身份即可,不需要企业认证。注册后进入控制台,在左侧找到「文字识别」下的「文档解析」,页面上能看到赠送的 200 页免费额度。在线体验入口也可以从产品页的「在线体验」按钮直接进。
第二步:在线体验页上传一份几十页的 PDF
第三步:看懂输出——这才是它和普通 OCR 拉开差距的地方
第四步:把解析结果喂给 AI 干活,这才是完整玩法
提示词一(长文档速读):下面是一份两百页文档解析后的结构化文本。请先用 10 条要点列出全文档的核心内容;再单独列出两份清单:1. 所有金额和数字所在的条款及页码;2. 所有要求某一方在某个期限前完成的事项。文档内容如下:〔粘贴你的 Markdown〕
提示词二(跨页表格核对):下面的文本里包含多张表格。请把所有表格整理成统一格式输出,并明确指出哪几张在原文档里是跨页的、你判断合并的依据是什么;如果发现表格里有对不上的数字,单独列出来提醒我。文本如下:〔粘贴你的 Markdown〕
第五步:进阶——模型本体免费拿走,想折腾的自己部署
pip install torch==2.13.0 torchvision pillow transformers==4.52.1 from transformers import AutoModel, AutoTokenizer tokenizer = AutoTokenizer.from_pretrained("baidu/Unlimited-OCR-2", trust_remote_code=True) model = AutoModel.from_pretrained("baidu/Unlimited-OCR-2", trust_remote_code=True, torch_dtype=torch.bfloat16).eval().cuda() text, num_tokens = model.infer_multi(tokenizer, image_files=按页序排好的图片列表, output_path="output/multi")
四个坑,替你踩过了
总结:页数自由之后,长文档才算真正进了 AI 时代
下一篇预告:盯最近 48 小时全网爆火的 AI 新东西,优先选「不花钱、当天就能上手」的;11 月 4 日前开放完整权重的 Kimi K3.1 Pro 是候选之一,写之前照例多来源核验。