ARTICLE · 1274448
AI视觉计算太重,能否把部分工作交给光?
智能光学
一句话核心
传统光学神经网络虽然能够利用光传播降低计算开销,但受限于参数规模和复杂运算的物理实现,难以同时支持多种视觉任务。针对这一问题,研究团队提出一种新的光电协同计算框架:不再让光学器件精确复现数字神经网络的运算,而是将相似性建模、类注意力机制及多尺度特征提取直接融入超表面光学设计,结合轻量级数字网络,实现目标检测、语义分割、三维重建和视频理解,并完成自然场景下的实时视觉处理验证。
1
背景
大规模视觉模型面临边缘部署瓶颈
近年来,视觉基础模型逐渐具备跨任务的通用处理能力,能够完成目标检测、语义分割、三维重建等复杂任务。
然而,这类模型通常包含千万至百亿级参数,计算和存储需求较高。对于自动驾驶、机器人和无人机等边缘设备而言,有限的算力和功耗预算难以支撑大型视觉模型持续运行。
如何在保持视觉处理能力的同时降低计算开销,成为边缘智能的重要研究方向。
光学计算为何难以实现通用视觉处理?
光学神经网络(Optical Neural Networks,ONNs)利用光传播的天然并行性,有望降低计算延迟和能耗。
但现有部分光学计算方案主要尝试在物理系统中精确复现数字神经网络的卷积、矩阵运算等操作。这对光学权重的实现精度、器件制造和系统对准提出了较高要求,也难以直接实现复杂的数字非线性运算。
此外,常规无源超表面制造后难以重新配置,如果针对不同任务分别设计光学权重,就可能需要重新制造器件,限制了系统的通用性。
因此,本文关注的问题是:能否不再精确复制数字网络的计算过程,而是利用光学物理本身实现通用视觉特征提取,让同一光学器件适应多种复杂任务?
2
贡献
将视觉计算原理映射到光学物理
研究提出一种不同于传统数字运算光学化的设计思路,将视觉模型中的相似性建模、注意力引导和局部—全局特征提取,与超表面调制及光衍射过程相结合。
这一方法不需要光学系统逐步复现特定数字模型的内部运算,而是直接利用物理传播形成具有通用性的视觉特征。
实现4100万参数的可扩展光学前端
研究构建了包含约4100万个纳米元原子的超表面,通过高斯统计分布的调制权重近似实现径向基函数核,形成256通道的光学特征提取能力。
这种设计不要求每个纳米结构都精确匹配独立指定的权重,有利于扩大器件规模,并提高对制造偏差的容忍能力。
构建支持多任务的轻量化光电系统
研究设计了与光学前端相匹配的数字网络,仅使用约8.7万个数字参数,即可支持目标检测、语义分割、三维重建和视频理解。
团队还制造了可部署的原型,在自然光照环境和嵌入式计算平台上进行实地测试,使研究从实验室光学计算扩展到实际视觉场景。
3
方法
整体架构:光学负责特征提取,电子负责信息理解
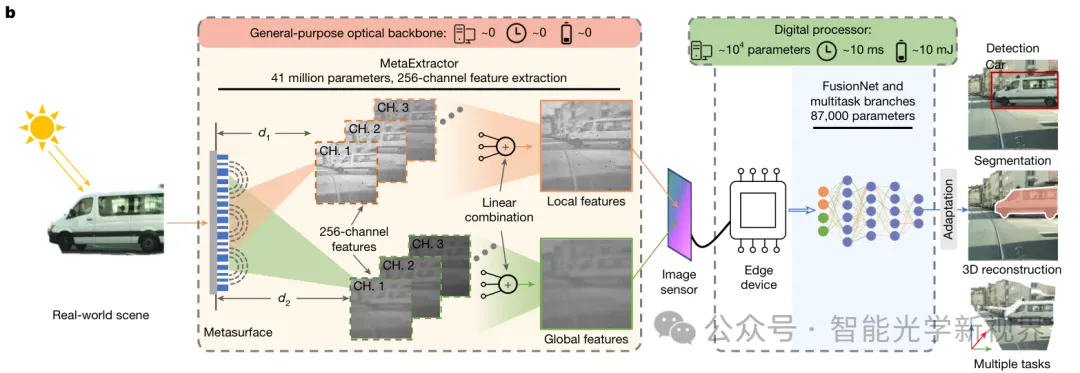
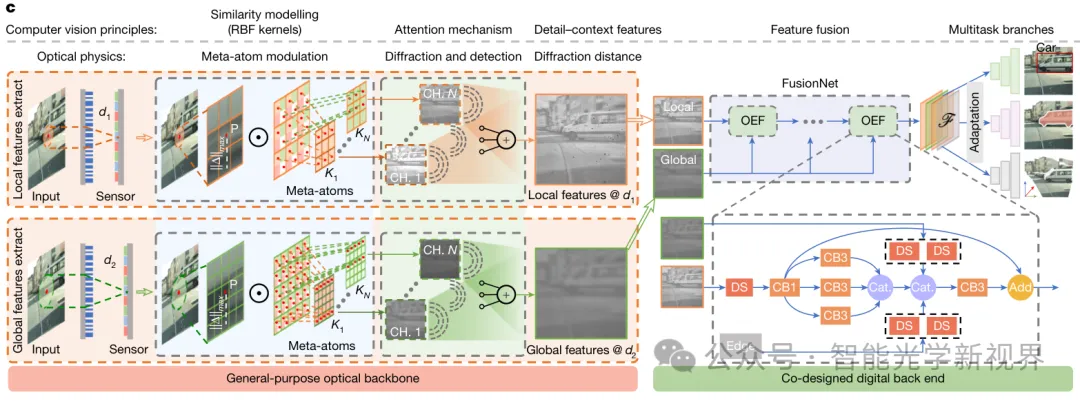
系统主要由超表面特征提取器(MetaExtractor)、图像传感器和数字后端组成。
输入场景的光场经过超表面调制,再通过自由空间衍射形成不同尺度的光学特征。图像传感器将光学信息转换为数字信号,交由轻量级网络FusionNet进行融合,最后通过不同任务分支输出检测框、分割掩膜和深度图等结果。
这一架构的核心是将大规模特征编码交给光学传播完成,而将灵活的非线性处理和任务预测保留在数字后端。
高斯RBF核:构建通用光学特征表示
相似性建模是视觉理解的重要基础。径向基函数(Radial Basis Function,RBF)核能够利用特征之间的距离描述相似程度,为不同视觉任务提供通用特征映射。
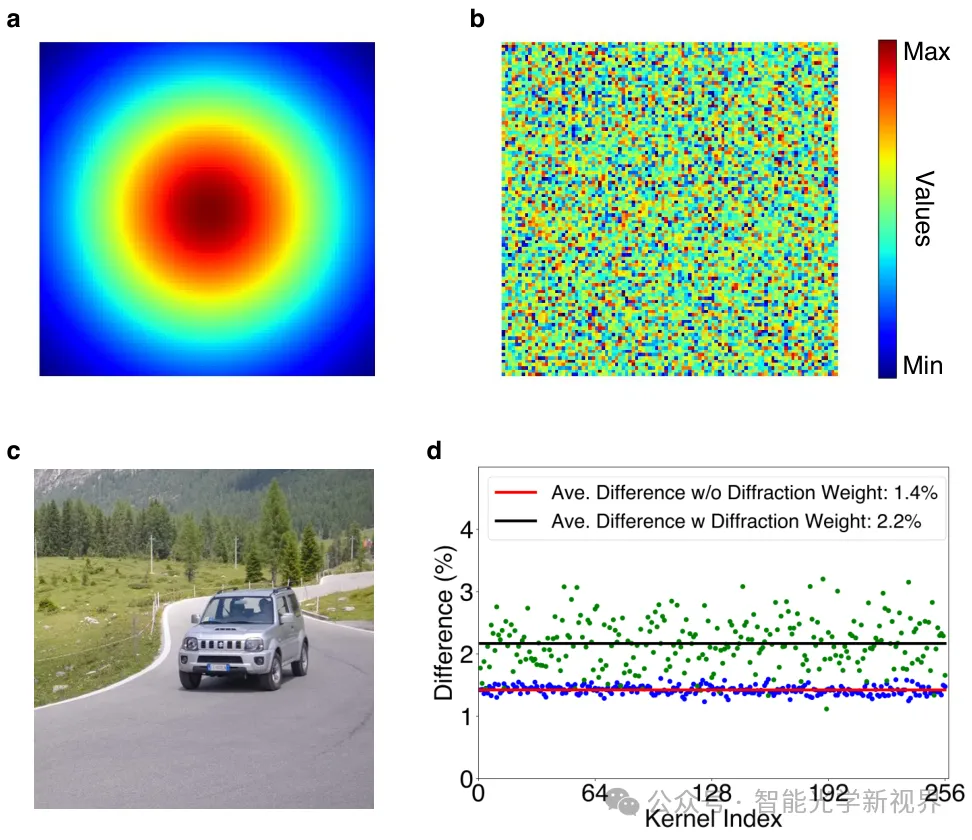
研究利用一个关键性质:当核函数包含足够多的参数时,从高斯分布中随机采样权重,可以有效近似RBF核。
因此,研究不再逐个精确设计所有光学权重,而是通过控制超表面纳米结构的尺寸,使整体调制系数符合高斯统计分布。
具体而言,超表面由6400×6400个硅纳米圆盘组成,每个圆盘的直径在100–400 nm之间变化,从而调节光场的振幅和相位。
当入射光经过超表面并发生衍射时,光学系统便可形成与图像相似性有关的特征表示。
这一设计的重要区别在于:RBF核的实现依赖大量权重的统计特性,而不是每个光学权重都必须精确匹配预设数值。
因此,同一超表面能够为多种任务提供通用特征,而不需要针对每个任务重新设计光学结构。
多通道光学编码:实现类注意力机制
在数字视觉模型中,注意力机制能够整合不同特征通道的信息,提高模型对重要视觉内容的表征能力。
研究利用超表面的亚波长结构实现类似的多通道特征处理。
每个输入图像位置对应16×16个元原子,它们提供256组不同的调制权重,形成256个特征核。经过光学传播和传感器检测后,这些通道的信息被线性组合,形成压缩后的特征输出。
这一过程与数字网络中的通道注意力具有功能上的相似性,能够整合多个特征核的信息,但并不等价于Transformer中的完整自注意力运算。
衍射距离控制:实现局部与全局特征提取
视觉任务既需要识别目标边缘、纹理等局部细节,也需要理解整个场景的空间关系。
研究利用自由空间衍射距离控制光学特征的有效感受野。
光在传播过程中,不同空间位置的信息会相互叠加。改变超表面与探测平面之间的距离,可以改变特征所覆盖的空间范围。
研究采用约1 mm的衍射距离提取局部特征,采用约6 mm的距离提取全局特征。前者侧重细节和局部结构,后者提供更大范围的场景信息。
通过这一方式,系统无需完全依赖数字网络中的多层卷积或注意力操作,即可在光学前端形成互补的多尺度特征。
FusionNet:将光学特征转化为具体任务结果
光学前端输出的特征仍需要进一步融合,才能完成复杂视觉任务。
研究设计的FusionNet采用级联式光电融合模块(Optical–Electronic Fusion,OEF),逐步处理局部、全局和边缘信息。
局部特征通过多尺度卷积提取细节,全局特征通过较简单的下采样保留整体结构,两类信息随后逐级融合,并送入不同任务分支。
对于视频输入,系统还会沿时间维度组合连续帧特征,使后端能够利用时序信息进行视频分割和内容理解。
需要注意,超表面制造完成后保持固定,后续主要训练数字后端,而不是针对每个任务重新优化4100万个光学参数。
4
实验
实验设置与评价条件
研究首先利用实验室光学平台,在Cityscapes和DAVIS数据集上评估多任务视觉性能。
其中,Cityscapes用于目标检测、语义分割和深度估计,DAVIS用于视频分割与视频理解。基准测试中的数字图像被调整为400×400后加载到光学实验系统,主要通过532 nm窄带光源和反射式超表面完成特征提取。
研究使用交并比(IoU,越高越好)、深度估计均方根误差(RMSE,越低越好)、分类准确率及计算资源消耗等指标,与多种轻量级和大型数字模型进行比较。
通用光学核的跨任务能力与制造鲁棒性
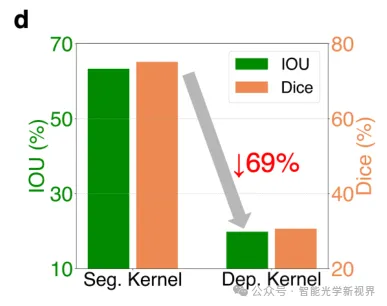
为了检验高斯RBF核是否真正具有通用性,研究在仿真中分别针对语义分割和深度估计优化专用光学核,再测试其跨任务迁移能力。
结果发现,针对深度估计优化的光学核迁移到语义分割后,性能下降达到69%。相比之下,高斯RBF核能够在不同视觉任务之间复用,无需重新配置光学结构。
研究还通过制造误差仿真和多批次芯片实验检验其稳定性。
仿真结果显示,不同误差条件下语义分割IoU的最大偏差仅为0.5%;四块不同批次制造的超表面芯片,在包含更换芯片和对准偏移等扰动的测试中,最大IoU偏差为1.4%。
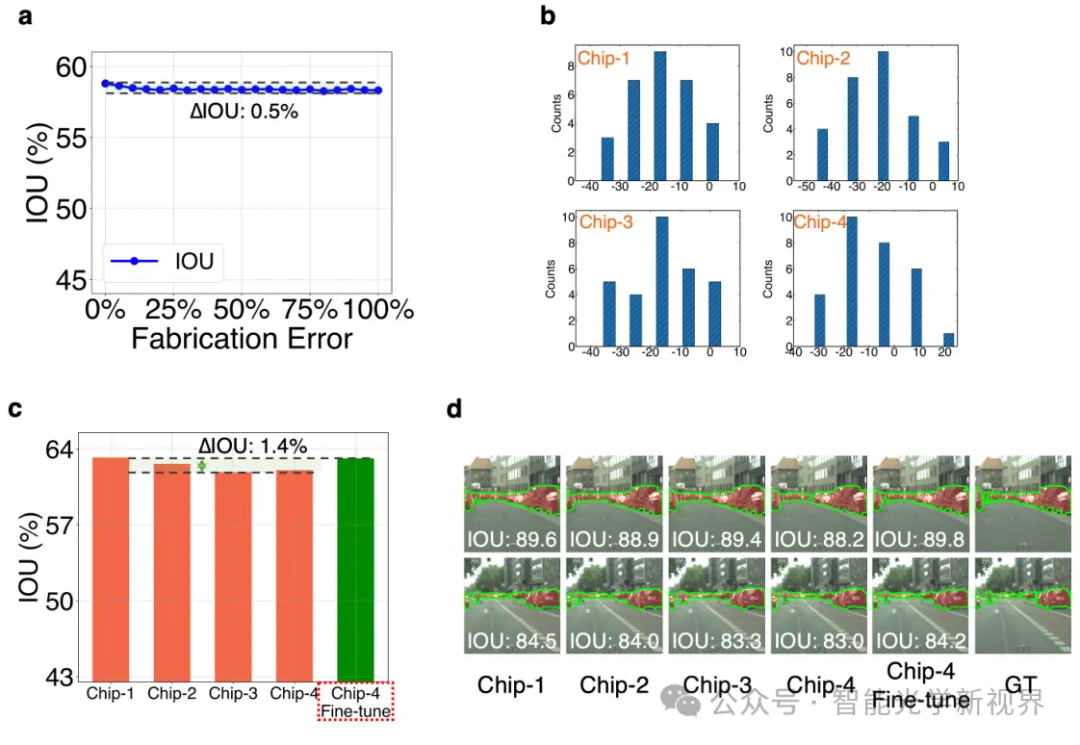
这些结果表明,依赖统计分布的光学编码能够在所测试的制造误差范围内保持较稳定的性能。相关详细验证图位于论文补充材料中。
静态视觉任务:检测、分割与三维重建
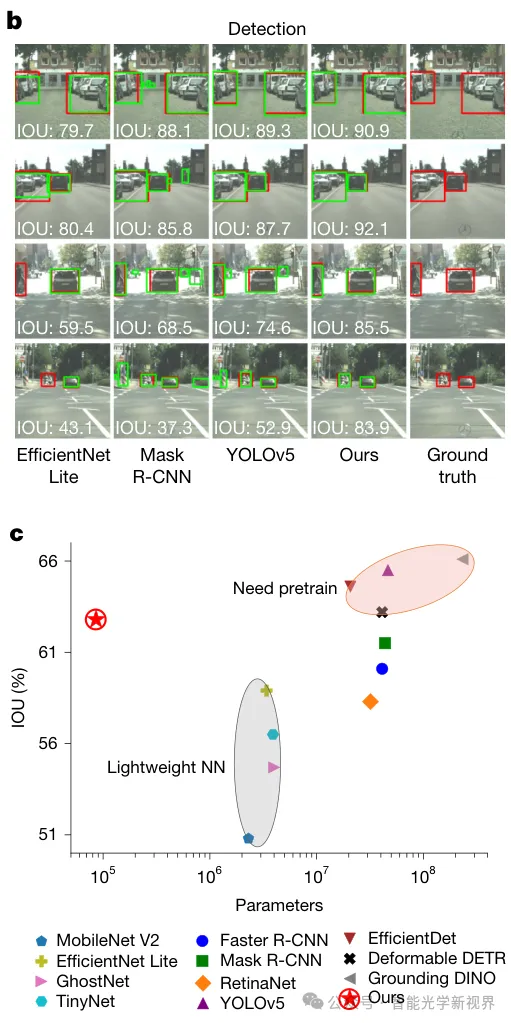
目标检测方面,系统在Cityscapes上取得62.8%的IoU,接近Deformable DETR的63.2%,并优于多种轻量级网络和部分大型模型。
这说明光学前端提取的特征能够支持复杂交通场景中的目标定位,而不仅限于简单图像分类。
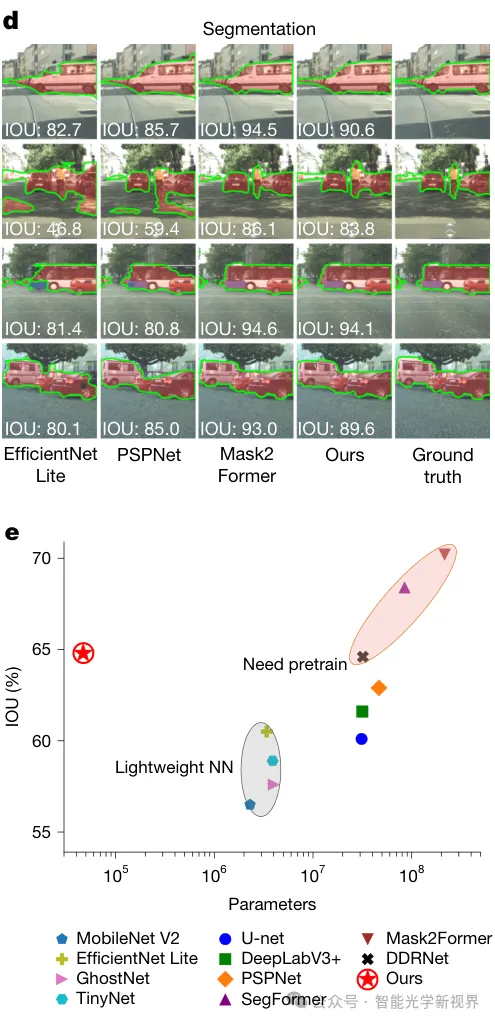
语义分割方面,系统取得64.8%的IoU,略高于DDRNet的64.6%,但低于SegFormer的68.4%和Mask2Former的70.2%。
结果表明,系统能够处理像素级视觉任务,但与部分先进数字模型相比仍存在精度差距。
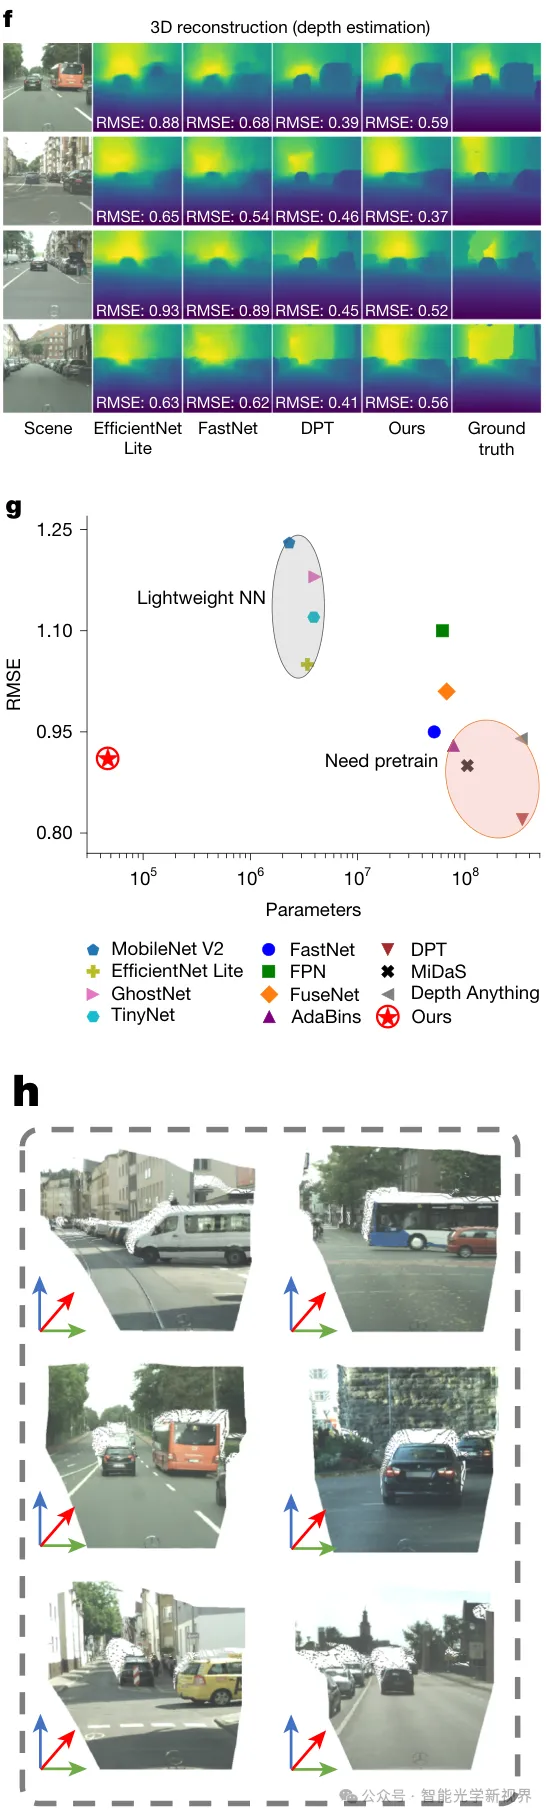
三维重建方面,系统通过深度估计恢复场景几何信息,取得0.91的RMSE,优于AdaBins的0.93和Depth Anything的0.94,但不及DPT的0.82。
这证明光学特征可以用于连续深度预测,而不只是离散类别识别。
多任务处理的计算效率
上述三项静态任务可以通过同一个光电混合系统,在一次前向处理中同时生成结果。
系统数字后端仅包含8.7万个参数,计算量为0.578 GFLOPs,每次推理的能耗为76 mJ。
论文将其与依次运行YOLOv5、Mask2Former和DPT完成三项任务的方案比较,报告数字参数量减少约6900倍、计算量减少约1600倍、能耗降低约300倍。
这些结果体现出共享光学特征带来的效率优势。不过,比较涉及不同模型的架构、任务精度和预训练条件,因此不能将这些倍率理解为在任意硬件和应用条件下均成立。
视频任务:时序信息带来不同的性能变化
在DAVIS数据集上,研究利用连续帧光学特征进行视频分割与视频内容理解。
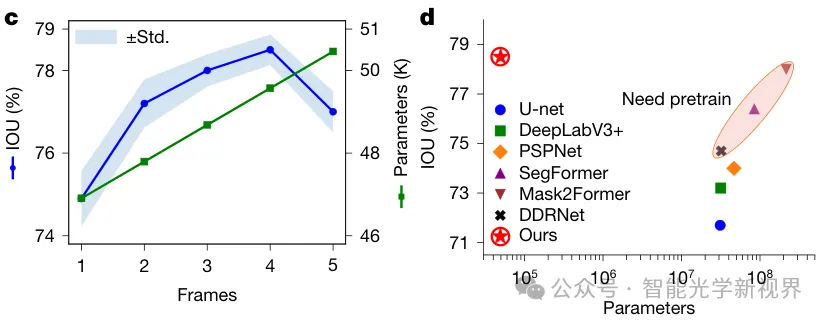
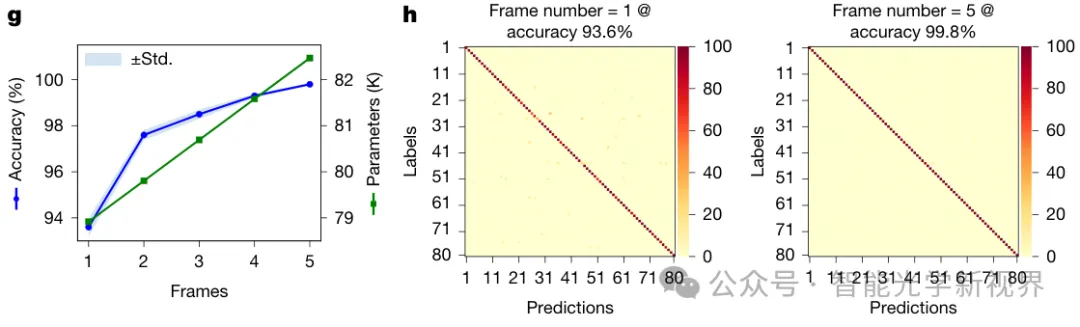
视频分割中,随着输入帧数增加,系统能够利用更多时序信息。使用四帧时,IoU达到最高的78.5%,超过SegFormer的76.7%和Mask2Former的78.0%。
但继续增加至五帧及以上后,分割性能反而下降。论文认为,大幅运动及遮挡会增加时序对齐难度,说明更多输入帧并不一定带来更好的密集预测结果。
对于视频内容理解,系统需要识别整个视频场景或动作类别。
在80类视频场景测试中,单帧输入的准确率为93.6%,使用五帧后提高至99.8%。
与视频分割不同,整体视频识别能够更充分地利用多个时间点提供的语义信息,因此表现出不同的帧数依赖关系。
实体原型:自然光场景下的边缘部署
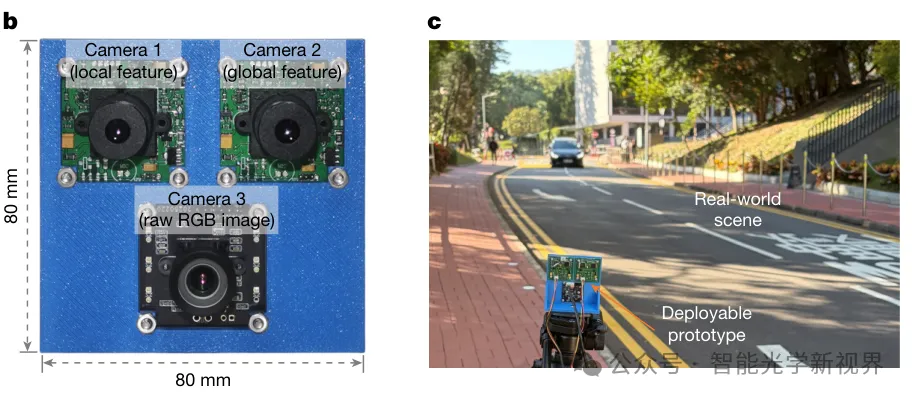
为了检验实际部署能力,研究制造了包含三套相机的原型系统。
其中,两套相机集成透射式超表面,分别提取局部和全局特征;第三套普通RGB相机仅用于记录彩色图像和展示结果。
考虑到硅超表面的光谱透射特性,原型采用800–1200 nm带通滤光片,与前述532 nm反射式实验平台不同。
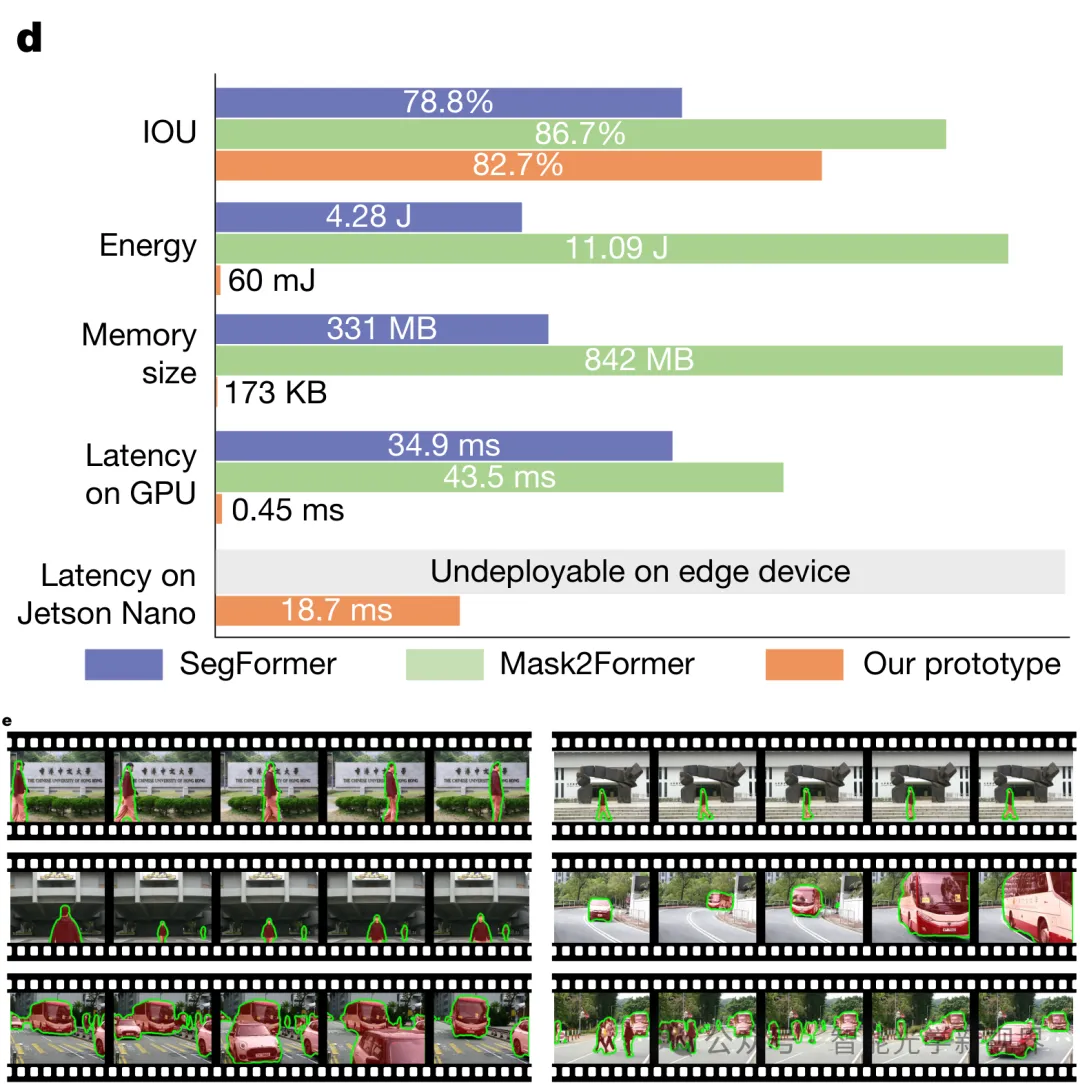
在校园自然场景的语义分割测试中,原型取得82.7%的IoU,高于SegFormer的78.8%,但低于Mask2Former的86.7%。
原型的分割数字后端仅需173 KB存储空间,论文报告能耗为60 mJ,测试GPU上的处理延迟为0.45 ms。
与Mask2Former相比,论文报告存储需求降低约4867倍、能耗降低约184倍、GPU延迟降低约96倍。
进一步部署到NVIDIA Jetson Nano后,系统实现18.7 ms的推理延迟,表明其能够运行于资源受限的边缘计算平台。
需要区分的是,0.45 ms为论文报告的GPU测试延迟,18.7 ms则对应Jetson Nano平台,二者不是同一硬件条件下的结果。
5
结论
这项研究最重要的突破,并不是单纯增加了光学神经网络的参数规模,而是改变了光学计算的设计思路:从精确复现数字模型的代数运算,转向利用光学物理本身实现通用视觉特征提取。
通过高斯RBF核、多通道光学编码和衍射尺度控制,研究构建了可供不同任务共享的光学前端,并利用轻量级数字网络完成信息融合与非线性处理。多任务基准实验和自然场景原型共同说明,这种光电分工能够在保持一定视觉性能的同时,显著降低数字计算需求。
不过,4100万个光学参数并不等同于可针对不同任务自由训练的数字权重,系统仍需要电子网络完成复杂视觉推理。实际原型也依赖特定工作波段、多相机配置和图像配准,其性能尚不能直接推广到所有分辨率、照明条件与边缘硬件。
总体而言,研究为通用智能光学提供了一种新的技术方向:不再要求光学系统独立完成全部神经网络计算,而是将适合物理传播的计算交给光学器件,将灵活的任务处理交给电子网络,通过光电协同实现高效率的视觉感知。
微信号丨智能光学新视界
扫描二维码 关注我们
论文题目:Optical metasurfaces for general vision processing on the edge