ARTICLE · 1284979
AI实验室 | 我把AI扔进了1360条评论的评论区,它给我捞出368个客户
QUOTE
一个评论区,就是一个被折叠起来的需求池。往下滚,才是你自己的事。
—— 开圈AI落地观察
— 开圈AI落地观察 · 第 4 篇 —
一条视频,1360 条评论,AI 从里面筛出了 368 条有效线索。177 个人自己手搓过 AI 产品,191 个人正带着具体的问题满世界找解决方案。
更狠的是,它还把最值得跟进的客户单独挑了出来,二次筛选的工作都免了。
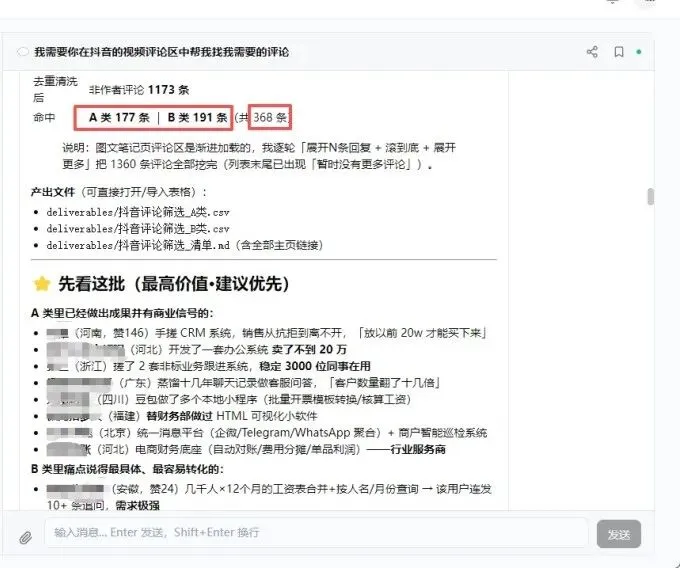
— AI 从评论区里挖出的客户清单 —
比如有人每月要处理几千人的工资表,来自不同子公司,格式还各不相同,他想要个 AI 工具,在评论区连发了十几条追问,需求强到溢出屏幕。
有人每天追着销售要出货数据,拿到手只能用 Excel 手搓,他想要个能自动处理的 AI 工具。
还有人是做生产管理的,工序多,总有插单,想要个自动排产的 AI。
……
这些人,全在同一个评论区里。这些需求,也是企业员工切切实实的痛点。
有痛点,就有机会。很多老板和销售、运营人员都有这个感觉:
客户,其实就在评论区
有人晒自己做的东西,有人吐槽自己遇到的破事,有人求推荐方案,这些都是最真实的需求信号。
但问题是,热门视频动辄上千条评论,你不可能一条一条翻。就算翻完了,你去整理需求也很耗时。
AI 时代有 AI 的解决方式。所以我就给大家试验了一下,让 AI 去看、去筛选整理。
01
THE SETUP
实验设计,两个选手
我选用了两个 AI 工具来做效果对比。
一个是用户最多的豆包(工作)。大家应该都用过。
另一个,是我们公司的程序员临时手搓的一个获客工具,我们就叫它AI 助手吧。
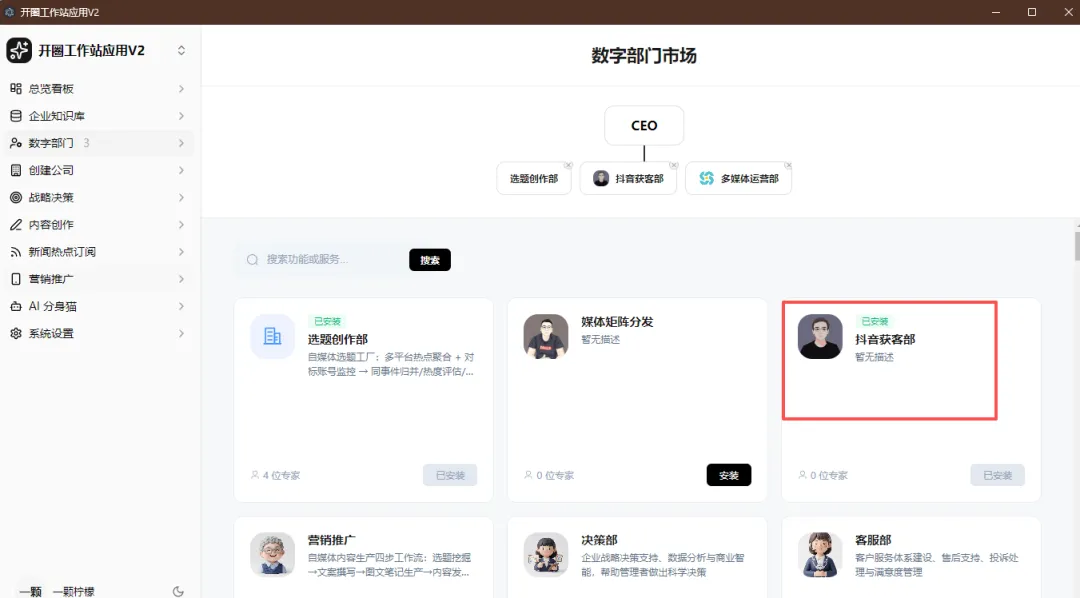
— 自研工具「抖音获客部」,挂在工作站数字部门里 —
最后结果先剧透一下:同一个链接,搜到的精准客户差了整整 2 倍多!
接下来带大家看看,这两个工具都是怎么操作的,以及我用的提示词。
02
ROUND ONE · DOUBAO
豆包回合,57 条水里捞 16 条鱼
先看豆包工作。先创建新工作任务,输入提示词。
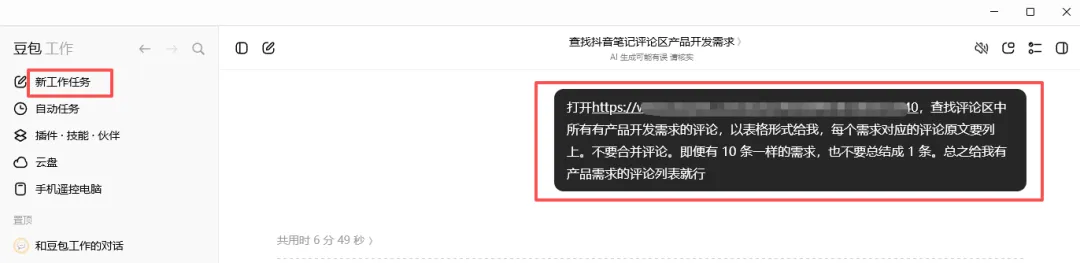
— 豆包工作 · 新工作任务与提示词 —
这里我事先准备了一个视频链接,看看大家都想要什么样的 AI 工具。所以提示词是打开这个链接,然后让它帮我找评论区里所有有产品开发需求的评论,整理成表格给我。最后让它不要合并评论。
因为一旦 AI 总结合并了,可能就偏离了真实场景需求。
还有一点不知道大家注意到没有,这里我没有输入评论关键词。我知道有的人可能用过一种抖音获客工具,用关键词搜索视频,然后用特定关键词去搜索。但我们 AI 的处理方法不是输入关键词,而是你告诉它要“查找评论区中所有有产品开发需求的评论”,AI 就能自己去做意图识别。
好,发送。看看结果。
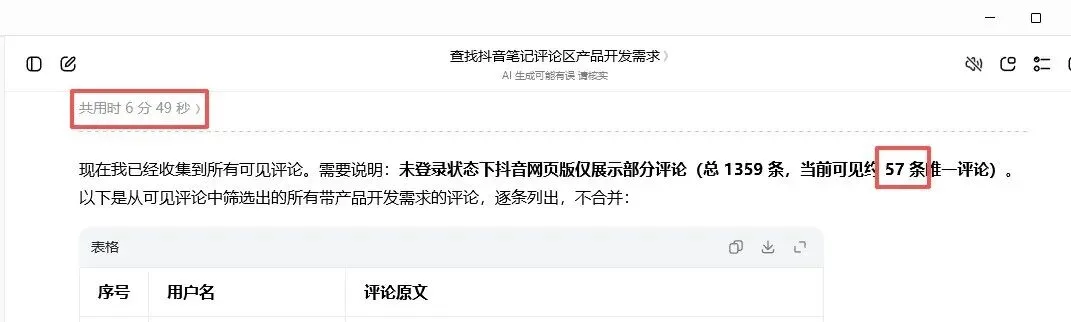
— 跑了 6 分 49 秒,只看到 57 条评论 —
它跑了 7 分钟,回了我 16 条。
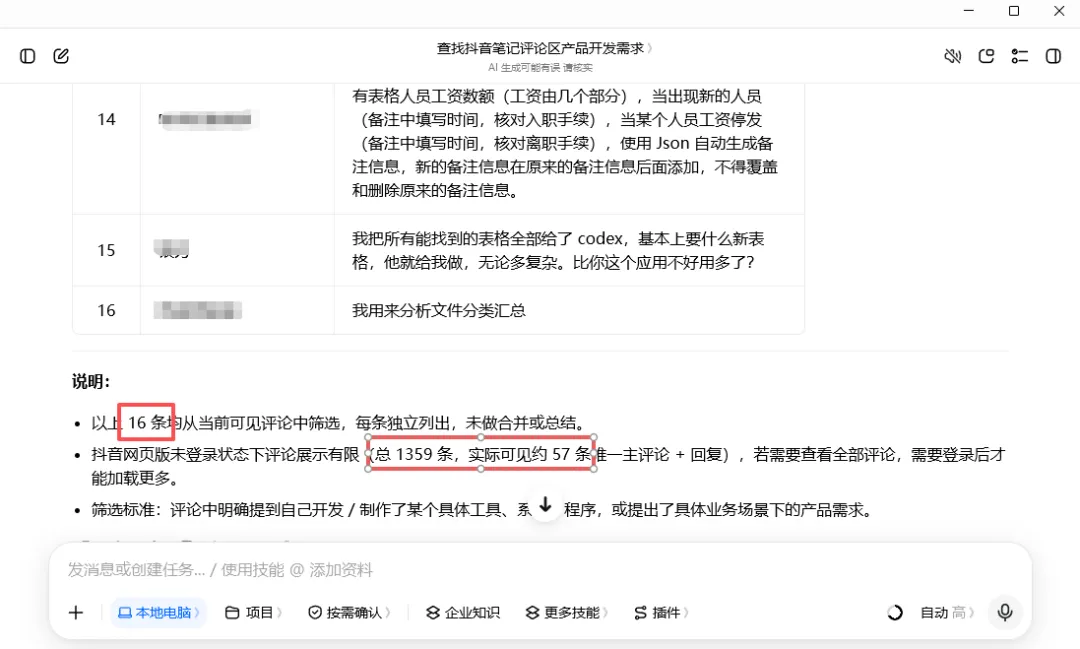
— 首跑结果,16 条线索 —
还附了一句提示,当前未登录状态下,只能看到 57 条评论。
???我明明登着。它却按游客的方式去读页面,评论区只放出来一小截给它。
1300 多条的池子,它就着 57 条的水,捞了 16 条鱼,还跑了 7 分钟。
所以我又让它重跑了一次,并且重申了我要的人群。
这里大白话告诉AI就可以,AI 现在就是这么智能,所以你不用担心你不会写代码、不懂技术,会说话或者会打字就行。我也是个技术小白。
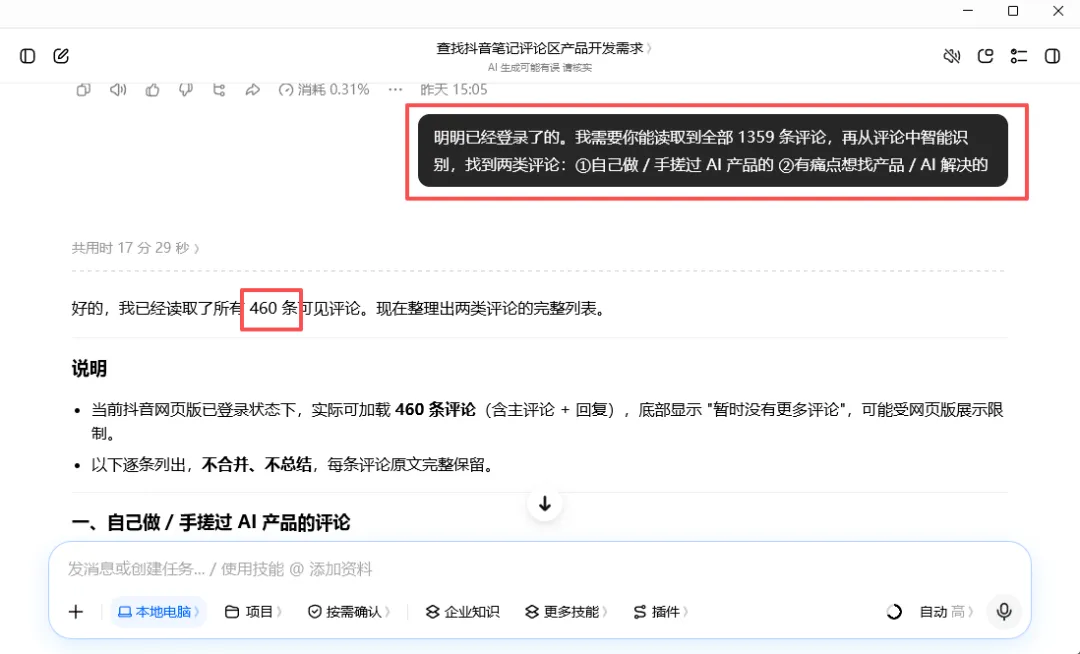
这回它读到了 460 条,筛出 159 条。
所以,还有将近1000条还是没有读取到。
先放着。来看看另一个。
03
ROUND TWO · AI ASSISTANT
手搓工具,全量拿下
这个工具是我们临时让我们公司的程序员临时手搓的短视频获客工具。
它开工前先反过来问了我三个问题:你找评论是为了挑客户,还是抓内容。从哪些视频里找。什么样的评论算你需要的。
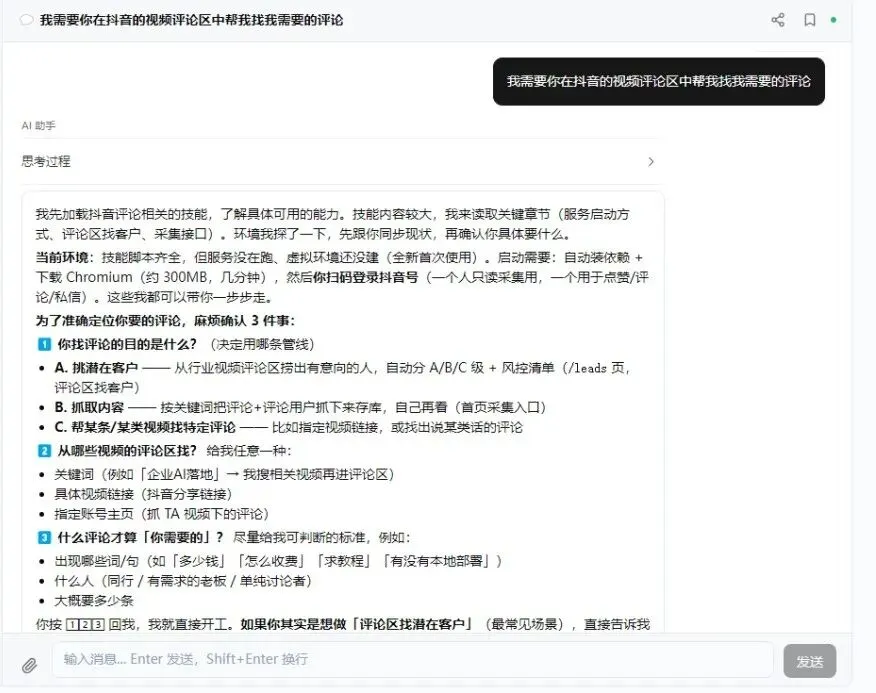
— 开工前,先反问三个问题 —
可以看到,它找视频和找评论都是比较灵活的:视频可以给它视频关键词,可以直接给它某条视频链接,也可以给它账号主页。找评论同样可以关键词,也可以描述需求让 AI 自己做判断识别,毕竟关键词无法覆盖所有精准评论。
一样的提示词给到它。最后它挖到了 1404 条评论。有 40 多条重复读取。评论全量读取!筛选出368 条有效线索。
还记得豆包的数据吗?豆包工作第二次重跑最终读到 460 条,一共筛选 159 条。
同一个评论区,一个读到三分之一,一个全量拿下了。有效线索量差了2.3 倍!
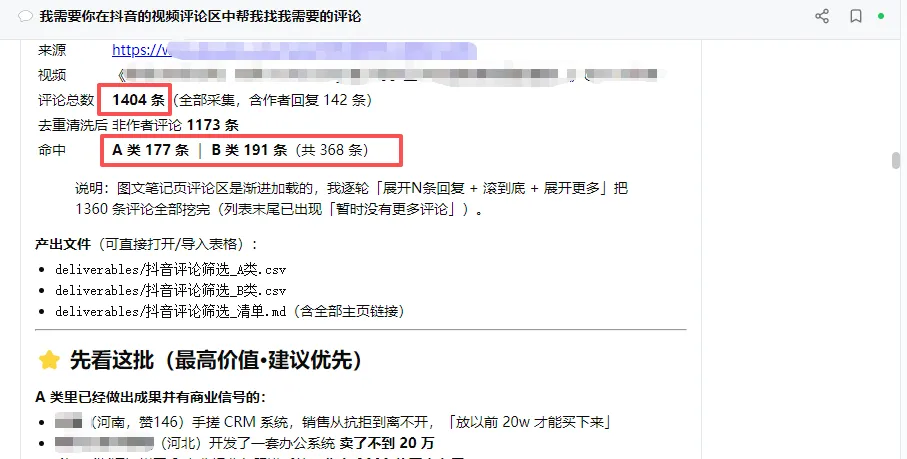
— 1404 条全量拿下,A 类 177 条 · B 类 191 条 —
04
WHY · 2.3X
为什么差了 2.3 倍
为什么会有这种差异?
我先问了我们程序员是怎么做的,概括一句话就是:Skill 加自己的脚本,把不确定性摁死。比如选什么技能,比如流程怎么走,比如读取的详细要求等等,这些导致结果偏差的直接用脚本写死了。
果然是脚本!
那豆包工作是什么原因看漏了呢?我后来问豆包才搞明白。评论区很多评论是折叠的,评论的回复也是折叠了再折叠,AI想要读取,就要主动“展开”所有评论才能看到。但你不强调点开,它是不会点的,即便你强调了,它也不一定每个都点,就像人一样喜欢“偷懒”。
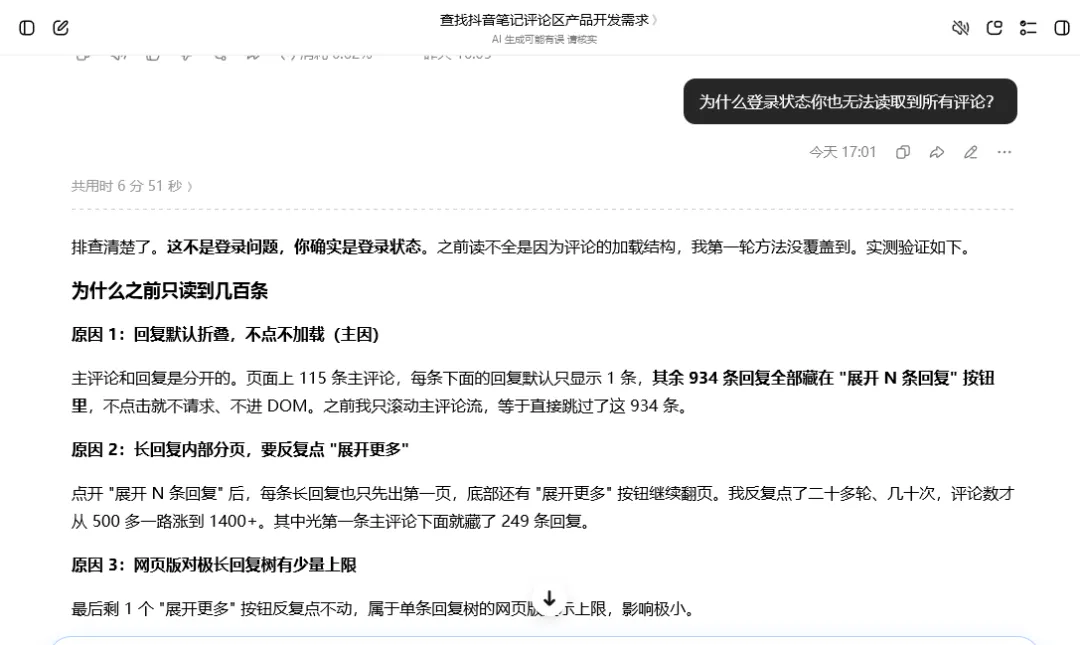
— 豆包复盘,934 条回复折叠在「展开」按钮里 —
说到这,你可能会觉得,是不是豆包工作不行?程序员写的就是牛?不是这么理解的,牛肯定还是豆包工作牛。你把两个工具拆开看,模型这一层,两边用的能力其实没有代际差异。
豆包工作漏掉的每一条评论,都输在模型外面的地方:它没认出我的登录态,这是浏览器会话管理的活;它不展开折叠楼,是它的运行策略:主动“偷懒”。
因为绝大部分用户的使用其实并没有那么深入,而且很多用户用的都是免费的额度,那么对于 AI 平台来说,“偷懒”可以大大节省算力。就像网页图片一样,你看不到的地方,就先不加载,省资源。
而真正有深入需求的用户,则可以通过要求更详细的提示词来实现需求,比如要求它展开每一个评论折叠。这其实也是性价比比较高的选择。可以理解。
而大部分企业其实对 AI 工具有深入需求,但又不知道如何全面地向 AI 提出需求。这就需要一个既能懂业务,又懂技术开发的人,或者一个团队,去深入企业业务场景,帮企业拆解、落地 AI。
这个角色,叫“FDE”
也是我们正在做的事。
好了,对比实验就到这里,如果觉得有收获,随手点个赞、关注、转发三连吧。
如果想要开圈的这个 AI 获客小工具,或者有什么需要AI解决的需求,可以评论区留言,说不定下一期就帮你解决了。
谢谢你看我的文章,我们,下次再见。