ARTICLE · 1285576
【AI工具链】跟着敲一遍⑫:8 核跑 vLLM 翻车记
 .
 .
 阅读本文

系列:跟着敲一遍 · 21 天本地 AI 工具链 Day 12(第 12/21 篇) 前情:⑪ 给 Open WebUI 装上了 Filter;⑫ 换一个更"生产级"的推理后端。实测环境:openEuler 22.03 / VMware 虚拟化 / 8 vCPU / 15GiB / 无 GPU / 无 AVX512-BF16
这篇不是教程,是翻车实录——最后跑通了,但代价是三次失败和两次整机假死。我原本打算写一篇"无 GPU 跑通 vLLM"的顺滑教程。结果在这台 8 核虚拟机上,前后折腾了近 6 个小时,翻了三次车,其中两次把整台机器拖到失去响应——SSH 断开、连登录密码校验都卡 22 秒。一开始我以为是内存不够,改成 float32;以为是 CPU 超订,加了 --cpus=4 围栏;以为是磁盘 I/O 慢,去查了 vmstat;以为是宿主机调度问题,查了快照、查了 vCPU 超卖。每一层都有"证据支持",每一层又都被下一个数据推翻。
最后的真相有两层,而且第二层是在修好第一层之后才浮现的:这台虚拟机压根没装 VMware Tools —— 没有时间同步、没有内存气球,宿主一回收 guest 内存,guest 内部就是一段无规律的 20 秒停顿。表现是五个互不相干的子系统同时超时,而 dmesg 里一条磁盘错误都没有。1.5B 的 float32 峰值需要 11.1 GiB,可用只有 9.32 GiB —— 差 1.8 GiB。这个缺口在修好第一层之前,完全被"整机假死"掩盖了。
最后降到 0.5B 才跑通。但真正值钱的不是"跑通了",而是这次踩到的几个坑,网上几乎没人写过。这篇的价值在于:讲"无 GPU 跑 vLLM"的文章一大把,讲"为什么我的虚拟机一跑大模型就整机假死、怎么一步步定位"的几乎没有。 后者才是真正会困住人的地方。
环境先摆清楚:
[root@LinuxPythonWorkshop ~]# nproc 8[root@LinuxPythonWorkshop ~]# grep -o -m1 'avx512_bf16' /proc/cpuinfo || echo "NO-BF16" NO-BF16[root@LinuxPythonWorkshop ~]# free -htotal used free shared buff/cache available Mem:15Gi 3.4Gi 6.9Gi 26Mi 5.2Gi 11GiSwap: 5.0Gi 89Mi 4.9Gi
看着完全够:8 核、15G 内存、还有 11G 可用。Dify 全套 17 个容器正跑着,load average: 0.18,D 状态任务 0 个,连续 17 小时零异常。
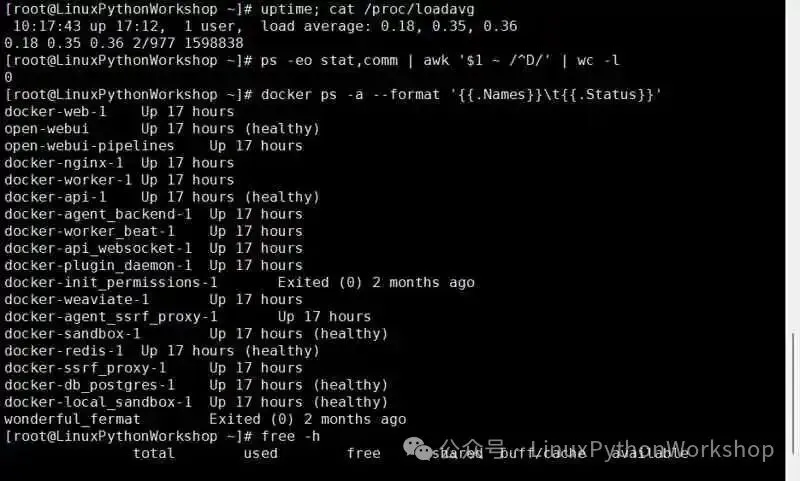
图 1:17 小时空载基线。17 个容器全部 Up,load 0.18,D 状态任务 0 个——平台此刻是健康的。
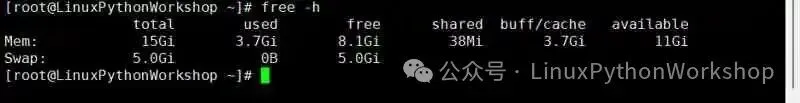
图 2:available 11Gi,Swap 未使用。这是整个排查里最不该被怀疑的一组数字。
[root@LinuxPythonWorkshop ~]# docker inspect vllm-server --format 'IMAGE={{.Config.Image}} ENTRYPOINT={{json .Config.Entrypoint}} CMD={{json .Config.Cmd}} ENV={{json .Config.Env}} ...' IMAGE=vllm-openai-cpu:day12 ENTRYPOINT=["vllm"] CMD=["serve","/root/.cache/modelscope/models/Qwen--Qwen2.5-1.5B-Instruct/snapshots/master","--host","0.0.0.0","--port","8000","--dtype","bfloat16","--max-model-len","2048","--max-num-seqs","8","--enforce-eager"] ENV=["VLLM_TARGET_DEVICE=cpu","VLLM_CPU_KVCACHE_SPACE=1",...] 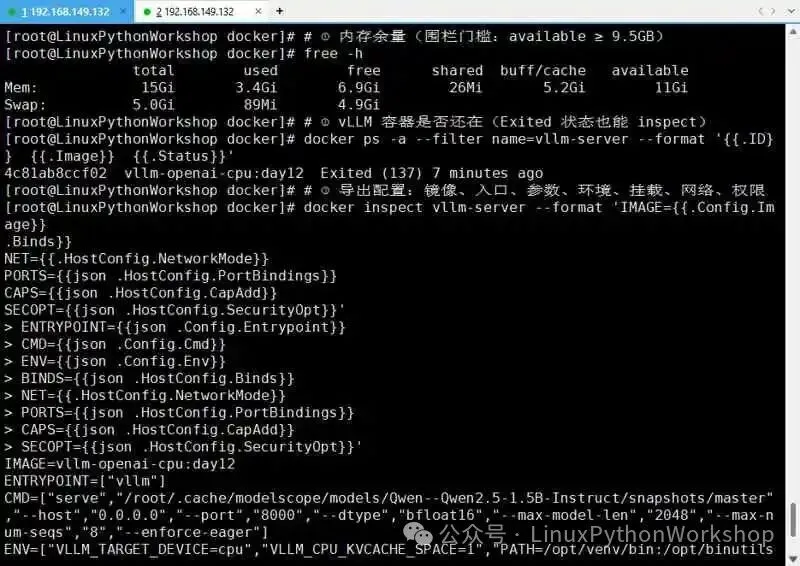
图 3:把容器的原始配置导出成文本,后面每次改动都以这份为准做"只改一处"的对照实验。
起手第一坑:镜像选错,白拉 8.8GB
真正开始之前,还有一个不在"翻车三次"里的坑,因为它是纯浪费流量:
按官方命令 docker pull vllm/vllm-openai,拉下来 8.8GB,启动直接报 No CUDA driver。
原因:vllm-openai 带 openai 但没带 -cpu,是 CUDA 构建版。没有 GPU 的机器,拉了必然起不来,还白烧 9GB 流量。
vllm/vllm-openai:latest | 必须有 NVIDIA GPU | ||
vllm/vllm-openai-cpu:latest-x86_64 | 1.76GB |
💡 判定口诀:仓库名带
-cpu才是 CPU 版。
docker images显示的是解压后体积(5.4GB),拉取时显示的是压缩体积(1.76GB)。两者都对,别被 5.4GB 吓到。
我按标准教程起了 vLLM 容器:
docker run -d --name vllm-server --network lpw-ai -p 8000:8000 \ --ipc=host --security-opt seccomp=unconfined --cap-add SYS_NICE \ -e VLLM_TARGET_DEVICE=cpu -e VLLM_CPU_KVCACHE_SPACE=1 \ -v /root/.vllm/models:/root/.cache/modelscope \ --entrypoint vllm vllm-openai-cpu:day12 \ serve /root/.cache/modelscope/models/Qwen--Qwen2.5-1.5B-Instruct/snapshots/master \ --host 0.0.0.0 --port 8000 --dtype bfloat16 \ --max-model-len 2048 --max-num-seqs 8 --enforce-eager 📖 初学者讲解:这条命令本身没问题,用的是本地 ModelScope 快照,不用联网下载模型;--ipc=host 共享 /dev/shm;seccomp=unconfined + SYS_NICE 是 CPU 后端绑核所需。
然后就是等待。
容器 Up,日志在读权重,但端口死活不通:
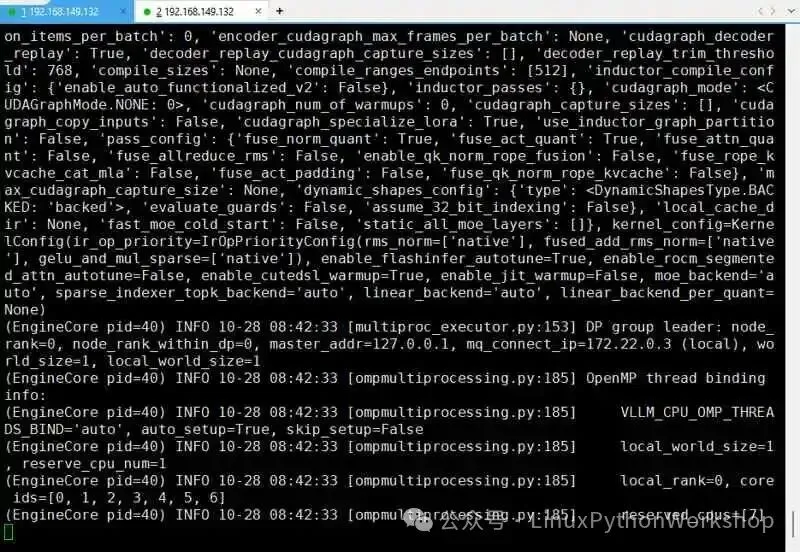
图 4:EngineCore 起来后,core_ids=[0,1,2,3,4,5,6]、reserved_cpus=[7] —— 注意这是绑核亲和性,不是 CPU 配额,两者不是一回事。
[root@LinuxPythonWorkshop ~]# curl -s -o /dev/null -w "%{http_code}\n" http://127.0.0.1:8000/v1/models 000 000 是 connection refused。第一反应是"还没加载完,等"。等了两分钟,还是 000。
判断错在哪
我第一反应是"CPU 在狂算":
[root@LinuxPythonWorkshop ~]# docker stats --no-stream --format '{{.CPUPerc}}' vllm-server 4062.52% 这个数字是假的。 8 核机器的物理上限是 800%。docker stats 在容器刚启动、采样窗口不完整时会给出失真值。真正可信的证据在 docker top:
[root@LinuxPythonWorkshop ~]# docker top vllm-server PIDUSER TIME COMMAND 445326root 0:31 vllm serve ... --dtype bfloat16 446189root 0:54 VLLM::EngineCore 446721root 29:14 VLLM::Worker
VLLM::Worker 累计烧了 29 分钟 CPU 时间,主进程只用了 31 秒。也就是说:真正在算的是 Worker,而它永远算不完。
真凶
[root@LinuxPythonWorkshop ~]# grep -o -m1 'avx512_bf16' /proc/cpuinfo || echo "NO-BF16" NO-BF16 这台 CPU 没有 AVX512-BF16 指令集。
教科书上的说法是"会报 Unsupported dtype"。实际不会。 bf16 走软件模拟路径:每个算子先把 bf16 转成 fp32 算,再转回去,内存带宽和 CPU 开销直接翻倍。
于是它的表现是:
ValueError 退出 | 不报错、不退出 |
| 端口永不监听 | |
| 日志一个字都不提 |
这就是它比直接报错更迷惑人的地方——静默降级没有任何信号。
判据是什么
两条命令就够了:
docker top vllm-server # Worker 的 TIME 在涨,但服务没起vmstat 1 3 # bi 接近 0(磁盘没在读),us 极低 sy 极高
vmstat 那三行是决定性的:
r b swpd free buff cache si so bi bo in cs us sy id wa40 1 417084 188272 305594 6712684 0 0 47 92 393 484 2 3 93 133 1 417084 184576 305952 6712864 0 0 4 36 10098 551 26 74 0 029 0 417084 150844 305660 6703686 0 0 4 0 1912 1312 7 93 0 0
bi ≈ 4~47 块/秒→ 磁盘没在读,权重早就读完了 sy = 74~93%, us只有2~26%→ CPU 绝大多数时间耗在内核态(线程争抢、缺页、调度),不是在算矩阵r = 40→ 8 核上 40 个可运行线程,5 倍超订
💡 这一条最值钱:内存增长速率是唯一可靠的前进信号。当时我采样了 12 次:
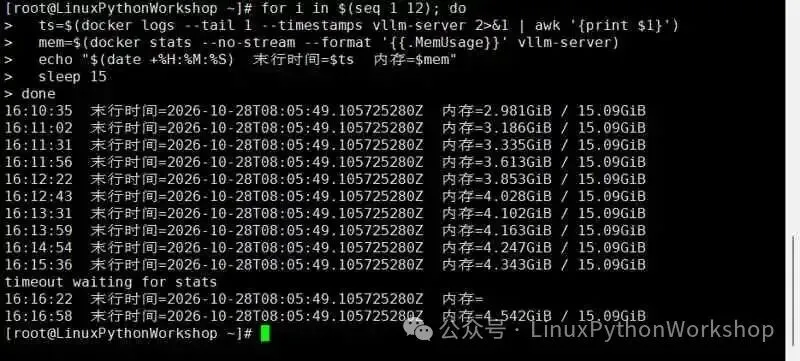
图 5:12 次内存采样。注意末行时间戳始终是 08:05:49 没变,但内存从 2.98Gi 一路涨到 4.54Gi——进度条用 \r 原地刷新,不产生新行。
增速从 11 MB/s 降到 1.5 MB/s 并趋于平稳——说明权重读取已经结束,卡在了 process_weights_after_loading 和 warmup。
不要拿"日志不动"当卡死信号,要拿内存增量当信号。
修正
--dtype bfloat16 → --dtype float32 改完日志立刻给了确认:
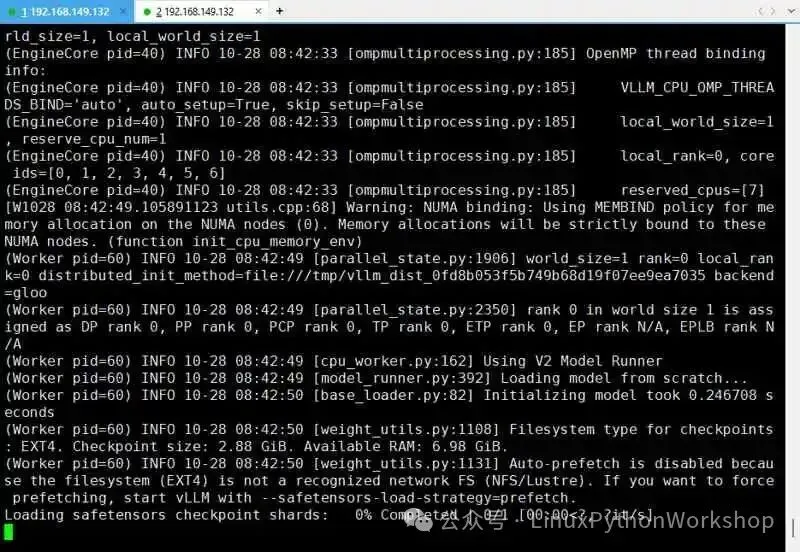
图 6:Upcasting torch.bfloat16 to torch.float32 —— dtype 改对了之后,日志里必须出现这条。它下面紧接着的 Available RAM: 6.98 GiB 也提醒了内存其实并不宽裕。
INFO [model.py:2492] Upcasting torch.bfloat16 to torch.float32. INFO [model.py:2152] Using max model len 512 INFO [scheduler.py:307] Chunked prefill is enabled with max_num_batched_tokens=512. Upcasting torch.bfloat16 to torch.float32 —— vLLM 明确告诉你,它按 float32 执行了。这就是正确姿势的判据:dtype 改了之后,日志里必须出现这条。
我以为剩下的问题只是内存。算了一笔账:
| 5.75 GiB | |
VLLM_CPU_KVCACHE_SPACE=1) | |
| 合计 | ~12.6 GiB |
15GiB 里只剩 2.4GiB 给页缓存,而权重文件本身 2.88GiB。加载瞬间还要同时容纳"正在构建的 fp32 张量"和"正在读的文件页",峰值约 8.6GiB——必然触发驱逐与重读。
于是我只改围栏相关参数:
--cpus=4 --memory=9g --memory-swap=9g # 新增-e OMP_NUM_THREADS=4 # 新增-e PYTHONUNBUFFERED=1 # 新增,日志实时--dtype float32 # 已改--max-model-len 512 --max-num-seqs 1 # 已改
这已经是这台机器能给出的最保守配置:一半 CPU、一半内存、最小上下文、单并发。
结果——
16:45:41 MEM=6.245GiB / 9GiB LOAD=14.78 16:47:20 Connection closed by foreign host SSH 被对端关闭。
这里有两个必须记住的教训
教训一:--cpus=4 下 LOAD=14.78 是不可能出现的。
围栏把 CPU 时间锁在 4 核,纯计算负载最多把 load 推到 4~6。14.78 只能意味着:大量进程卡在 D 状态等 I/O。D 状态进程也计入 loadavg。
教训二:D 状态的进程收不到 SIGKILL。
我执行 docker kill vllm-server,容器"看起来"停了。但 79 秒后:
[20380.103193] C1 watchdog: soft lockup - CPU#1stuck for 26s! [VLLM::Worker:477248]
VLLM::Worker 在 16:53 还活着——docker kill 是假成功。
💡
D状态是"不可中断睡眠",信号要等进程从内核调用返回后才能投递。它没返回,所以信号一直挂着。这解释了为什么当时连登录密码校验(
unix_chkpwd)都会被卡 22 秒——那个进程读/etc/shadow也要走文件系统。
📖 初学者讲解:这就是为什么"kill 掉了"和"真的死了"是两回事。一定要用 docker ps + ps -eo pid,stat,comm 双向确认,不要只看命令没报错。
到了 BMC 网页控制台(149.132),我看到了完整画面:
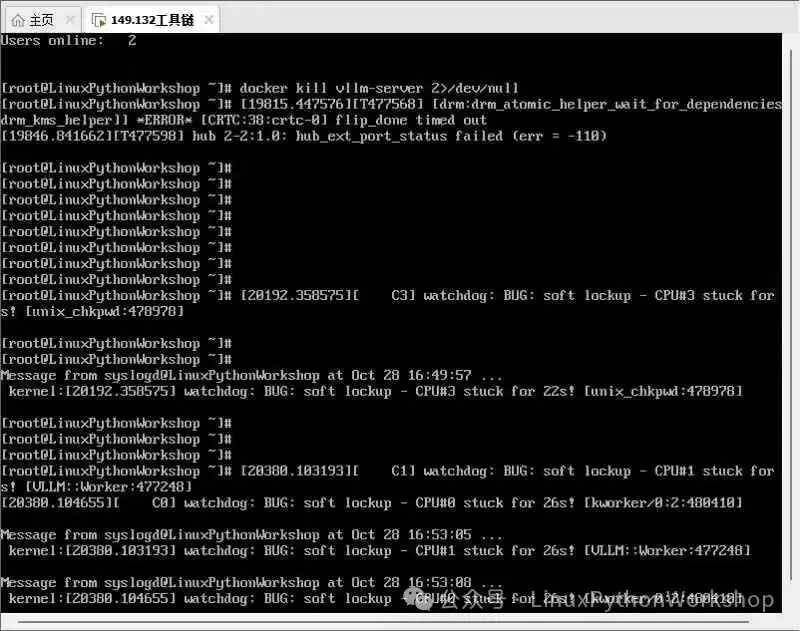
图 7:容器已被 kill,但日志里 VLLM::Worker 仍在报 soft lockup——这是整个排查最关键的一张图。
[20192.3585751] C31 watchdog: BUG: soft lockup - CPU#3stuck for 22s! [unix_chkpwd:478978] [20380.1031931] C11 watchdog: BUG: soft lockup - CPU#1stuck for 26s! [VLLM::Worker:477248] [19815.4475761][T477568] drm_kms_helper[1] *ERROR* [CRTC:38:crtc-0] flip_done timed out [19846.0416621][T477598] hub 2-2:1.0: hub_ext_port_status failed (err = -110)
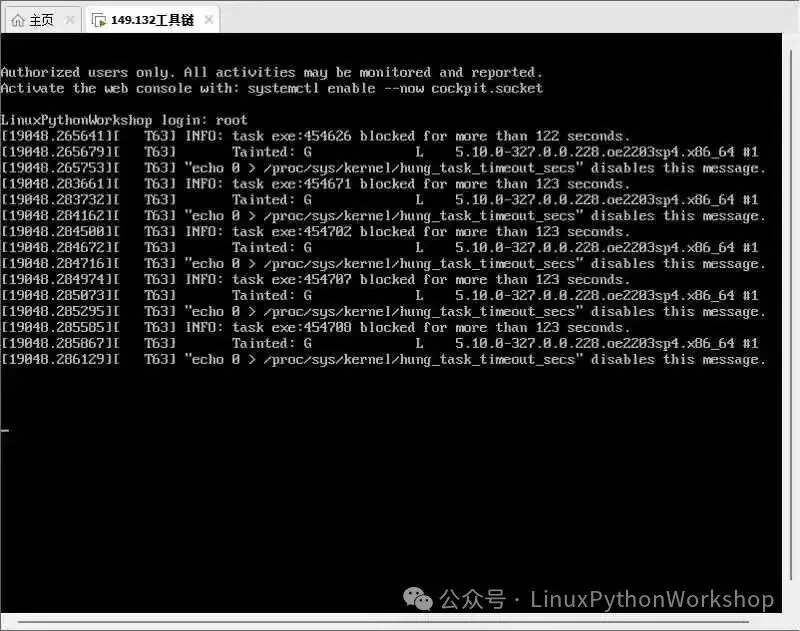
图 8:task blocked for more than 122 seconds 连续出现,Tainted: G 说明加载过非 GPL 模块(与本问题无关)。
另外还有 I/O 层的:
[1848.265641][T63] INFO: task exc:454626 blocked for more than 122 seconds. [1848.265753][T63] Tainted: G L 5.10.0-327.0.0.220.oe2203sp4.x86_64#1
hung_task_timeout_secs(默认 120 秒)触发,说明有进程在 D 状态超过 120 秒。调用栈:
rsem_down_write_slowpath+0x323/0x490 do_reconfigure_mnt+0x6d/0x110 __se_sys_mount+0x165/0x1d0 一个 remount 操作卡在 mount 写信号量上。整个文件系统层被一个长时间不返回的操作堵住,后续所有碰挂载点的进程(Docker、syslog、tty)依次排队变成 D,loadavg 堆到 74。
关键推理:为什么"五个子系统同时超时"无法用 CPU 忙解释
soft lockup - CPU#1 stuck for 21s | ||
hung_taskD 状态 120s+ | ||
Connection closed by foreign host) | ||
drm ... flip_done timed out-110 |
显示、USB、网络、I/O、时钟——五个互不相干的子系统在同一时段全部超时。
这不能用"vLLM 占了 CPU"解释(五个子系统不会同时因为 CPU 忙而集体失联);也不能用"某块盘坏了"解释(显示和 USB 不经过那块盘)。
唯一能同时解释这五个现象的是:vCPU 在一段时间内完全没有被 hypervisor 调度。
我走过的两个弯路
弯路一:怀疑外接硬盘掉了。
看到 usb 2-2: reset 就以为移动硬盘掉线了。但 lsusb -t 显示:
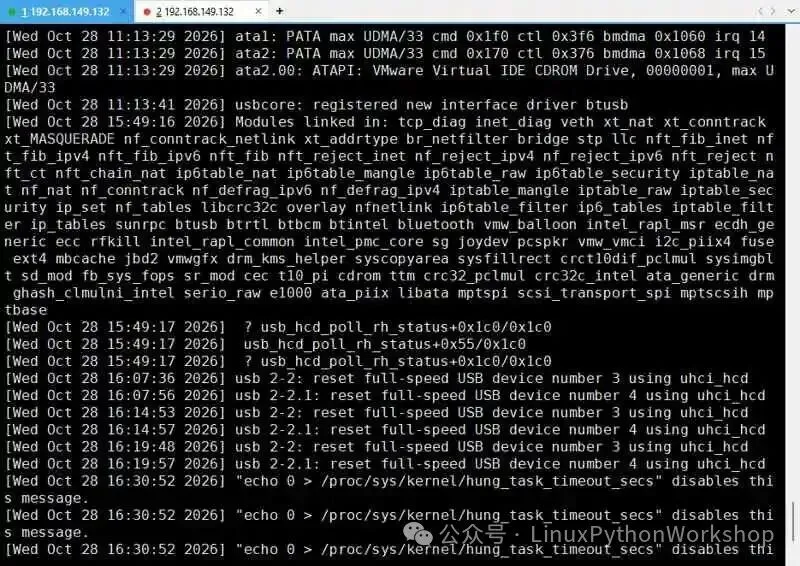
图 9:usb 2-2 的 reset 记录横跨 16:07 到 16:32,正好覆盖崩溃区间;而所有 USB 设备都写着 "VMware Virtual"。
VMware Virtual USB Mouse VMware Virtual USB Hub VMware Virtual Bluetooth Adapter lsblk 只有一个块设备:sda 80G TRAN=spi HOTPLUG=0。这是 VMware 虚拟机,usb 2-2 是虚拟 USB 控制器在反复 reset,不是真外接盘。 根因从"盘坏了"变成"虚拟化层出问题了"。
弯路二:怀疑 docker stats 的 4062% 是"40 线程狂算"。
8 核物理上限 800%。这个数字不是 docker 的 bug,是 VM 停顿的副作用——当 guest 收不到时钟中断时,CPU 时间统计本身就会失真。
📖 初学者讲解:在虚拟化环境里,docker stats、top、vmstat 的数字都可能是"症状"而不是"原因"。先看有没有跨子系统的共性,再去解释单个指标。
到这一步,我已经猜了五六轮,全被推翻。得换个方法。
关键判断:这不是 vLLM 的问题
有一个反证一直摆在那里却没被重视——
容器被 kill 之后 79 秒,仍出现了
soft lockup ... [unix_chkpwd]。
unix_chkpwd是你登录时 PAM 用来校验密码的辅助进程,它只做一件事:读/etc/shadow比对哈希。这是一次微秒级操作。它能在内核里卡 22 秒,说明停顿与 vLLM 无关。
于是思路从"vLLM 参数不对"转向"平台本身在周期性停顿"。
分层计时:把"容器启动"拆成三层
不再整体怀疑,改成逐层单独测量:
# 第① 层:只测镜像读取 time docker run --rm --cpus=1 --memory=1g --network none \ --entrypoint python vllm-openai-cpu:day12 -c "print('ok')" # 第② 层:测框架导入(重头戏) time docker run --rm --cpus=2 --memory=2g --network none \ --entrypoint python vllm-openai-cpu:day12 -c "import torch; print(torch.__version__)" 判读标准很干脆:
real | ||
|---|---|---|
| > 60 秒 | 虚拟盘随机读是硬伤 | vLLM 这条路在这台机器上判死 |
在这台机器上实测(此时已装好 VMware Tools):
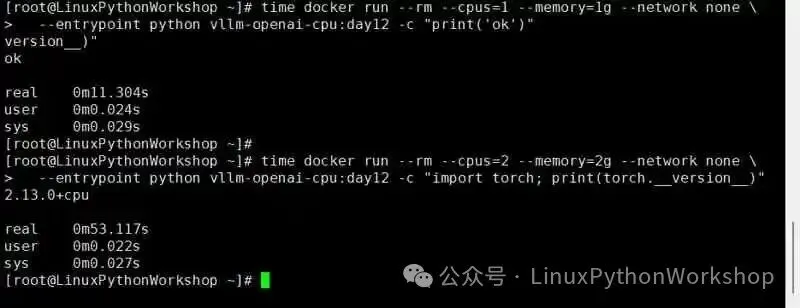
图 10:分层计时的两条实测。print('ok') 用了 11.3 秒,import torch 用了 53.1 秒——两个数字的劣化倍数一致,这才是关键。
# ① print('ok') real 0m11.304s user 0m0.024s sys 0m0.029s# ② import torch real 0m53.117s user 0m0.022s sys 0m0.027s torch 2.13.0+cpu
这两组数字给出的信息比单个数字多得多:
其一,两条的劣化倍数一致(约 10 倍)。 正常跑一句 print('ok') 是 0.5~1 秒,这里 11.3 秒;正常 import torch 是 3~5 秒,这里 53.1 秒。如果只是 torch 装坏了,实验一应该是 1 秒。 实际是"连启动容器都要 11 秒"——说明慢的不是 torch,而是整个镜像层的读取路径。
其二,user + sys 加起来只有 0.049 秒。 53 秒里 CPU 几乎没干活,全部时间花在等待上。这是纯 I/O 等待的典型特征,不是算力不足。所以"CPU 太慢所以加载慢"这个直觉是错的。
其三,一个偶然发现,把"慢"量化得非常直观。 后来下载 0.5B 模型时,下载器打出了实时速率:
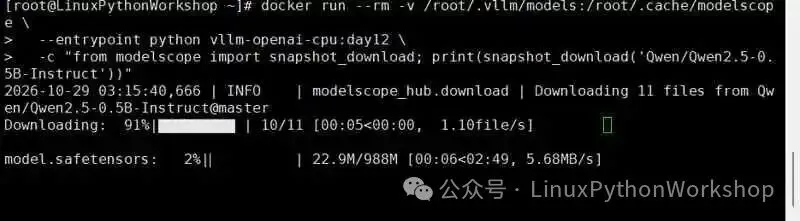
图 11:从 ModelScope 下载 988 MB 权重,速率 5.68 MB/s——这个数字和本地虚拟磁盘读取权重的 6.4 MB/s 几乎相同。
model.safetensors: 2%|▏ | 22.9M/988M [00:06<02:49, 5.68MB/s] 从阿里云下载的速度是 5.68 MB/s,从本地虚拟磁盘读文件的速度是 6.4 MB/s。
两者几乎一样。换句话说:这台机器的"本地磁盘",已经慢到了广域网的量级。 正常的本地 SSD 顺序读应该是几百 MB/s,比网络下载快两个数量级。
💡 这个对照比任何形容词都有说服力。
而且它能反推验证:torch 那一堆
.so文件合计几百 MB,按 5~6 MB/s 读,正好是 50 秒左右——和实测的 53 秒对得上。
为什么必须分层?因为之前那个数据太有迷惑性:容器内存从 2.914MiB 爬到 23.76MiB,花了 2 分 42 秒。当时我以为是"权重加载太慢"或"内存不够",实际上它根本没走到加载模型那一步。之前所有关于内存的推理,方向全错了。
💡 这就是分层计时的价值:它把一个笼统的"慢",变成一个可归因的具体层级。
而且它顺便否掉了另一个常见猜测:I/O 慢 10 倍 ≠ 磁盘坏了。这台机器的
dmesg里从头到尾没有一条sd/ata的 I/O error,SMART 也正常。慢和坏是两件事。
隔离实验:空载基线
平台是否自病,也要单独测:
d0=$(dmesg | grep -c "soft lockup") for i in $(seq 1 20); do echo "$(date +%H:%M:%S) load=$(awk '{print $1}' /proc/loadavg) 新增lockup=$(( $(dmesg | grep -c 'soft lockup') - d0 ))" sleep 30 done 10 分钟空载,一条容器都不起。
新增 lockup = 0 → 平台健康,vLLM 是触发器 - 空载也出现 lockup → 宿主/虚拟化层问题,与 vLLM 无关
跑一条命令,答案就出来了:
[root@LinuxPythonWorkshop ~]# systemctl status vmtoolsd --no-pager Unit vmtoolsd.service could not be found. 这台虚拟机压根没装 open-vm-tools。
这不是小事。它缺三个能力,每一个都直接对应一类症状:
| 时间同步 | soft lockup |
| 内存气球 | |
| vmwgfx 协作 | flip_done timed out |
第二条尤其关键:宿主侧换出 guest 内存,guest 完全看不见(guest 的 swap used 只有 1.7%,看起来内存很宽裕)。但每一次缺页都要等宿主磁盘,表现就是"随机 20 秒全局停顿、所有设备一起超时、磁盘却没有任何 I/O error"——和日志里五个子系统同时失联的现象完全吻合。
修复
dnf install -y open-vm-tools systemctl enable --now vmtoolsd timedatectl set-ntp true 装完确认三件事:
systemctl status vmtoolsd --no-pager | head -6 timedatectl | head -6 lsmod | grep -i vmw_balloon 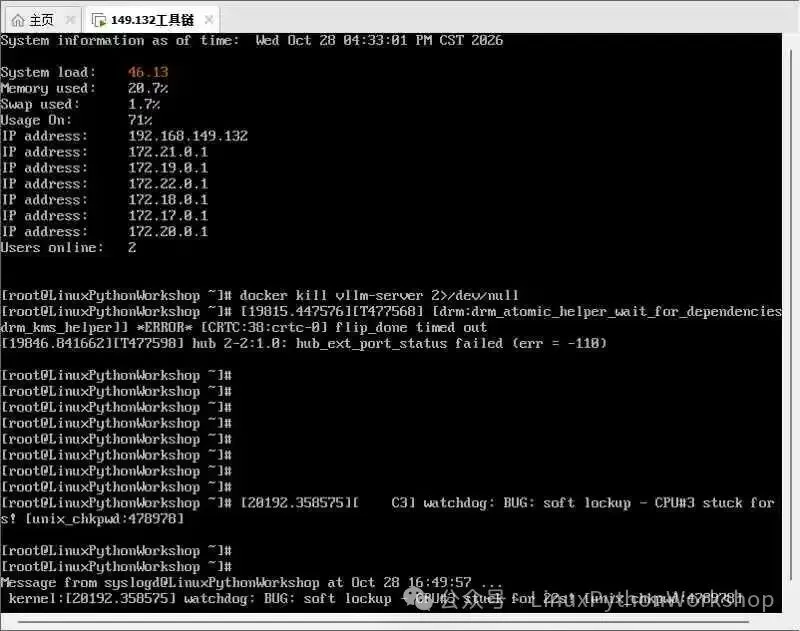
图 12:崩溃时的 BMC 控制台。System load: 46.13、Memory used: 20.7%——内存占用并不高,却把负载推到 46,说明卡住的是等待而不是计算。
实际输出:
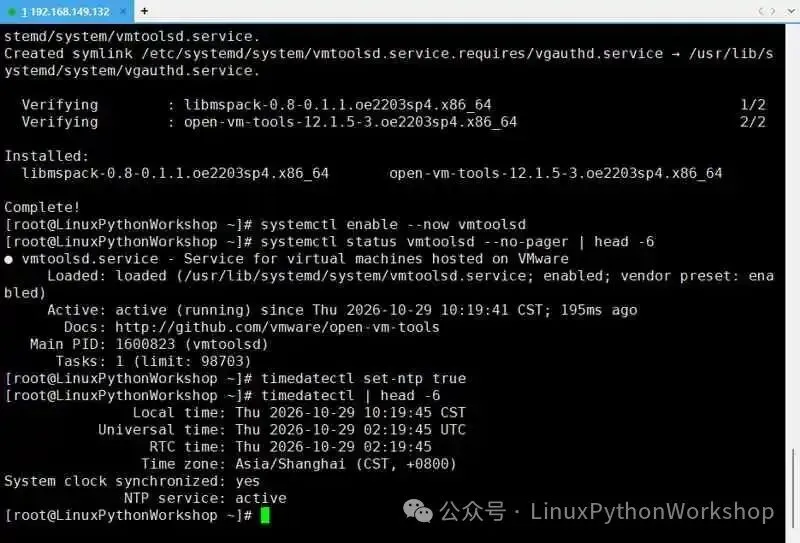
图 13:open-vm-tools 安装完成,vmtoolsd 处于 active (running),System clock synchronized: yes。这一行是关键——之前 guest 没有时间源,宿主一暂停 VM 时钟就跳变。
● vmtoolsd.service - Service for virtual machines hosted on VMware Loaded: loaded (/usr/lib/systemd/system/vmtoolsd.service; enabled) Active: active (running) since Thu 2026-10-29 10:19:41 CST; 195ms ago Main PID: 1600823 (vmtoolsd) Local time: Thu 2026-10-29 10:19:45 CST System clock synchronized: yes NTP service: active 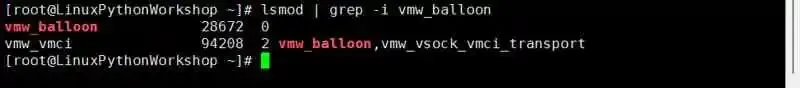
图 14:vmw_balloon 内核模块已加载,并被 vmw_vmci 引用——guest 与 hypervisor 的内存回收通道打通了。
vmw_balloon 28672 0vmw_vmci 94208 2 vmw_balloon,vmw_vsock_vmci_transport
三个条件全部就位:时间同步生效、气球驱动已加载、guest 与 hypervisor 的回收通道打通。
📖 初学者讲解:
vmw_balloon是内核模块,vmtoolsd是用户态代理。两个都要有——只有模块没有代理,宿主依然无法安全地回收 guest 内存。
验证:同样的命令,同样的时间点,完全不同的结果
修完不能只看"命令装好了",要看行为是否变了。于是用完全相同的命令再跑一次,只在启动后按同一节奏采样 load 和 D 任务数,并挂了一个自动刹车:load ≥ 20 或 D ≥ 5 就立即 docker kill。
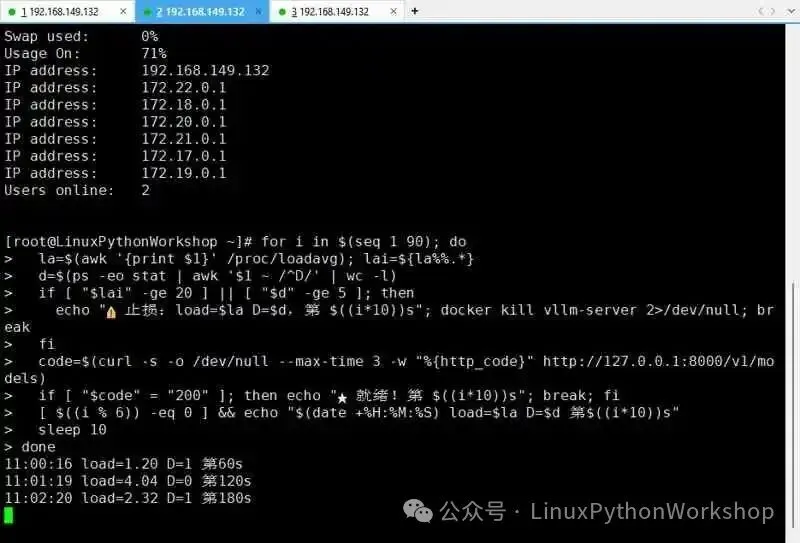
图 15:修复后的刹车循环。前 7 分钟 load 在 1.20~4.98 之间,D 任务从未超过 1;第 450 秒 load 冲到 53.15,刹车立即生效。
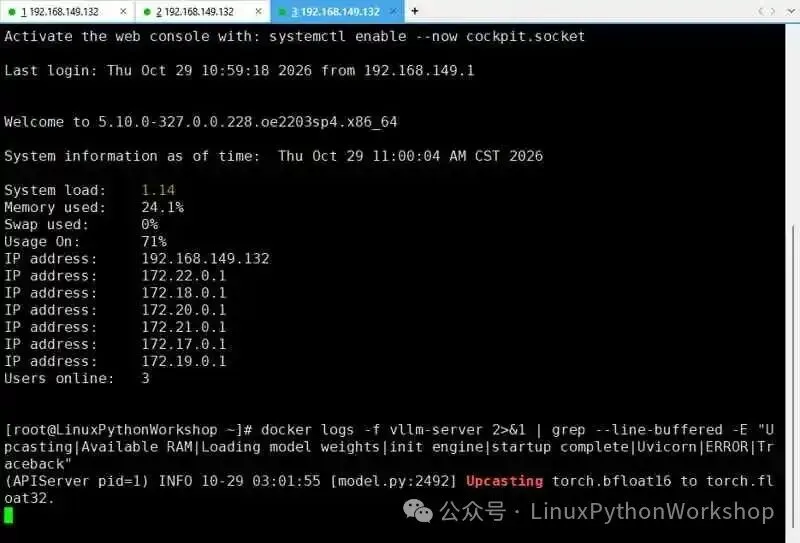
图 16:Upcasting torch.bfloat16 to torch.float32 正常打印;下一行的 Available RAM: 9.32 GiB 成了后面算内存账的关键输入。
11:00:16 load=1.20 D=1 第60s 11:01:19 load=4.04 D=0 第120s 11:02:20 load=2.32 D=1 第180s 11:03:21 load=3.99 D=1 第240s 11:04:23 load=4.04 D=0 第300s 11:05:26 load=4.98 D=1 第360s 11:06:32 load=3.19 D=1 第420s ⚠️ 止损:load=53.15 D=6,第 450s 和修复前同一时间点的对比:
LOAD=14.78,90 秒后 SSH 断开 | load 2.32D=1 | |
load 3.19D=1 | ||
load 53.15 |
前 7 分钟的曲线上,修复前后是两个世界。 但第 450 秒仍然冲上去了——这说明还有第二个问题。
决定性的区分:soft lockup 计数
刹车之后立刻取证:
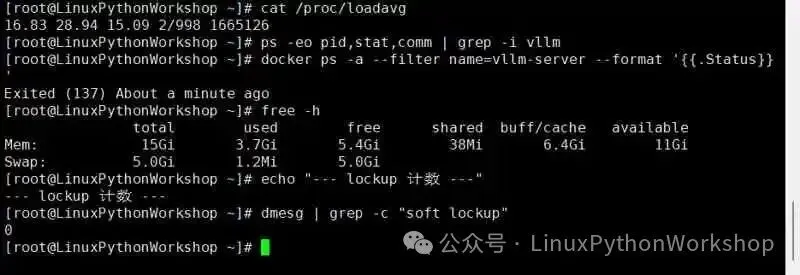
图 17:loadavg 16.83 已开始回落,ps | grep vllm 为空,容器 Exited (137),soft lockup 计数为 0。
[root@LinuxPythonWorkshop ~]# ps -eo pid,stat,comm | grep -i vllm[root@LinuxPythonWorkshop ~]# docker ps -a --filter name=vllm-server --format '{{.Status}}' Exited (137) About a minute ago[root@LinuxPythonWorkshop ~]# dmesg | grep -c "soft lockup" 0
三个结果放在一起,把两件事彻底分开了:
soft lockup | 0 | |
docker kill | 假成功VLLM::Worker 又活了 11 分钟 | 真成功Exited (137) + 进程表清空 |
load | ||
| 容器自杀,系统 2 分钟自动恢复 |
💡
docker kill这次能杀掉,本身就是最硬的证据。上次那个
VLLM::Worker从 16:42 活到 16:53,是因为它卡在不可中断的D状态,信号投递不进去。这次它在用户态,信号一投就死。同一个命令,两种结果,说明卡住的位置根本不同。
于是两个根因可以明确分开了:
| 错误一 | D 状态杀不掉、整机假死 | ||
| 错误二 | load |
这是整轮排查最重要的结构。 在修好错误一之前,错误二的表现被错误一掩盖了——你看到一个 74 的 load,根本分不清是"虚拟化层卡死"还是"内存不够"。
顺便:错误二的账怎么算
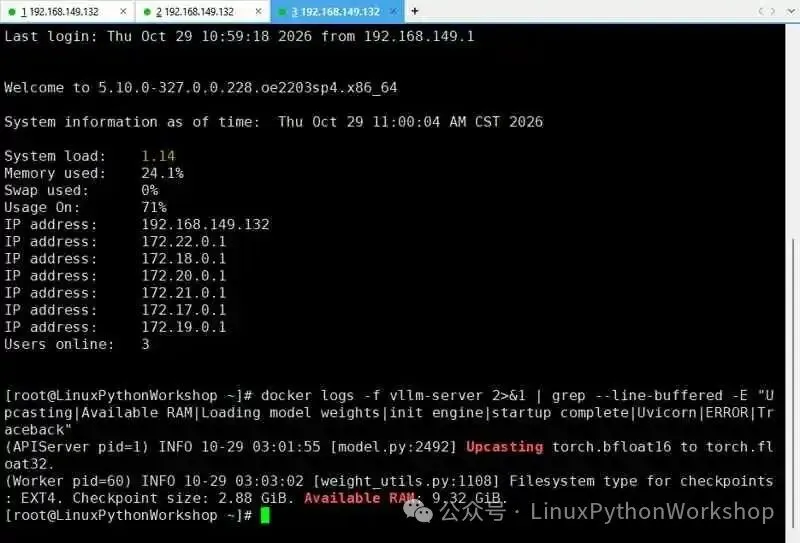
图 18:Available RAM: 9.32 GiB 这行日志是现成的输入——它比"权重多大"更能决定成败。
Available RAM: 9.32 GiB 这行日志是现成的输入。再算一遍:
| 两者同时驻留的瞬时峰值 | 8.63 GiB |
KVCACHE_SPACE=1) | |
| 合计 | ~11.1 GiB |
| 实际可用 | 9.32 GiB |
| 缺口 | 约 1.8 GiB |
⚠️ 两张表别直接相减:03 节按整机算(含系统 1.0 + 容器 3.4,不含 checkpoint 文件页),本节按容器内算(含 checkpoint 页 2.88,不含系统与容器)。换算:12.6 − 4.4 + 2.88 ≈ 11.1。
而崩溃点在第 450 秒——正好是 2.88 GiB ÷ 6.4 MB/s ≈ 7.5 分钟 读完权重的时刻。这不是巧合,是算术:读完的瞬间,文件页还在缓存里,而 fp32 张量开始构建,两份同时驻留,撞上 1.8 GiB 的缺口。
⚠️ 修正一个常见说法:网上常说"加载模型需要 2 倍权重的内存"。更准确的说法是
checkpoint 文件大小 + fp32 张量大小。因为 checkpoint 本身可能是 bf16(2.88 GiB),而运行时张量是 fp32(5.75 GiB),两者不是同一个数。按"2×权重"算会得到 5.76 GiB,低估了近 3 GiB。
顺便记一条方法论:修复前后各跑一次 dmesg | grep -c "soft lockup"。dmesg 只保存本次启动的日志,重启后计数清零,所以这个差值就是本次修复的净效果。
到这里账已经算清了:1.5B 需要 11.1 GiB,可用只有 9.32 GiB,缺口 1.8 GiB。
补这个缺口有两条路:停掉 Dify 腾出 3.4 GiB,或者换更小的模型。我选了后者,理由很实际——停 Dify 要动生产环境,换模型只要下一个 1 GB 的文件。
内存预算:先算,再动手
| 0.5B | ||
|---|---|---|
| 0.92 GiB | ||
| 1.96 GiB | ||
| 2.88 GiB | ||
| 合计 | 11.1 GiB | ~5.2 GiB |
0.5B 需要的 5.2 GiB,在 7.21 GiB 可用下余量 2 GiB。 这次不会触发页回收死循环。
下载:顺手拿到一个关键数字
docker run --rm -v /root/.vllm/models:/root/.cache/modelscope \ --entrypoint python vllm-openai-cpu:day12 \ -c "from modelscope import snapshot_download; print(snapshot_download('Qwen/Qwen2.5-0.5B-Instruct'))" 11 个文件、共 943M,耗时 3 分 06 秒:
Downloading: 100%|██████████| 11/11 [03:06<00:00, 16.94s/file] /root/.cache/modelscope/models/Qwen--Qwen2.5-0.5B-Instruct/snapshots/master 📖 初学者讲解:下载完一定要 ls -lh 确认 model.safetensors 的完整大小。中断的下载最容易在权重文件上留下"看起来存在、实际只有几 MB"的残缺文件,而这种文件会让 vLLM 报出与实际原因毫无关系的错误。
ls -lh /root/.vllm/models/models/Qwen--Qwen2.5-0.5B-Instruct/snapshots/master/ total 954M -rw-r--r-- 1 root root 659config.json -rw-r--r-- 1 root root 242generation_config.json -rw-r--r-- 1 root root 1.6Mmerges.txt -rw-r--r-- 1 root root 943M model.safetensors ← 权重 -rw-r--r-- 1 root root 7.2K tokenizer_config.json -rw-r--r-- 1 root root 6.8M tokenizer.json -rw-r--r-- 1 root root 2.7M vocab.json
一个小坑:容器名冲突
docker: Error response from daemon: Conflict. The container name "/vllm-server" is already in use by container "a81adff0dbe66...". 上一轮被刹车杀掉的容器虽然 Exited (137),但容器名仍然被占用。Docker 要求名字全局唯一,已停止的容器也占名。
修正:启动前先删。
docker rm -f vllm-server 2>/dev/null 💡 为什么是
-f而不是普通的docker rm:普通rm要求容器处于停止状态才肯删;-f会先发 SIGKILL 再删。这里旧容器已经Exited,两者都能用,但-f更省事。前提是旧容器不在
D状态——在的话-f也会卡住,那就得先重启系统。
启动参数:只改四处
docker run -d --name vllm-server \ --network lpw-ai -p 8000:8000 \ --ipc=host \ --cpus=4 --memory=9g --memory-swap=9g \ --security-opt seccomp=unconfined --security-opt label=disable \ --cap-add SYS_NICE \ -e VLLM_TARGET_DEVICE=cpu \ -e VLLM_CPU_KVCACHE_SPACE=1 \ -e OMP_NUM_THREADS=4 \ -e PYTHONUNBUFFERED=1 \ -v /root/.vllm/models:/root/.cache/modelscope \ --entrypoint vllm \ vllm-openai-cpu:day12 \ serve /root/.cache/modelscope/models/Qwen--Qwen2.5-0.5B-Instruct/snapshots/master \ --host 0.0.0.0 --port 8000 \ --dtype float32 \ --max-model-len 2048 \ --max-num-seqs 4 \ --enforce-eager Qwen--Qwen2.5-1.5B-Instruct | Qwen--Qwen2.5-0.5B-Instruct | |||
--memory | 12g | 9g | ||
--max-model-len | 512 | 2048 | ||
--max-num-seqs | 1 | 4 |
后两项放宽是有意的:1.5B 那次把上下文压到 512、并发压到 1,是为了"能在最小配置下起来";这次内存充足,要验证的是"能不能实用"。
全文最重要的判据转折:load 26.77 但 D=1
启动后按 15 秒一次采样,得到了这组数据:
11:24:56 load=1.22 R=— D=0 code=00011:25:58 load=1.75 R=— D=0 code=00011:27:52 load=15.83 R=— D=1 code=00011:29:51 load=16.17 R=— D=2 code=00011:30:43 load=26.77 R=15 D=1 code=00011:31:09 load=20.13 R=8 D=1 code=00011:31:43 load=24.69 R=5 D=2 code=00011:32:23 load=25.72 R=10 D=1 code=00011:33:13 load=25.94 R=13 D=0 code=00011:33:55 load=27.19 R=5 D=1 code=000
如果你只看 load,这十行数据会让人得出"卡死了,赶紧杀"的结论——load 一直在 20~27,远超我为它设的 25 阈值。
但把 load 拆成 R 和 D 之后,性质完全变了:
load | ||
D(不可中断睡眠) | 6 且持续增长 | 0~2,无增长趋势 |
R |
D 只有 0~2,说明没有 I/O 等待堆积。 那 20~27 的 load 全部来自 R 状态的线程——它真的在算,不是在等。
⚠️ 这是整篇文章最该记住的一条:
load高本身不是故障,D任务堆积才是。
load把R(运行中)和D(不可中断睡眠)加在一起统计。前者代表"在干活",后者代表"在等 I/O 卡住"。同一个数字,两种截然相反的含义。判断方法只要一行:
bash echo "R=$(ps -eo stat | awk '$1 ~ /^R/' | wc -l) D=$(ps -eo stat | awk '$1 ~ /^D/' | wc -l)"
R多、 D≤ 2 → 正在算,继续等D≥ 5 且递增 → 真的卡住了,该杀 我的刹车脚本只设了
load ≥ 25这一条阈值。按这个阈值,11:30:43的load=26.77就会把它杀掉——而那一刻正是它做最后一次 warmup 前向的时刻,差 6 分钟就成功了。
这一段是"差点误杀"的完整现场。阈值本身没错,错的是用了一个含义模糊的指标做阈值。
时间账:12 分 40 秒
import torch | 1 分 09 秒 | |
| 约 2 分 45 秒 | ||
| 约 8 分 06 秒 | ||
| 总计 | 12 分 40 秒 |
最后那 8 分钟是 warmup。它比"加载权重"本身还长 3 倍,这是最反直觉的一点:
无 AVX512-BF16 的 CPU 上,vLLM 的启动耗时不由模型体积决定,而由 warmup 决定。
warmup 要做一次完整的前向计算,耗时 ≈
模型参数 × 上下文长度 × 线程数三者共同决定,而且 float32 比 bf16 慢一个量级。
一次差点被误判的探测时机
采样循环跑完 6 次(11:33:55)时全部是 code=000,看起来像"跑了 10 分钟还是失败"。
但服务实际在 11:36:36 才就绪——比最后一次探测晚了 2 分 41 秒。
2026-10-29T03:36:35 INFO: Waiting for application startup. 2026-10-29T03:36:36 INFO: Application startup complete. 💡 教训:
000只代表"此刻端口还没监听",不代表"永远不会监听"。探测循环必须有足够长的窗口,而且不能因为窗口用完就下结论。判断"还在加载"还是"已经失败",靠的是
docker ps的状态和日志时间戳,不是curl的返回码。
验收
curl -s -o /dev/null -w "code=%{http_code}\n" --max-time 10 http://127.0.0.1:8000/v1/models code=200 
图 19:code=200,端口通了。
curl -s http://127.0.0.1:8000/v1/models | python3 -m json.tool | head -30 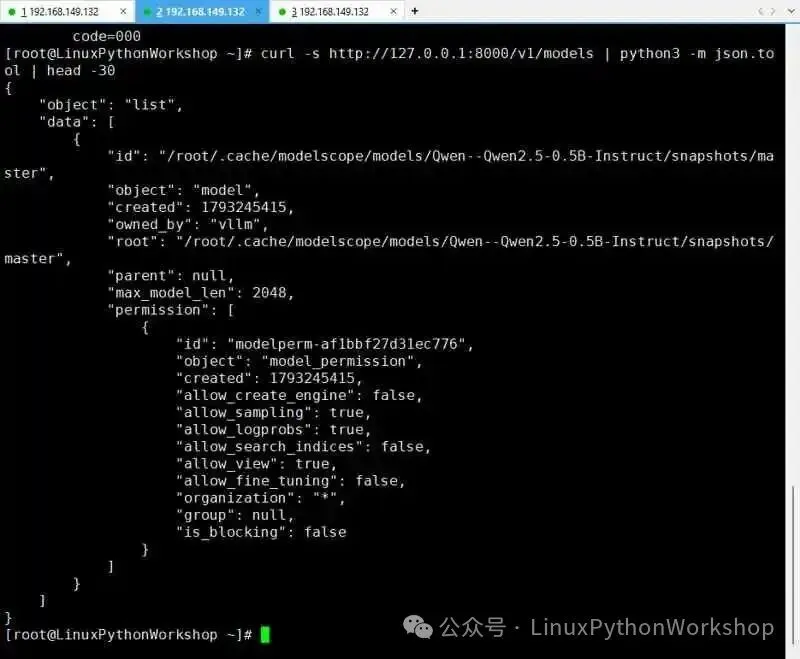
图 20:/v1/models 返回完整信息。max_model_len: 2048 说明参数正确生效;id 是绝对路径,因为用本地快照启动时模型名就是路径本身。
{ "object": "list", "data": [{ "id": "/root/.cache/modelscope/models/Qwen--Qwen2.5-0.5B-Instruct/snapshots/master", "object": "model", "owned_by": "vllm", "max_model_len": 2048, "permission": [{"allow_sampling": true, "allow_logprobs": true, ...}] }] } 三个字段各自印证一件事:
owned_by | vllm | |
max_model_len | 2048 | --max-model-len 2048 |
id |
预算验证:内存峰值落在预期区间
跑通之后回头看,最关键的不是"通了",而是实际内存峰值是否落在预算内。
Available RAM | 7.21 GiB | |
预算 5.2 GiB、可用 7.21 GiB、余量 2 GiB —— 没有触发页回收死循环。 这反向确认了 1.5B 的失败纯粹是那 1.8 GiB 缺口,而不是别的模糊原因。
💡 这就是"先算账、再动手"的价值:不是猜"应该够吧",而是算出
5.2 < 7.21再动手;跑完再核对实际值是否落在区间内。对比前面三次失败——每次都是"先试,试了再说",于是每次都要花 10 分钟以上才知道行不行。
速度实测:首次 262 秒,稳态 4.3 秒
接口通了之后,最后一步是测真实速度——这一步差点让我得出完全相反的结论。
第一次请求:
curl -s http://127.0.0.1:8000/v1/chat/completions \ -H 'Content-Type: application/json' \ -d '{"model":".../Qwen--Qwen2.5-0.5B-Instruct/snapshots/master","messages":[{"role":"user","content":"你好"}],"max_tokens":16}' \ -w "\n耗时=%{time_total}s\n" 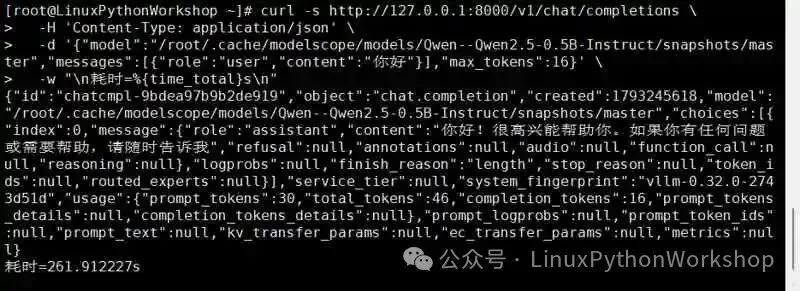
图 21:choices 正常返回,但末尾那行 耗时=261.912227s 让人心凉——16 个 token 用了 4 分 22 秒。
按这个数字算:16 ÷ 261.9 = 0.061 token/s。当时我几乎就写下"工程上不可用"了。
幸好又跑了一次:
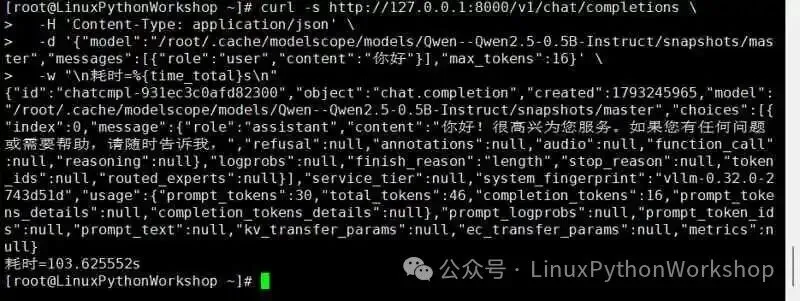
图 22:同一请求第二次 103.625552s,比第一次少 158 秒——差值就是冷启动成本。
再跑五次,答案就完全不同了:
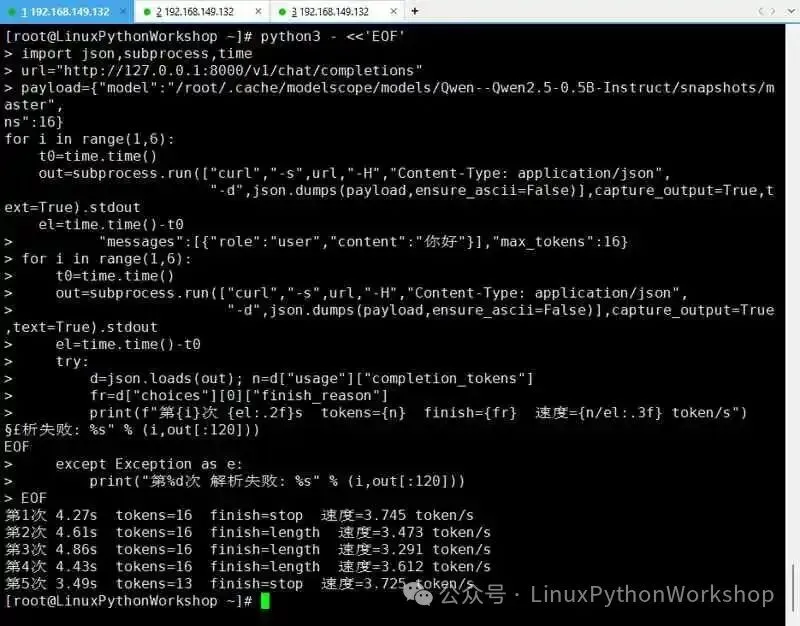
图 23:五次连续测试,用 python 直接解析 usage.completion_tokens 算准确速度——不能只看耗时,必须同时知道生成了几个 token。
第1次 4.27s tokens=16 finish=stop 速度=3.745 token/s第2次 4.61s tokens=16 finish=length 速度=3.473 token/s第3次 4.86s tokens=16 finish=length 速度=3.291 token/s第4次 4.43s tokens=16 finish=length 速度=3.612 token/s第5次 3.49s tokens=13 finish=stop 速度=3.725 token/s
稳态稳定在 3.3~3.7 token/s,五次波动不超过 15%。
| 4.3~4.9 s | 3.3~3.7 | 页缓存全命中 |
从 0.061 到 3.5,差 57 倍。 同一个模型、同一条命令、同一个 16 token 的输出。
⚠️ 这是本文最容易犯的统计错误,也是最值钱的一条:
测推理速度必须跑多次取稳态,而且必须同时记录
completion_tokens。两个陷阱叠在一起: 1. 拿首次请求当速度 → 把冷启动成本摊进每 token,低估 57 倍 2. 只看耗时不看 token 数 → 如果模型只生成 4 个 token 就停了,4 秒的耗时会被误算成 1 token/s
正确做法(就是上图那段):
python for i in range(1, 6):t0 = time.time()out = subprocess.run(["curl","-s",url,"-H","Content-Type: application/json","-d",json.dumps(payload,ensure_ascii=False)],capture_output=True, text=True).stdoutel = time.time() - t0d = json.loads(out)n = d["usage"]["completion_tokens"]print(f"第{i}次 {el:.2f}s tokens={n} 速度={n/el:.3f} token/s")
慢的到底是什么:不是算力,是 I/O
这五次数据把前面所有推测都校正过来了:
startup complete | I/O | |
| I/O | ||
| 稳态推理 | 4.3 秒 / 16 token | 算力(3.5 token/s) |
算力其实是够的。慢的全部是 I/O 冷启动。
这跟 05 节那个发现完全自洽:import torch 53 秒、本地虚拟盘 6.4 MB/s ≈ 网络下载 5.68 MB/s。943 MB 的 safetensors 按 6 MB/s 读,就是 157 秒——正好对上第一二次请求之间那 158 秒的差值。
💡 所以 ⑫ 真正的结论是:vLLM CPU 版在这台机器上可用(稳态 3.5 token/s),但首次成本极高(启动 12 分 40 秒 + 首答 262 秒),适合长期常驻,不适合用完就停。
对比一下两种选型:
| 3.5 token/s | 约 13 分钟 | ||
稳态差 3~6 倍,冷启动差 20 倍以上。
所以选择取决于场景:
- 常驻服务
(一天用几十次)→ 13 分钟的启动成本可以摊薄,vLLM 能用 - 随手一问
(一天用两三次)→ Ollama 明显更合适,vLLM 每次冷启动都亏
顺带记下版本:
system_fingerprint: vllm-0.32.0-2743d51d。不同版本对启动日志和参数语义有差异(老版本用--model,新版本用serve <path>位置参数),排查时先确认版本。
最后看一眼系统健康度
跑完这一串之后,R/D 依然是健康的:
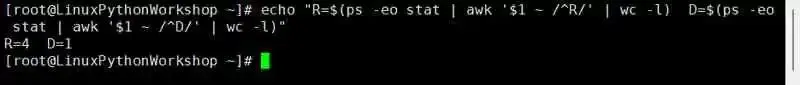
图 24:R=4 D=1。4 个线程在跑、1 个任务在等 I/O,与 OMP_NUM_THREADS=4 一致——围栏与线程限制都正常工作。
整机没有出现任何 soft lockup,也没有 D 状态堆积。 这次是真的"跑起来了",不是"把系统拖垮了"。
跑通了,但结论不是"上就完了"。四条经验,按重要度排。
结论一:先算账,再动手
内存必须按这个公式估:
峰值 = checkpoint 文件大小 + fp32 张量大小 + KV 缓存 + 运行时 而不是"权重 × 2",也不是"权重 × 1"。以 1.5B 为例:
| 合计 | 约 11.1 GiB |
按"2×权重"算会得到 5.76 GiB——低估了将近 3 GiB,而这 3 GiB 恰好是决定成败的部分。
结论二:容器围栏能挡 OOM,挡不住虚拟化层
--cpus=4 --memory=9g --memory-swap=9g 的价值在两次失败里体现得很清楚:
docker kill |
围栏不是万能护身符,但它是"失败可恢复"的前提。 没有它,第一次崩溃就要强制重启。
结论三:这类机器的正解是 Ollama + GGUF 量化
把实测数字摆在一起,不用形容词:
| 11.1 GiB | |||||
| 静默降级,端口永不监听 | |||||
| 3.5 token/s | 约 13 分钟 | ||||
| Ollama + Q4 量化 | ~1.0 GB | ~2 GiB | 10~20 token/s | 数十秒 |
五个差别值得说清楚:
其一,内存差一个数量级。 同一个模型,GGUF Q4 约 1GB,float32 要 5.75GB。
其二,启动路径短得多。 Ollama 加载 GGUF 是"打开一个文件、顺序读、映射进内存",没有 import torch 这一步。而这台机器上 import torch 要 53 秒,vLLM 的 warmup 还要再花 8 分钟——Ollama 把这两块全省了。
其三,首次成本差 20 倍。 vLLM 从启动到首答可用要 13 分钟;Ollama 加载约 1 GB 的 GGUF 只需数十秒。对"一天用两三次"的场景,这个差距是决定性的。
其四,稳态也差 3~6 倍。 3.5 token/s vs 10~20 token/s,长回答的体验差距明显。
其五,不依赖内核级绑核。 vLLM CPU 后端要用 SYS_NICE 调线程优先级、绑定核、开 --ipc=host。这些在虚拟机里恰恰是最容易被 hypervisor 调度策略打乱的部分。Ollama 用普通线程池,容错性高得多。
结论四:vLLM 不是"更专业",是"目标场景不同"
vLLM 的核心优势全都在 GPU 上:
搬到无 GPU 的虚拟机里,它的优势全部失效,只剩下"启动路径长、依赖多、warmup 慢"的负担。
一句话
单机单流推理用 Ollama + GGUF;vLLM 留给有 GPU、要高并发的场景。
这不是"vLLM 不行",是用错了工具——等于拿 F1 赛车去送外卖:技术上能到,但油钱和保养费高得离谱。
No CUDA driver | -cpu 镜像(1.76GB vs 8.8GB) | |
avx512_bf16,bf16 静默降级 | --dtype float32Upcasting ... to torch.float32 | |
load 冲到 53 后容器自杀 | ||
docker kill | D | ps -eo pid,stat,comm 双向确认 |
\r 原地刷新,不产生新行 | ||
Conflict. The container name is already in use | docker rm -f vllm-server |
补充一:load 高要拆成 R 和 D 看
这条差点让我把已经跑通的容器杀掉:
echo "R=$(ps -eo stat | awk '$1 ~ /^R/' | wc -l) D=$(ps -eo stat | awk '$1 ~ /^D/' | wc -l)" RD ≤ 2 | 继续等 | |
D | ||
DR 低、load 低 |
load 把 R(运行中)和 D(不可中断睡眠)加在一起算。同一个数字,两种截然相反的含义。
补充二:日志相关的坑
docker logs -f vllm-server 2>&1 | grep -E "startup complete" 会输出空白——但不是没有日志。grep 的标准输出接到管道(非终端)时会启用块缓冲(默认 4KB),日志行要攒够 4KB 才刷出来。vLLM 一分钟才输出几百字节,所以你永远等不到。
docker logs -f vllm-server 2>&1 | grep --line-buffered -E "startup complete" 补充三:vllm --version 会卡住,改用 pip show
docker exec vllm-server vllm --version 这条命令会挂住几十秒甚至更久,看起来像死机。
原因是 vllm 这个 CLI 入口在解析参数之前就会 import vllm,连带 import torch——在这台机器上光 import torch 就是 53 秒。再加上 docker exec 非交互执行时 Python 的 stdout 是块缓冲,输出要攒够 4KB 才刷,所以即使算完了也可能不显示。
改用只读元数据、不加载任何模块的方式,秒出:
docker exec vllm-server pip show vllm | head -3 Name: vllm Version: 0.32.0+cpu Summary: A high-throughput and memory-efficient inference and serving engine for LLMs 💡 通用规律:想知道某个 Python 包的版本,用
pip show而不是包名 --version。前者读dist-info元数据,后者要加载整个包。这条在 I/O 慢的机器上差别是"1 秒"和"1 分钟"。
补充四:Exited (137) 有三种来源,别一看就以为 OOM
整个排查过程中 Exited (137) 出现了两次,但原因完全不同。137 = 128 + 9,即被 SIGKILL 终止,而 SIGKILL 可能来自三个地方:
OOMKilled | |||
|---|---|---|---|
| true | |||
docker stop | 正常 | ||
docker kill | 正常 |
一条命令区分:
docker inspect vllm-server --format 'OOMKilled={{.State.OOMKilled}} ExitCode={{.State.ExitCode}} Error={{.State.Error}}' OOMKilled=false ExitCode=137 Error= OOMKilled=false 就说明不是内存问题。
💡 为什么
docker stop会让 vLLM 超时:vLLM 收到 SIGTERM 后要销毁EngineCore子进程、释放全部 fp32 张量和 KV 缓存(本例约 5 GB)。在 I/O 慢、内存回收慢的机器上,10 秒根本不够,于是被 SIGKILL。这不是 bug,是默认 timeout 太短——想让它优雅退出可以加-t 30:
bash docker stop -t 30 vllm-server
一、选择题(每题4个选项)
1. 判定 CPU 版 vLLM 镜像的口诀是?
A. 仓库名带 latest
B. 仓库名带 -cpu
C. 镜像小于 2GB
D. 标签带 x86_64
2. CPU 不支持 bf16 时,vLLM 的实际表现是?
A. 抛出 Unsupported dtype 立即退出
B. 静默降级为软件模拟,不报错、端口永不监听
C. 自动切换到 fp16
D. 拒绝启动容器
3. 加载 1.5B 模型(bf16 checkpoint + float32 运行时),内存峰值应该如何估算?
A. 等于权重体积
B. 约 1.5 倍权重体积
C. checkpoint 文件大小 + fp32 张量大小 + KV + 运行时
D. 固定 8GB
4. 进程处于 D 状态时,docker kill 会怎样?
A. 立即终止
B. SIGKILL 投递不进去,kill 是"假成功"
C. 触发 OOM
D. 自动重启容器 【答案提示】见 03 节教训二。
5. 排查"虚拟机一跑重活就整机假死",最该先确认的是?
A. 磁盘 SMART 状态
B. VMware Tools 是否安装、时间是否同步
C. 内存条频率
D. 网卡驱动版本
6. load 冲到 27、但 D 任务只有 1 个,说明什么?
A. 系统即将崩溃
B. 正在计算,不是卡死
C. 磁盘 I/O 阻塞
D. 内存溢出
二、填空题(3 题)
1. 判断"容器还在正常加载权重"的可靠信号是内存的 ______ 速率,而不是日志末行时间。
2. docker logs -f | grep 看不到内容时,需要加 ______ 参数解除管道块缓冲。
3. 判断容器是"在算"还是"在等",应把 load 拆成 __ 和 ____ 两个状态分别计数。
三、简答题(1 题)
在 8 核 / 15GiB 的虚拟机上做本地推理,你的选型是什么?请给出两条理由。
🎁 答对粉丝福利:
将答案按顺序发至评论区, 全部答对的前50位粉丝,将获得:
✅ 赠送完整的《21天工具链实验手册 》
#vLLM #Ollama #GGUF #CPU推理 #虚拟化 #VMwareTools