ARTICLE · 1292210
端侧AI工具链原理(08):Code Generation、ISA与Kernel库:AI编译器怎样真正落到硬件
本文是端侧 AI 工具链原理第 8 篇。上一篇完成量化与混合精度,这一篇继续 Lowering:高层 MatMul 和 Attention 怎样变成循环、Tile、DMA、指令与可加载资产。
开篇:编译器识别了 MatMul ,离硬件执行还有多远
一个高层 MatMul 只描述数学关系:
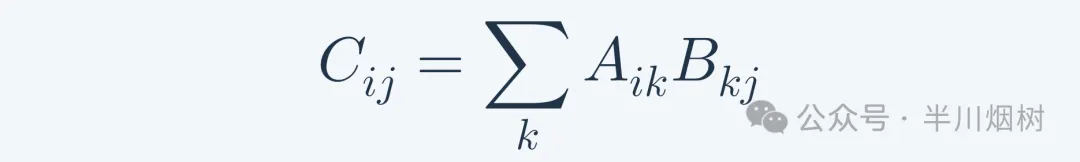
硬件需要明确 Tile 大小、Buffer 地址、Layout、DMA 顺序、阵列指令、累加精度、同步和边界处理。Code Generation 的任务,是把“算什么”变成“何时、在哪里、以什么数据组织执行”。
一、 Lowering 是一系列语义收缩
典型过程:
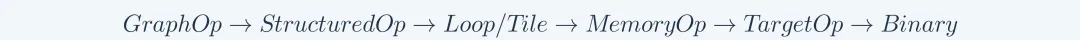
高层 IR 适合做算子融合和代数变换;中层 IR 适合 Tiling 、 Vectorization 和 Bufferization ;低层 IR 承担指令、寄存器、地址和同步。
过早 Lowering 会丢失图语义,过晚 Lowering 则难以表达目标硬件限制。
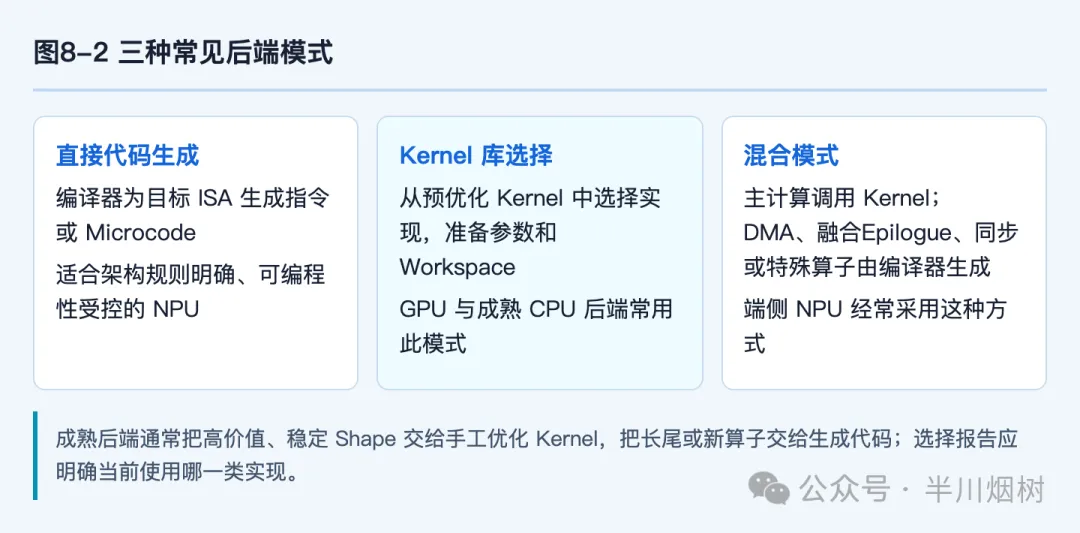
二、三种常见后端模式
直接代码生成
编译器为目标 ISA 生成指令或 Microcode,适合架构规则明确、可编程性受控的 NPU 。
Kernel 库选择
编译器从预优化 Kernel 中选择实现,准备参数和 Workspace。GPU 与成熟 CPU 后端常用此模式。
混合模式
主计算调用 Kernel,DMA、融合 Epilogue、同步或特殊算子由编译器生成。端侧 NPU 经常采用这种方式。
三、 ISA 必须表达计算之外的能力
AI 加速器 ISA 通常需要:
如果 ISA 只强调 MAC,编译器会被迫用大量指令拼接搬运和控制,吞吐单元反而等待。
四、指令选择需要匹配 Shape
同一个 MatMul 可用大 Tile Tensor 指令、小矩阵 Kernel 或 Vector GEMV。选择可写成:

候选 Kernel 的适用域必须显式记录。离线 Autotune 得到的最佳 Kernel 也要带设备、频率、Compiler 和 Shape 版本,避免误用。
五、循环变换怎样映射硬件
MatMul 循环可对M/N/K分块,并决定:
Loop Interchange 改变访问顺序,Unroll 增加并行和代码体积,Vectorization 映射 Lane,Software Pipeline 重叠 DMA 与 Compute。每项变换都要受寄存器和 SRAM 约束。
六、边界 Tile 不能被忽略
当M不是 Tile 大小M_t的整数倍时,有三种方法: Padding、Mask 或专用 Tail Kernel。
Padding 计算浪费率近似为:
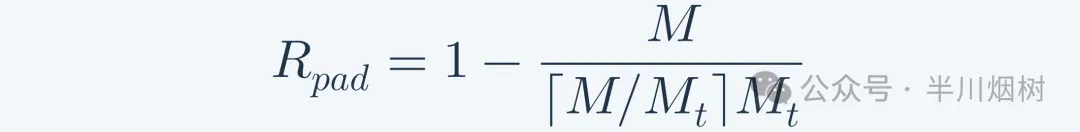
Mask 减少无效结果但可能降低硬件效率;Tail Kernel 提高利用率却增加代码和调度复杂度。端侧常见的小 Shape 使 Tail 策略非常重要。
七、 Kernel ABI 是编译器与 Runtime 的接口
Kernel 至少需要定义:
ABI 不稳定会让编译资产与 Runtime 强绑定。产品化工具链应提供版本检查和兼容策略,而不是加载后才产生难懂的设备错误。
八、代码体积也是端侧约束
为每个 Shape、精度和融合组合生成专用 Kernel 可以提高性能,却导致 Binary 膨胀、加载变慢和指令 Cache 压力。
可将目标写为:
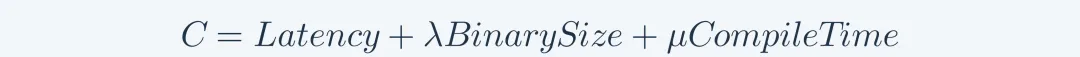
Shape Bucket 、参数化 Kernel 和共享 Epilogue 都是性能与资产体积之间的折中。
九、后端验证需要多层 Reference
若只在真机看最终输出,地址、同步和数值问题会混在一起。
十、一个 MatMul 后端时间线
对C=A B,假设A为[256, 1024]、B为[1024, 4096],选择M_t=64、N_t=128、K_t=64。后端为每个输出 Tile 生成:
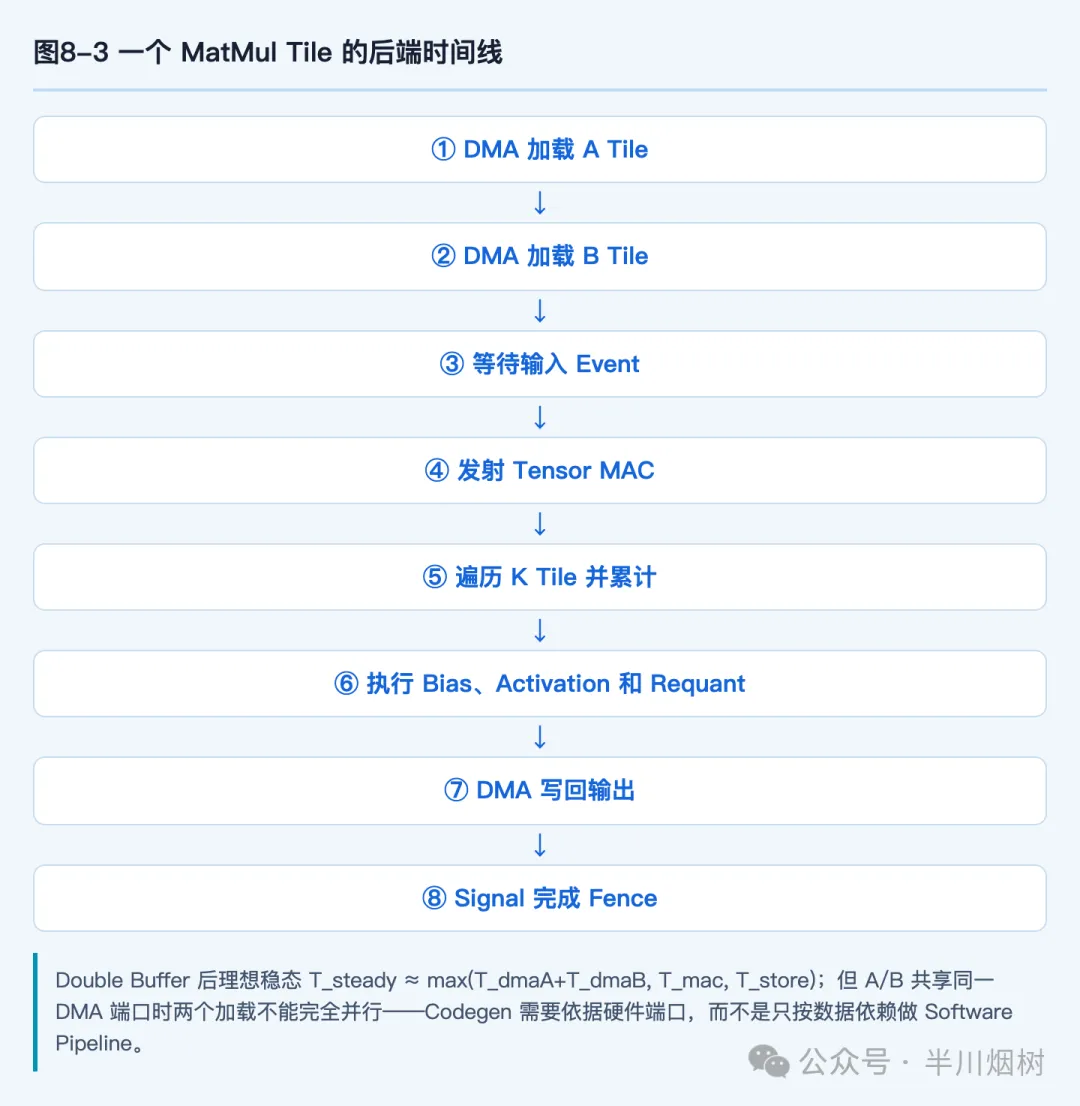
Double Buffer 后,理想稳态为当前 Tile 计算时预取下一 Tile :
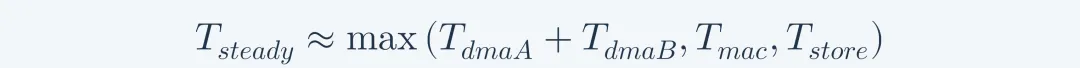
但如果 A/B 共享同一 DMA 端口,两个加载不能完全并行;如果 Epilogue 占用 Vector 端口并与下一 Tile 地址生成冲突,实际周期还会出现气泡。Codegen 需要依据硬件端口,而不是只按数据依赖做 Software Pipeline。
十一、 Kernel 库的适用域怎样表达
一个 Kernel 条目不仅是函数指针,还应包含:
Kernel 选择失败时,应说明哪项 Constraint 不满足。否则用户看到的只是“选择 Generic Kernel”,无法知道怎样修改模型 Shape。
十二、 ISA 设计如何影响 Compiler 复杂度
过于固定的指令可在目标 Pattern 上高效,却让新算子需要复杂分解;过于通用的指令降低 Codegen 限制,却增加 Decode 、控制和面积。
评审一条新指令时,至少问:
新指令的价值可以粗略写为:
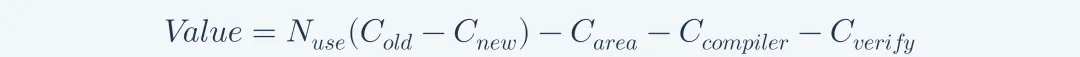
十三、后端错误怎样分层定位
后端必须保留可缩小到最小失败 Command Stream 的工具,否则完整模型问题很难复现。
十四、 Attention 怎样 Lower 到 Tensor 与 Vector 单元
高层 Attention 包含 QK MatMul、Scale、Mask、Softmax 和 PV MatMul。朴素 Lowering 为五组独立 Kernel,Score 写回外部内存。融合 Lowering 则按Q行与K/V块遍历,在片上维护在线 Softmax 状态。
每个 Block 维护最大值m、归一化和l与输出累计o。处理新块时更新:
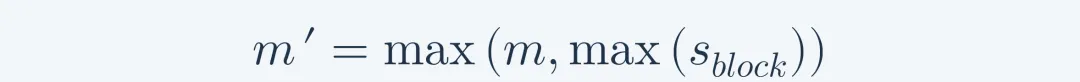
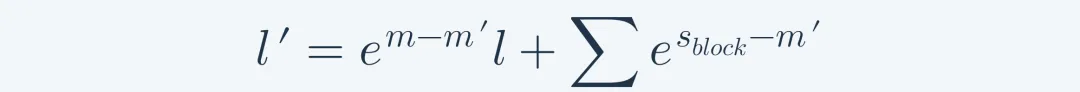
Tensor 单元完成 QK/PV,Vector 单元完成 Max、Exp、Reduce 和归一化, Scalar 负责循环与地址。ISA 需要支持跨单元同步和本地状态保持。
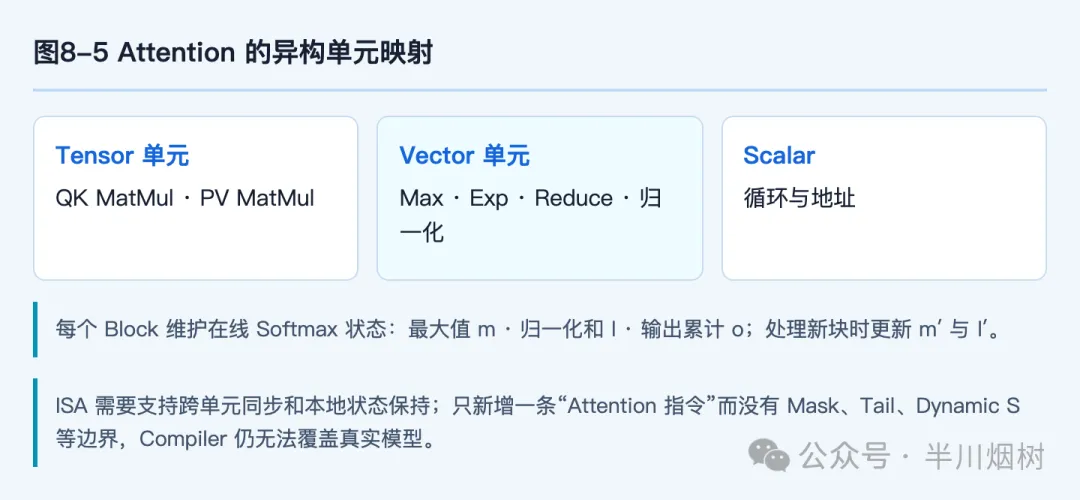
后端还要处理 Mask、Tail Sequence、Head 维对齐、不同精度和 Dynamic S。只新增一条“Attention 指令”而没有这些边界,Compiler 仍无法覆盖真实模型。
十五、代码生成质量指标
这些指标应关联回原始 Operator 和 Shape,才能指导模型与微架构共同优化。
十六、寄存器分配为什么会反向改变 Tile
Tensor Tile 不仅占 Local SRAM,地址、循环变量、Vector 中间值和 Accumulator 还占寄存器。Fusion 加入更多 Epilogue 后,Live Value 增多,寄存器不足会 Spill 到 Local Memory 甚至外部内存。
若每个 PE/线程可用寄存器为R_max,计划需求为:
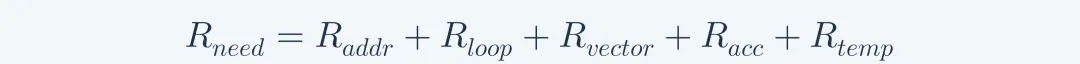
必须满足R_need ≤ R_max。低层寄存器分配发现 Spill 后,应把 Pressure 反馈给高层:减小 Tile、拆 Epilogue、降低 Unroll 或改变 Vector 宽度。
单向 Lowering 只能在低层被动插入 Spill,可能让 Cost Model 的高层预测完全失效。
十七、多核 MatMul 与 Reduction 怎样生成
MatMul 可按M或N切分,每核生成独立输出,无需 Reduction;按K切分时,每核只得到 Partial Sum,必须合并。
设P核按K并行,输出 Tile 大小为B_C,Reduction 通信至少与:
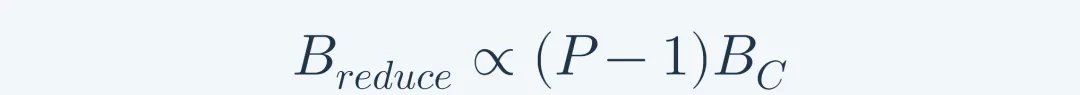
相关。优势是K很大时提高并行度,代价是 NoC 流量、 Barrier 和 Accumulator 存储。
Codegen 需要选择 Tree Reduce、Ring 或集中式合并,并生成:本地计算、写入共享 Buffer、Barrier、读取/累加和最终写回。若 NoC 不支持高效 Collective,按K切分可能比单核更慢。
十八、 DMA Codegen 需要理解多维布局
AI Tensor 通常不是一段连续内存。DMA 描述符可能需要 Base、Width、Height、Stride、Plane 和 Repeat。Blocked Weight 还涉及 Packed Layout 。
对二维区域,每行有效W字节、源 Stride 为S、高度H,传输有效字节为WH,但总地址跨度为:
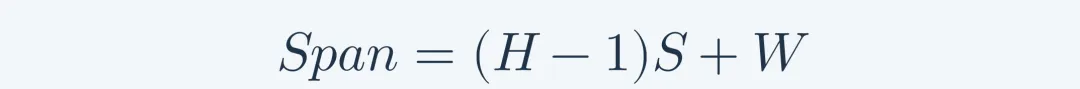
如果 DMA 不支持目标 Stride,Compiler 需要分行命令或先 Repack。分行会增加 Descriptor 和启动,Repack 会增加内存。Layout Assignment 必须考虑 DMA 能力,而不只考虑计算 Kernel。
十九、 Compiler 、 Driver 与 Firmware 的 Command ABI
目标 Binary 或 Command Stream 需要版本化 Schema:Opcode、Buffer Handle、Offset、Shape、依赖、Profile Tag 和错误语义。至少包含:
Compiler 生成新 Command 前先查询 Capability;Driver 拒绝不兼容 Major; Firmware 对长度和地址做验证。依赖“版本号碰巧相同”无法保证安全加载。
二十、 Kernel 库和生成代码如何共存
成熟后端通常把高价值、稳定 Shape 交给手工优化 Kernel,把长尾或新算子交给生成代码。二者共享 ABI、Layout 和测试。
生成 Kernel 经过 Profile 达到阈值后可晋升为库实现;库 Kernel 无法覆盖新硬件或 Shape 时回退生成路径。这样既保留快速适配,也保留关键路径性能。
选择报告应明确当前使用哪一类实现。否则性能回归时,团队不知道是调度变化还是 Kernel 来源变化。
二十一、从模拟器到真机的后端发布门禁
后端验证应沿着语义逐步收缩,而不是把所有失败都留给整网真机测试。
第一层验证 Lowering 前后 IR 等价,覆盖边界 Shape、Dynamic Shape 和非法输入;第二层在 ISA Simulator 中逐指令比较 Accumulator、Rounding、Saturation 和异常;第三层运行 Kernel 级真机测试,检查 DMA、Bank Conflict、Barrier 和 Tail Tile;第四层才进入整网与系统压力测试。
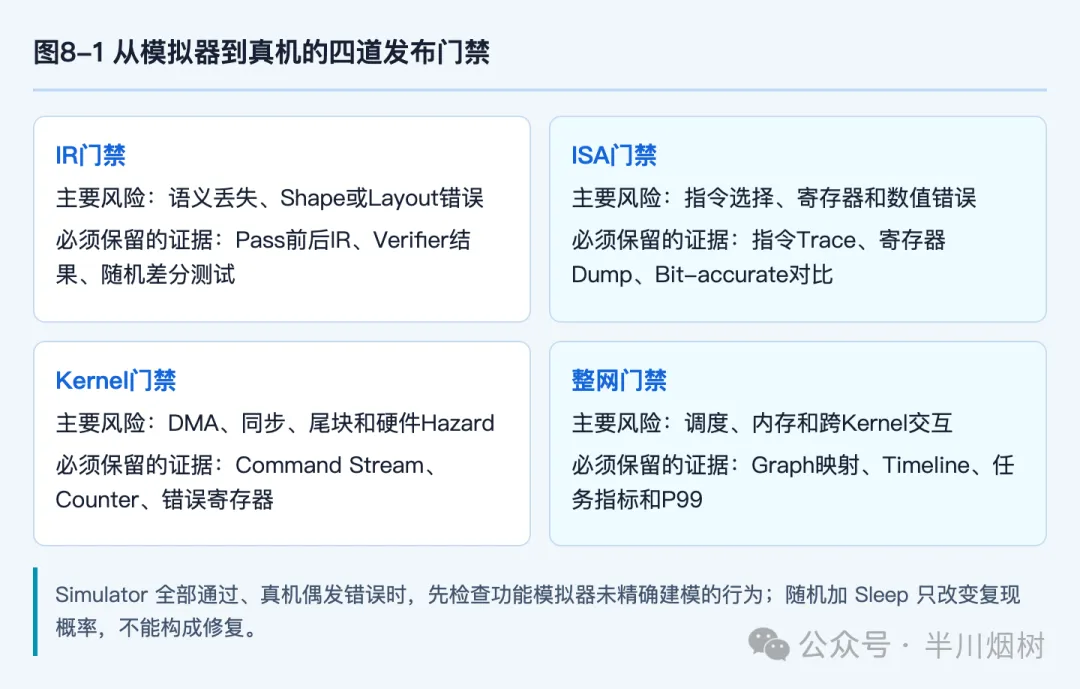
一个常见陷阱是 Simulator 全部通过,真机偶发错误。此时应优先检查未被功能模拟器精确建模的行为:异步 DMA 完成时序、Cache 维护、 Barrier 参与核数、地址 Alignment、命令队列回绕和硬件 Revision 差异。随机增加 Sleep 只能改变复现概率,不能构成修复。
发布产物还需绑定 Compiler Commit 、 ISA/Command ABI 、 Kernel 库版本、 Firmware 最低版本和 Capability 集合。 Driver 加载时验证这些信息,不兼容则明确拒绝或重新编译。后端只有同时具备数值正确、性能达标、错误可定位和版本可回滚四项能力,才算从实验性代码生成器走向量产工具链。
工程检查清单
结尾:后端的质量体现在细节能否闭环
Code Generation 不是把算子名称换成指令名称。它要在有限 Buffer、离散 Tile、异步 DMA 和目标 ISA 之间构造可验证的执行计划,并把这份计划通过稳定 ABI 交给 Runtime。
下一篇转向运行时:Delegate 怎样接管子图,CPU、GPU 和 NPU 怎样同步,所谓零拷贝又需要哪些前提。
参考资料
参考链接
[1] MLIR Linalg Dialect: https://mlir.llvm.org/docs/Dialects/Linalg/
[2] MLIR Vector Dialect: https://mlir.llvm.org/docs/Dialects/Vector/
[3] LLVM Code Generator: https://llvm.org/docs/CodeGenerator.html
--------------------------------
我是半川
一个偏爱在芯片底层与光影算法里死磕细节的工程师