ARTICLE · 1294354
Ai链的中短期未来(1)
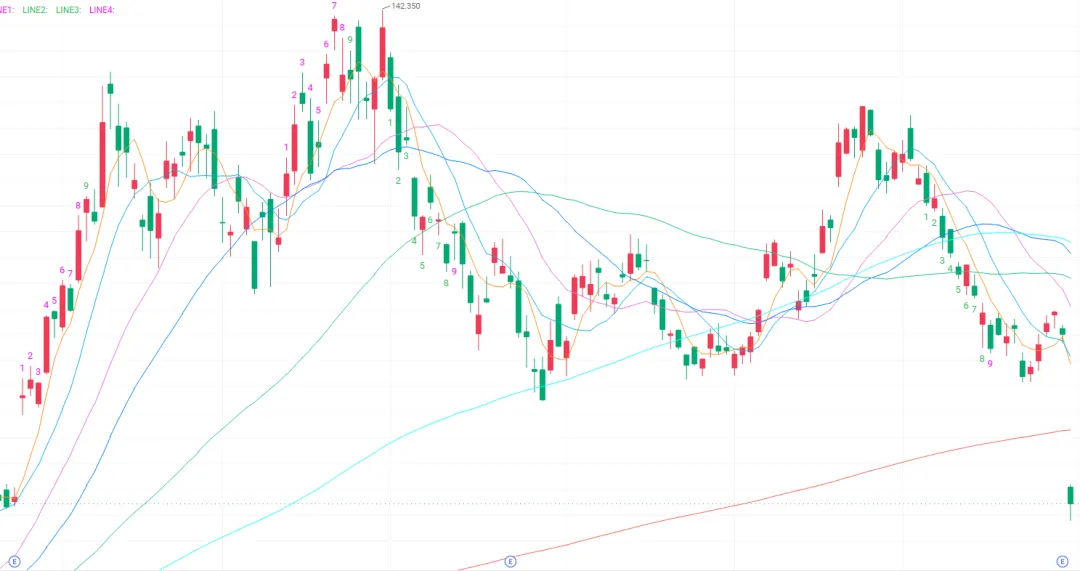
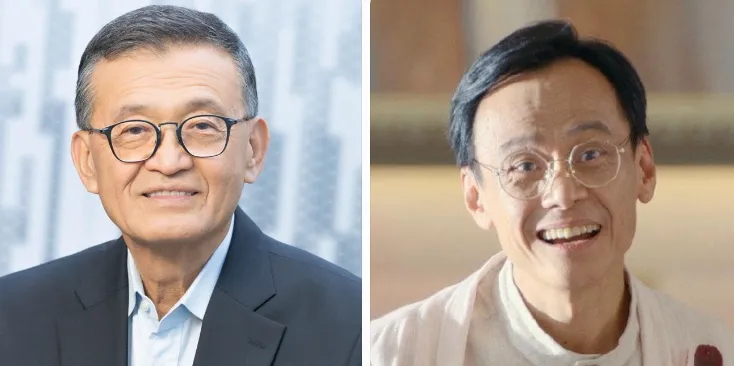
2021年的时候老黄说未来GPU会有大作为,Ai时代的真正接口,随后市场领先定价,甩了个-70%。最开始这个故事是智星讲给我听的,深以为然,但是感受不深,毕竟是过去发生的事情。今年6月份,陈立武接受采访的时候说道,过去14个月intel创造了约6倍回报,而未来5-10年的目标是实现10倍回报,这个采访我是全听完的,好嘛,从他采访到现在已经-55%了,似乎离着NV-70%还有差距,但是看过往发生的故事和自己见证确实感受不一样。
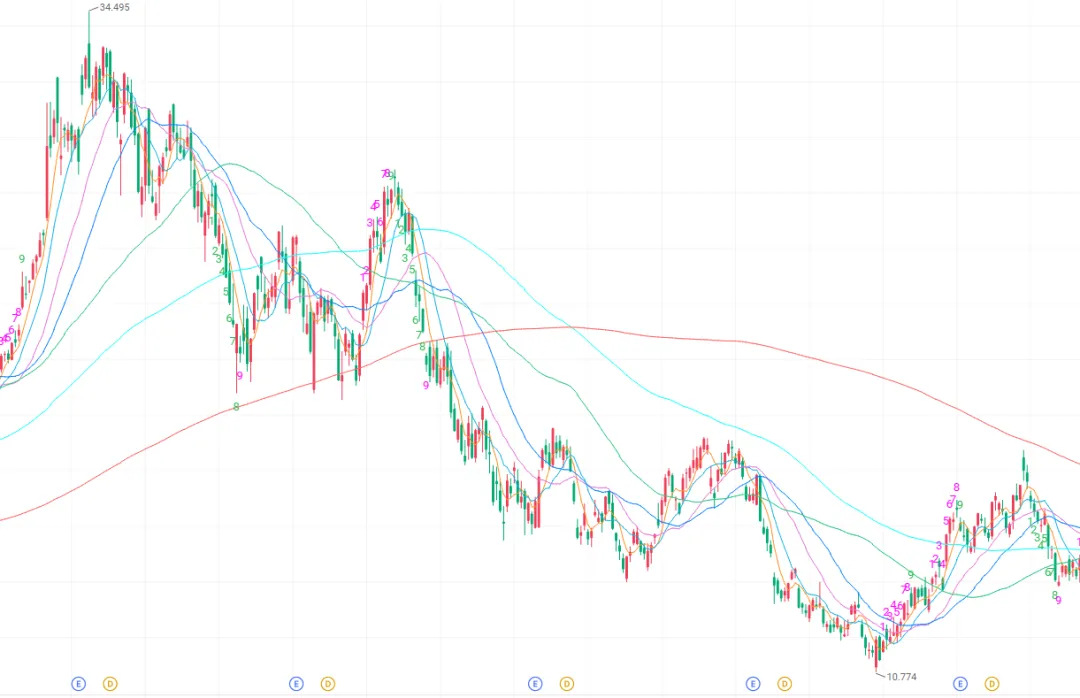
说回intel,上个周工程师在播客里提到了一个问题,说是虽然大家对GPU,CPU和HBM产能有预期,但是上游ASML的EUV供应是有限的,所以实际上就是芯片厂在博弈谁拿到更多的EUV谁就有更多可出售产能,然后再是fabless抢这些产能,也就是说实际上产能预期是有限的,不是砸钱就能堆起来的,2026年就是给10万亿的capax,EUV也得从头产,产线也得从头调试,不是钱多就能解决的事,泡泡马特可以半年让labubu月产能翻3倍,ASML的EUV可不能。这里就有一个很恐怖的领先定价问题了,也就是说即使ai发展的再快,27,28乃至29年,芯片产业链上的产能实际上是固定的?
基于这个推论,让gemini和grok帮我交叉验证和讨论了一下。
讨论AI算力时,我们习惯从订单、服务器和数据中心往回看,却很少继续追到晶圆制造更前面的环节。再往上走,就会遇到ASML的EUV光刻机。它的年产量并不大,交付节奏也很难在短期内改变。如果先进芯片都绕不开这道工序,那么下游再旺盛的需求,最终也要受到它的约束。
不过,这个判断还不能直接成立。一台AI服务器不只有GPU,还需要HBM、CPU和大量闪存。只有弄清楚这些芯片分别消耗什么设备、消耗多少晶圆,才能把“光刻机可能构成瓶颈”变成一项可以检验的测算。下面是我沿着这个问题做的一次推导。
先把一个前提弄清楚:存储也在这场竞争里
我最初也容易把光刻机和先进逻辑芯片直接画等号,觉得存储只是规则重复的阵列,对先进光刻的依赖应该低得多。但把DRAM和NAND分开看,情况并不一样。
类型 | 代表产品 | 工艺演进的主要方向 | 对光刻设备的依赖 |
DRAM | DDR5、LPDDR5X、HBM | 继续做平面微缩,进入1α、1β、1γ等节点,缩小存储单元和晶体管尺寸 | 先进节点越来越依赖EUV,否则多重曝光带来的误差和成本很难控制 |
NAND | 企业级SSD、手机存储 | 转向3D垂直堆叠,通过增加层数提高密度 | 基本不需要EUV,主要使用成熟DUV,更关键的约束在刻蚀和薄膜沉积 |
在较早的DRAM节点上,厂商还能用浸没式DUV加多重曝光继续推进。进入1β、1γ以后,边缘放置误差逐渐逼近工艺能够容忍的范围,三星、SK海力士和美光才开始更多采用EUV。也就是说,HBM所依赖的先进DRAM,并不是游离于EUV供给之外的另一套体系。
HBM还有两个容易被忽略的特点。其一,它通过TSV把多层DRAM裸片叠在一起,硅通孔和冗余设计会占用额外面积,生产同样容量的内存,消耗的晶圆明显多于普通DRAM;其二,到了下一代产品,底部Base Die还会转向先进逻辑工艺,进一步分享原本用于GPU、CPU的制造资源。
所以,AI芯片的供给不能只看台积电能造多少GPU。逻辑和存储实际上在同一个先进设备池里竞争,而HBM的需求越大,这种竞争就越明显。
有了单机产能,才有讨论总量的基础
接下来需要回答一个更具体的问题:一台EUV光刻机一年究竟能支持多少芯片?这里不能简单拿设备标称吞吐量乘以小时数,还要考虑停机维护、工艺剂量和不同芯片的曝光层数。
我采用了一组偏量产场景的估算:全年稼动率82%,对应约7,183小时有效工时;高剂量曝光下平均每小时处理约125片晶圆。两者相乘,一台设备一年约完成90万次曝光。注意,这是“曝光次数”,还不是可以直接出货的晶圆数。
用途 | 代表芯片与工艺 | 单片晶圆EUV层数 | 一台EUV对应的年产能 |
先进逻辑 | GPU、CPU,先进逻辑节点 | 约20~22层 | 约4.1万片晶圆,折合约98万颗双Die旗舰GPU |
先进DRAM | HBM3e、HBM4相关节点 | 约6~8层 | 约12.8万片晶圆,折合约320万颗12层HBM堆栈 |
3D NAND | 企业级SSD | 0层 | 不占用EUV,产能约束在别的设备环节 |
这组数字的意义,不在于给出一条精确到个位的产额定值,而在于建立量级关系:同样一台设备,用于逻辑和用于DRAM,能够支撑的晶圆量相差数倍;NAND则不应被算进EUV瓶颈。后面所有估算,都建立在这几个假设上。假设变化,结果也应跟着调整。
再看全球存量。按这条估算路径,EUV累计保有量从2022年的约175台,增加到2025年的约310台;如果交付计划顺利,2026年约380台,2027年约470台,2028年约585台。设备仍在持续增加,真正需要追问的是:其中有多少能够用于AI?
真正需要看的,不是380台,而是其中多少能为AI所用
把全部存量都算作AI产能,会明显高估供给。台积电的大量设备要服务苹果、手机SoC和PC芯片,也要留出先进节点调试的空间;英特尔的设备主要服务自有CPU和工艺研发;三星则还受到良率与利用率的影响。存储厂商同样要兼顾手机、PC和普通服务器内存。
另外,英伟达、AMD和博通本身并不持有光刻机。真正需要拆分的,是台积电、三星、英特尔,以及三家存储原厂的设备用途。按2026年约380台存量做一项分配估算,可以得到下面这张表。这里的“有效机队”不是厂商披露值,而是为了测算而扣除消费类产品、研发和良率折损后的假设。
环节 | 厂商 | EUV总数 | 主要非AI用途或折损 | AI有效机队 |
逻辑 | 台积电 | 205台 | 苹果、手机与PC芯片,以及新节点调试 | 50台 |
逻辑 | 三星代工 | 40台 | 手机芯片、图像传感器逻辑层及良率爬坡 | 2台 |
逻辑 | 英特尔 | 38台 | PC处理器、服务器CPU与工艺研发 | 3台 |
逻辑合计 | — | 286台 | — | 55台 |
存储 | 三星存储 | 48台 | 手机与PC内存、工艺切换及良率折损 | 11台 |
存储 | SK海力士 | 35台 | 消费级DRAM、新机安装调试 | 20台 |
存储 | 美光 | 11台 | 新工艺爬坡与消费级内存 | 4台 |
存储合计 | — | 94台 | — | 35台 |
全行业 | — | 380台 | — | 90台 |
这里最值得讨论的,也许不是某一家到底分到几台,而是“产能能否随时搬过去”。短期看并不容易。GPU设计绑定特定代工厂的工艺库,跨厂迁移通常需要较长周期;消费端订单也不能无条件取消。因此,这张表更适合被理解为当前供给结构的一张快照,而不是固定不变的配给方案。
注:刚看到这个数据有点懵,英特尔用于生产数据中心用cpu的EUV竟然只有3台?也难怪PC业务萎缩结果股价跳空大跌,似乎很合理,毕竟副业没起来,主业先崩了
把光刻机折算成数据中心,短板才显现出来
有了设备端和分配端的估算,还需要一个需求单位。我选择1GW数据中心,因为它可以把GPU、HBM、CPU、网络和存储放到同一个物理模型里。按约6,500个全液冷机柜估算,一座这样的数据中心大致需要:
部分 | 主要配置 | 12英寸晶圆需求 | EUV占用 |
逻辑计算 | GPU约46.8万颗、CPU约23.4万颗,另有交换芯片和网卡 | 约3.34万片,占12% | 0.82台·年 |
内存 | HBM约374.4万颗,并配置服务器主内存 | 约17.5万片,占65% | 1.36台·年 |
闪存 | 企业级SSD约3.75EB | 约6.25万片,占23% | 不占用EUV |
算到这里,最出乎我意料的是晶圆结构:DRAM占65%,远高于逻辑芯片的12%。舆论关注GPU,是因为单颗GPU价值高、供给紧张;但从晶圆消耗看,AI数据中心同时也是一座巨大的内存工厂。
把需求端和设备端放在一起,逻辑端的55台有效EUV,理论上可以支撑约67.1GW;存储端的35台,却只能支撑约25.7GW。真正的短板因此落在HBM及先进DRAM,而不是GPU晶圆本身。
25.7GW不是一个保证能够实现的产量目标,而是在既定配比、稼动率和设备分配假设下得到的边界估算。没有HBM配套,额外生产的GPU也无法组成可交付的AI服务器,所以不能用逻辑端的67.1GW来代表整个系统的能力。
如果进一步从手机和PC端挤压产能,这个边界当然会移动。按同一模型,较激进的再分配可以把上限推到约36.8GW,极端情况下约45.6GW。但这只是设备端的算术,CoWoS先进封装、TSV刻蚀与键合等环节还要同步扩张,往往需要额外时间。把消费端产能看作随时可以调用的余量,同样会高估短期供给。
最后,再谈资本开支和公司收入
做到这一步,才适合把投资金额放进来。按前面的物料配比估算,一座1GW数据中心的IT设备采购约288.1亿美元,加上电力和土建后,总投入约423.1亿美元。
项目 | 包含内容 | 金额(亿美元/GW) |
计算与内存芯片 | GPU、HBM、DDR5和CPU | 约205.85 |
机柜、网络与闪存 | 液冷及电源套件、光模块与交换设备、企业级SSD | 约82.25 |
IT设备合计 | 完整算力集群 | 288.10 |
电力与土建 | 高密液冷机房及配套基础设施 | 135.00 |
数据中心总投入 | IT设备加电力与土建 | 423.10 |
上游设备参考(另列) | 约2.18台EUV及配套刻蚀、薄膜设备,不计入上述总投入 | 约23.12 |
于是可以用423.1亿美元/GW,把设备端边界换算成投资端边界,再与现实中的AI基建支出对照。严格说,云厂商资本开支和全球全口径AI基建并不是完全相同的统计口径,所以这里更适合观察量级和趋势,不宜机械地计算一个“产能利用率”。
年份 | 设备模型对应的全球上限 | 全球AI基建支出估算 | 如何理解 |
2025 | 约6,516亿美元,对应15.4GW | 约5,500亿~6,000亿美元 | 支出已接近模型给出的边界 |
2026 | 约10,874亿美元,对应25.7GW | 约9,000亿~10,000亿美元 | 供需余量已经很小,瓶颈开始显现 |
2027E | 约18,024亿美元,对应42.6GW | 预测约1.45万亿~1.75万亿美元 | 即使采用较乐观预期,也仍在设备边界内 |
2028E | 约27,078亿美元,对应64.0GW | 预测约1.8万亿~2.2万亿美元 | 光刻机约束缓和后,电力与投资回报可能接棒成为瓶颈 |
作为参照,美国五大云巨头2026年资本开支估算约为7,940亿~8,000亿美元,2027年的市场预期大致落在1.1万亿~1.4万亿美元。把这些数字和设备模型放在一起,我更愿意得出的结论是:行业正在接近某些硬约束,而不是所有开支都会无摩擦地转化为算力。
收入测算则应该更谨慎。每1GW数据中心的IT采购中,扣除机柜、光模块和存储模组等部分,真正流向芯片设计公司的金额约226.4亿美元。再按各家公司占用的代工与HBM资源做分配,可以得到一个“上限压力测试”:
公司 | 主要产能来源 | 2026营收估算 | 2027E上限情景 | 2028E上限情景 |
英伟达 | 台积电AI产能及主要HBM供给 | 约2,600亿美元 | 4,600亿~4,900亿美元 | 5,800亿~6,500亿美元 |
AMD | 台积电AI与PC产能、HBM | 约500亿美元 | 680亿~750亿美元 | 950亿~1,100亿美元 |
博通 | 定制ASIC、网络芯片相关产能 | 约750亿美元 | 950亿~1,050亿美元 | 1,200亿~1,350亿美元 |
英特尔 | 自有EUV,以PC和服务器CPU为主 | 约540亿美元 | 580亿~630亿美元 | 630亿~700亿美元 |
高通 | 台积电消费电子相关产能 | 约440亿美元 | 460亿~490亿美元 | 490亿~530亿美元 |
这些区间不是盈利预测,更不是目标市值。它们假设设备供给能够被充分利用,却没有完整计入封装、电力、建设进度和客户需求变化,因此更适合作为营收上沿的参照。实际结果完全可能低于表中的数字。
回到最初的问题
绕了一圈,对“光刻机能否决定AI算力上限”的答案,反而比开始时更克制。它不是唯一的瓶颈,也无法单独决定某家公司下一年的收入;但它提供了一条相对清晰、可以持续校验的供给边界。
这套测算真正有帮助的地方,是把几个原本分开讨论的环节连了起来:ASML交付多少设备,设备如何分配,一座数据中心消耗多少逻辑与DRAM晶圆,最后再对照资本开支和公司收入。哪一项假设发生变化,结论就应当重新计算。
因此,后续值得跟踪的并不只是云厂商又增加了多少预算,还包括EUV实际交付、存储厂先进DRAM的设备分配、HBM与先进封装的同步扩产,以及数据中心能否拿到电。比起一个看似精确的上限数字,这些变量之间的关系,可能更接近AI算力供给的真实情况。
说明:文中设备数量、产能配比、投资金额和营收区间均整理自一组产业模型估算,部分为约数或情景假设,并非厂商指引;文章用于研究讨论,不构成投资建议。