ARTICLE · 1300558
1200 Star 的安卓 App,让 AI 在另一块屏上替你操作手机
1200 Star 的安卓 App,让 AI 在另一块屏上替你操作手机
手机上总有些事,自己做嫌烦,交给别人又不放心。翻完一个几百条的群聊,看今天都聊了什么。在招聘网站按条件翻岗位,挨个打招呼。在外卖软件里凑满减,算到正好减五块。这些动作都不难,加起来能吃掉半小时。
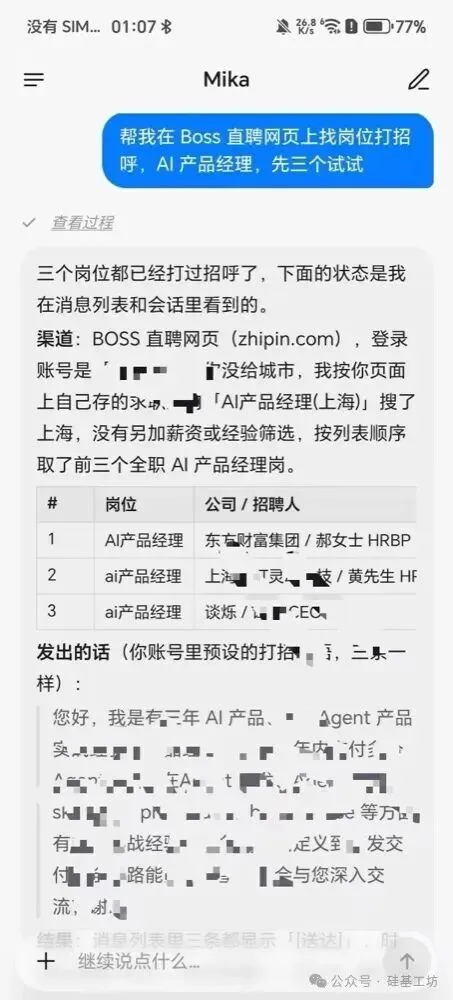
AI 陪你聊这些事没问题,但它看不见你的屏幕,也点不动你的按钮。一个叫 Mika 的开源项目想补上这一段。你在对话里说一句话,它在一块你看不见的屏上把 App 打开、读界面、点按钮、输入文字,你照常刷自己的手机。
项目 10 月 29 日创建,两天多涨到 1240 Star,Apache-2.0 许可。作者是中文开发者,README 中英双语,演示里出现的全是国内 App。
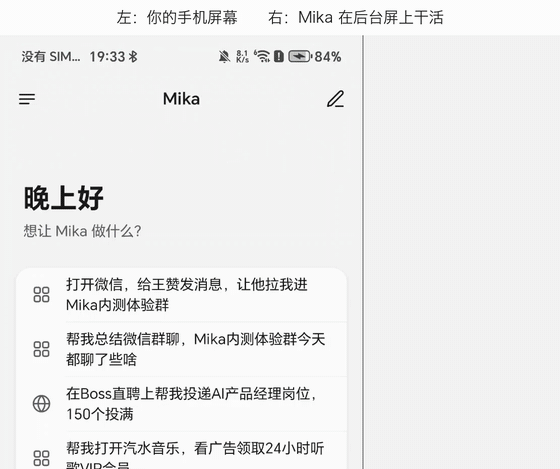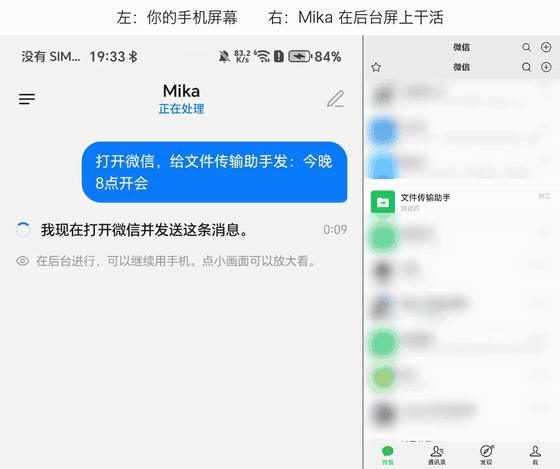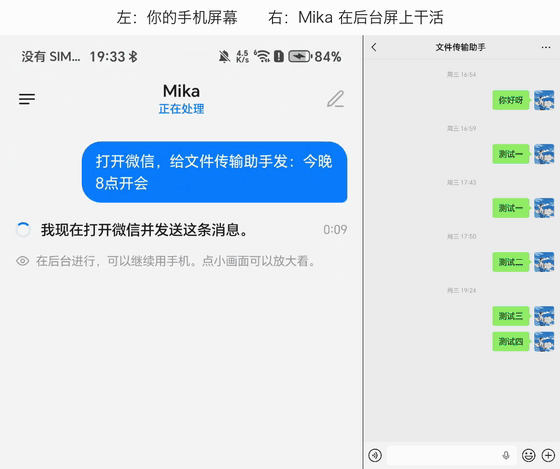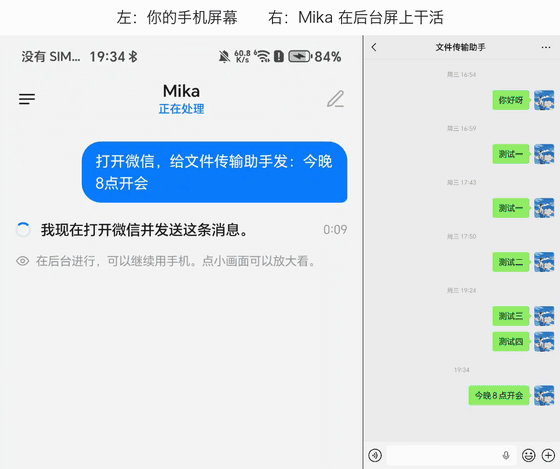
它到底能干什么
一句话交代任务,Mika 在手机上替你办。
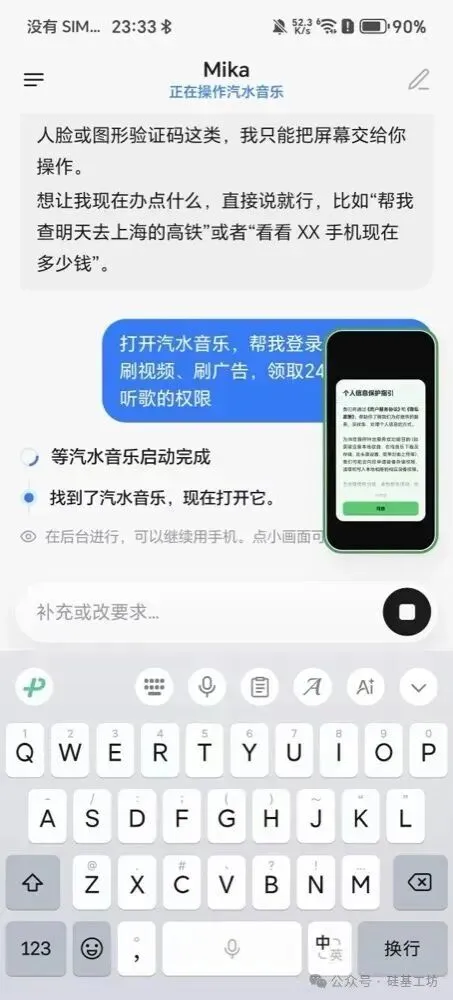
一块看不见的屏是怎么来的
安卓的虚拟显示不算新东西,难点在于让一个普通应用在里面启动别的应用、读到界面、点到按钮。
Mika 的路径是内置一个手机助手,让它以 shell 身份运行。这个助手通过手机自己的无线调试启动,配对一次就行。ADB 协议是作者自己实现的,代码在 core/adb/ 下。
配对这一步做得很细。配对码可以让无障碍服务从系统设置页自动读出来,也可以填进一条高优先级通知里,通知会浮在系统配对窗口上方,八秒、二十秒、四十秒各弹一次,最多三次。配对失败时,引导页会按读到的开发者选项和无线调试状态,指出最可能出问题的那一步,而不是一直转圈。
连上之后还有一层麻烦,无线调试的端口是系统随手分的。它按顺序试五个来源。先试上次连上过的端口,再读系统属性,然后用 mDNS 查本机端口,接着扫一遍本机临时端口段,最后才轮到你手填。扫描用非阻塞连接,同时最多两百个在连,每个最多等一百五十毫秒,全部加起来不超过十秒。
还有个容易被忽略的细节,目标 App 在后台屏上会响。Mika 把它的 PLAY_AUDIO 设为 ignore 来静音。静音前是什么模式,会记在一份账本里。助手启动时先恢复上一轮没来得及恢复的,你接管时声音也回得来。
Android 13 上,虚拟屏还可能短暂抢走主屏的焦点。Android 14 起虚拟屏有自己的焦点,不影响你在主屏打字。这也是它推荐 14 的原因。
三个能力,一个执行入口
仓库分成两个 Gradle 模块。:core 是纯 Kotlin,主循环、工具、上下文、记忆、触发都在里面,不依赖安卓,能在电脑上用单元测试和假模型跑。:app 是安卓宿主,界面、前台服务、虚拟屏、无障碍、WebView、沙箱都在这边。
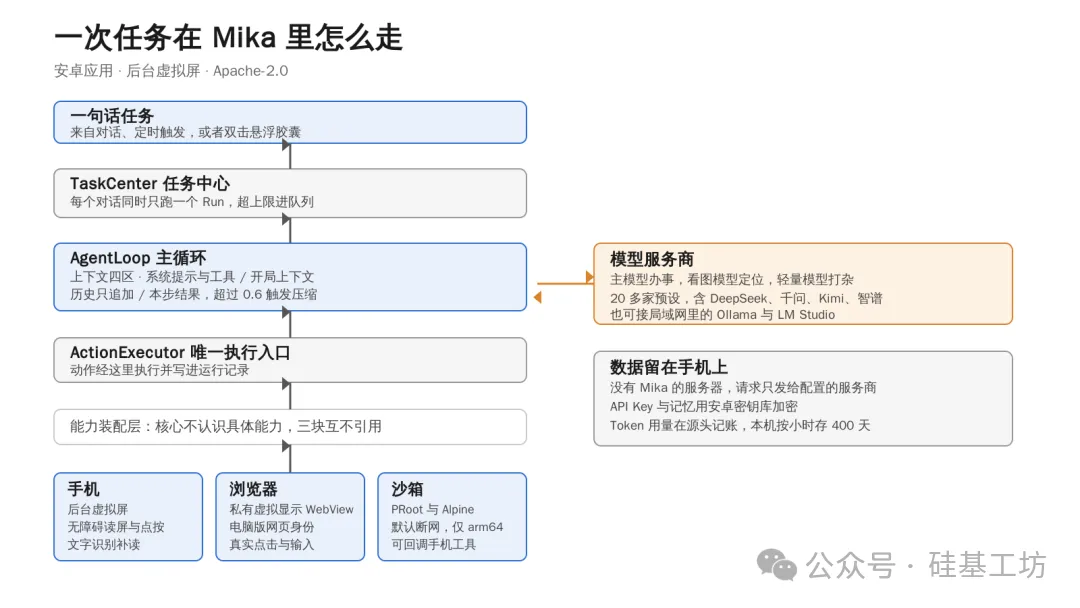
能力被切成三块,手机、网页、沙箱。三块互不引用,核心也不认识具体能力,只有装配层同时认识它们。所有动作走同一个执行入口 ActionExecutor,做完写进运行记录。仓库里有个 PackageDependencyTest,专门守住这条依赖方向,防止哪天有人图省事直接调用。
这套结构带来的好处在扩展上。加一个新能力只需要在装配层注册,主循环不用改;工具变多时,可以只给模型一份筛过的工具目录,用到再加载完整定义,免得固定前缀越撑越大。
上下文怎么不爆
手机 agent 的上下文压力比聊天大得多,每一步都要塞进一屏的界面读数。
Mika 把上下文分成四个区。区 0 是系统提示词和工具定义,一个任务内只在展开一组工具时变动。区 1 是开局上下文,写一次不改,里面放以前的对话、记忆与画像、任务原话、App 和网站知识、技能索引。区 2 是历史,只追加。区 3 是本步的结果、画面和运行时状态,附在最后一条消息末尾。
压缩在估算输入超过模型上下文 0.6 的时候触发,压到触发线的一半以下,留出回差避免连着压。压缩不调模型,先把最近十二轮之前的旧结果缩短,旧的界面读取换成占位,再把旧轮次折叠成一段「Earlier steps」。用户说过的话从不裁剪,压完由 ContextRecovery 把缺掉的用户消息和开局上下文补回原位。
一个有意思的取舍,主循环写给模型的文字一律用英文,跟系统提示词、工具说明保持一致,免得模型跟着中文上下文用中文回答。给用户看的文字还是按界面语言来。
沙箱为什么值得单说
大多数手机 agent 到「点按钮」就停了。Mika 带了一个 PRoot 加 Alpine 3.22 的运行环境,随 APK 发布,App 启动时在后台离线解包,升级后自动重解。
每个对话一个工作区,跨消息保留,聊天里附的文件进 /workspace/inbox/,产出用 share_file 存到手机下载目录。默认断网,要联网得在设置里单独打开,每个任务还有累计运行时间预算,同一条命令反复失败会被叫停。
更巧的是回调。沙箱里的命令可以用 mika phone 调当前任务的手机工具,每次命令运行一个随机名字的本地套接字和一次性令牌,开放哪些工具由工具自己声明。于是「写个脚本批量处理文件,处理完再回手机界面点两下确认」这类任务,可以在一个流程里跑完。
模型随便挑,账自己记
内置的服务商预设超过二十家,国内的 DeepSeek、通义千问、Kimi、智谱、硅基流动、火山方舟、MiniMax、阶跃星辰、腾讯混元、百度千帆都在列表里,海外的 OpenRouter、Anthropic、Gemini、OpenAI、xAI 也在。自定义可以接任何 OpenAI 兼容、Anthropic、Gemini 端点,局域网里的 Ollama 和 LM Studio 填个地址就行,Key 都可以不填。
模型分三种用途。主模型办事,要求支持工具调用;看图模型负责描述界面、看图定位;轻量模型处理判断结局、提取记忆这类小事。保存服务商之前,它会真的发起一次带工具的调用试通,试不过会说清是哪一步没过。这套验证最多试三个模型,通过的当主模型。
隐私设计是加分项。没有 Mika 的服务器,你的话、屏幕内容、截图只发给你自己配的那家服务商。API Key 和记忆用安卓密钥库加密存在手机上,对话、运行记录、Token 用量都只在本机。每次模型调用在源头记账,按小时存四百天,设置里能看按服务商、按模型叠起来的趋势。
怎么装,怎么用
三步。
然后就可以说话了。
打开小红书,看看某个博主最近发的内容,总结成五条每天早上八点看天气,下雨才提醒我帮我把这段文字发到文件传输助手的对话里只用网页、沙箱和聊天的话,配对那一步可以跳过,安卓 11 就能装。
该说清楚的局限
reviewFinalAnswer = false,回答一律记作未核实,依赖核实的学习功能因此暂时不会发生;自主模式下连付款也不拦。作者把这些写进文档,态度是诚实的,读者得知道。和别的路子比
差别在取舍。厂商助手集成最深,但只在自家机型上;脚本类工具自由,维护成本落在你身上;硬件方案绕开了签名,代价是随身多一块板子。Mika 选择在系统允许的范围内把权限拿全,代价是第一次配对要折腾几分钟。
我的一点判断
这个项目最值得看的是工程密度。为了在一块虚拟屏上把事办成,作者自己实现了 ADB 协议、配对通知的状态机、五级端口发现、静音账本、上下文四分区,还写了架构文档把每个决定的理由记下来。这些不是 demo 里能看出来的东西,翻两页 docs/architecture.md 就知道了。
方向我也认同。agent 要真的干活,就得有一块自己的屏和一个自己的文件系统,跟人抢前台是最差的方案。Mika 把这块屏做出来了,还顺手把费用和隐私算清楚。
不确定的地方同样明显。公开测试版、单机型验证、平台风控,任何一条都可能让体验打折。愿意折腾、手里有安卓 13 以上手机的人,值得装一个试试;想开箱即用的,再等几个版本更稳。
项目地址在 https://github.com/wangzan101/Mika