ARTICLE · 1305960
AI 的「买家秀」与「卖家秀」:你用的真是那个模型吗?
有一天,我们或许不仅能要求 AI 给出答案,还能要求它拿出证据:这份答案确实来自约定的模型。
假设你购买了一项高端 AI 服务。界面显示的是某个高级模型,价格也按高级的模型收取。但在屏幕另一端,你看不到实际运行的程序。你怎么确定,服务商没有悄悄换成另一个更便宜的模型?
这不是说某家公司已经这样做了,而是一个很现实的技术问题:我们可以看到 AI 的回答,却通常无法独立检查回答背后的计算过程。
过去,这件事主要靠信任服务商。现在,一项名为 FlashProve 的研究,试图给出另一种答案:让模型推理附带一份可以被独立检查的密码学证明。这项工作由 Anthropic 在其研究文章和配套技术报告中介绍。它把一个看似抽象的密码学问题,带到了拥有 4000 亿总参数的大型语言模型上。
01|「买家秀」和「卖家秀」,差的到底是什么?
在网购中,卖家展示产品照片,买家收到实物后还能亲眼对比。但购买云端 AI 服务时,用户通常只能看到最后的输出。你看不到模型权重,也看不到中间每一步运算。即使回答很像某个模型写的,也不能据此证明它确实由那个模型生成。
一种粗暴的解决办法是让服务商公开模型权重,允许所有人自己重新计算。但这往往不现实:模型权重可能涉及商业机密,普通用户也没有能力重新运行数千亿参数的模型。
FlashProve 提出的思路更像是:不要求店家公开全部生产流程,但要求它拿出一份可核验的凭证。在这里,这份凭证就是密码学证明。验证者不必拥有模型权重,也不必重新完成同样庞大的计算,就能检查特定输出是否符合事先约定的模型计算规则。
不过,有一个重要细节:证明计算遵守了某组事先承诺的权重,不等于自动证明这组权重属于某个知名型号。 要完成后一步,还需要可信的模型身份与权重承诺之间的绑定。
02|FlashProve 是怎么工作的?
FlashProve 使用「先承诺、再证明」的设计。
离线阶段: 服务商针对模型权重生成承诺,并证明该承诺符合模型要求。这个过程不需要为每个请求重新执行。
在线阶段: 服务商针对具体请求构造推理证明。客户端使用模型承诺、输入输出和证明文件,检查被验证位置的 token 是否确实是所承诺模型根据规定计算得到的结果。
这里有一个重要前提:权重承诺必须与可信的模型身份绑定。 否则,验证者只能确认「某组权重完成了计算」,却不能单凭证明确认它就是服务商宣传的某个产品型号。
简单来说,可以把整个过程理解为两步。
第一步:先确定「应该用什么模型」。
模型服务商预先针对模型权重制作密码学承诺。承诺有点像一个经过特殊设计的数字封条:它可以帮助后续检查数据是否与事先确定的内容一致,又不必公开模型的全部秘密。
第二步:每次推理后,证明「实际做了什么计算」。
服务商针对特定输入和输出生成证明;验证者依据公开的输入输出、模型承诺与证明,检查被验证的 token 是否符合约定的运算过程。
这里用到的技术属于可证明推理(Provable Inference),并结合零知识证明相关方法,目标是同时满足几件事:正确计算能通过验证,造假难以通过验证,检查证明比重算模型便宜,并尽量不泄露被保护的权重和中间状态。
它并不能解决 「AI 说谎」的问题,但是可以确保「某个输出是不是按照约定的计算产生的」,这涉及到不同的信任问题,容易被混淆。
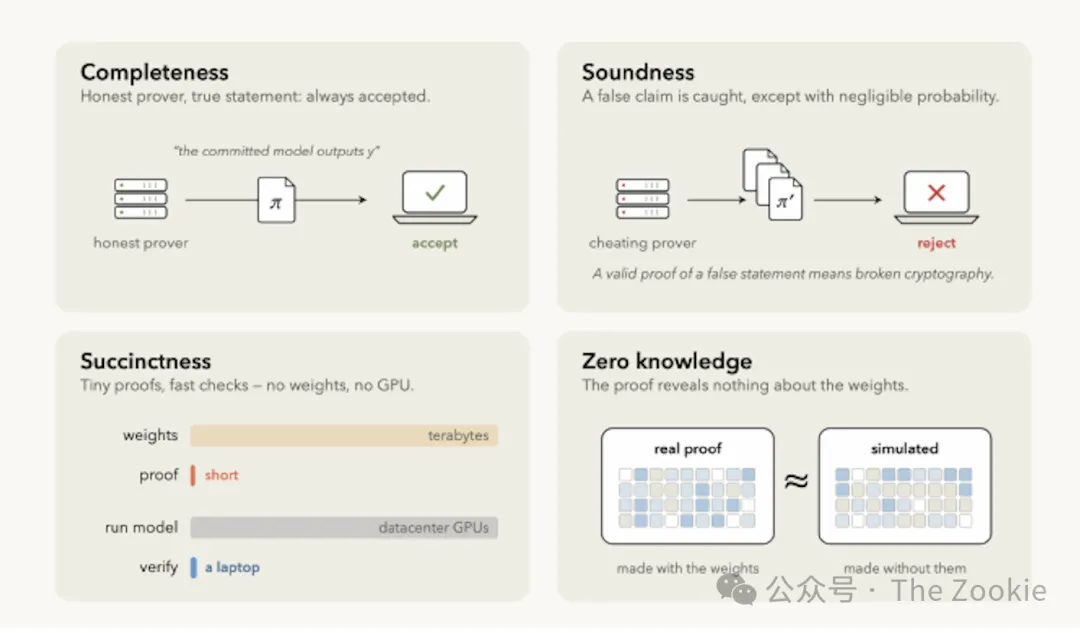
论文图:四项密码学性质
图 1|FlashProve 所追求的四项密码学性质。来源:技术报告第 3 页。
3. 为什么是 4000 亿参数?关键在于 MoE
FlashProve 的一个亮点,是把实验带到了 Llama 4 Maverick:这是一种拥有约 400B(4000 亿)总参数的混合专家模型(MoE)。
「4000 亿」听起来很吓人,但 MoE 的工作方式值得注意。你可以把它想象成一家有很多专业团队的公司。每次收到任务,并不需要所有团队一起上阵,而是由路由机制选出与这次任务相关的部分专家。
在研究涉及的模型中,每个 token 大约只激活 17B(170 亿)参数。因此,证明系统可以重点处理实际参与计算的部分,而不是把所有专家网络都当成执行过的计算。
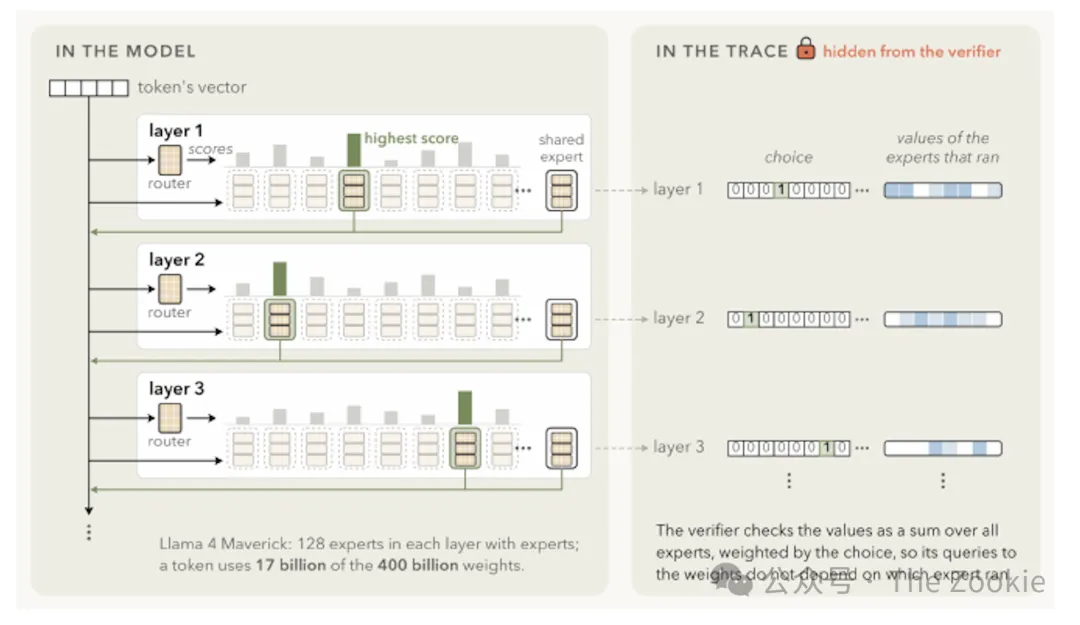
图 2|MoE 稀疏激活及证明轨迹。来源:技术报告第 11 页。
这意味着,MoE 不仅可以节省常规推理的计算量,也可能让证明推理过程更可行。但请注意:激活参数减少,并不意味着证明成本会等比例降低。编码、哈希、约束检查和数据搬运仍然有开销。
技术上,FlashProve 组合了交互式预言机证明(IOP)、Merkle 承诺、Fiat–Shamir 变换,以及 sumcheck、编码折叠、查表证明、整数化计算等方法。更重要的是理解它的目标:把庞大的计算过程转成一份相对容易检查的证明。
04|实验成绩很亮眼,但离「随聊随验」还有多远?
研究报告给出了一组值得关注的实验数据。其使用一张 NVIDIA H100 GPU 承担证明计算,对 24 个请求进行批量处理:
这里最容易误解的是 110 tokens/s。它不是用户聊天时实时获得、逐字附带证明的生成速度,而是特定批处理设置下的处理吞吐量。实验也不意味着每个单请求都对 1024-token 回复做了逐字完整认证。
还有一个细节:「单张 H100」不等于把整个 400B 模型塞进显存。 报告使用约 232 GB 的主机内存存放权重,按需传入 80 GB 的 H100,并分段处理证明轨迹。离线生成权重承诺本身还需要约 39 分钟。
所以,这项研究证明了「大模型可证明推理正在变得可做」,还没有证明它已经足够便宜,可以直接成为所有日常聊天的默认配置。
05|FlashProve 的突破究竟在哪里?
FlashProve 最有意思的地方,并不是某个吞吐量数字,而是它改变了一部分信任关系。
过去,用户往往只能相信服务商确实执行了承诺的模型。将来,在适当的部署和身份绑定条件下,第三方有机会独立核验某些计算声明。这可能更适合先出现在高价值场景里:例如模型身份核验、独立模型评测,或需要留存可审计推理记录的系统。至于能否成为普通聊天的标配,还要解决成本、时延和工程复杂性。
更重要的是,可验证不等于安全无虞。
证明「模型按规则运算」,不能证明回答一定真实。
证明「输出来自约定权重」,不能证明模型不会产生危险内容。
如果证明是事后生成的,它可能帮助发现异常,却不能自动撤回已经发送的错误结果或泄露的数据。
研究本身也明确列出未完成的部分:例如 C++ 实现与 Lean 形式化规范尚未证明等价,批量零知识性质尚未获得完整的形式化覆盖;实验针对整数化模型的贪心解码,与一般浮点推理或随机采样仍存在差异。技术报告还注明由 AI 生成、尚未完成详细人工审阅。
这些不是可以忽略的小字。真正严谨的技术报道,既要看到突破,也要看到证明覆盖不到的地方。
06|Zookie 观察:从「相信它」到「要求它拿出证据」
FlashProve 对 AI 产业提出了一个值得持续追问的问题:当 AI 系统越来越强大,我们能否把一部分对服务商的信任,转化为可以由外部独立验证的技术保证?
FlashProve 没有一次性回答这个问题,但它为其中一个环节提供了研究路径:验证特定模型计算是否遵循承诺。下一步值得关注的,是这种证明如何与模型身份认证、执行环境保护、权限控制和审计机制组合。毕竟,想让 AI 系统真正可信,单靠一份数学证明还远远不够。
Zookie 会继续关注这种防御性技术:不只是问 AI 还能做什么,也问我们凭什么相信它真的做到了。
资料来源与阅读说明
Anthropic 官方研究文章:Progress on provable inference for large language models
技术报告:FlashProve: an open-source library for provable inference,Roy Rinberg、Alex Allain、Alessandro Chiesa 等,2026 年 11 月。报告链接请点击左下方:阅读原文/Read more
本文依据官方研究文章及配套报告整理和解读,不是官方文章的逐字翻译。文中的实验数字与技术限制来自所提供的技术报告内容;本文未独立复现实验。论文配图版权归原作者或相关权利方所有,使用时须核对授权。
Zookie Defense · Start from zero, grow to infinity.