ARTICLE · 1306340
AI科研助手怎样记住上次踩过的坑?Magnolia把失败写进可审阅的记忆
前言
周五已经排查过的输入错误,周一换个对话又来一遍;同一种对接分数算错了三次,每次都像第一次发现。计算项目越长,真正难保存的往往是那句“当时为什么改成这样”。日志留住了命令,经验却散在聊天、笔记与目录里。
Magnolia把这个问题放到了科研agent的中心。这项2026年10月在arXiv公开的预印本由法国蔚蓝海岸大学、法国国家科学研究中心尼斯化学研究所等团队完成。第一作者Tao Jiang与通讯作者Élise Dumont、Louis-Félix Nothias均来自上述单位,Tao Jiang也担任通讯作者。研究用量子化学、分子动力学与蛋白质—肽对接,观察经验怎样在不同会话之间保存、修正并被再次使用。
把一整套生信交给AI:OmicsBench发现,难点藏在下一轮对话里讨论了长任务的交接;代码跑完了,结果就能进论文吗?给科研agent加一道验收门关注结果何时可用。Magnolia继续追问:一次排错留下的经验,什么时候才值得成为下一次工作的规则?
方法
团队把记忆分成三个层次。会话层接住工具调用、退出码、错误信息和对话,再提炼候选经验;项目层存放确认过、可以按任务检索的条目;经过研究者审核的经验才进入跨项目层,分别成为启动时加载的规则或按需调用的技能。
项目层也允许有限的自动接纳:同一经验至少在两个不同会话出现、置信评分达到0.85,且参数冲突检查没有发现矛盾。这里的评分来自模型自评,不能当作正确概率。升为跨项目规则仍需人工确认。
记忆以带结构化信息的Markdown文件保存,用Git记录修改。当前检索依靠标题、标签、工具和近期结果等启发式评分,可加入模型重排。研究者能够读到经验来自哪次运行,也能撤回错误条目。
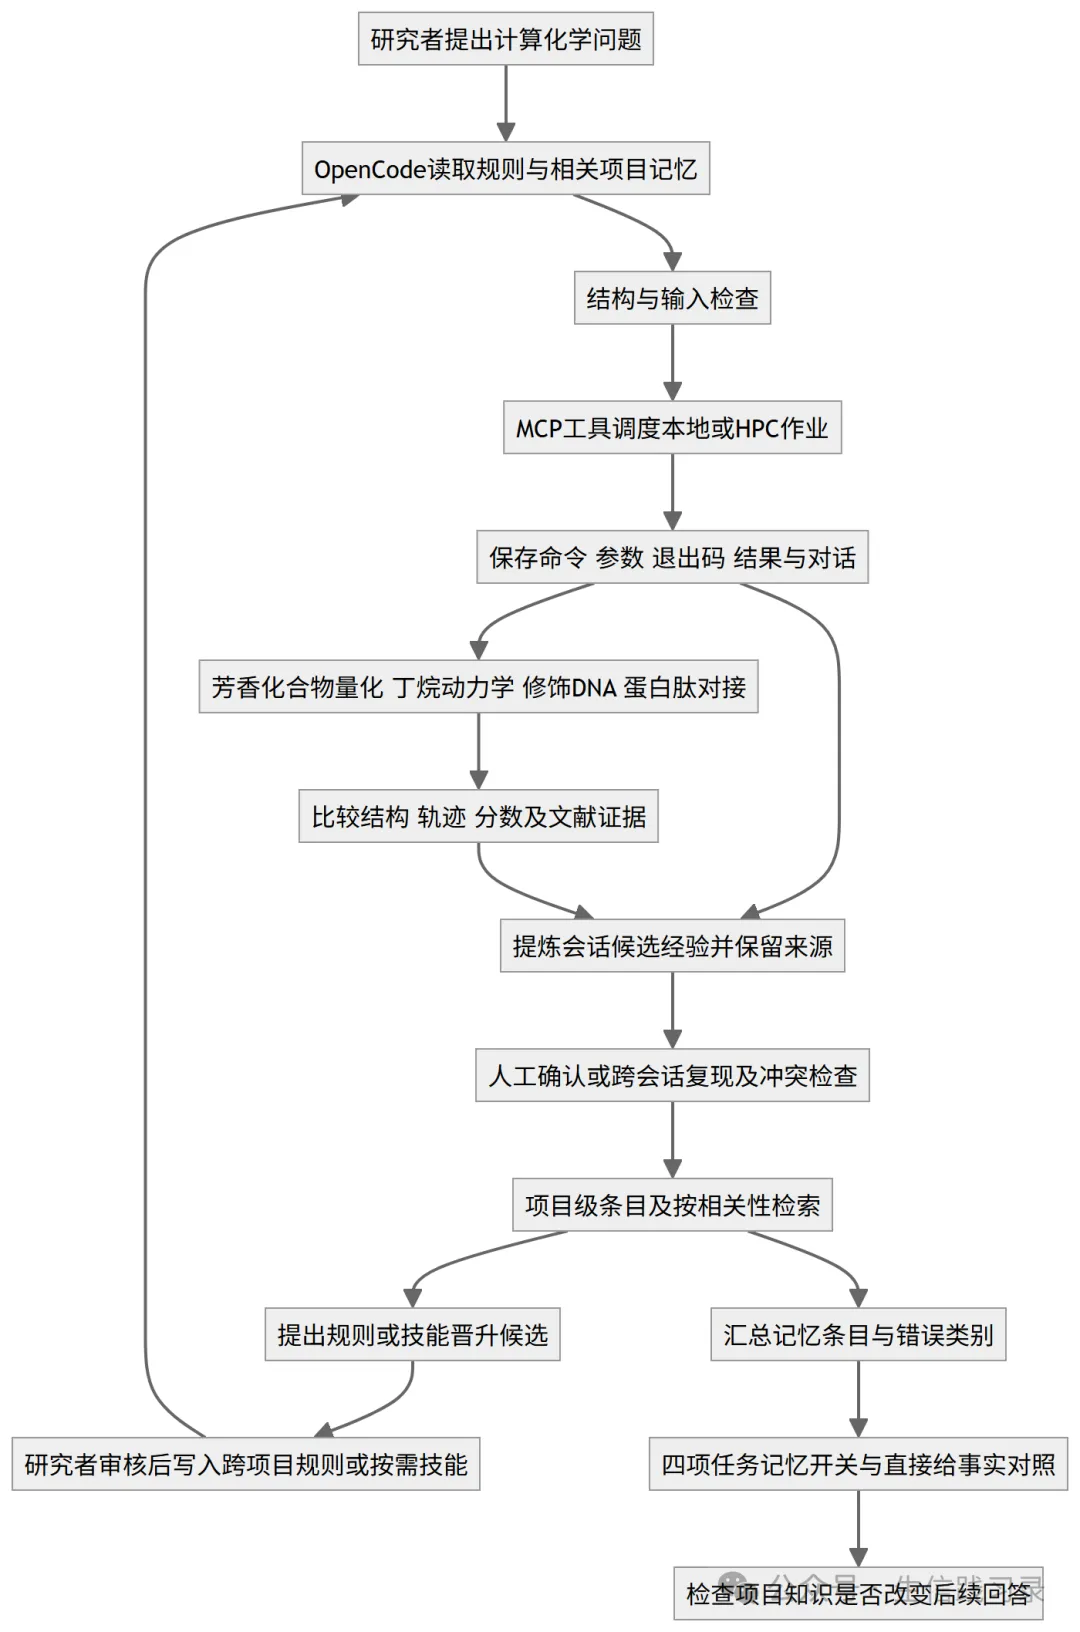
技术路线图
结果
让计算过程和经验一起留下
Magnolia以OpenCode承接对话,通过两个MCP服务分别调用科学工具与管理记忆,计算既可在本地执行,也可送到高性能集群。每次运行被登记,后续分析因此能够回到相应命令与产物。
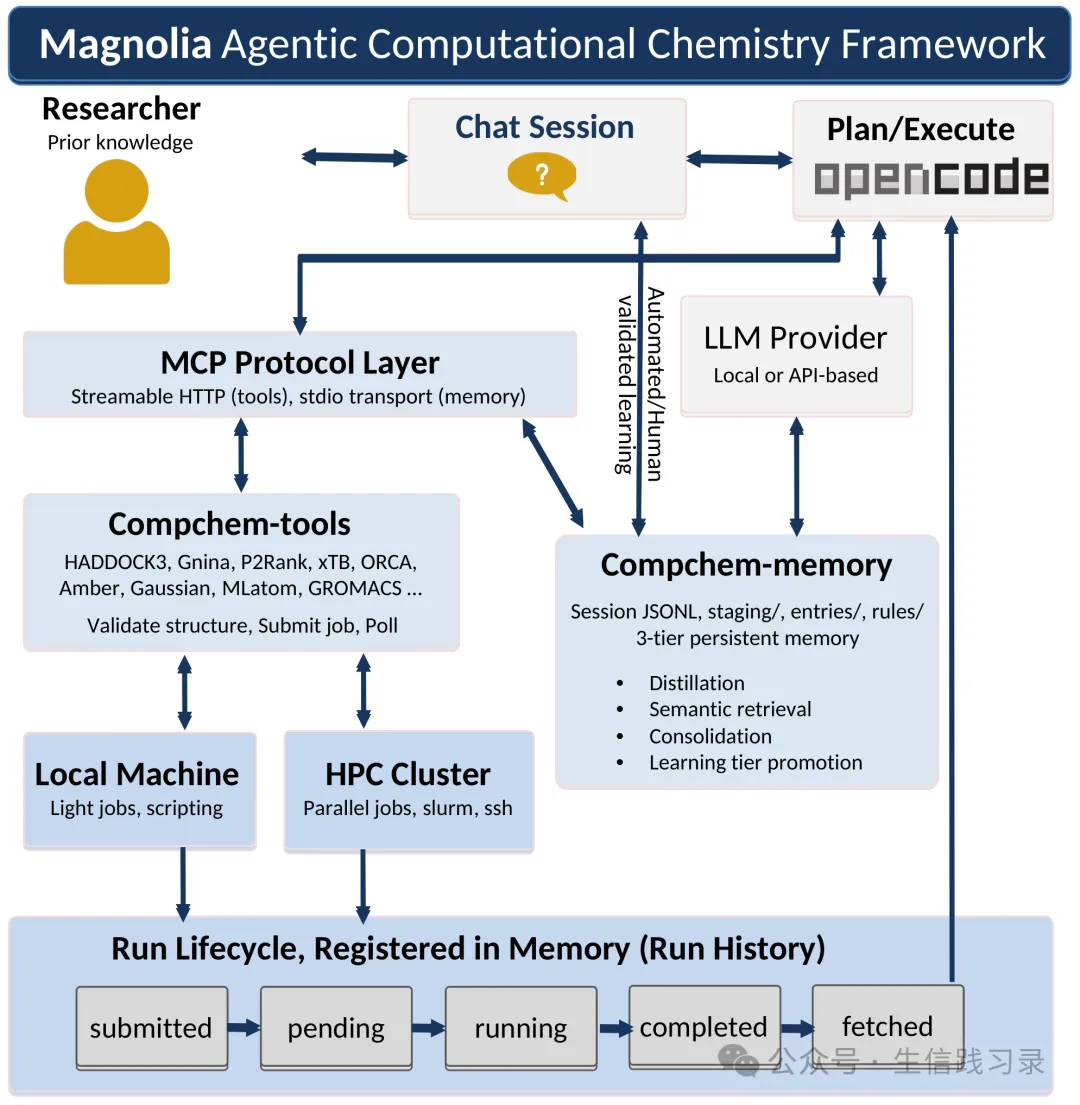
图1|Magnolia连接研究者、对话运行环境、计算工具和持久记忆,并记录作业从提交到结果取回的过程。
记忆的价值在于可逐步改变身份。一条“这次报错”的记录,先成为项目中的解决办法;如果适用范围足够清楚,才成为更广泛的约定。重复条目的合并也保留预览、人工审核和版本回退。
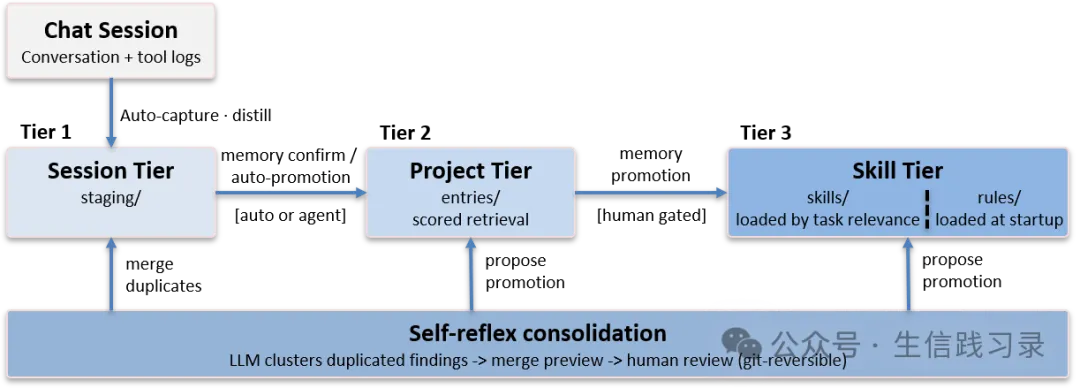
图2|经验从会话候选条目进入项目层,再经审核形成规则或技能;合并过程保留可追溯记录。
四个案例,让“完成”和“理解”接上
第一个案例覆盖COMPAS数据库中179个芳香化合物。agent组织量子化学计算,比较半经验方法与密度泛函方法的电子性质,并引入实验电离能作参照。排名接近并不意味着数值没有偏差,系统性偏移仍需分析。
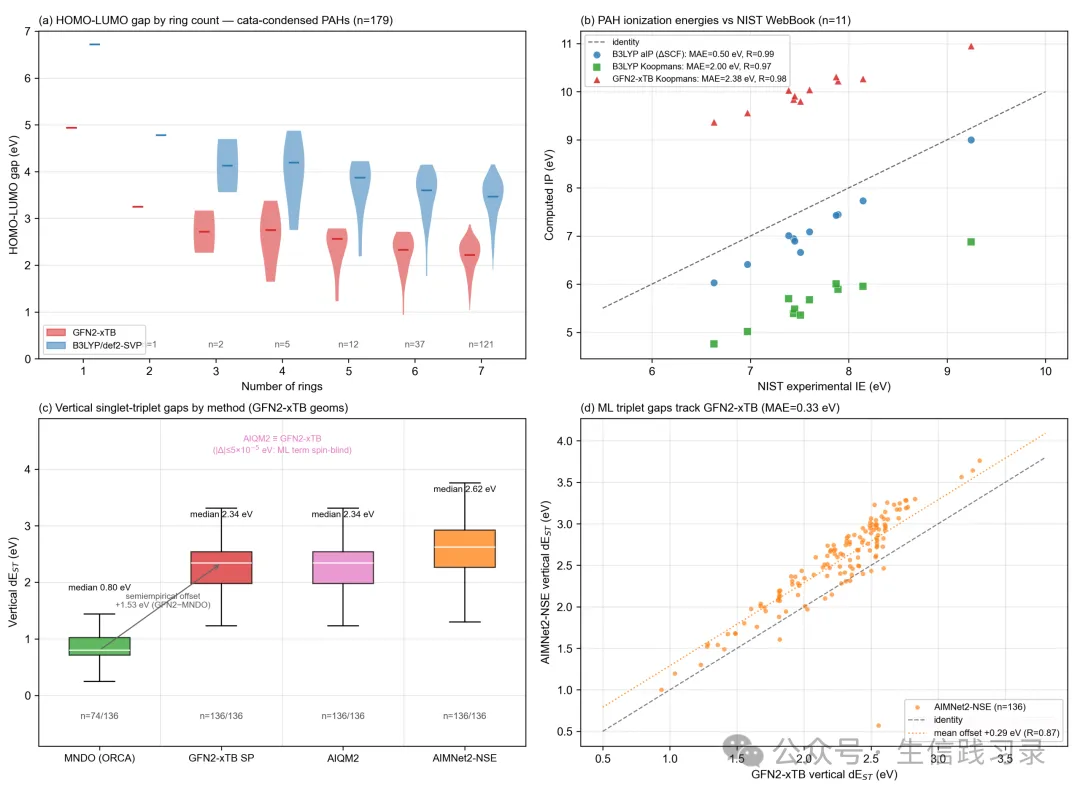
图3|不同计算方法对芳香化合物能隙、电离能和单重态—三重态能量差的比较,显示趋势一致性与方法偏差并存。
这次计算还留下过一条“刚性平面分子无需预优化”的建议,随后因核查生产代码被修订。记忆需要保留修正的缘由,才不会让旧建议继续传播。
丁烷案例更直观:经典动力学跑了10 ns,AIQM2动力学只有50 ps。后者停留在初始构象附近,直接比较构象占比容易把采样不足误读成方法差异。进一步的二面角扫描,为比较扭转能量提供了更合适的路径。
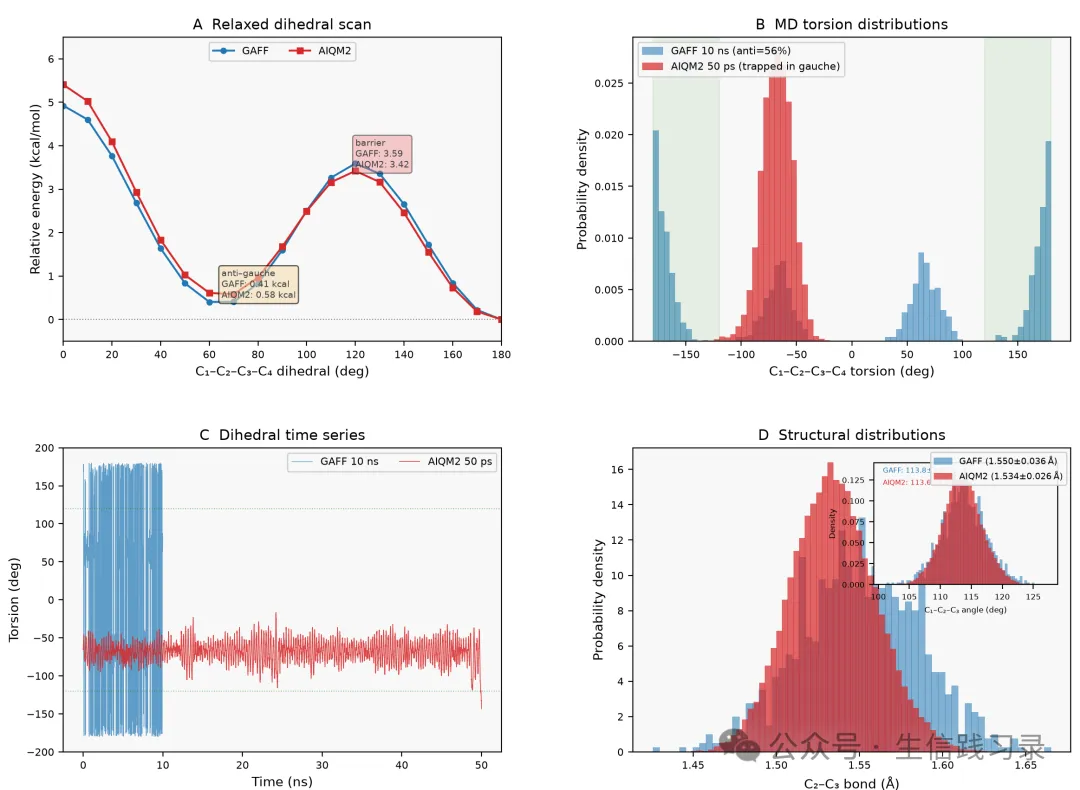
图4|丁烷的二面角扫描、构象分布、扭转轨迹和局部结构分布。短轨迹的构象滞留提示采样时间会影响解释。
修饰DNA案例将工作推进到更复杂的体系:生成序列、处理非标准碱基、构建溶剂盒,再分析轨迹与双螺旋几何。其项目记忆保留了结构重建和重启格式等问题,形成7条确认经验与12条候选记录,但尚未晋升为通用规则。
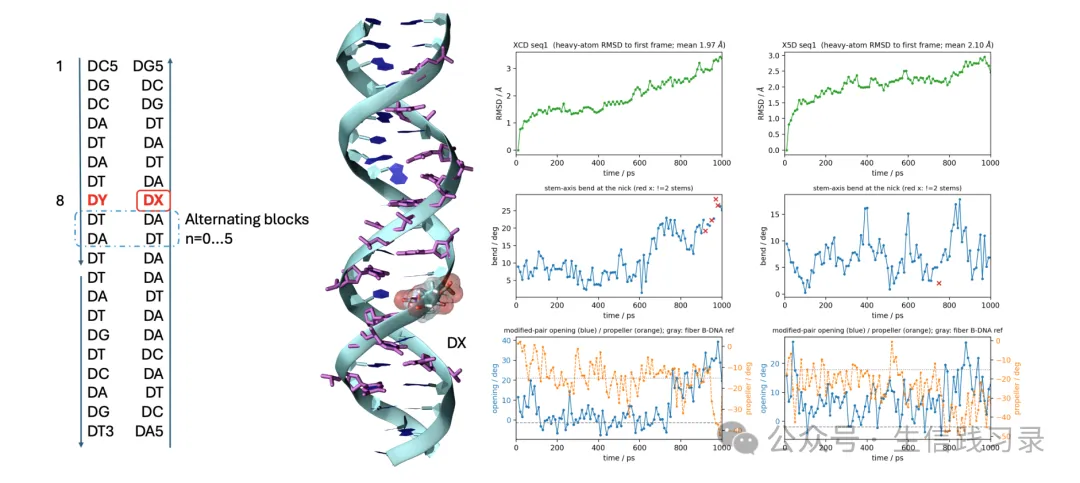
图5|含修饰碱基的DNA序列与结构,以及代表序列的均方根偏差、弯曲、碱基对张开角和螺旋桨角随时间的变化。
持续数周的蛋白质—肽对接揭示了更隐蔽的陷阱。换用预测口袋后,分数看起来改善了;进一步对照文献、晶体接触残基与构象,才发现对接落在错误位点。研究者据此修改约束,再比较不同长度与突变肽。更好看的分数,可能来自更偏离问题的计算。
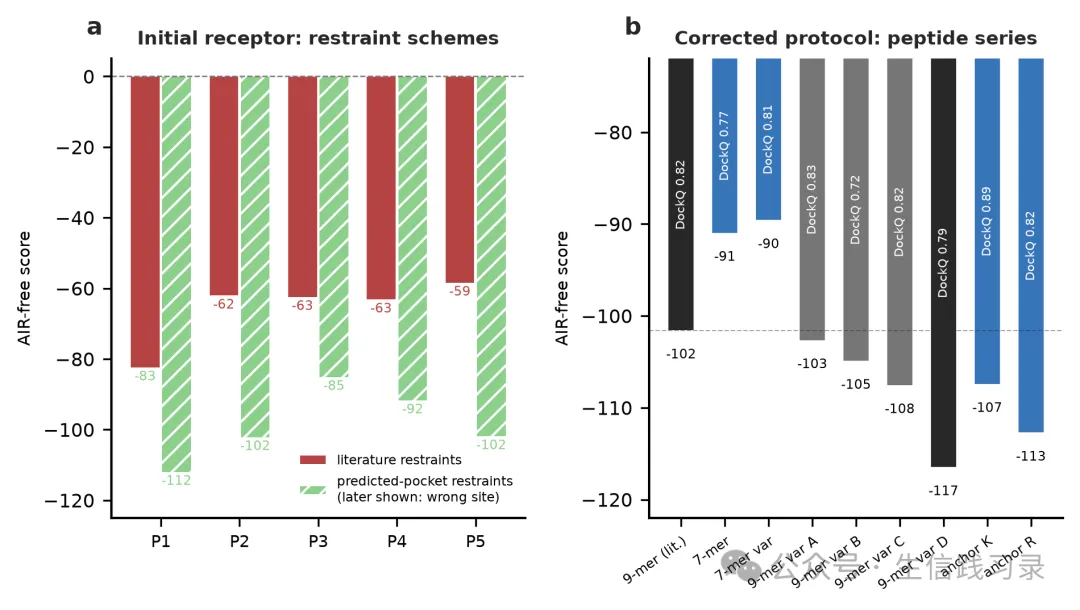
图6|初始约束与预测口袋约束的分数比较,以及纠正位点后不同肽的AIR-free分数。图中DockQ反映簇内一致性,不代表相对实验复合物的准确度。
记了多少,与改变了多少
四个案例合计登记317次运行,积累116条项目层经验,并有4条经验晋升为跨项目规则。量子化学批处理在生命周期管理器之外执行,因此没有计入其运行记录。对接项目一个记忆库的466条记录,则包括候选与已确认条目,不能与116条混用。
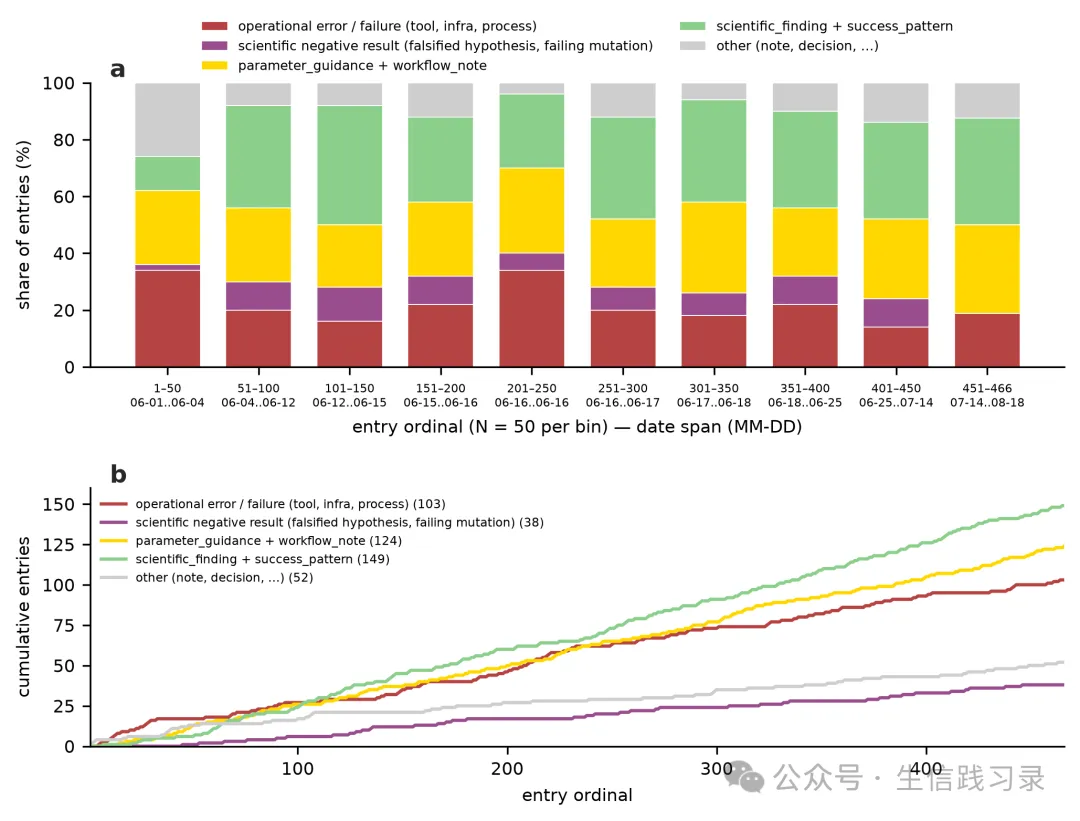
图7|对接项目中不同经验类型的比例与累计数量。横轴按条目顺序分组,各组覆盖的真实时间长度不同。
错误条目在早期较多,后续科学发现逐渐增加;新流程引入时,操作错误也会再次上升。不过,没有再记同一错误,并不能证明错误从未复发。
更直接的证据来自四项小规模受控重放。使用同一模型,分别关闭记忆、打开完整记忆,或在提示中直接给出关键事实。对接配置任务中,开记忆的四次运行均通过10项检查;关记忆时各次只通过1至4项。另一个任务也显示,只要库中缺少固定随机种子的要求,agent仍会漏掉它。记忆能传递经验,也会传递经验中的缺口。
结论
Magnolia把科研过程中的排错、参数选择和负结果,组织成能够追溯、检索与审核的经验链。它的贡献是让下一次行动有机会用上前一次的证据,同时保留研究者修改规则的权力。
编者总结
这项研究最值得借鉴的,是给经验保留出处、范围与修订记录。一次成功运行可以成为候选经验,反复确认后才适合扩大适用范围。
目前证据主要来自少数案例和项目内重放,尚未分离各层记忆的独立贡献,也未证明整体科研效率提升;部分对接对象与完整记录尚未公开。规则自动过期和错误引导检测也仍有缺口。将这种设计迁移到药用植物分析,仍需针对真实任务验证,但“经验从哪里来、何时被采用、由谁修订”已经是清楚可行的起点。
撰文:Yulee
相关参考
1. Magnolia预印本及版本记录(https://arxiv.org/abs/2610.27230)。 2. Magnolia完整论文与文内附录(https://arxiv.org/html/2610.27230v1)。 3. 官方代码仓库与使用说明(https://github.com/HolobiomicsLab/Magnolia-AI)。 4. Holobiomics研究团队(https://holobiomicslab.cnrs.fr/)。