ARTICLE · 1309125
加新类别掉老精度:AI项目交付避坑指南
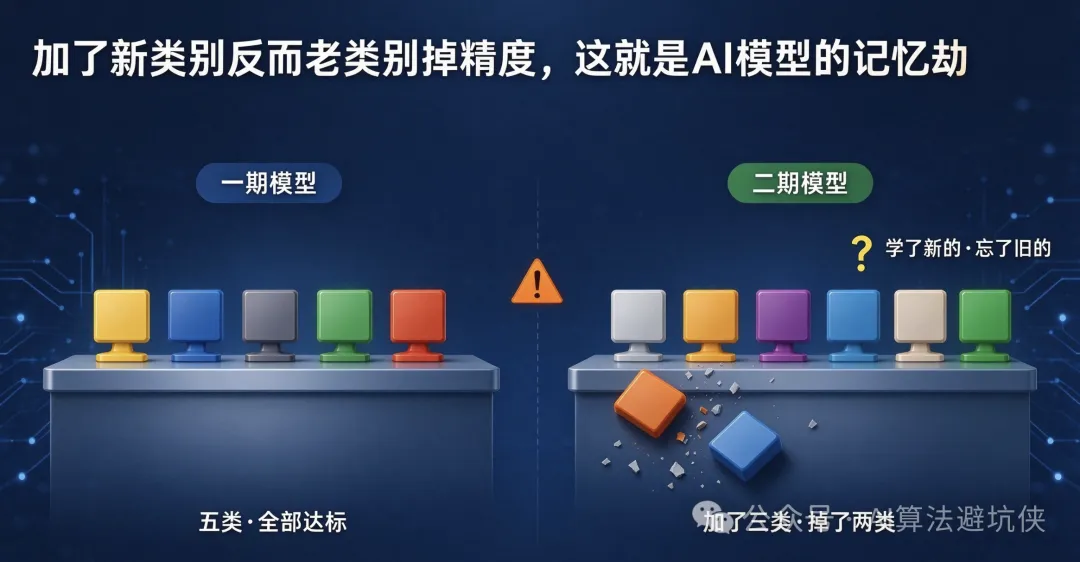
二期甲方说再加三类新缺陷,你心想不就是多训几类吗,简单。数据标好、模型一训、新的三类效果还不错。
结果一测老的五类,精度掉了。
不是掉一点点,是掉了好几个点。有的类别直接从达标掉到不达标。甲方指着测试报告问,怎么越做越回去了,加了新的反而旧的不行了。你也懵,明明每类都有数据,怎么老的就掉了呢。
这个问题,行业里有个专门的名字,叫灾难性遗忘。也有人叫它模型的记忆劫,学了新的、忘了旧的。
这篇就把这个坑拆透。为什么加新类别会导致老类别精度下降?灾难性遗忘的根因到底是什么?为什么传统的全量重训不是长久之计?以及真正能解决这个问题的方案有哪些,集成商选型的时候该怎么判断。
先搞清楚一件事,为什么加新类别会导致老类别精度下降。
很多人第一反应是数据不够,或者训练不够充分。多加点老类别的数据、多训几轮,是不是就好了。其实没这么简单。这个问题的根子,出在深度学习模型的基本特性上。
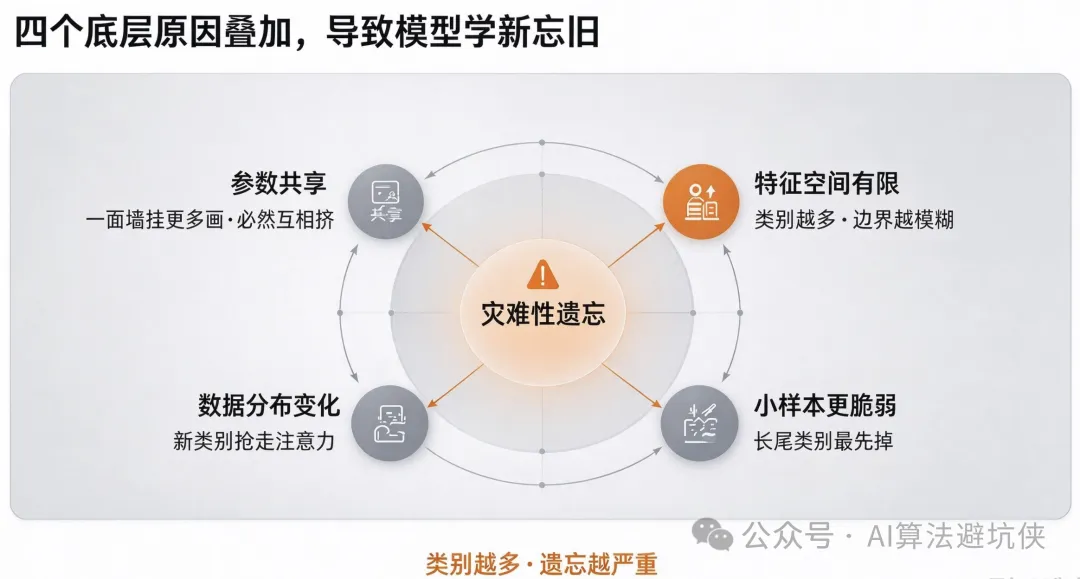
神经网络的参数是共享的。
一个目标检测模型,不管检测多少类,底层的特征提取网络都是共用的。模型的卷积层、注意力层,这些参数是所有类别一起用的。加新类别的时候,模型为了学好新类别的特征,会调整这些共享参数。参数一变,老类别的特征提取自然就受影响了。
打个比方。一面墙上挂了五幅画,位置刚刚好。现在你要再加三幅,墙还是那面墙,你就得挪动原来那五幅的位置。挪来挪去,有的画就挂歪了。
特征空间是有限的。
模型要在同一个特征空间里区分所有类别。类别越少,每类能分到的“特征空间”越大,区分起来越容易。类别越多,每类分到的空间越小,边界就越模糊。加了新类别之后,模型需要给新类别腾出空间,老类别的决策边界就会被挤压,误报和漏报自然就上来了。
数据分布的变化会打破原有平衡。
加新类别意味着训练数据的分布变了。新类别的数据多不多、质量好不好、跟老类别有没有重叠,这些都会影响模型的学习方向。如果新类别的数据量特别大,模型会把注意力更多地放在新类别上,老类别就被“冷落”了。这不是模型故意的,是梯度下降的天然特性。谁的损失大,模型就优先优化谁。
小样本类别更容易被遗忘。
数据量少的类别,本身在训练里话语权就弱。加了新类别之后,模型参数一调整,小样本类别那点微弱的特征很容易就被覆盖掉。掉精度掉得最厉害的,往往是那些样本量少的长尾类别。
这几个因素叠在一起,就导致了一个结果。类别越多,灾难性遗忘越严重。 三五类的时候可能不明显,十类八类的时候开始有感觉,到了十几二十类,每加一类都可能导致好几类老的掉精度。到那时候,加类别就不是简单的增量更新了,每次都得从头调。
遇到灾难性遗忘,大多数团队的第一反应是全量重训。
把所有类别的数据放在一起,从头训一个新模型。这样总不会忘吧,所有类别一起学,公平。
全量重训确实能解决遗忘问题,但它带来的新问题更多。
训练周期太长。
全量重训一次,少则几天,多则几周。数据量越大、类别越多、模型越大,训练时间越长。甲方今天说加两类,你说等我两周,甲方能等吗。项目节奏快的,等你训完,需求都变了。
验证成本爆炸。
每重训一次,所有类别都要重新测一遍。不是只测新加的,是所有老的都要测。因为你不知道哪些老的掉了、掉了多少。十类要测十类,二十类要测二十类,五十类要测五十类。测试的工作量随着类别数量线性增长,到后面测试比训练还慢。
版本管理混乱。
每次全量重训出一个新版本,每个版本的各类精度都不一样。这个版本A类好B类差,下个版本B类好A类差。甲方要的是所有类别都稳定达标,结果你每个版本都在波动,永远有那么几类不达标。
算力成本吃不消。
全量重训要把所有数据都跑一遍,数据量越大、算力成本越高。十几二十类的时候,每次重训的算力成本都是一笔不小的开支。而且这不是一次性的,是每次加类别都要花一遍。
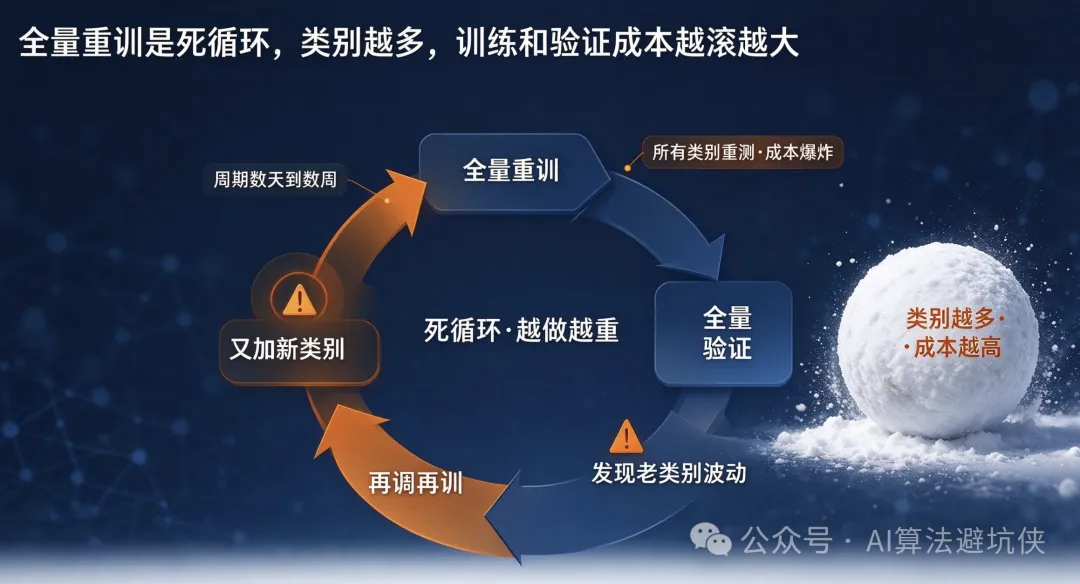
更要命的是,全量重训是个死循环。
这次全量重训解决了遗忘问题,下次再加类别,还是会忘。忘了解决方案还是全量重训。类别越多,重训周期越长、验证成本越高、版本越不稳定。到最后,项目的主要工作不是做算法,是训模型、测模型、调模型,陷入无限循环。
很多AI项目就是这样被拖死的。算法清单越写越长,交付周期越拖越久,成本越来越高,利润越来越薄。
那真正的解法是什么。
解决灾难性遗忘的正确方向,是增量学习。
简单说就是,加新类别的时候,不从头训整个模型,只更新模型的一部分参数。老类别的特征保留住,新类别的特征加进去,两边都不耽误。
增量学习的技术路线有好几种,各有优劣。
正则化方法是最朴素的思路。
训练新类别的时候,给模型参数加一个约束,重要的参数不能动太多。哪些参数对老类别重要,就保护哪些参数。这样新类别也能学,老类别也不会忘太多。好处是实现简单、不需要额外数据;坏处是保护力度不好控制,保护太严新类别学不好,保护太松老类别忘得多。
知识蒸馏走的是传承路线。
训新类别的时候,让新模型同时学习老模型的输出。老模型对老类别的判断结果,作为“知识”传给新模型。新模型既要学好新类别,也要尽量跟老模型在老类别上保持一致。好处是效果通常比正则化好;坏处是需要保存老模型,而且训练过程更复杂。
动态结构是更彻底的方案。
不加新类别不动老参数,加新类别就加新的参数模块。每类或每组类别有自己独立的参数空间,新老互不干扰,自然不会遗忘。好处是遗忘几乎为零;坏处是模型会越来越大,推理成本上升,类别多了之后管理也复杂。
回放重放是最直接的办法。
训练新类别的时候,同时混入一部分老类别的数据。老类别有数据在里面,模型自然不会全忘。这是最朴素也最有效的方法,工业界用得最多。前提是你得有老类别的数据,而且数据量不能太少。
这几条路线不是互斥的,真正落地的方案往往是组合拳。比如知识蒸馏加重放,再加一点正则化,多管齐下,效果才够好。
但不管用哪种方案,增量学习的门槛都不低。不是随便找个开源仓库改改就能用的。效果好不好,要看遗忘率控制得怎么样、新类别学的质量怎么样、推理速度有没有影响、工程实现稳不稳定。这些都得靠实打实的工程积累。
共达地 AutoML 平台内置了增量学习能力,加新类别不需要全量重训,老类别精度基本不掉。平台结合了知识蒸馏、数据回放、动态参数分配等多种技术,用户只需要上传新类别的数据、选择要新增的类别,平台自动完成增量训练,几天就能出结果。训练完自动跑全量验证报告,每类精度多少、掉没掉、掉了多少,一目了然。
最后给集成商和甲方几个实用建议。以后再遇到类别多、迭代快的AI项目,别等踩了记忆劫的坑才想办法,前期选型和规划的时候就要注意。
先问清楚增量能力:加新类别要不要全量重训。
这是最直接的问题。如果对方说要全量重训,那你就要算算账了。项目预期要做多少类、多久加一次、每次重训要多久、验证要多久、成本是多少。类别少还好说,十几类以上的,全量重训的模式迟早扛不住。
再问遗忘率:新增后老类别掉多少精度。
别听对方说“基本不掉”这种模糊的话。要具体数据,加一类掉多少、加三类掉多少、十类之后累计掉多少。不同场景、不同数据量,遗忘率不一样。一定要用你自己的场景数据测一下,看看遗忘率在不在可接受范围内。掉一两个点可能还能接受,掉五六个点就要慎重了。
再问验证效率:新增后要不要全量复测。
真正成熟的增量学习方案,应该能做到只验证受影响的类别,或者自动给出每类的精度变化。每次加类别都要把所有类别从头到尾测一遍,那跟全量重训的区别就不大了。
最后问工程成熟度:有没有完整的版本管理和报告体系。
增量学习不是一个算法点,是一整套工程体系。版本管理、精度追踪、自动验证报告、回滚机制,这些都得有。今天加了两类,精度怎么样,跟上个版本比哪些升了哪些降了,能不能一键回退到上一个稳定版本。这些工程能力,比算法本身更重要。
灾难性遗忘这个问题,说穿了就是个规模问题。三五类的时候谁都能做,十类八类开始拉开差距,二十类以上就是真功夫了。 很多团队死在十类以内的舒适区里,一到二十类以上就全线崩盘。 而真正的大项目,算法清单动不动几十上百类,没有增量学习能力根本扛不住。
做AI项目,别只看一期能不能交付。要想想二期、三期、十期之后怎么办。算法清单只会越来越长,需求只会越来越多。如果每次加类别都要脱一层皮,那项目做得越大、亏得越多。
选对技术路线,从第一天就按增量的思路做,后面才能越做越轻、越做越快。
你们遇到过灾难性遗忘吗,加新类别后老的掉了多少?评论区聊聊。想拿增量学习落地方案的,也可以私信我,我们细聊。
算法清单越做越长,每次加类别都要全量重训?
扫码添加共达地市场顾问,领取《共达地增量学习落地方案手册》,含灾难性遗忘成因分析、增量学习技术路线对比、AutoML增量训练流程、版本管理与精度追踪体系、典型场景落地案例参考。
关于共达地
共达地(GDDi)是一家专注于 AI 算法自动化训练的科技公司,核心产品 AutoML 自动化训练平台,帮助集成商和方案商从零代码快速量产长尾视觉算法。平台内置增量学习能力,新增类别无需全量重训,老类别精度基本不掉,训练周期按天算、不是按月算。支持知识蒸馏、数据回放、动态参数分配等多种技术组合,配套完整的版本管理、精度追踪和自动验证报告体系。
共达地的目标,是让每一家集成商都能拥有自己的算法工厂,从“卖硬件的倒爷”升级为“掌握算法生产能力的解决方案提供商”。
#灾难性遗忘 #增量学习 #AI项目交付 #避坑指南 #模型训练 #集成商转型 #全量重训 #共达地 #AutoML