ARTICLE · 1318473
AI 越来越会找软件漏洞,网络安全会变得更安全吗?
10 月 27 日,法国 AI 公司 Mistral 把旗舰模型 Mistral Large 4 的权重公开发布。这是一个总参数约一万亿、每次推理激活约 520 亿参数的多模态模型,也是欧洲第一个万亿级开源权重模型。官方在公告里给它的定位中,"防御性网络安全"排在很靠前的位置:发现漏洞、复现漏洞、写出补丁。
安全行业有个延续多年的困境:已知漏洞的修补速度,远远赶不上漏洞被发现的速度。现在,找漏洞这件事正在从安全研究员的手艺变成模型参数里的能力。这对每个用软件的人都有关联:AI 越来越会找漏洞,网络会因此更安全,还是更危险?
01|先看事实:这份"安全成绩单"里写了什么
按 Mistral 官方公告(10 月 6 日发布预览,10 月 27 日发布权重):模型总参数约 1 万亿、激活约 520 亿,混合专家(MoE)架构,原生支持文本和图像输入,在自有欧洲数据中心用 3,800 块 NVIDIA Grace Blackwell GPU 从零训练。许可证是修改版 MIT:允许商用、微调和再分发,只有把模型包装成云服务转售的厂商需要另行谈判。
与安全直接相关的数字有三组。
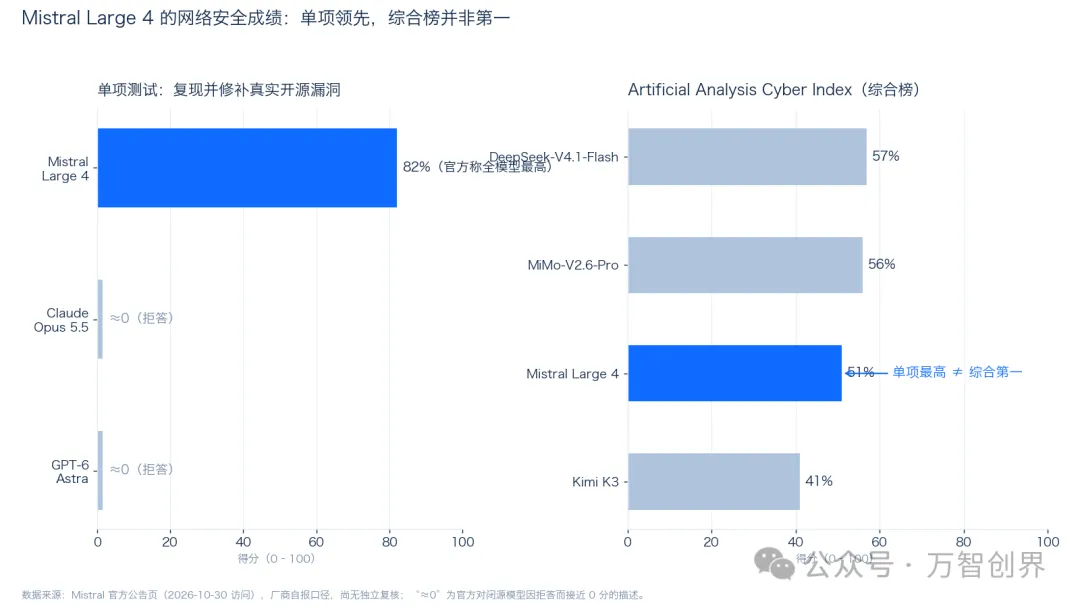
真实漏洞的复现与修补。在一项"复现并修补真实开源软件漏洞"的测试中,它得分 82%,官方称这是包括闭源模型在内的所有模型中最高分。作为对照,官方图表里 Claude Opus 5.5 和 GPT-6 Astra 在这项测试上接近 0 分——按官方的解释,它们不是不会做,而是拒绝做。
恶意请求的拒答率。在 JailbreakBench、StrongREJECT、AgentHarm 三套恶意提示测试上,平均拒答率 96.6%,官方称是开源模型中最高;对提示注入攻击的抵御率 97.1%,同样位居开源模型首位。
综合能力榜的位置。在 Artificial Analysis 的网络安全综合指数上它得分 51%。这里需要如实说明:同一张榜单上,DeepSeek-V4.1-Flash(57%)和 MiMo-V2.6-Pro(56%)都比它高。Mistral 领先的是"漏洞复现加修补"单项和拒答率,并不是网络安全综合能力榜的第一名。
编码是它的另一个主打:在 Cognition FrontierCode 2.0 上得分 19.7%,领先榜单上其他开源模型。安全能力和编码能力出现在同一个模型里,并非巧合——理解代码,是找漏洞和写补丁共同的前提。
02|变化在哪:从辅助工具到端到端复现
AI 参与漏洞研究并不新鲜,几年前的工具已经能辅助模糊测试的参数优化、标注代码审计的重点区域。这一次的不同有三个。
一是从"辅助人"变成"端到端"。82% 那项测试考核的是完整链条:拿到一个真实存在的开源漏洞信息,模型要自己定位代码、写出可运行的复现、再给出能用的补丁。这差不多是过去安全团队里一名资深研究员几天的工作量。
二是能力随权重扩散。闭源模型再强,能力都锁在厂商的服务端,厂商随时可以加限制;开源权重一旦发布就没有收回这回事。这份许可证明确允许任何人下载、本地部署、微调、商用。第三方规格页显示它的上下文窗口约一百万 token(官方公告页未标注此参数),足以把一个中型代码库整体放进上下文里排查问题。
三是攻防边界被做成了产品能力。官方明确说,模型的守卫机制会区分防御性任务和攻击性任务,防御工作"不需要不必要的拒答"。换句话说,厂商在模型层面做出承诺:你做防御,我配合;你想攻击,我拒绝。
03|同一份权重里的两副面孔
这正是争议的核心。96.6% 的拒答率听起来让人安心,但要分清它管住了什么、没管住什么。
拒答是模型行为,不是权重属性。通过官方接口调用时,守卫机制在起作用;把权重下载到本地之后,是否拒答取决于运行者怎么配置——系统提示词、微调、推理参数都可以改,而许可证允许这一切。官方自己也坦白:在实时流量监测中观察到"潜在攻击能力提升",护栏仍在更新。
所以那 96.6% 回答的问题是"模型会不会配合攻击者",而安全真正的边界问题是"攻击者能不能不靠模型自己干"。对后一个问题,开源权重把一种此前集中在头部厂商和国家级力量的漏洞研究能力,变成了一份可以免费下载的文件。能力的扩散不可逆。
Mistral 并非没有考虑这一层。它把更进一步的攻击性能力——渗透测试、红队、漏洞评估——从通用模型里分离出来,只提供给经过审核的企业设计伙伴(公告点名了 Orange Cyberdefense),附带合同约束,且仅限授权系统。但这个安排的边界意义正在稀释:通用模型本身已经能拿到 82% 的漏洞复现修补分,"专用变体才危险"的假设越来越难维持。
04|两条路线:开放加高拒答,还是训练期削减
Mistral 的发布恰好和另一个案例构成对照。三天前的 10 月 24 日,路透社报道,中国的月之暗面(Moonshot AI)在发布新模型 Kimi K3.1 Pro 时主动宣布:从训练语料和强化学习环境里移除了部分网络攻击内容,以降低模型被用于漏洞利用的能力。其内部沙盒测试显示,削减版在攻击性安全任务上的表现比未削减对照版低了约 9 个百分点(81.0% 对 90.5%,企业自报、未独立验证),并计划 11 月 4 日公开权重。
两家厂商面对同一道题,给出了相反的解法。Mistral 保留能力,靠拒答率和使用审核划线,主打"让防御者用上最好的工具";Moonshot 从训练源头削减能力,宁可牺牲部分性能。前者赌守卫机制足够可靠,后者赌能力削减不会让模型变成"干不了活的玩具"。
两种路线目前都没有经过独立检验:Mistral 的完整技术报告截至权重发布仍未公布,Kimi 的削减效果是企业自报数字。11 月 4 日 Kimi 权重公开之后,两边都会接受同样的第三方复核。
05|会更安全吗:取决于三个还没答案的问题
回到标题的问题。在能力层面,答案接近"是":能自动复现漏洞并写出补丁的模型,对防守方是真实的工具。开源软件的漏洞修补长期积压,安全团队缺的从来不是漏洞数量,而是处理漏洞的人手。
但"更安全"的结论,要等三个问题有答案。
基准分会不会变成生产力。82% 是在测试环境里对已知开源漏洞的成绩;生产系统里的未知漏洞、复杂业务逻辑、供应链依赖,还没有同等证据。研究能力和实际安全之间的距离,历来都卡在这一段。
攻防两侧谁先用上。防御者要真正把模型接进漏洞管理流程,需要工具链改造、流程重构和专业判断;攻击者用上它的门槛低得多——一条下载命令。
治理能否跟上能力扩散。拒答率、使用审核、合同约束都是厂商层面的安排。当能力以权重形式扩散之后,行业需要的是独立评测、漏洞披露协作和平台责任,而不只是厂商自律。
比较合理的判断是:AI 会显著抬高漏洞研究的效率上限,防御侧因此获得的增益是真实的;但网络是否"更安全",取决于防守方把新工具接入实战的速度,能不能快过攻击门槛下降的速度。这场竞赛刚刚换了发令枪,胜负未定。
值得持续观察的信号:11 月 4 日 Kimi 权重发布后两边的独立评测结果;第一批用 AI 完成漏洞复现与修补的真实安全运营案例;以及下一批模型发布时,各厂商如何在"能力、开放与安全"之间做取舍。
参考来源
Introducing Mistral Large 4 – Mistral AI,2026-10-06:https://mistral.ai/news/mistral-large-4 Mistral Large 4 (Le Chonk) is now open weight – Mistral AI,权重 2026-10-27 发布,页面 2026-10-30 访问:https://mistral.ai/news/mistral-large-4-oss Moonshot curbs hacking ability in new Kimi model as fears grow over AI-powered cyberattacks – Reuters,2026-10-24:https://www.reuters.com/technology/moonshot-curbs-hacking-ability-new-kimi-model-fears-grow-over-ai-powered-2026-10-24/ Mistral Large 4: How good is the 'best open model outside China' – ActusIA,2026-10:https://www.actuia.com/en/news/mistral-large-4-how-good-is-the-best-open-model-outside-china 上下文窗口约 1M token 的规格来自第三方规格页与媒体报道(Deployalo、eWeek 等,2026-10),Mistral 官方公告页未标注;文中基准数字除注明"企业自报"外均出自 Mistral 官方公告页(2026-10-30 访问),尚待独立复核。
看懂 AI 变化,探索未来可能。